

Anthropic hat diese Woche einen kostenlosen KI-Sicherheitsscanner für Open-Source-Projekte gestartet, den man per Opt-in aktiviert. Der Zeitpunkt ist heikel. KI findet inzwischen echte Bugs in Code, den Menschen jahrelang geprüft haben. Sie kann ehrenamtliche Maintainer aber auch unter erfundenen Meldungen begraben. Beides stimmt gleichzeitig, und ein kleines Team muss entscheiden, wie es damit umgeht.
Der neue Dienst heißt OSS Scanner und führt regelmäßig Schwachstellenscans für angemeldete Projekte durch, und zwar mit Anthropics stärksten Modellen. Jeder Report enthält einen Reproducer, eine Erklärung und, wo möglich, einen Patch-Vorschlag (Anthropic). Er steht neben einer ganzen Reihe ähnlicher Angebote von Google, OpenAI, GitHub, Snyk und Semgrep, und neben einem wachsenden Berg minderwertiger KI-Reports, der manche Maintainer dazu gebracht hat, die Tür zuzumachen.
Dieser Beitrag schafft Ordnung: was diese Tools tun, welche nichts kosten, wie Sie sich anmelden, ohne sich zu schaden, und welchen Workflow ein Zwei-Personen-Team fahren kann. Die Kurzfassung: KI-Scanner sind inzwischen gut genug, um sie ernst zu nehmen, und niemand sollte übernehmen, was sie liefern, ohne es zu lesen.
Was Anthropics OSS Scanner leistet
Core-Maintainer melden sich an, indem sie anhand einer Vorlage einen Pull Request in einem GitHub-Repository öffnen. Anthropic entscheidet im Einzelfall und legt ähnliche Kriterien an wie Googles OSS-Fuzz: Ein Projekt braucht „kritische Bedeutung für Infrastruktur und die Sicherheit der Nutzer“ (Anthropic). Das ist also nichts für jedes Hobby-Repo. Denken Sie an curl und wolfSSL, also Bibliotheken, gegen die halb Internet linkt.
Der Dienst ist kostenlos. Ein Topf, den Anthropic Defender Advantage Fund nennt, bezahlt die Scans (SiliconANGLE), und laut Anthropic bleibt die Teilnahme für angemeldete Projekte kostenlos.
Am wichtigsten ist, was fehlt. Die Reports sind „vollständig modellgeneriert, ohne menschliche Prüfung oder Triage“, und Anthropic sagt offen, dass manche falsch sein werden (Anthropic). Als Beispiel nennt das Unternehmen eine falsche Schweregrad-Einstufung. Projekte ohne Personal für die Sichtung können weiter den bestehenden Disclosure-Prozess von Anthropic nutzen, bei dem zuerst Menschen verifizieren (SiliconANGLE).
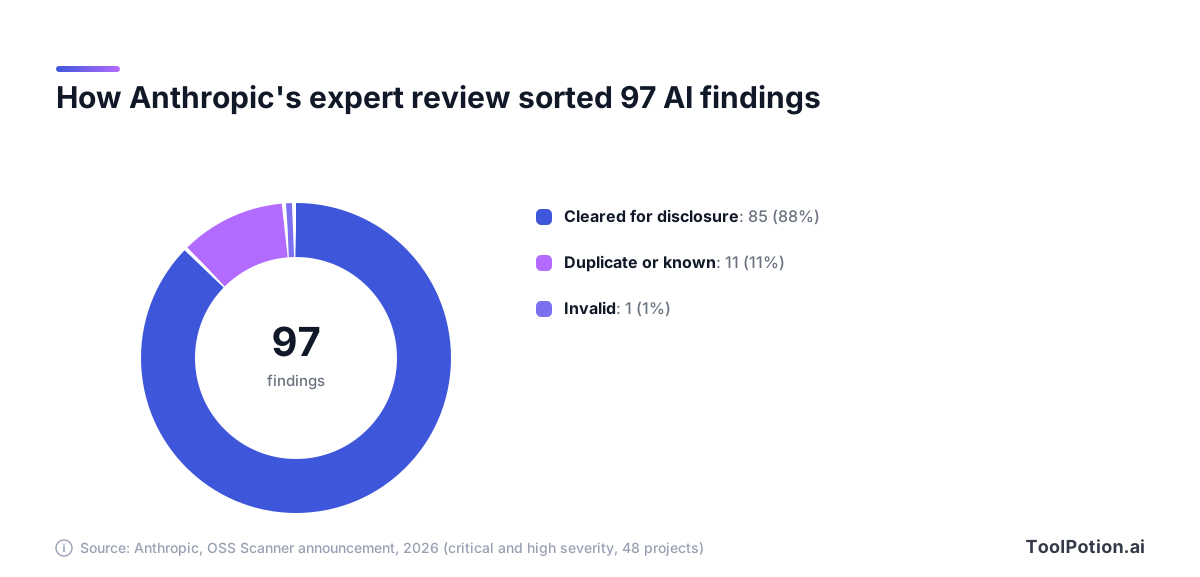
Anthropics eigene Zahlen zeigen, warum das Unternehmen den Tausch für lohnend hält. Erfahrene Penetrationstester prüften 97 kritische und hochgradige Funde in 48 Projekten. 85 davon erfüllten die Anforderungen für eine koordinierte Offenlegung, 11 waren Duplikate oder echte, aber bereits bekannte Probleme, und einer war ungültig (Anthropic). Unabhängig davon meldete wolfSSL, dass 72 von 74 Reports aus einem frühen Test gültig waren und fünf CVEs hervorbrachten (SiliconANGLE).
Daniel Stenberg, der curl betreut, sagte, der Scanner habe „eine der schlimmsten curl-Schwachstellen der letzten Jahre“ gefunden (Anthropic). Bedenken Sie dabei: Jede dieser Zahlen stammt von Anthropic oder seinen Partnern. Anthropic erwartet außerdem eine True-Positive-Rate von über 90 % (Anthropic). Das ist eine Prognose, keine Garantie für Ihr Repo.
Was ein KI-Scanner wirklich tut: finden, beweisen, patchen
Klassische statische Analyse gleicht Code mit Regeln ab. Sie ist schnell und berechenbar und überschwemmt Sie mit Warnungen. Die neueren agentischen Scanner arbeiten eher wie ein Junior-Sicherheitsforscher. Sie lesen den Code, entwickeln eine Theorie, wo er bricht, versuchen den Bruch auszulösen und schreiben ihn erst dann auf.
Auf diesen mittleren Schritt sollten Sie achten. Ein Fund mit funktionierendem Exploit ist etwas ganz anderes als ein Fund mit einem Absatz selbstsicherer Prosa.
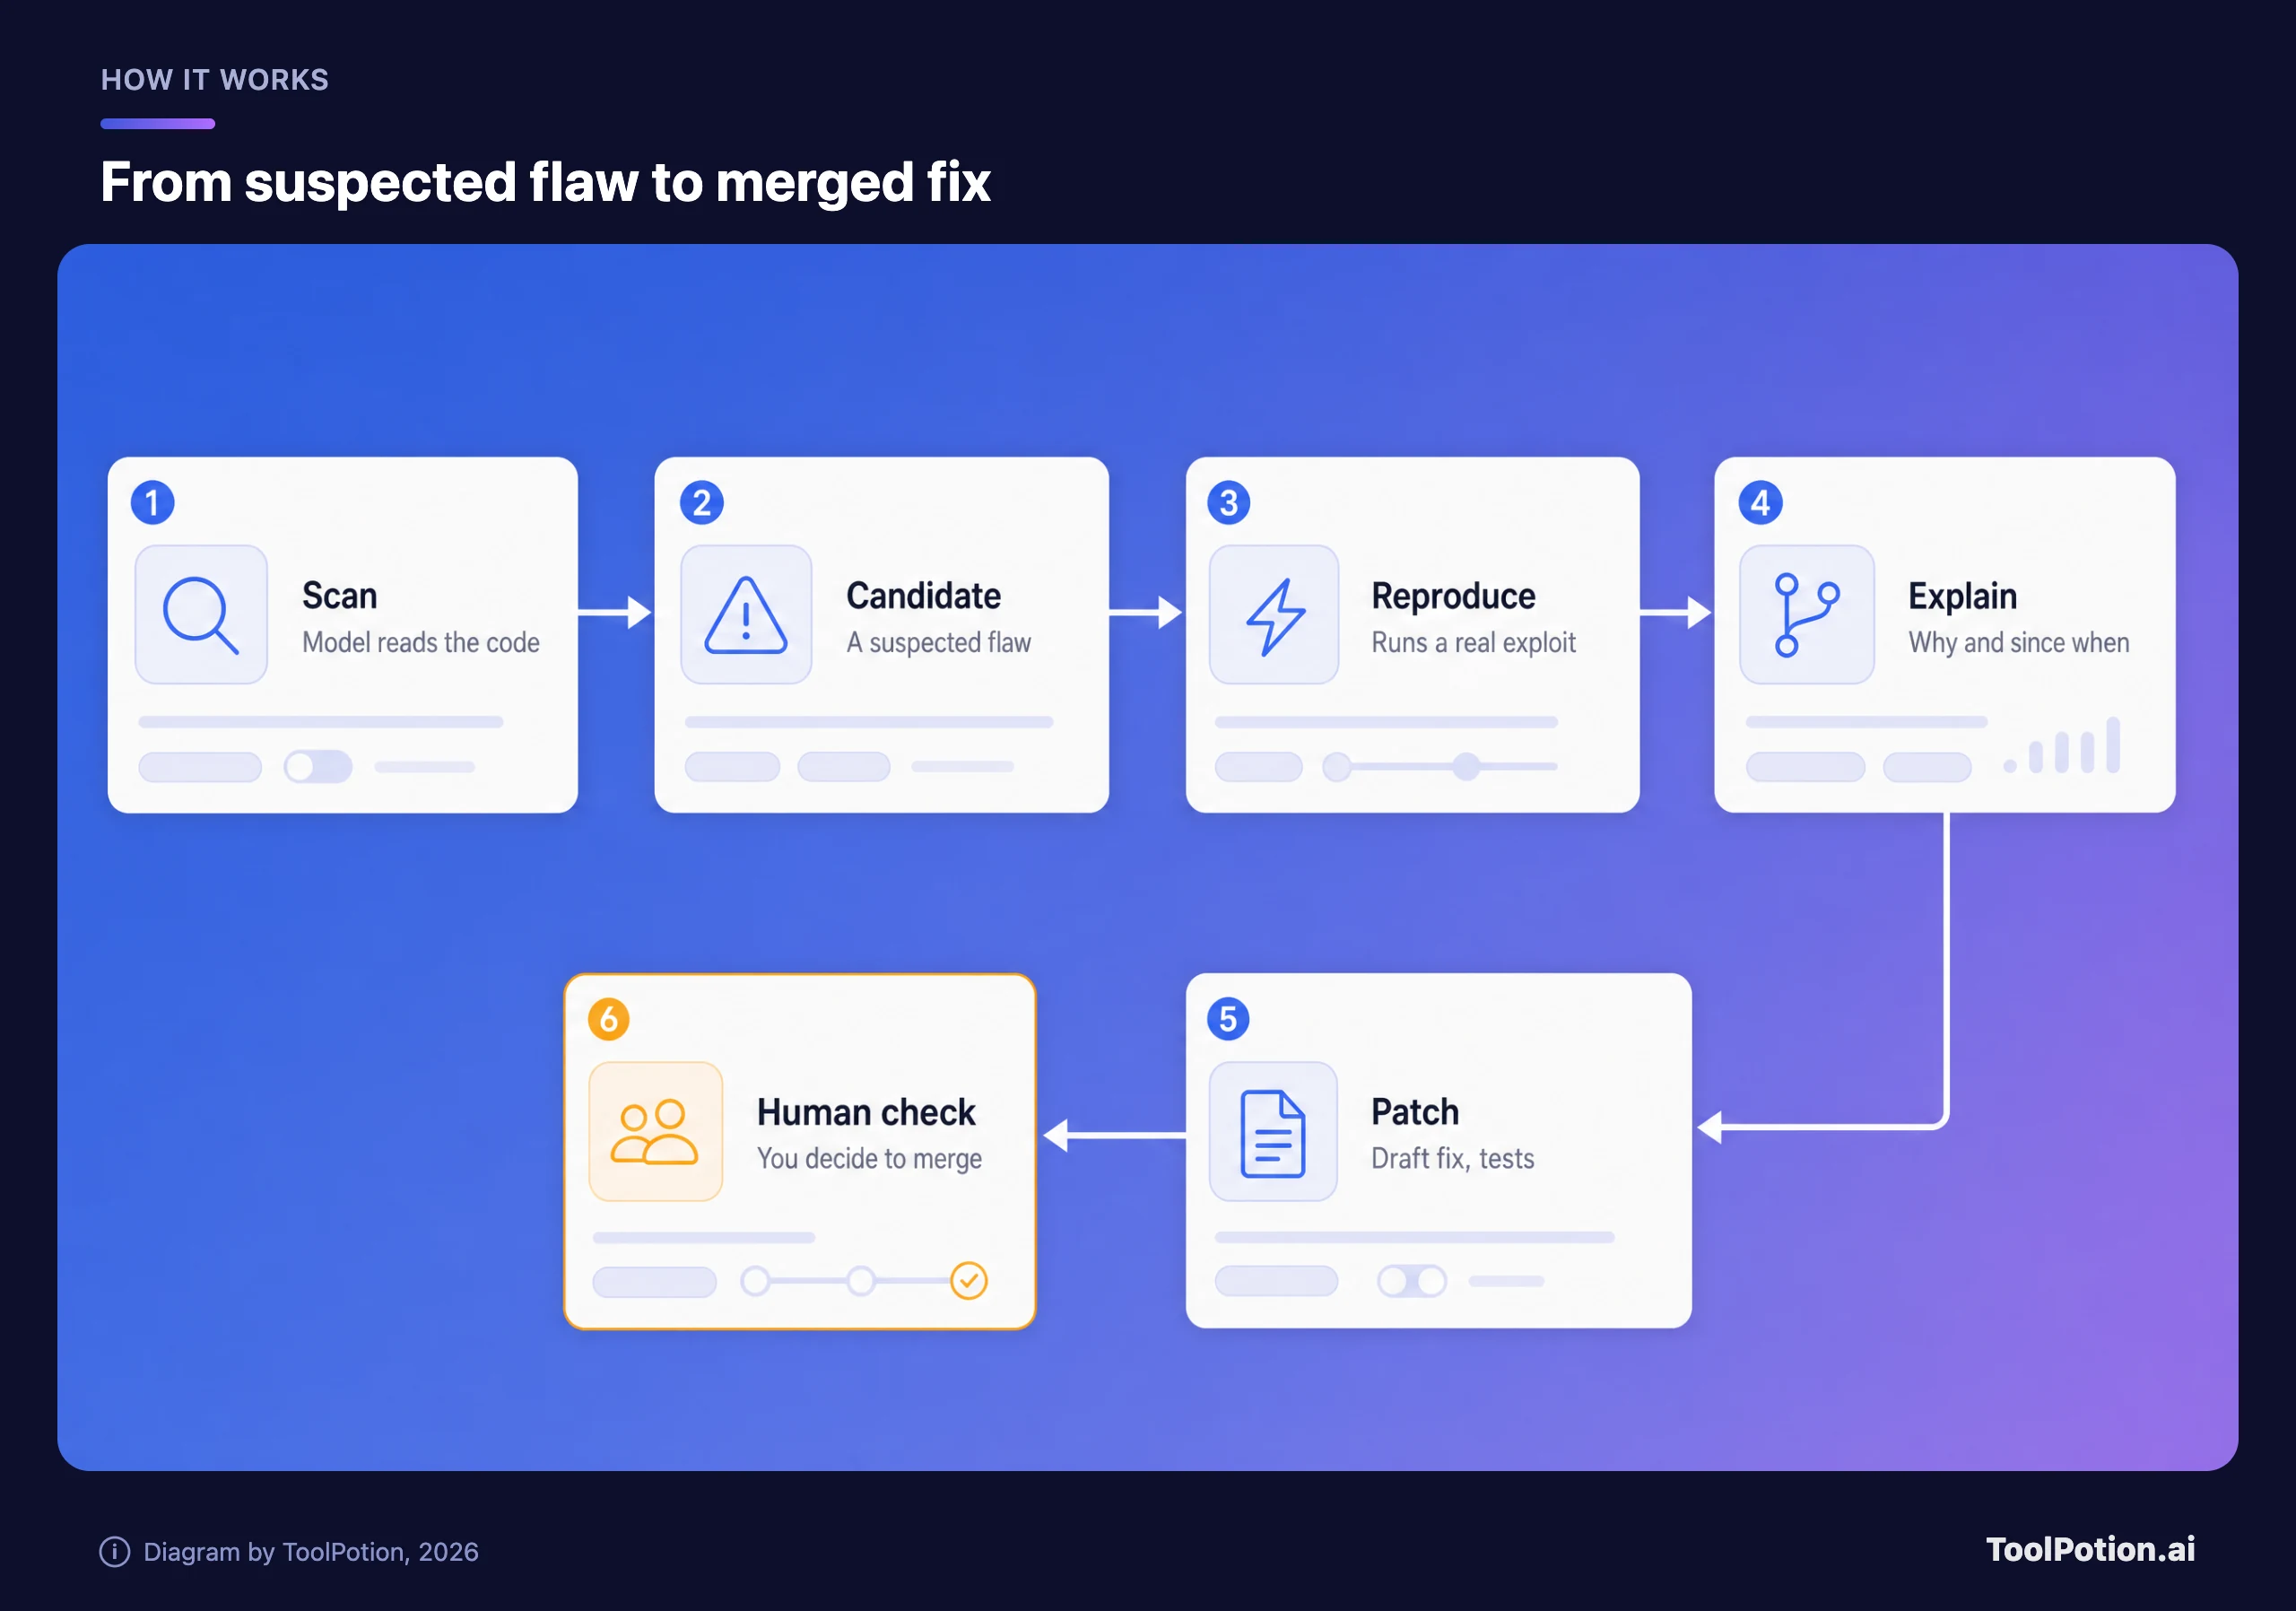
Lesen Sie die Pipeline von links nach rechts. Die ersten drei Schritte sorgen dafür, dass der Fund stimmt: Ein Kandidat wird einem echten Test unterzogen, bevor ihn jemand zu Gesicht bekommt. Schritt vier und fünf machen ihn nützlich, mit einer Erklärung, was kaputt ist, und einem Fix-Entwurf. Das letzte Kästchen gehört Ihnen, und es ist nicht ohne Grund bernsteinfarben. Google sagt, dass jeder CodeMender-Patch von Menschen geprüft wird, und GitHubs Autofix macht nur Vorschläge. Anthropics Scanner ist bei der Triage die Ausnahme, weshalb dieses letzte Kästchen bei Ihnen landet.
Das Feld 2026
OSS Scanner ist nicht allein. Googles DeepMind hat Big Sleep gebaut, einen Agenten, der Bugs aufspürt, und CodeMender, der Fixes schreibt. DeepMind gab an, bereits 72 Sicherheitsfixes in Open-Source-Projekte eingebracht zu haben, und dass jeder Patch zuvor von menschlichen Forschern geprüft wurde (Google DeepMind). CodeMender ist inzwischen als Public Preview für Unternehmenskunden auf Google Cloud verfügbar. Dort baut es Proof-of-Concept-Exploits in einer Sandbox und liefert getestete Fixes als Diffs zur Prüfung durch Entwickler (Infosecurity Magazine).
OpenAIs Variante startete als Aardvark, ein Agent auf GPT-5-Basis, der ein Threat Model Ihres Repos erstellt, neue Commits beobachtet, Probleme in einer Sandbox bestätigt und Patches vorschlägt. OpenAI gab an, in Testrepositories bei bekannten und synthetischen Schwachstellen 92 % erreicht zu haben und Probleme gefunden zu haben, die zehn CVE-IDs einbrachten (OpenAI). Inzwischen hat OpenAI das Tool unter neuem Namen in Codex integriert: Auf der Aardvark-Seite steht jetzt „Aardvark is now Codex Security“, verfügbar als Research Preview (OpenAI). Die Doku beschreibt Codex Security als Agenten, der Teams hilft, „Schwachstellen zu finden, zu bestätigen und zu beheben“, wobei die Cloud-Version weiterhin in der Research Preview ist (OpenAI docs).
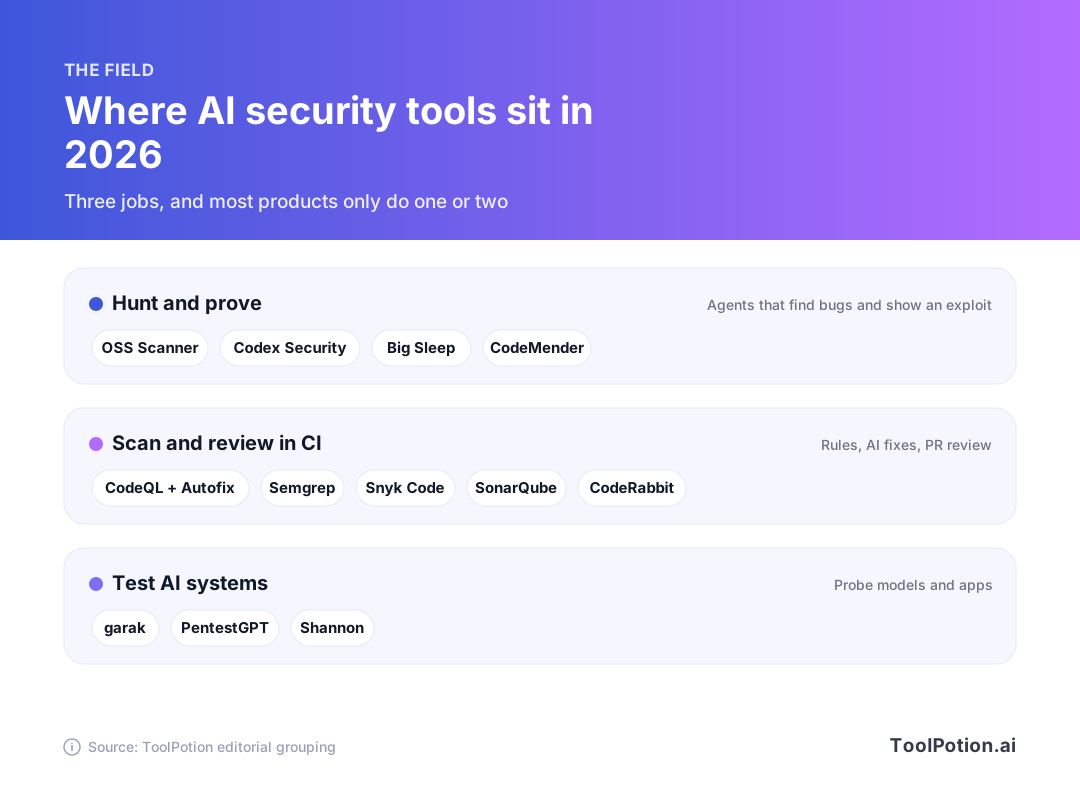
Die Karte gruppiert die Tools nach Aufgabe, und die Gruppierung stammt von uns, nicht von den Anbietern. Die obere Reihe spürt auf und beweist. Die mittlere Reihe lebt in Ihrer Pipeline und arbeitet bei jedem Commit. Die untere Reihe blickt in die andere Richtung und testet KI-Systeme selbst.
In der mittleren Reihe schlägt GitHub Copilot Autofix Fixes für Alerts vor, die CodeQL, GitHubs Scanner, auslöst. Semgrep und Snyk Code leisten mit eigenen Engines Ähnliches, und SonarQube deckt neben Sicherheitschecks auch Codequalität ab. CodeRabbit prüft Pull Requests. In der unteren Reihe testet garak Sprachmodelle auf Schwachstellen, und PentestGPT steuert Penetrationstests mit einem Modell. Unser Board zu KI-Cybersecurity rankt das größere Feld, und das Code-Review-Board deckt die Pull-Request-Tools ab.
| Tool | Hauptaufgabe | Wer es nutzen kann |
|---|---|---|
| OSS Scanner (Anthropic) | Findet und beweist Bugs, entwirft Patches | Angemeldete Open-Source-Projekte, kostenlos |
| Codex Security (OpenAI) | Findet, bestätigt und behebt | Research Preview in Codex |
| CodeMender (Google) | Scannt, beweist und patcht | Public Preview, Google-Cloud-Kunden |
| Copilot Autofix (GitHub) | Schlägt Fixes für CodeQL-Alerts vor | Kostenlos in öffentlichen Repos |
| Semgrep | Regelbasiertes Scanning mit KI-Funktionen | Kostenlos bis 10 Contributors |
| Snyk Code | Scanning von Code und Abhängigkeiten | Free-Plan, 100 Code-Tests pro Monat |
Das meiste in dieser Tabelle stammt von Anbieterseiten, und Anbieter beschreiben ihre eigenen Produkte wohlwollend. Die Zugangsbedingungen sind die nützlichste Spalte. Sie ändern sich schnell.
Die Kehrseite: Maintainer ertrinken
Dieselben Modelle, die echte Bugs finden, schreiben auch überzeugende falsche. curl ist der klarste Fall. Das Bug-Bounty-Programm lief von 2019 bis Anfang 2026, zahlte über 100.000 $ für 87 bestätigte Schwachstellen aus und wurde dann eingestellt. 2025 wurden weniger als 5 % der Reports bestätigt, in früheren Jahren waren es 15 % oder mehr (Daniel Stenberg).
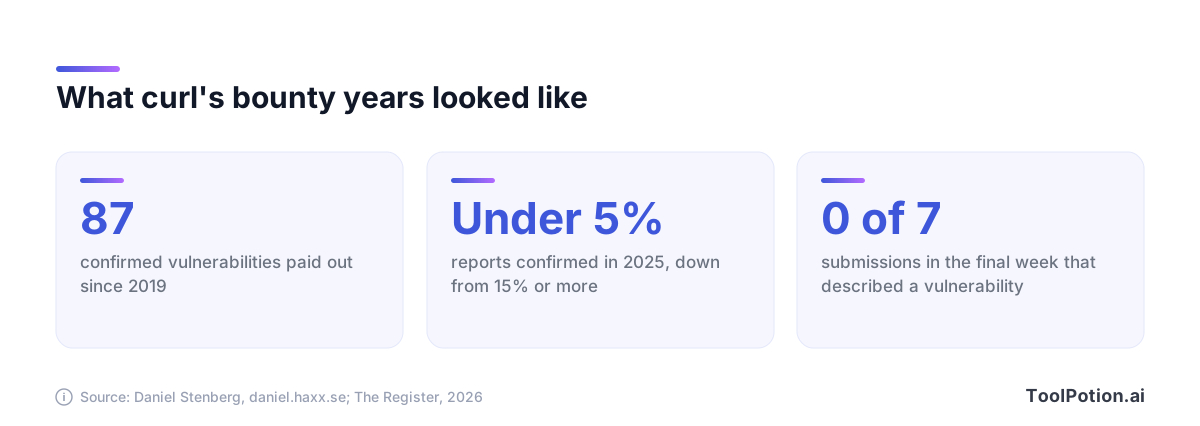
In der letzten Woche vor dem Ende des Bounty-Programms erhielt curl sieben Einreichungen, und keine beschrieb eine Schwachstelle (The Register). Stenbergs Begründung war unverblümt. Man wolle „den Anreiz beseitigen, uns Mist und schlecht recherchierte Reports zu schicken. KI-generiert oder nicht.“ Piotr Karwasz von Apache Log4j beschrieb dasselbe Muster: Viele Reports „übersehen die Grundlagen unseres Sicherheitsmodells und bringen Rauschen statt Mehrwert“ (Daniel Stenberg).
curl ging später noch weiter. Stenberg schrieb, das Projekt habe in diesem Sommer einen Monat lang keine Schwachstellenmeldungen angenommen, und nannte das „möglicherweise unsere beste Projektentscheidung seit langem“ (Daniel Stenberg).
Beachten Sie: Dasselbe Projekt, das sein Bounty-Programm schloss, um KI-Rauschen zu stoppen, lobte auch einen KI-Scanner, der einen seiner schlimmsten Bugs fand. Das ist kein Widerspruch. Der Unterschied liegt in einem funktionierenden Reproducer und in einem Absender, der schon geprüft hat. Ein Modell, das seine Behauptung belegt, kostet den Maintainer Minuten. Ein Mensch, der Modell-Output einfach einfügt, kostet ihn Stunden.
Anthropics Scanner überspringt den menschlichen Mittelsmann, und das ist zugleich Reiz und Risiko. Er beschleunigt die Zustellung, bedeutet aber auch, dass ein Report bei Ihnen eintreffen kann, ohne dass ihn vorher jemand gelesen hat. Wenn Sie ein Projekt betreuen, rechnen Sie damit von jedem Anbieter in der Tabelle.
Angreifer haben dieselben Modelle
Anthropics eigene Ankündigung sagt, „Frontier-Modelle können missbraucht werden, um Schwachstellen auszunutzen und Cyberoperationen durchzuführen“ (Anthropic). Die praktische Lesart ist einfach. Jeder kann ein starkes Modell auf öffentlichen Code ansetzen und fragen, wo er bricht, und Open Source ist per Definition öffentlich.
Das ist das eigentliche Argument, den eigenen Code zu scannen. Nicht, dass KI-Scanner Magie wären. Sondern dass das Zeitfenster zwischen der Existenz eines Bugs und seiner Entdeckung durch jemand anderen kürzer wird und Sie lieber zuerst dran sein wollen. Ein Projekt ohne Scanning ist nicht sicher. Es ist nur unbeobachtet.
Was kostenlos ist und was nicht
Ein großer Teil der nützlichen Schicht ist kostenlos, wenn Ihr Code öffentlich ist. Copilot Autofix ist für öffentliche Repositories, die CodeQL nutzen, standardmäßig aktiv, ein Copilot-Abo ist nicht nötig (GitHub). GitHub hat es bereits 2024 für alle öffentlichen Repositories kostenlos gemacht (GitHub changelog).
Semgrep in der kostenlosen Edition deckt bis zu 10 Contributors und 10 Repositories ab, inklusive 60 KI-Credits (Semgrep). Snyks Free-Plan erlaubt fünf Projekte und 100 Snyk-Code-Tests pro Monat (Snyk), und das Unternehmen betreibt außerdem ein Programm, bei dem Open-Source-Maintainer kostenlosen Zugang beantragen können.
Kostenpflichtig wird es meist bei privatem Code und Agenten. GitHubs neueres agentisches Autofix, noch in der Preview, verbraucht KI-Credits, und Copilot Autofix in privaten Repositories braucht eine Code-Security-Lizenz (GitHub). Für Codex Security brauchen Sie Zugang zur Research Preview (OpenAI docs).
So melden Sie sich sicher an
Kostenlos heißt nicht folgenlos. Ein Scanner, der Ihren Code liest und Ihnen Reports schickt, wirkt sich auf Ihren Workflow, Ihren Disclosure-Prozess und manchmal auf Ihren Ruf aus. Ein paar Schritte halten das im Griff.
- Prüfen Sie zuerst die Voraussetzungen. OSS Scanner will Projekte mit kritischer Bedeutung für Infrastruktur oder Sicherheit. Lesen Sie daher die Kriterien im Anthropic-Repository, bevor Sie Zeit in einen Pull Request stecken.
- Legen Sie fest, wohin Reports gehen. Nutzen Sie einen privaten Kanal, etwa GitHubs Private Vulnerability Reporting oder eine Security-E-Mail-Adresse, damit ein Fund nicht öffentlich wird, bevor es einen Fix gibt.
- Benennen Sie eine verantwortliche Person. Eine Person bekommt jeden Report und entscheidet, was passiert. Bei zwei Personen geht jeder davon aus, dass der andere es erledigt.
- Lesen Sie die Datenbedingungen jedes gehosteten Scanners. Semgrep etwa sagt, dass aktivierte KI-Funktionen die Teile von Dateien verarbeiten können, die Funde enthalten (Semgrep). Wissen Sie, was Ihre Maschine verlässt.
- Beginnen Sie mit Lesezugriff und behandeln Sie Patches nur als Vorschläge. Kein Tool sollte auf Ihren Main-Branch pushen.
- Schreiben Sie Ihre Disclosure-Timeline auf, bevor der erste Report eintrifft. Einer Regel, die Sie in Ruhe geschrieben haben, folgt man viel leichter.
Nichts davon ist exotisch. Es ist dieselbe Hygiene, die ein guter Maintainer bei jedem externen Forscher anwendet, nur eben bevor das Volumen kommt.
Ein Workflow für kleine Teams
Wenn Sie zu zweit bis zu zehnt ein Produkt ausliefern, brauchen Sie am ersten Tag keinen agentischen Scanner. Sie brauchen eine Queue, die Sie tatsächlich leeren können. Der Ablauf unten hat sechs Schritte, und der bernsteinfarbene ist der, den die meisten Teams überspringen.
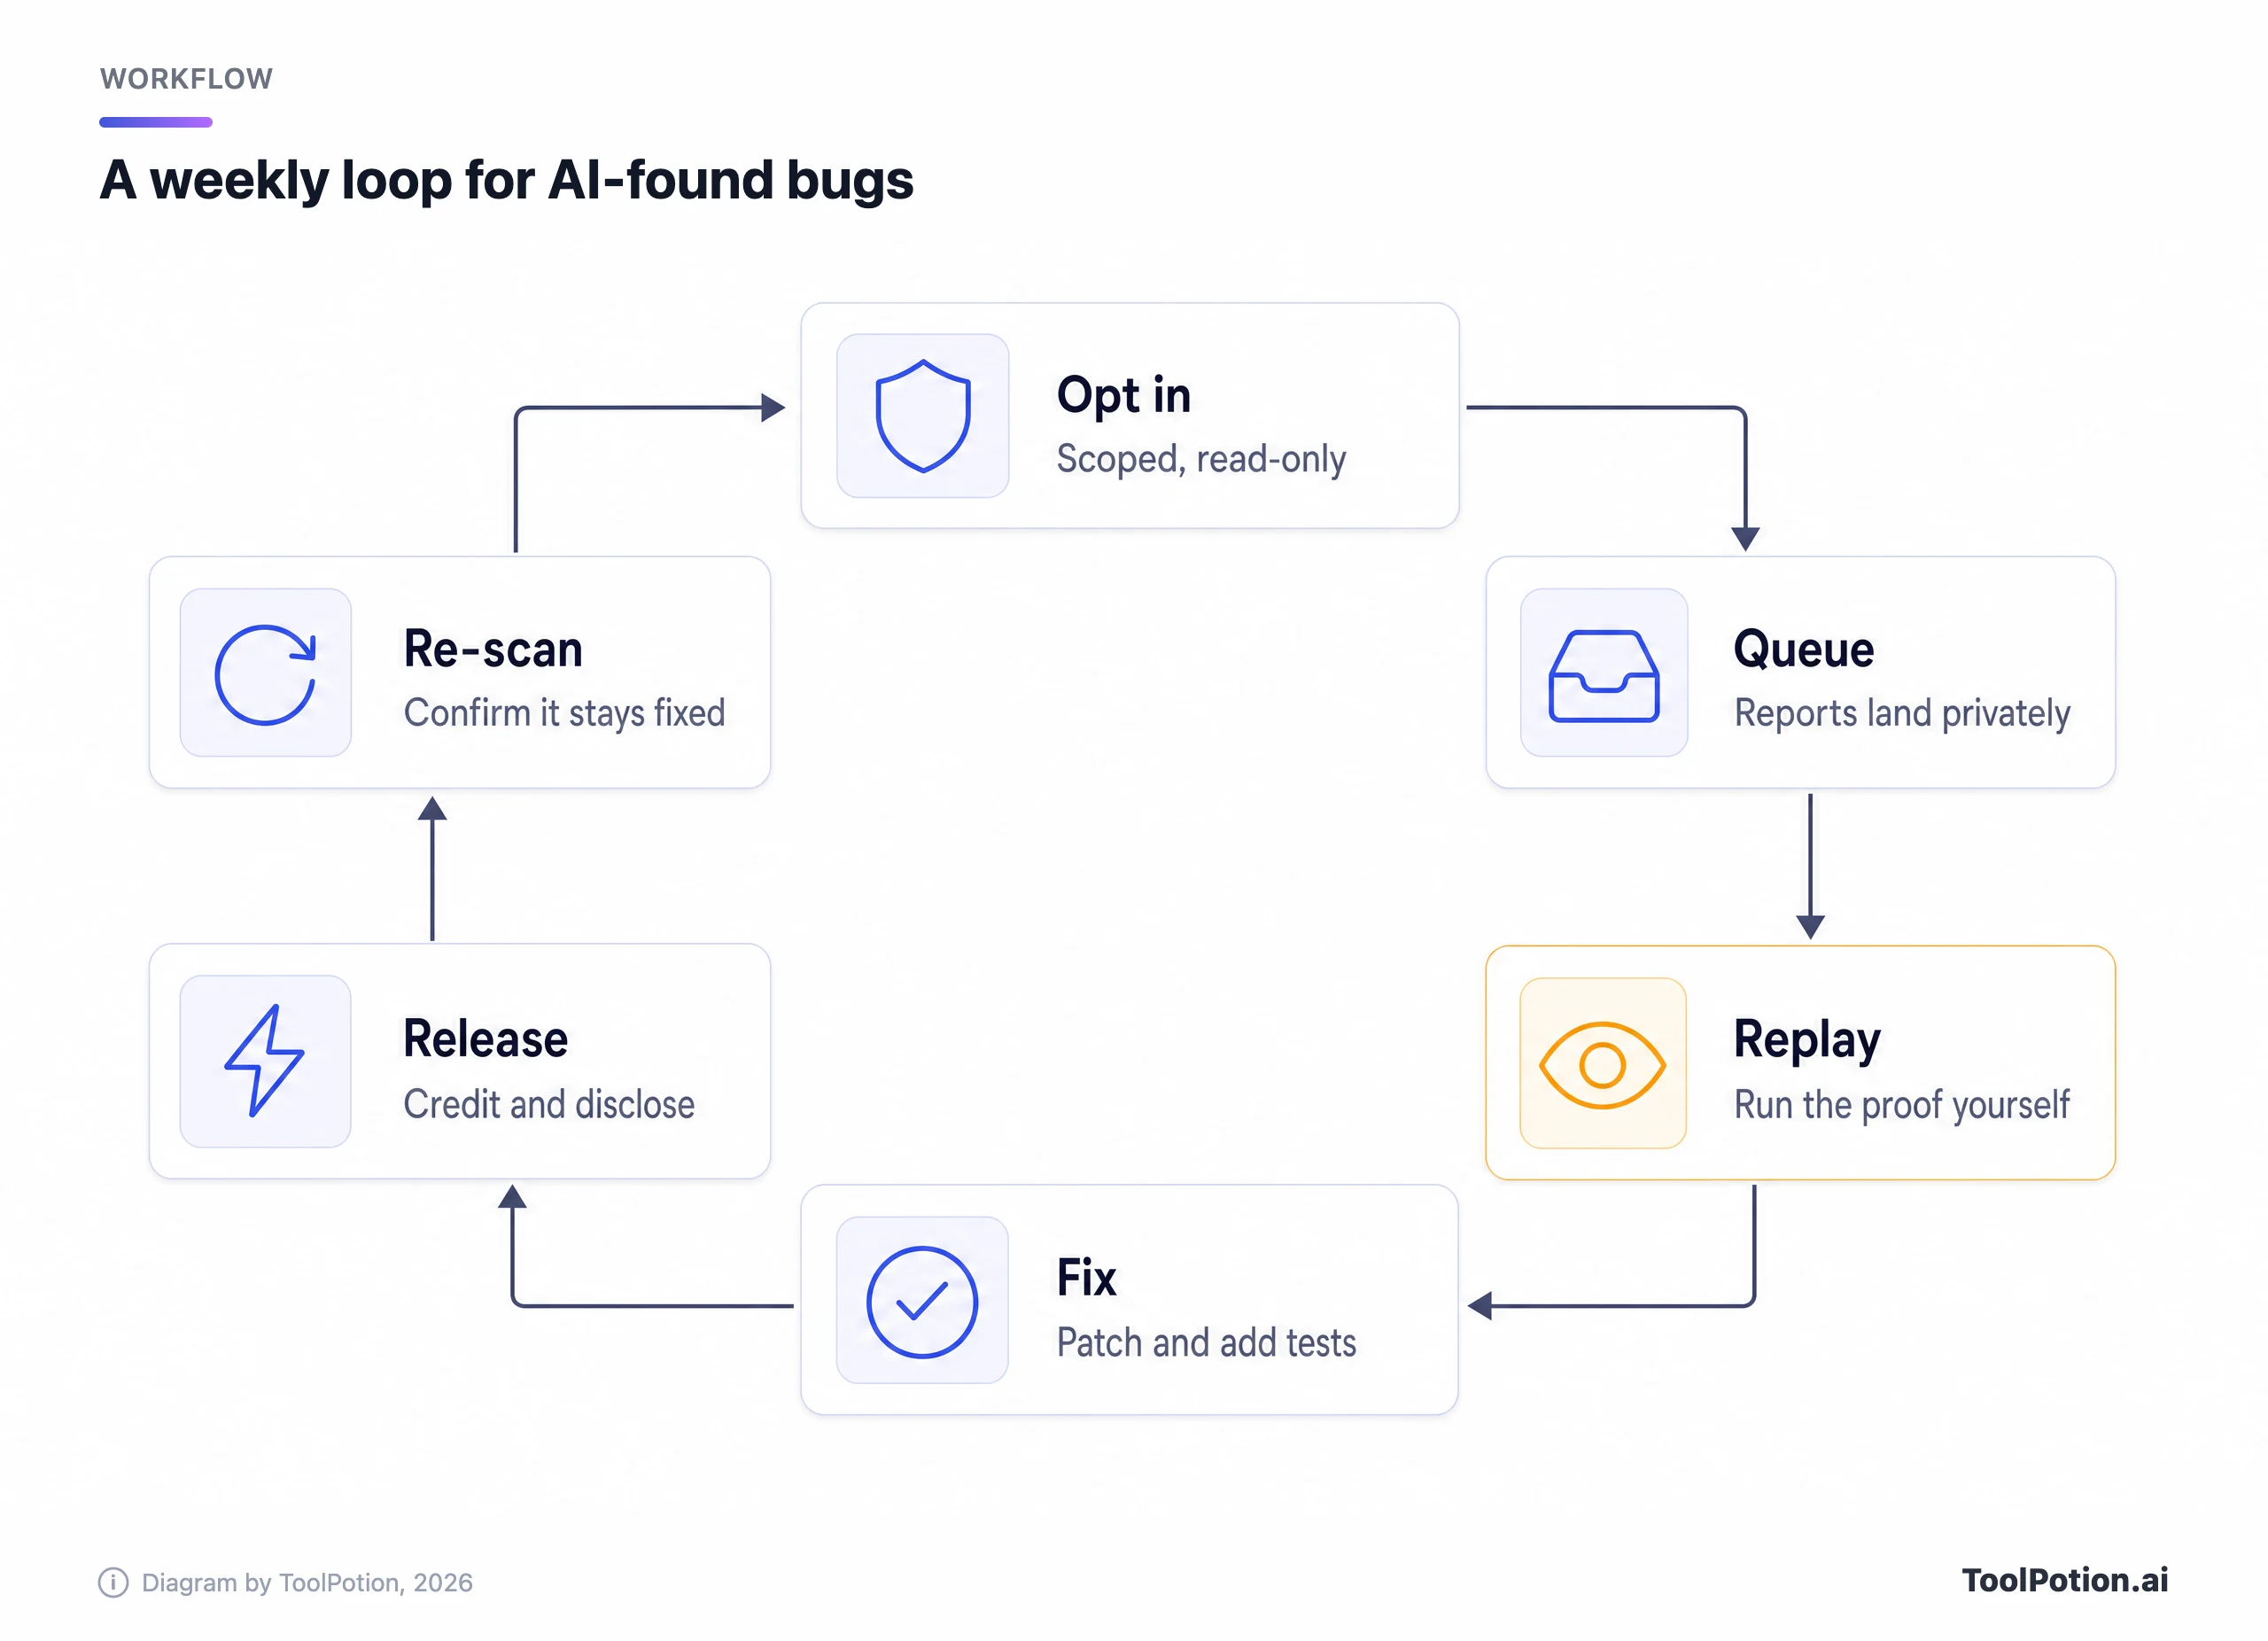
Das Nachspielen trennt einen nützlichen Scanner von einem lauten. Hat ein Report einen Reproducer, führen Sie ihn selbst aus. Hat er keinen, fordern Sie einen an. Ein Modell, das seine Behauptung nicht lauffähig zeigen kann, hat Ihnen eine Theorie geliefert, und Theorien sind billig.
Unsicher, wo Sie anfangen sollen? Der Entscheidungsbaum unten bildet die gängigen Fälle ab. Es ist redaktioneller Rat auf Basis der oben genannten Anbieterbedingungen, passen Sie ihn also an Ihre Situation an.
Für die meisten kleinen Teams ist der bessere erste Schritt ein kostenloser Pull-Request-Scanner plus eine Person, die die Ergebnisse verantwortet. Einen agentischen Tool ergänzen Sie, sobald die Queue einige Wochen ruhig bleibt. Ein Hobby-Repo kommt mit den kostenlosen Standardfunktionen seines Hosts aus. Eine Bibliothek auf einem kritischen Pfad sollte sich dagegen für OSS Scanner bewerben.
Was Triage kostet
Triage-Zeit steht auf keiner Preisseite, und doch entscheidet sie, ob ein Scanner hilft oder schadet. Selbst ein gutes Tool liefert einige Duplikate. Anthropics eigene Prüfung fand 11 bei 97. Der Rechner unten rechnet Ihr Report-Volumen in Stunden um.
Schieben Sie den Anteil ungültiger Reports nach oben und sehen Sie, wie schnell sich die Stunden auftürmen. Senken Sie dann die Minuten pro Report auf 15, als grobes Bild dafür, was ein funktionierender Beweis Ihnen sparen könnte (die Zahl ist eine Illustration, keine Messung). Diese Lücke ist das Argument dafür, Reproducer zu verlangen, von KI-Tools wie von Menschen.
Ein paar Gewohnheiten helfen, sobald die Reports eintreffen. Die Grafik unten fasst sie zusammen.
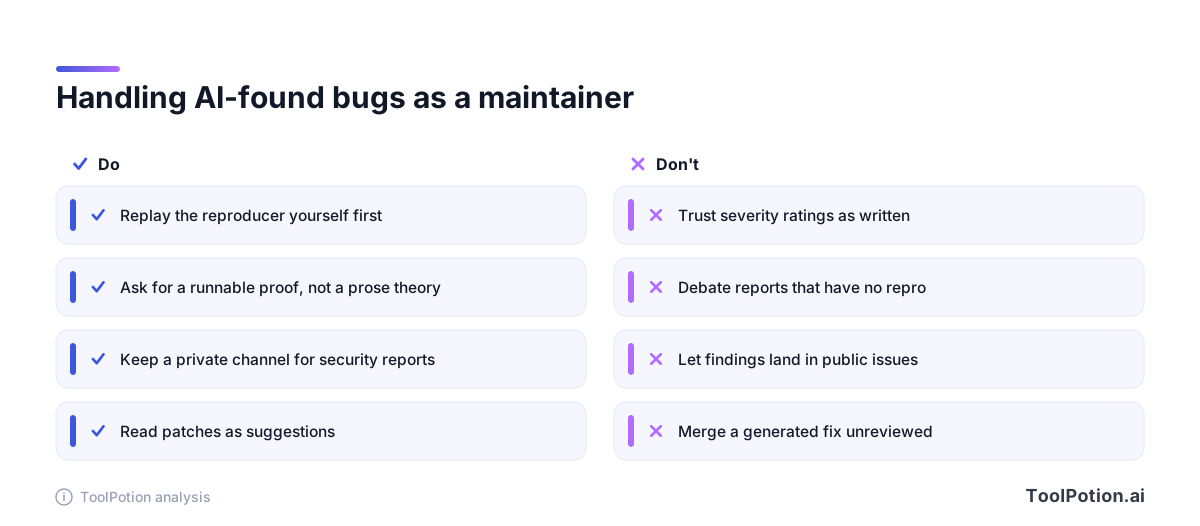
Das erste Paar verdient eine Wiederholung. Schweregrade stammen von einem Modell, und Anthropic selbst warnt, dass sie falsch sein können (SiliconANGLE). Stufen Sie selbst ein, nachdem Sie den Fund nachgespielt haben. Ein Assistent im Stil von Claude Code kann Ihnen helfen, den Fix und den Regressionstest zu schreiben, sobald Sie entschieden haben, dass der Bug echt ist, aber die Entscheidung bleibt bei Ihnen. Mehr zu dieser Art von Tools finden Sie in unserem Board zu Coding-Assistenten und im Guide zu KI-Code-Review-Tools.
Wo diese Tools noch Schwächen haben
Gut sind sie bei Bugklassen, die Spuren im Code hinterlassen: Speicherfehler, Injection, fehlende Prüfungen. Schwächer sind sie bei Fehlern, die davon abhängen, wie ein Unternehmen tatsächlich arbeitet, etwa wer was freigeben darf. Ein Scanner kennt Ihre Absicht nicht.
Sie ersetzen außerdem nicht den Rest der Security. Googles CodeMender lässt Patches von Menschen prüfen, bevor sie Upstream gehen (Google DeepMind), und GitHub sagt, Autofix arbeite nach dem Best-Effort-Prinzip und könne nicht bestätigen, dass ein Fix Alerts aus eigenen Queries behebt (GitHub). Gerade die Anbieter mit dem größten Interesse sagen Ihnen trotzdem, dass Sie den Output prüfen sollen.
Die ehrliche Grenze ist das Volumen. Bugs zu finden wird schneller billiger, als sie zu beheben. Ein Scanner, der einem Dreierprojekt vierzig echte Funde liefert, hat ein Backlog geschaffen, kein sichereres Produkt. Wählen Sie Tools danach, wie viel Sie in einem Monat beheben können, nicht danach, wie viel sie finden können.
Häufig gestellte Fragen
Steht Anthropics OSS Scanner jedem GitHub-Repository offen?
Nein. Er ist Opt-in und wird im Einzelfall bewertet, mit ähnlichen Kriterien wie bei OSS-Fuzz, Projekte brauchen also kritische Bedeutung für Infrastruktur und die Sicherheit der Nutzer. Maintainer bewerben sich per Pull Request im GitHub-Repository von Anthropic.
Ersetzen KI-Scanner einen Penetrationstest?
Nicht bei allem, was für Ihre Kunden zählt. Sie decken Bugs auf Codeebene gut ab, Fehler in der Geschäftslogik dagegen schlecht. Sehen Sie sie als zusätzliche Schicht, die dauerhaft läuft, neben gelegentlichen menschlichen Reviews.
Kann ich Claude oder Gemini direkt nutzen, um meinen Code zu auditieren?
Sie können Code in Claude oder Google Gemini einfügen und ein Security-Review anfordern. Für eine einzelne Funktion hilft das. Es fehlen aber die Sandbox, das repoweite Threat Model und die Exploit-Prüfung, die die oben genannten spezialisierten Agenten mitbringen, rechnen Sie also mit mehr Fehlalarmen.
Was tun, wenn ich einen KI-geschriebenen Report bekomme, der gefälscht wirkt?
Fordern Sie einen Reproducer gegen eine konkrete Version an. Ein echter Fund kann diese Frage beantworten. Ein erfundener oft nicht. Wenn jemand immer wieder solche Reports schickt, dürfen Sie den Report schließen und weitermachen.
Sind kostenlose Scanner für privaten Code sicher?
Lesen Sie bei jedem die Bedingungen. Manche laufen komplett auf Ihrer eigenen Maschine, andere schicken Dateiausschnitte an ein gehostetes Modell. Prüfen Sie, was der Anbieter speichert und wie lange, bevor Sie ein privates Repository verbinden.