

Die Aussage „Platz 1 im Leaderboard" stimmt für einen bestimmten Test, auf eine bestimmte Weise durchgeführt, an einem bestimmten Tag. Ob dieses Modell das beste für Ihre Arbeit ist, sagt sie deutlich weniger aus. Bevor Sie wegen eines Rankings das Tool wechseln oder einen teureren Tarif buchen, klären Sie: Von welchem Board stammt der Wert, wer hat ihn ermittelt, und was wird eigentlich gemessen?
2026 ist das wichtiger denn je, denn Leaderboards sind zum Geschäft geworden. Arena, die öffentliche Ranking-Seite, früher unter dem Namen LMArena bekannt, hat in diesem Jahr 200 Millionen US-Dollar bei einer Bewertung von 3,1 Milliarden US-Dollar eingesammelt – fast doppelt so viel wie die 1,7 Milliarden US-Dollar, mit denen das Unternehmen früher im Jahr 2026 bewertet wurde (Phemex). Arena gibt an, der annualisierte Umsatz liege inzwischen über 100 Millionen US-Dollar (Arena). Jeder Modellstart beginnt heute mit einem Rang, und der Rang verkauft.
Das heißt nicht, dass die Boards unseriös wären. Die meisten stammen von ernsthaften Leuten und messen tatsächlich etwas. Das Problem: Jedes misst etwas anderes, und ein Launch-Post zitiert genau das Board, das dem Modell schmeichelt. Dieser Leitfaden erklärt, wie die wichtigsten Boards funktionieren, wo sie jeweils verzerren und wie Sie einen Claim in etwa zwei Minuten einordnen.
Vier Arten von Boards, vier unterschiedliche Fragen
Die meisten Rankings, denen Sie begegnen, lassen sich in vier Gruppen einteilen. Die Gruppen sind wichtiger als jedes einzelne Board, denn eine Zahl hat erst dann eine Bedeutung, wenn Sie wissen, aus welcher Gruppe sie kommt.
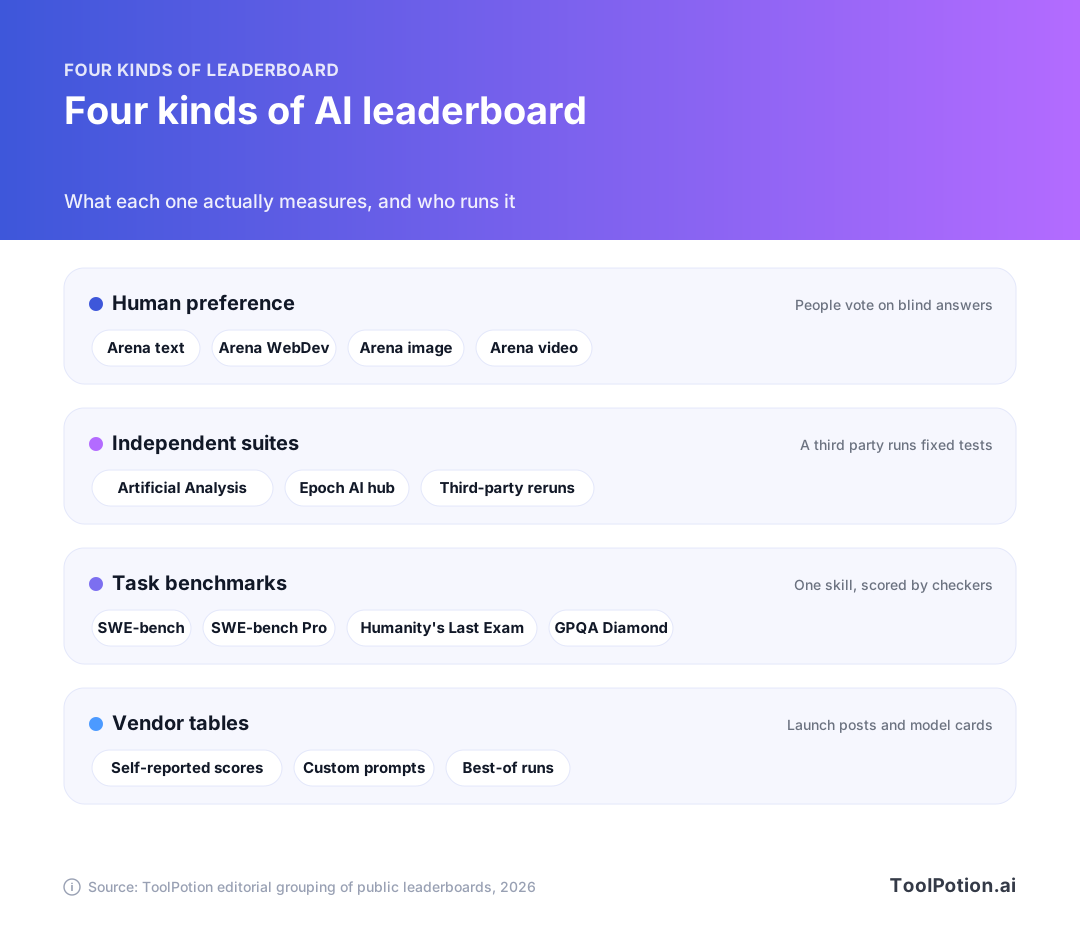
Präferenz-Arenen fragen Menschen, welche Antwort ihnen besser gefällt. Unabhängige Suites lassen für jedes Modell dieselben Tests unter denselben Bedingungen laufen. Task-Benchmarks prüfen mit automatischer Auswertung eine einzelne Fähigkeit, etwa das Beheben echter Softwarefehler. Herstellertabellen sind die Werte, die ein Lab im eigenen Launch-Post oder in der Model Card veröffentlicht, meist mit Einstellungen, die das Lab selbst gewählt hat.
Die Gruppen konkurrieren nicht so sehr miteinander, sie beantworten schlicht verschiedene Fragen. Präferenz zeigt, mit welchem Modell Menschen gern arbeiten. Eine Suite zeigt, wie Modelle abschneiden, wenn eine neutrale Stelle die Stoppuhr hält. Ein Task-Benchmark zeigt, ob ein Modell eine eng umrissene Aufgabe beherrscht. Eine Herstellertabelle zeigt, was das Lab Sie sehen lassen möchte.
| Board-Typ | Beispiel | Was gemessen wird | Größte Schwäche |
|---|---|---|---|
| Nutzerpräferenz | Arena Text und WebDev | Für welche Antwort Menschen stimmen | Belohnt Stil und Länge, manipulierbar |
| Unabhängige Suite | Artificial Analysis, Epoch AI Hub | Ergebnisse auf einem festen Testset | Nur so gut wie die gewählten Tests |
| Task-Benchmark | SWE-bench, Humanity's Last Exam | Eine Fähigkeit, automatisch bewertet | Kontamination, fehlerhafte Aufgaben, Sättigung |
| Herstellertabelle | Launch-Posts, Model Cards | Was das Lab zu berichten beschlossen hat | Einstellungen und Prompts nicht überprüfbar |
Wie aus einer Arena-Stimme ein Rating wird
Arena begann als Chatbot Arena, ein Forschungsprojekt der UC Berkeley. Die Idee ist simpel: Sie geben einen Prompt ein, zwei anonyme Modelle antworten, und Sie wählen die bessere Antwort. Das Originalpaper der Forschenden beschreibt eine Plattform, die in den ersten Monaten mehr als 240.000 Stimmen gesammelt hatte, und stellt fest, dass die Stimmen der Masse gut mit Expertenurteilen übereinstimmten (arXiv).
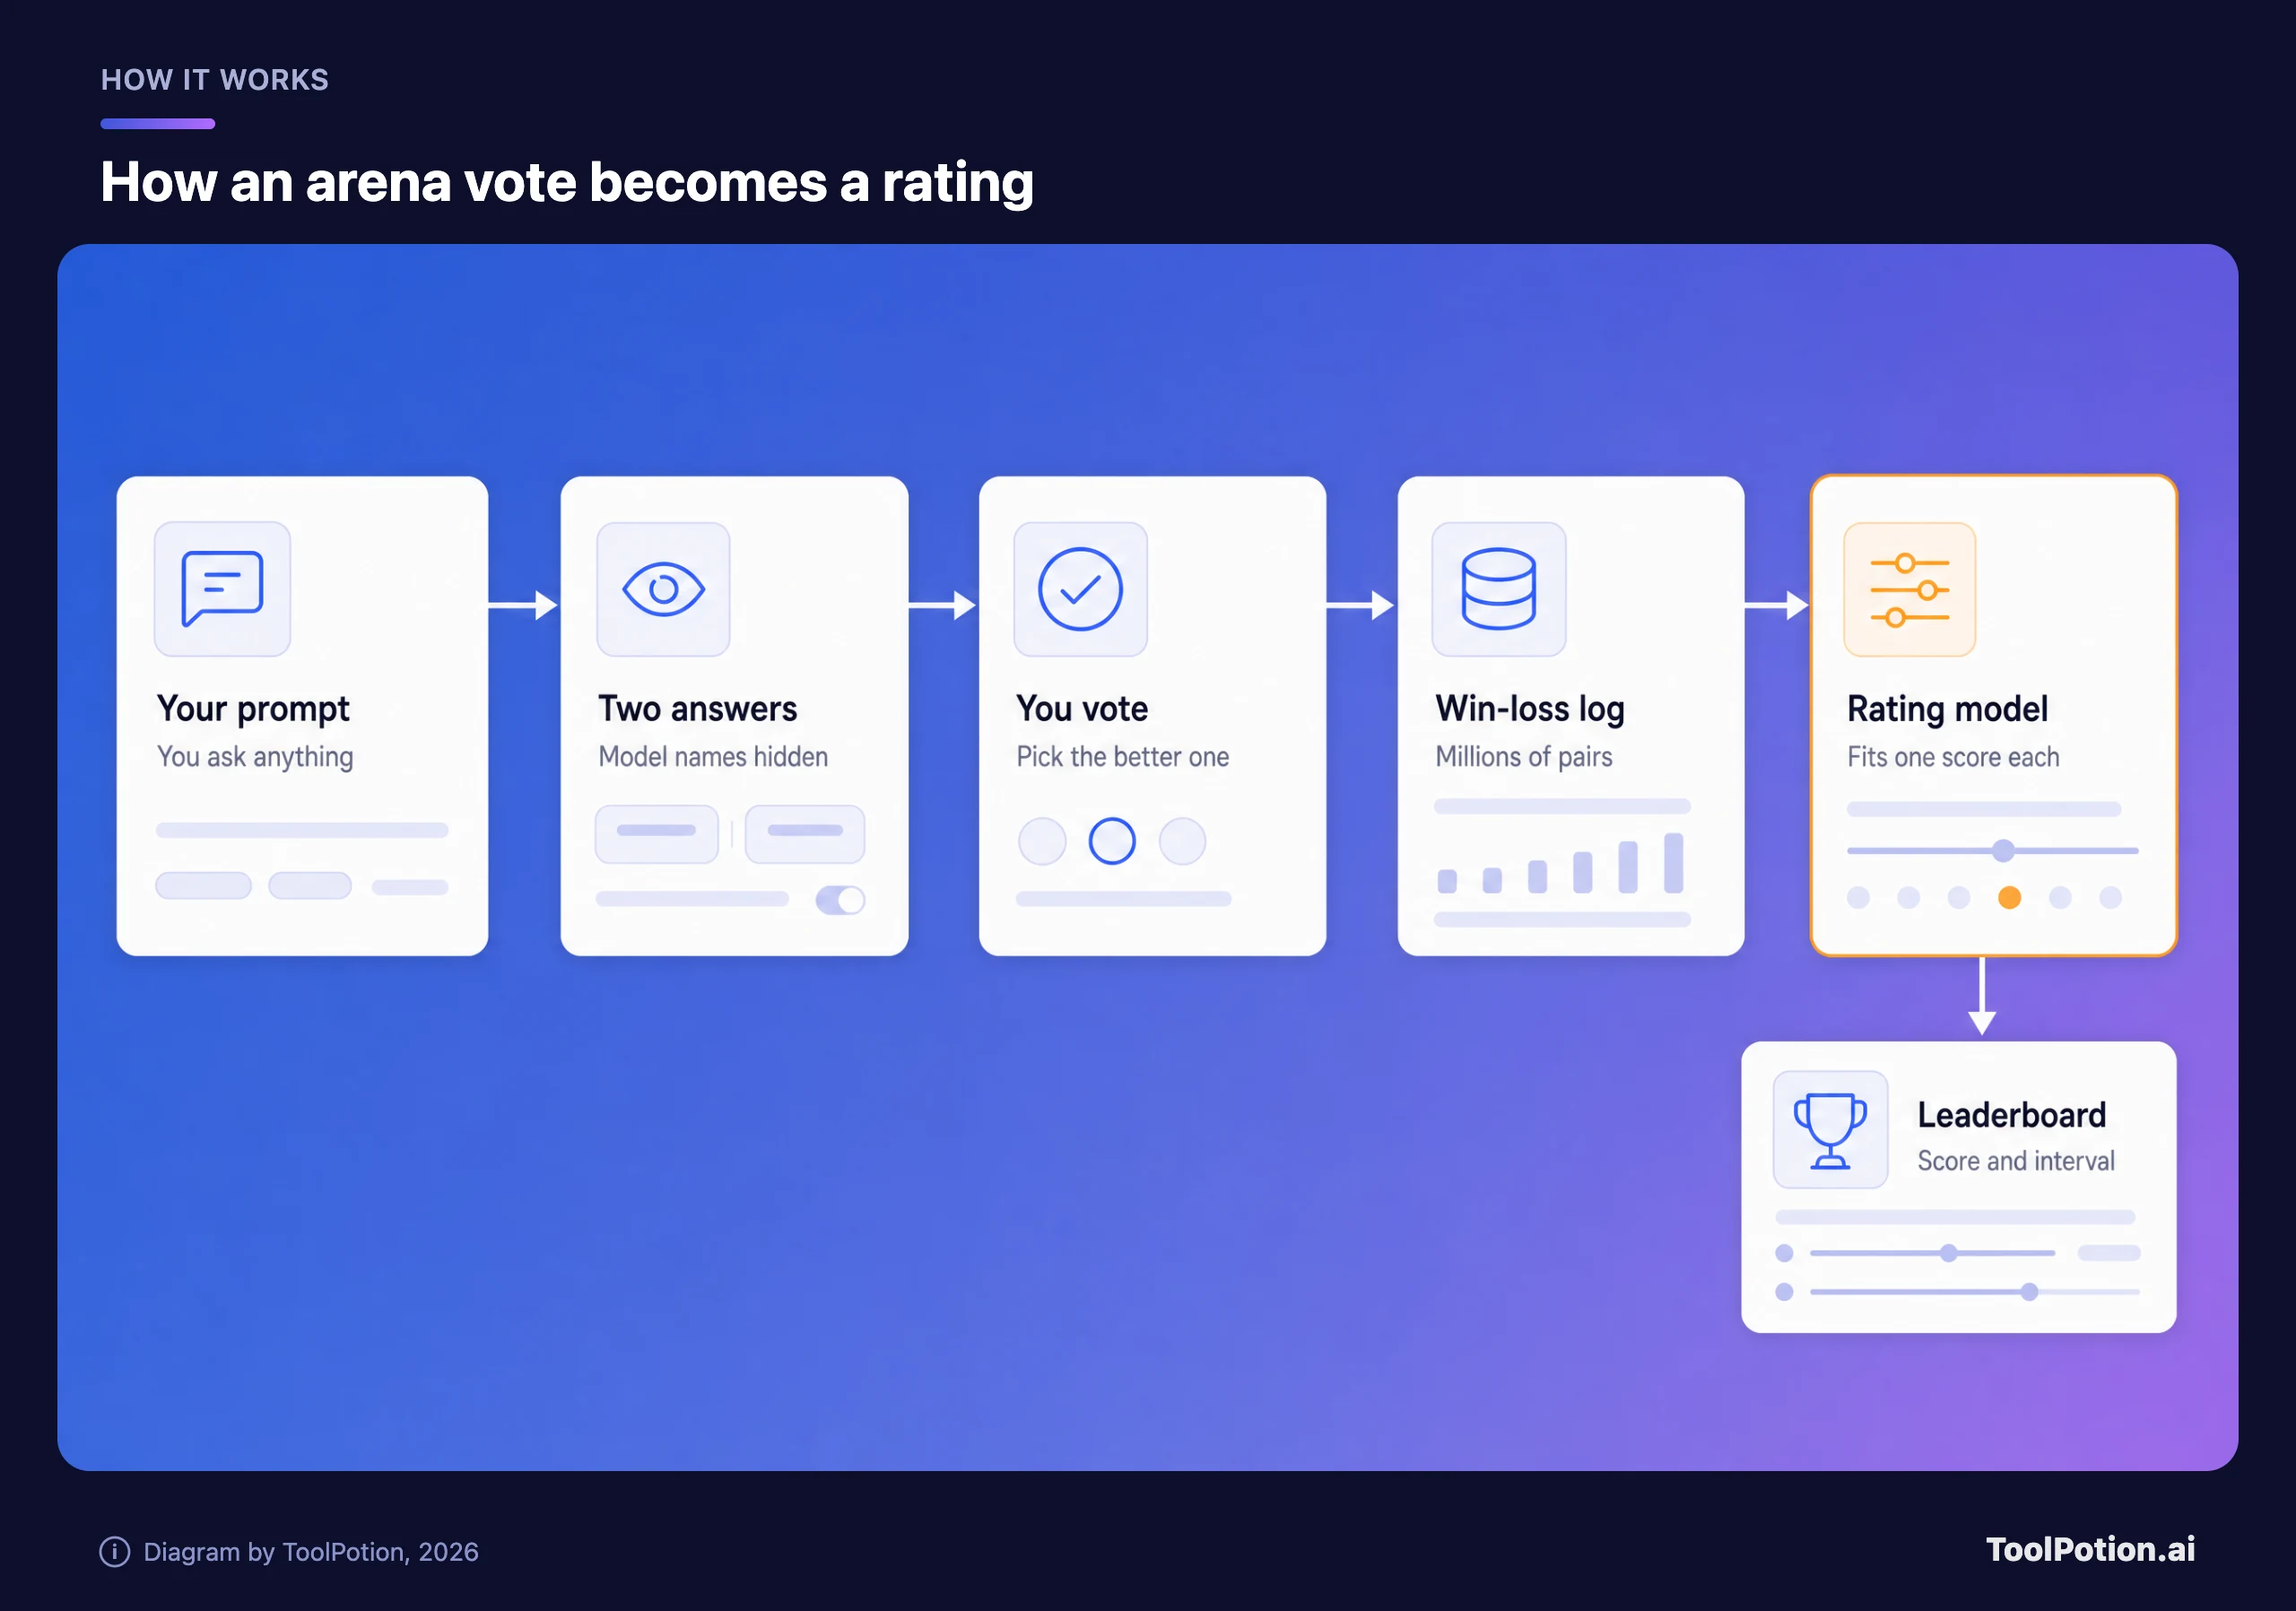
Jede Stimme ist ein winziger Datensatz: Modell A hat bei diesem Prompt Modell B geschlagen. Millionen solcher Datensätze fließen in ein statistisches Modell, das jedem Modell einen einzigen Score zuweist. Arena beschreibt die Methode in eigenen Beiträgen als Bradley-Terry-Regression, eng verwandt mit dem Elo-System aus dem Schach (LMSYS). Der Score eines Modells steigt, wenn es starke Gegner schlägt, und sinkt, wenn es gegen schwache verliert. Das Text-Leaderboard zeigt neben jedem Score ein Intervall (die „±"-Angabe) und nicht nur den Punktwert.
Dieses Intervall lassen Launch-Posts gern weg. Liegen zwei Modelle nur wenige Punkte auseinander und überlappen sich ihre Intervalle, ist die ehrliche Lesart ein Unentschieden. Ein „Platz 1" mit zwei, drei Punkten Vorsprung ist meist ein statistischer Münzwurf.
Arena ist längst über den Chat hinausgewachsen. Das Leaderboard hat inzwischen eigene Boards für Text, WebDev, Vision, Suche, Bildgenerierung und -bearbeitung sowie Video, dazu ein neueres Agent-Board, das neben der Gewinnrate die Kosten pro Aufgabe ausweist (Arena). Die Kostenspalte lohnt den Blick. Ein Modell, das einen Platz höher steht, aber ein Vielfaches kostet, ist eine ganz andere Empfehlung.
Was eine Arena Ihnen nicht verrät
Präferenzabstimmungen haben drei gut dokumentierte Probleme. Das erste ist der Stil. Menschen mögen lange, gut formatierte Antworten, deshalb kann ein Modell aufsteigen, indem es mehr schreibt und Überschriften einbaut. Die Analyse des Arena-Teams selbst ergab, dass die Antwortlänge der dominante Stileffekt war und dass die Korrektur von Länge und Markdown die Reihenfolge der Modelle verschob. In dieser Analyse von 2024 fiel GPT-4o-mini von Platz sechs auf elf, während Claude 3.5 Sonnet von Platz sechs auf vier stieg (LMSYS). Arena bietet inzwischen stilkontrollierte Ansichten an, und es lohnt sich, sie zu nutzen.
Das zweite Problem ist der Zugang. Ein Paper von 2025 mit dem Titel „The Leaderboard Illusion", unter anderem von Sayash Kapoor und Noah Smith, argumentierte, große Labs hätten auf Arena strukturelle Vorteile. Demnach testete Meta vor dem Release von Llama 4 27 private Modellvarianten und veröffentlichte nur den besten Score. Außerdem schätzten die Autoren, dass Google und OpenAI etwa 19,2 % bzw. 20,4 % aller Arena-Daten erhielten, während 83 Open-Weight-Modelle zusammen auf rund 29,7 % kamen (arXiv).
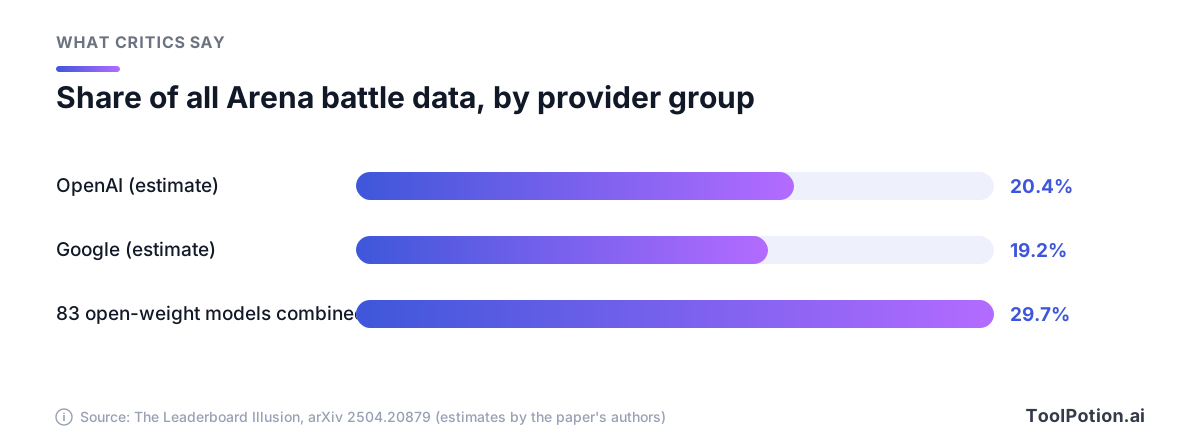
Das Paper berichtete außerdem, dass Training mit Arena-ähnlichen Daten die Leistung auf der Arena-Verteilung um bis zu 112 % steigern kann. Das ist ein Anreiz, auf das Board hin zu optimieren statt auf allgemeine Leistungsfähigkeit. Das sind Schätzungen und Behauptungen der Autoren, und sie bilden den Stand zum Zeitpunkt des Papers ab. Dennoch sind sie die klarste externe Beschreibung dafür, wie sich ein Präferenz-Board manipulieren lässt, ohne dass jemand eine Regel bricht.
Das dritte Problem: Präferenz ist nicht Korrektheit. Eine selbstsichere, freundliche Antwort kann eine Abstimmung gewinnen und trotzdem einen falschen Fakt enthalten. Für das Gefühl im Chat und fürs Schreiben ist Präferenz ein brauchbarer Maßstab. Bei Code, der laufen muss, oder Zahlen, die stimmen müssen, taugt sie wenig.
Die aktuelle Policy-Seite von Arena greift einiges davon auf. Sie besagt, dass Modelle vor dem Release unter anonymen Namen getestet werden, bis sich die Scores stabilisiert haben (mindestens 1.000 Stimmen), dass diese Scores privat an den Anbieter gehen und dass der Score eines Modells nach dem öffentlichen Release als „preliminary" gekennzeichnet bleibt, bis neue Stimmen vorliegen. Außerdem soll jedes Duell mindestens ein öffentlich verfügbares Modell enthalten, und in mindestens 20 % der Duelle treten nur öffentliche Modelle an (Arena). Die Faustregel: Ein „preliminary"-Hinweis heißt, dass die Zahl noch nicht belastbar ist.
Unabhängige Suites: Artificial Analysis und Epoch AI
Fragen Präferenz-Boards, was Menschen gefällt, fragen unabhängige Suites, was ein Modell leistet, wenn alle denselben Test bekommen. Artificial Analysis ist die bekannteste. Der Intelligence Index, aktuell in Version 4.3.2, fasst 10 Evaluierungen in vier Gruppen zusammen: Agenten (30 % Gewicht), Allgemeinwissen und Reasoning (30 %), Coding (20 %) und wissenschaftliches Reasoning (20 %). Jedes Modell läuft unter denselben Bedingungen mit pass@1-Auswertung, also einem Versuch pro Frage, und laut Seite hält Artificial Analysis eigene Kopien der Datensätze vor. Für subjektive Bewertungen kommt ein Gremium aus drei Frontier-Modellen verschiedener Labs zum Einsatz. Der Index ist überwiegend englisch und textbasiert; mehrsprachige und multimodale Fähigkeiten bewertet die Seite separat (Artificial Analysis).
Die Gewichtung ist eine redaktionelle Entscheidung. Mit weniger Gewicht auf Agenten und mehr auf Coding würden einige Modelle anders einsortiert. Das ist kein Makel, aber die „Gesamtzahl" ist eben eine Meinung dazu, was zählt. Wenn es Ihnen vor allem um Coding geht, lesen Sie die Coding-Ergebnisse statt der Schlagzeilenzahl.
Epoch AI betreibt einen Benchmarking-Hub, der selbst durchgeführte Tests wie GPQA Diamond, FrontierMath und SWE-bench Verified mit Ergebnissen externer Quellen kombiniert. Die für Leser nützlichste Erkenntnis betrifft Herstellerzahlen: Für Claude 3.5 Sonnet wurden 65 % auf GPQA Diamond angegeben. Epoch maß über 16 Durchläufe 55 %, plus/minus 3, und merkte an, dass Labs oft weder Prompt noch Temperatur veröffentlichen (Epoch AI). Zehn Punkte Abweichung allein durch das Setup sind ein guter Grund, Wiederholungsläufe durch Dritte zu bevorzugen. Der Hub wird vom UK AI Security Institute finanziert, und seine Daten sind frei nutzbar.
Unabhängig heißt nicht unvoreingenommen. Ein Dritter wählt trotzdem die Tests aus, und jeder Index mit LLM-Juroren übernimmt deren Gewohnheiten. Arenas eigene Studie zu KI-Juroren fand, dass Modelle ihre eigenen Antworten bevorzugen: Bei 1.460 Text-Arena-Duellen, bewertet von 12 Modellen, wählten die Juroren ihre eigenen Antworten rund 70 % häufiger als Menschen es taten (Arena).
Benchmarks nutzen sich ab
Task-Benchmarks haben das umgekehrte Problem. Sie sind objektiv, altern aber schnell. Ein Benchmark startet schwer, Labs optimieren darauf, die Scores steigen, der Test sickert in die Trainingsdaten, und bald liegen alle Top-Modelle nahe der Obergrenze, sodass das Ranking nichts mehr aussagt.
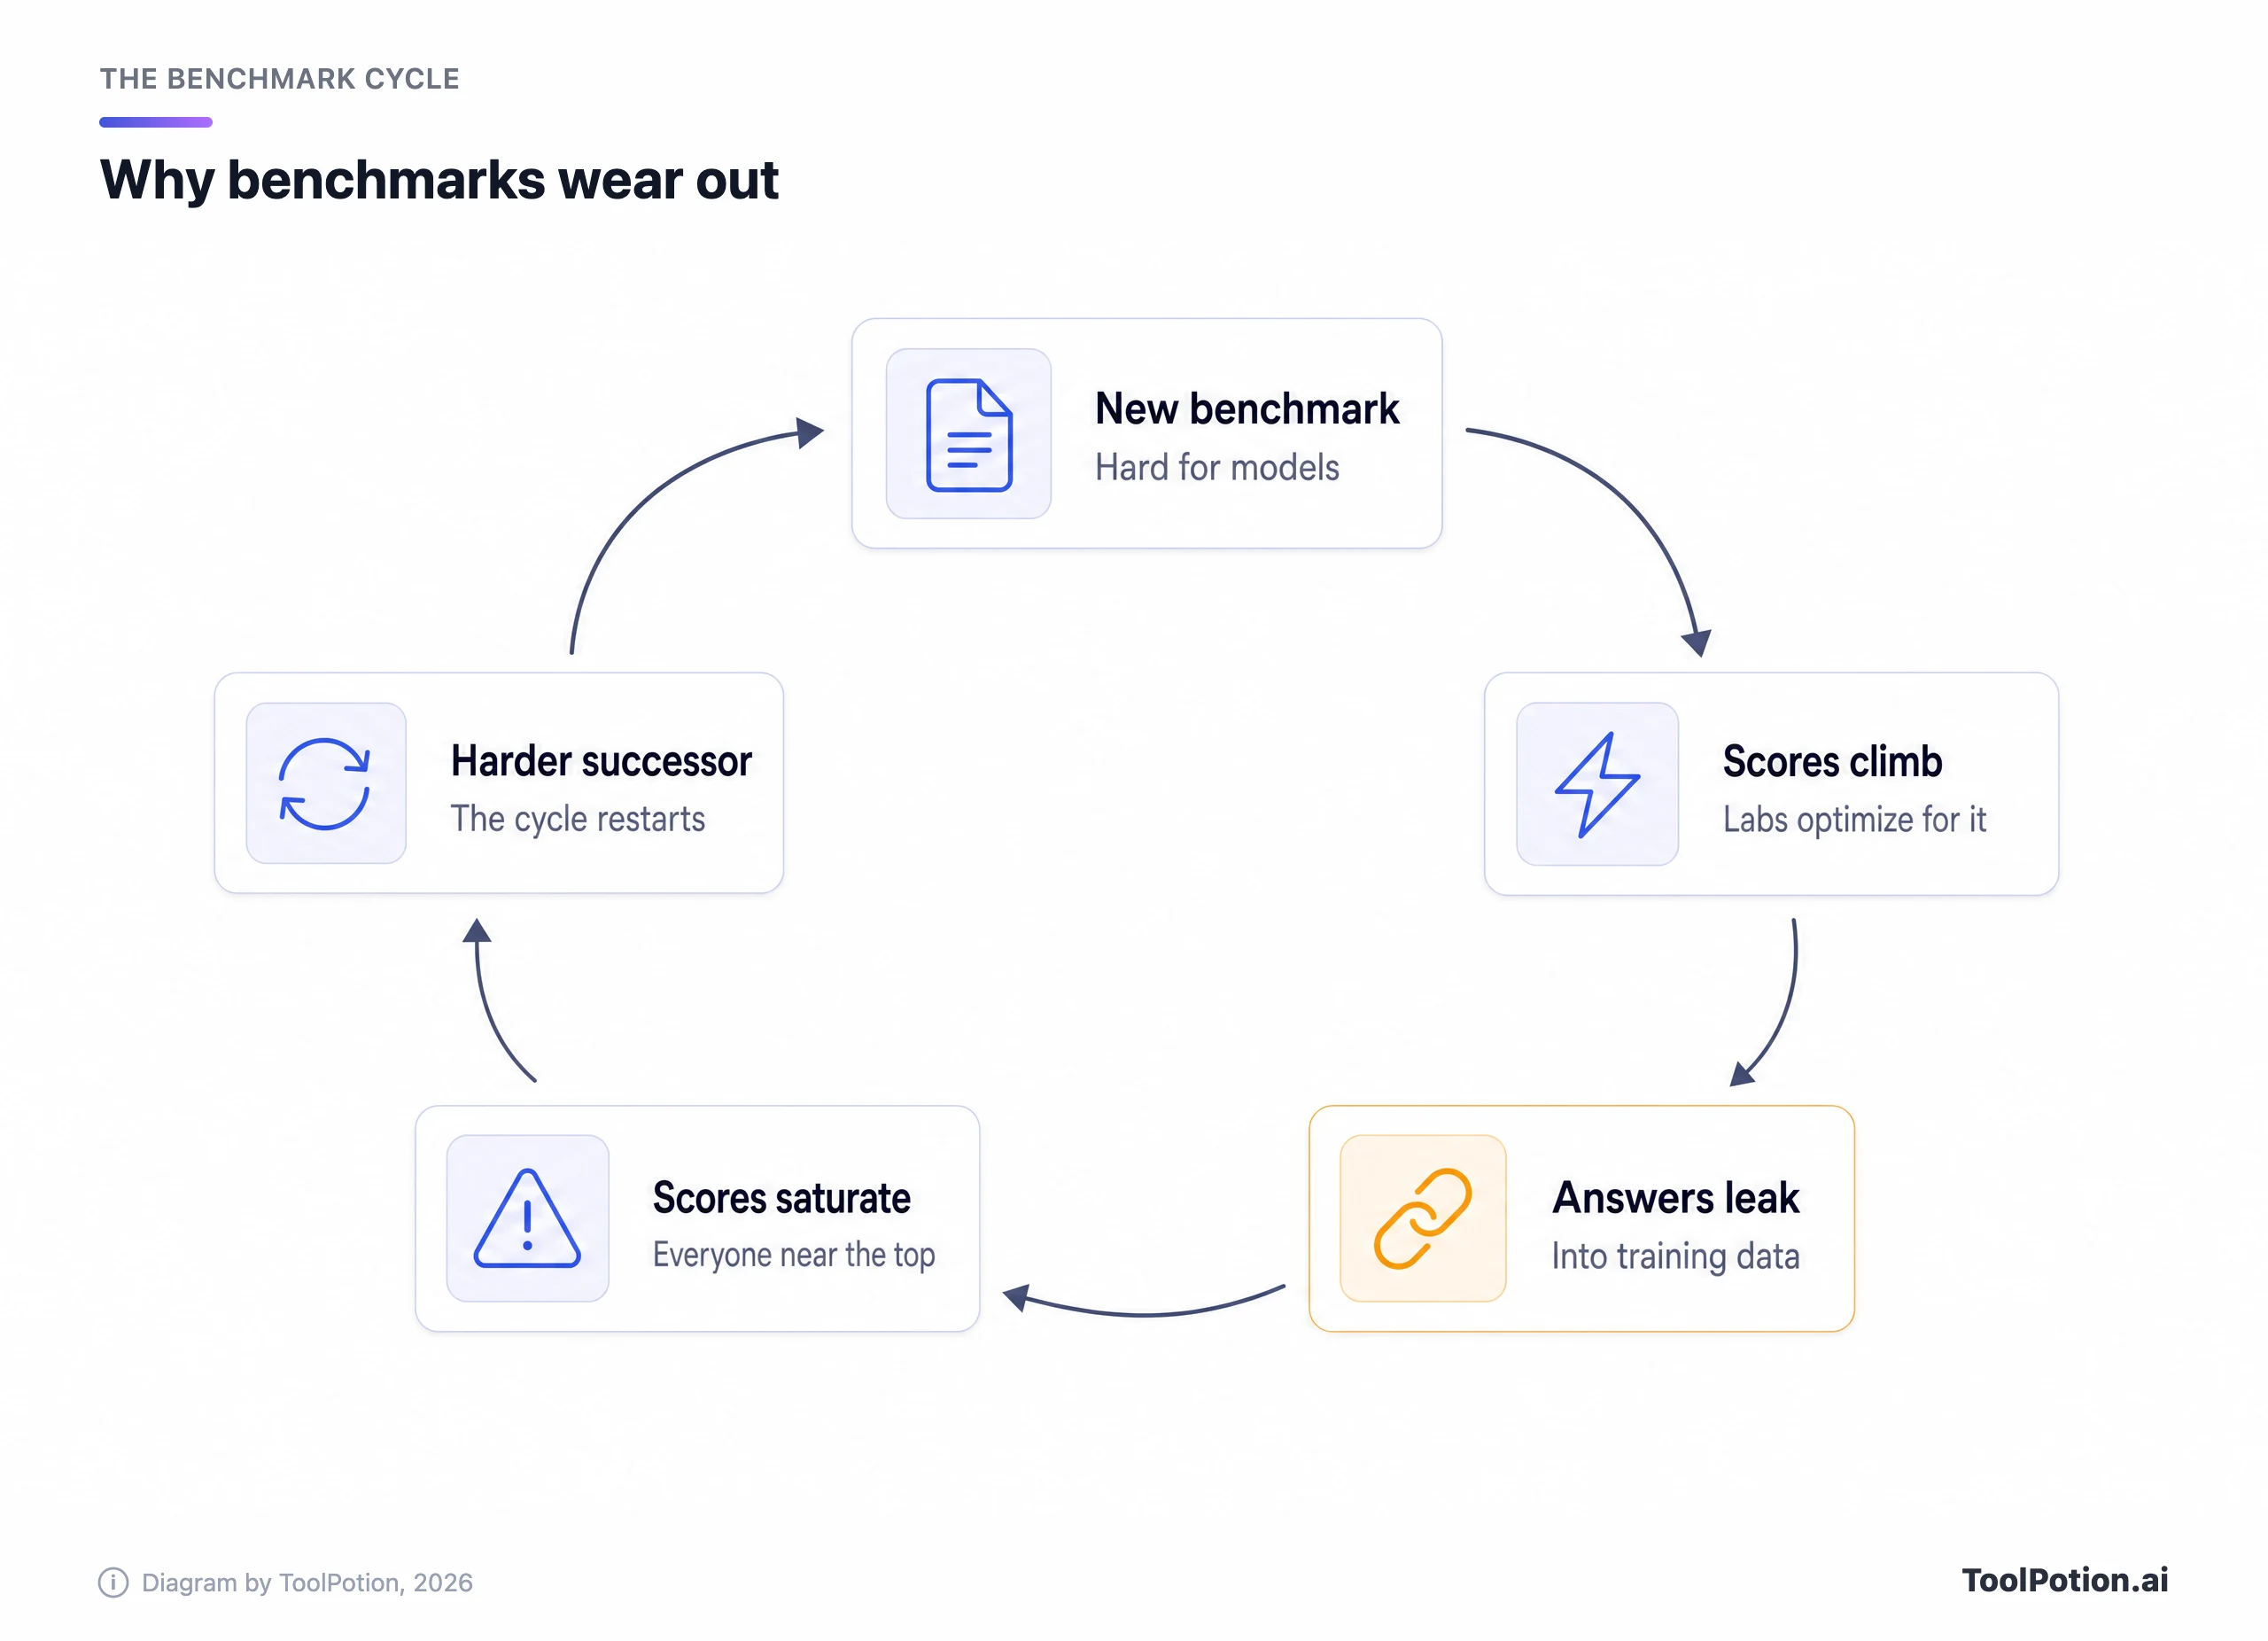
Humanity's Last Exam ist ein gutes Beispiel für die Gegenreaktion. Der Test umfasst 2.500 Fragen aus über hundert Fachgebieten, verfasst von knapp 1.000 Experten an mehr als 500 Institutionen, und hält ein privates Testset zurück, um Overfitting aufzudecken. Die Autoren haben ihn gebaut, weil ältere Tests wie MMLU von Frontier-Modellen über die 90-%-Marke gedrückt worden waren (arXiv). 2026 erschien er in Nature, und selbst seine Schöpfer rechneten mit schnell steigenden Scores.
SWE-bench zeigt den gesamten Lebenszyklus. Der ursprüngliche Benchmark enthielt 2.294 echte GitHub-Issues aus 12 Python-Projekten, und das beste Modell der Zeit, Claude 2, löste 1,96 % davon (laut Originalpaper). Eine bereinigte Teilmenge mit 500 Aufgaben, genannt Verified, wurde zur Standardzahl in Coding-Launches. Dann kam das Audit.
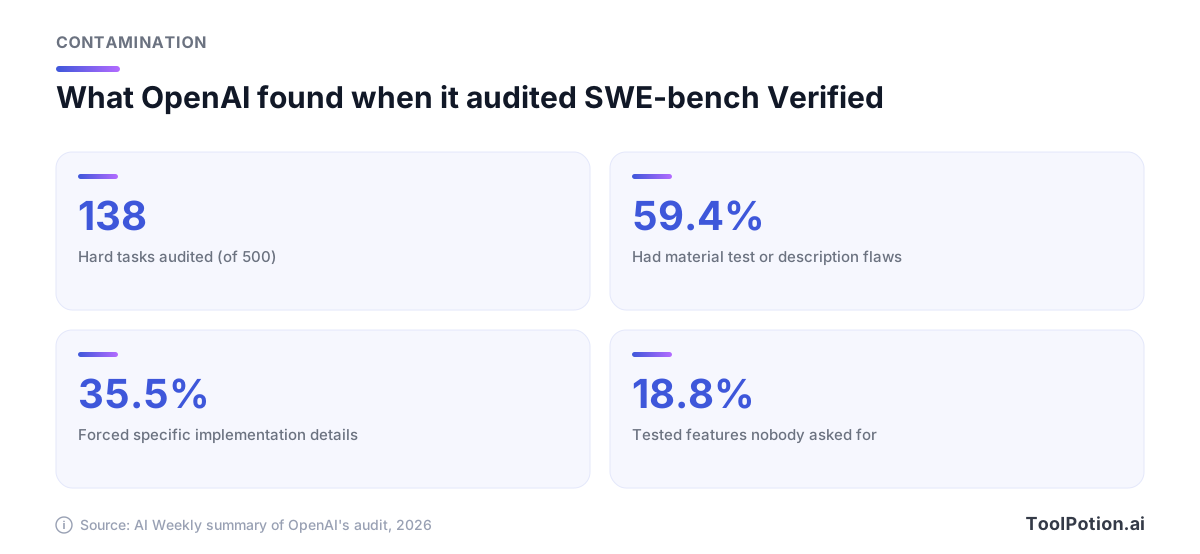
OpenAI prüfte 138 Verified-Aufgaben, die sein Modell o3 nicht zuverlässig löste, jede von mindestens sechs Engineers begutachtet. Ergebnis: Bei 59,4 % gab es gravierende Probleme in den Tests oder Beschreibungen. In einem separaten Kontaminationstest konnten GPT-5.2, Claude Opus 4.5 und Gemini 3 Flash Preview jeweils Details der ursprünglichen Fixes reproduzieren – ein Hinweis darauf, dass die Aufgaben in die Trainingsdaten gelangt waren. OpenAI erklärt, keine Verified-Scores mehr zu berichten, und empfiehlt stattdessen SWE-bench Pro (OpenAI). Die Zusammenfassung von AI Weekly ergänzt, dass Top-Modelle auf Verified bei rund 80 % lagen und auf Pro etwa 35 Punkte niedriger, und dass ein späteres externes Audit auch die Auswertung von Pro infrage stellte (AI Weekly).
Die Lehre ist nicht, dass Coding-Benchmarks nutzlos wären. Aber ein Score aus einem ausgemusterten oder undichten Test ist eine veraltete Zahl. Wenn ein Launch-Post SWE-bench zitiert, prüfen Sie die Variante und das Agent-Scaffolding um das Modell herum. Arenas „HarnessTax"-Studie mit 21 Paaren aus Modell und Scaffolding fand, dass die Wahl des Scaffoldings kaum Einfluss auf den Aufgabenerfolg hatte, die Kosten bei ähnlichem Ergebnis aber um bis zu das Fünffache veränderte – bei einer kleinen Stichprobe von 30 Aufgaben pro Benchmark (Arena).
Checkliste für jeden Platz-1-Claim
Hier die Zwei-Minuten-Version. Gehen Sie sie durch, bevor Sie einem Ranking glauben, und erst recht, bevor Sie seinetwegen Geld ausgeben.
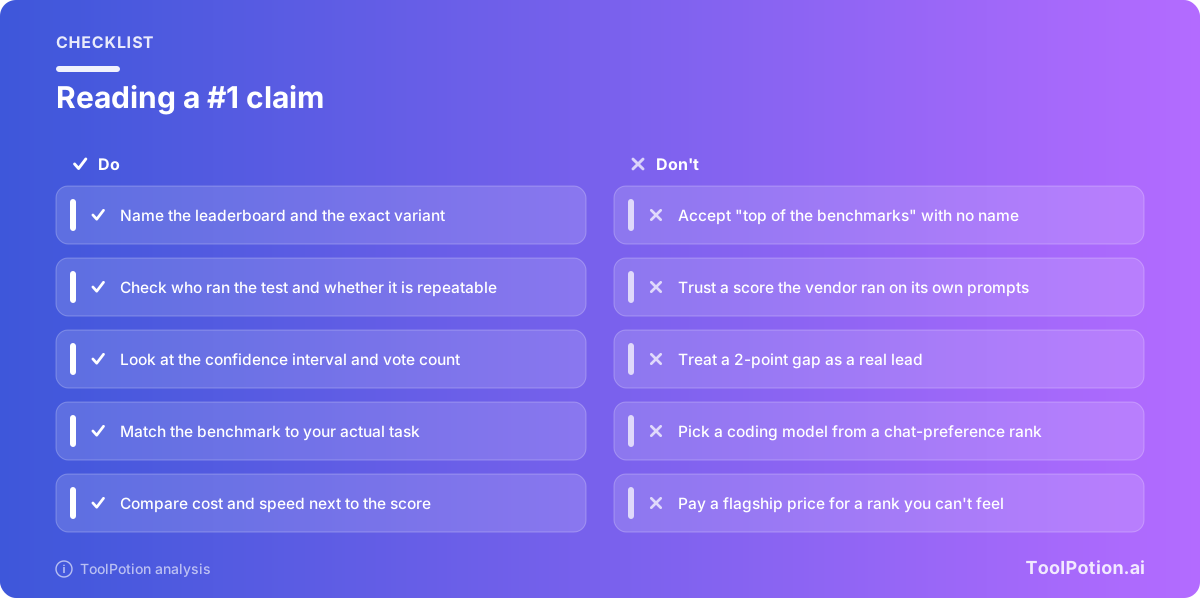
- Finden Sie das genaue Board und die Version heraus. „Führt die Benchmarks an" lässt sich nicht prüfen. „Platz 1 auf Arena Text mit Stilkontrolle" schon.
- Finden Sie heraus, wer den Test durchgeführt hat. Ein Lauf des Labs mit eigenen Prompts ist eine Marketingzahl. Ein Wiederholungslauf durch Dritte hat mehr Gewicht.
- Lesen Sie Intervall und Stimmenzahl. Ist der Vorsprung kleiner als das Intervall, ist es ein Unentschieden.
- Prüfen Sie, ob das Modell öffentlich verfügbar ist. Ein Score für etwas, das Sie heute nicht ausprobieren können, hilft bei der Auswahl nicht.
- Fragen Sie sich, ob der Test zu Ihrer Aufgabe passt. Chat-Präferenz sagt nicht voraus, wie ein Modell mit Ihren Tabellen oder Ihrer Codebasis zurechtkommt.
- Suchen Sie ein zweites, anderes Board, das zustimmt. Ein Board kann falsch liegen oder manipuliert sein. Dass zwei voneinander unabhängige übereinstimmen, ist viel schwerer zu fälschen.
- Stellen Sie Preis und Geschwindigkeit neben den Score. Das günstigere Modell, das zwei Plätze tiefer steht, ist oft der bessere Kauf.
Mit der folgenden Checkliste können Sie einen Claim selbst bewerten. Sie gewichtet das stärker, was sich am schwersten fälschen lässt, etwa Läufe durch Dritte und Übereinstimmung zwischen Boards.
Das Board zu Ihrer Frage finden
Weil die Boards unterschiedliche Fragen beantworten, gehen Sie am besten von Ihrer Frage aus und wählen das Board erst danach. Suchen Sie einen Assistenten fürs Schreiben und für Gespräche, ist eine Präferenz-Arena ein brauchbarer erster Filter. Wollen Sie die rohe Leistung reproduzierbar vergleichen, nehmen Sie eine unabhängige Suite. Wählen Sie ein Coding-Tool, schauen Sie auf Task-Benchmarks mit echten Repositories und testen dann an Ihrem eigenen Code.
Der Entscheidungsbaum liefert einen Ausgangspunkt, kein Urteil. Auf welchem Board Sie auch landen: Ein kurzer Test mit Ihrer eigenen Arbeit schlägt jedes öffentliche Ranking. Nehmen Sie 10 echte Aufgaben, die Sie jede Woche erledigen, lassen Sie sie durch zwei oder drei Finalisten laufen und vergleichen Sie die Ergebnisse nebeneinander. Das dauert einen Nachmittag und misst das Einzige, was kein Leaderboard messen kann: Ihre Arbeit.
Wenn Sie nach Kategorie suchen: Das ToolPotion Verzeichnis für KI-Modelle & LLMs und das KI-Modell-Board listen Modelle nebeneinander auf, und der Leitfaden zum Zuordnen von KI-Modell-Stufen zu Aufgaben erklärt, wann sich ein Flaggschiff lohnt. Einen breiteren Überblick bietet Top 15 AI Models & LLMs in 2026, oder ChatGPT-Alternativen 2026, wenn ein bestimmter Assistent Ihr Ausgangspunkt ist.
Wo die Zahlen am wenigsten verlässlich sind
Einige Situationen verlangen besonderes Misstrauen. Neue Modelle haben in den ersten Tagen weniger Stimmen und breitere Intervalle, und Arena kennzeichnet diese Scores nicht ohne Grund als „preliminary". Open-Weight-Modelle, die Sie von Hugging Face herunterladen können, sind der andere blinde Fleck: Die Autoren der Leaderboard Illusion schätzten, dass sie einen kleineren Anteil der Arena-Daten erhalten, ihre Scores also verrauschter sein können. Auch gehostete Modelle können sich unter demselben Namen verändern, sodass ein Score aus der Launch-Woche das Modell, das Sie Monate später nutzen, womöglich nicht mehr beschreibt.
Spezialisierte Arbeit ist die größte Lücke. Juristische Entwürfe, medizinische Kodierung, eine Nischensprache und die interne Codebasis eines Unternehmens sind in öffentlichen Boards kaum abgedeckt. Real-SWE Benchmark ist eine Antwort darauf: Er bewertet Frontier-Modelle an privaten Unternehmens-Codebasen, die weniger wahrscheinlich in Trainingsdaten gelandet sind als öffentliche Repositories. Betrachten Sie ein solches Board als nützliche zweite Meinung, nicht als Ersatz für Ihren eigenen Test.
Und wenn Sie nur gelegentlich KI nutzen, brauchen Sie das alles womöglich gar nicht. Fürs alltägliche Schreiben und Fragen liegen die besten Modelle von OpenAI, Anthropic und Google nah genug beieinander, dass am Ende Preis, Oberfläche und Gewohnheit entscheiden. Eine Stunde in Rankings zu investieren, um zwischen fast Gleichstarken zu wählen, ist das falsche Geschäft.
Häufig gestellte Fragen
Ist Arena dasselbe wie LMArena?
Ja. LMArena ging aus dem Forschungsprojekt Chatbot Arena der UC Berkeley hervor und heißt heute Arena, unter arena.ai. Der ältere Name taucht noch in Artikeln und älteren Papern auf.
Welches Leaderboard ist am vertrauenswürdigsten?
Keines ist in jedem Fall vertrauenswürdig, und die Antwort hängt davon ab, was Sie wissen wollen. Für Reproduzierbarkeit ist eine Suite eines Dritten, die jedes Modell selbst ausführt, am stärksten. Für die Frage, was Menschen bevorzugen, hat Arena die meisten Daten. Am verlässlichsten ist es, wenn zwei voneinander unabhängige Boards übereinstimmen und anschließend ein kurzer Test mit Ihren eigenen Aufgaben dasselbe zeigt.
Was ist Benchmark-Kontamination?
Gemeint ist, dass ein Modell die Fragen oder Antworten eines Tests schon im Training gesehen hat, sodass ein hoher Score Auswendiglernen widerspiegelt statt Können. OpenAIs Audit von SWE-bench Verified ergab, dass Frontier-Modelle bei einigen Aufgaben die ursprünglichen Fixes reproduzieren konnten. Private Testsets, wie Humanity's Last Exam eines vorhält, sind eine Gegenmaßnahme.
Tricksen Hersteller bei Leaderboards?
Die Belege stützen eine engere Aussage. Labs entscheiden, welche Scores sie veröffentlichen, welche Einstellungen sie nutzen und, laut dem Leaderboard-Illusion-Paper, welche privaten Varianten sie offenlegen. Das ist selektives Berichten innerhalb der Regeln, nicht zwingend Regelbruch. Genau deshalb sind unabhängige Wiederholungsläufe wichtig.
Sollte ich jedes Mal das Modell wechseln, wenn ein neues auf Platz 1 landet?
Nein. Ein Rangunterschied liegt oft innerhalb der Fehlertoleranz, und ein Wechsel hat echte Kosten bei Prompts, Workflows und Tests. Wechseln Sie, wenn ein Modell Ihr aktuelles bei Ihren eigenen Aufgaben schlägt oder es bei deutlich niedrigerem Preis erreicht.