

Muse Wonder 是 Meta 团队自己称为前沿模型的第一款模型,对开发者来说现在就是一个实实在在的选项:你可以通过 API 调用,价格是每百万输入 token $4,每百万输出 token $20。更强的 Muse Wonder Full 则是另一回事,Meta 只在一款编程订阅里提供它(TechCrunch)。
在你被那些基准测试图表吸引之前,最值得先搞懂的就是这种区别。两个模型都是全新发布,你看到的很多数据都来自 Meta 自己,所以我们标注了每个说法是谁提出的。
Meta 发布了什么
Meta Superintelligence Labs 推出了两个模型:Muse Wonder 和 Muse Wonder Full。它们比 Meta 先前发布的轻量模型 Muse Spark 更大,Meta 称它们在编码等复杂任务上表现更好(TechCrunch)。Meta 的卖点围绕 agent 展开,也就是替你完成长任务的软件。它点出了两个特性:Active Memory(在多轮对话间记住与你有关的重要信息)和 Active Focus(遇到阻碍时继续推进,而不是中途放弃)(Meta)。
模型卡显示它支持文本、图像、视频和音频输入,输出为文本,上下文窗口为 100 万 token(Meta 模型卡)。Meta 表示之后会发布更完整的安全报告(Meta)。
背景值得了解一下。Meta 的消费级 agent Muse 刚上线不久,跑在更轻量的 Muse Spark 上(TechCrunch)。Wonder 则是 Meta 说将为它提供动力的更重量级引擎。TechCrunch 指出,这是 Alexandr Wang 去年重组 Meta AI 业务以来的第一个前沿模型,此前 Meta 一直没有推出 OpenAI 和 Anthropic 那种旗舰级模型。Meta 的 CEO 称这是一个"把我们带到前沿"的模型(Euronews)。
在哪能用,多少钱
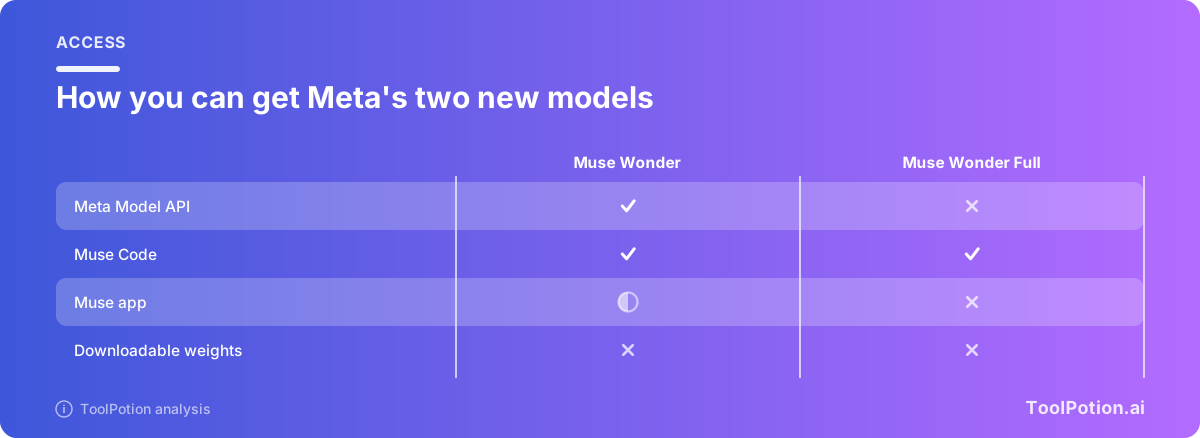
Meta 表示,Wonder 现在已经可以通过 Meta Model API 和它的编程产品 Muse Code 使用,而 Wonder Full 仅限 Muse Code 订阅用户。面向普通用户的上线会晚一些:Wonder 很快会进入 Muse 助手,订阅用户优先(Meta)。如果你只想用助手,我们的目录里有 Meta AI 的条目,API 方面可以看 Meta AI Developer 页面。
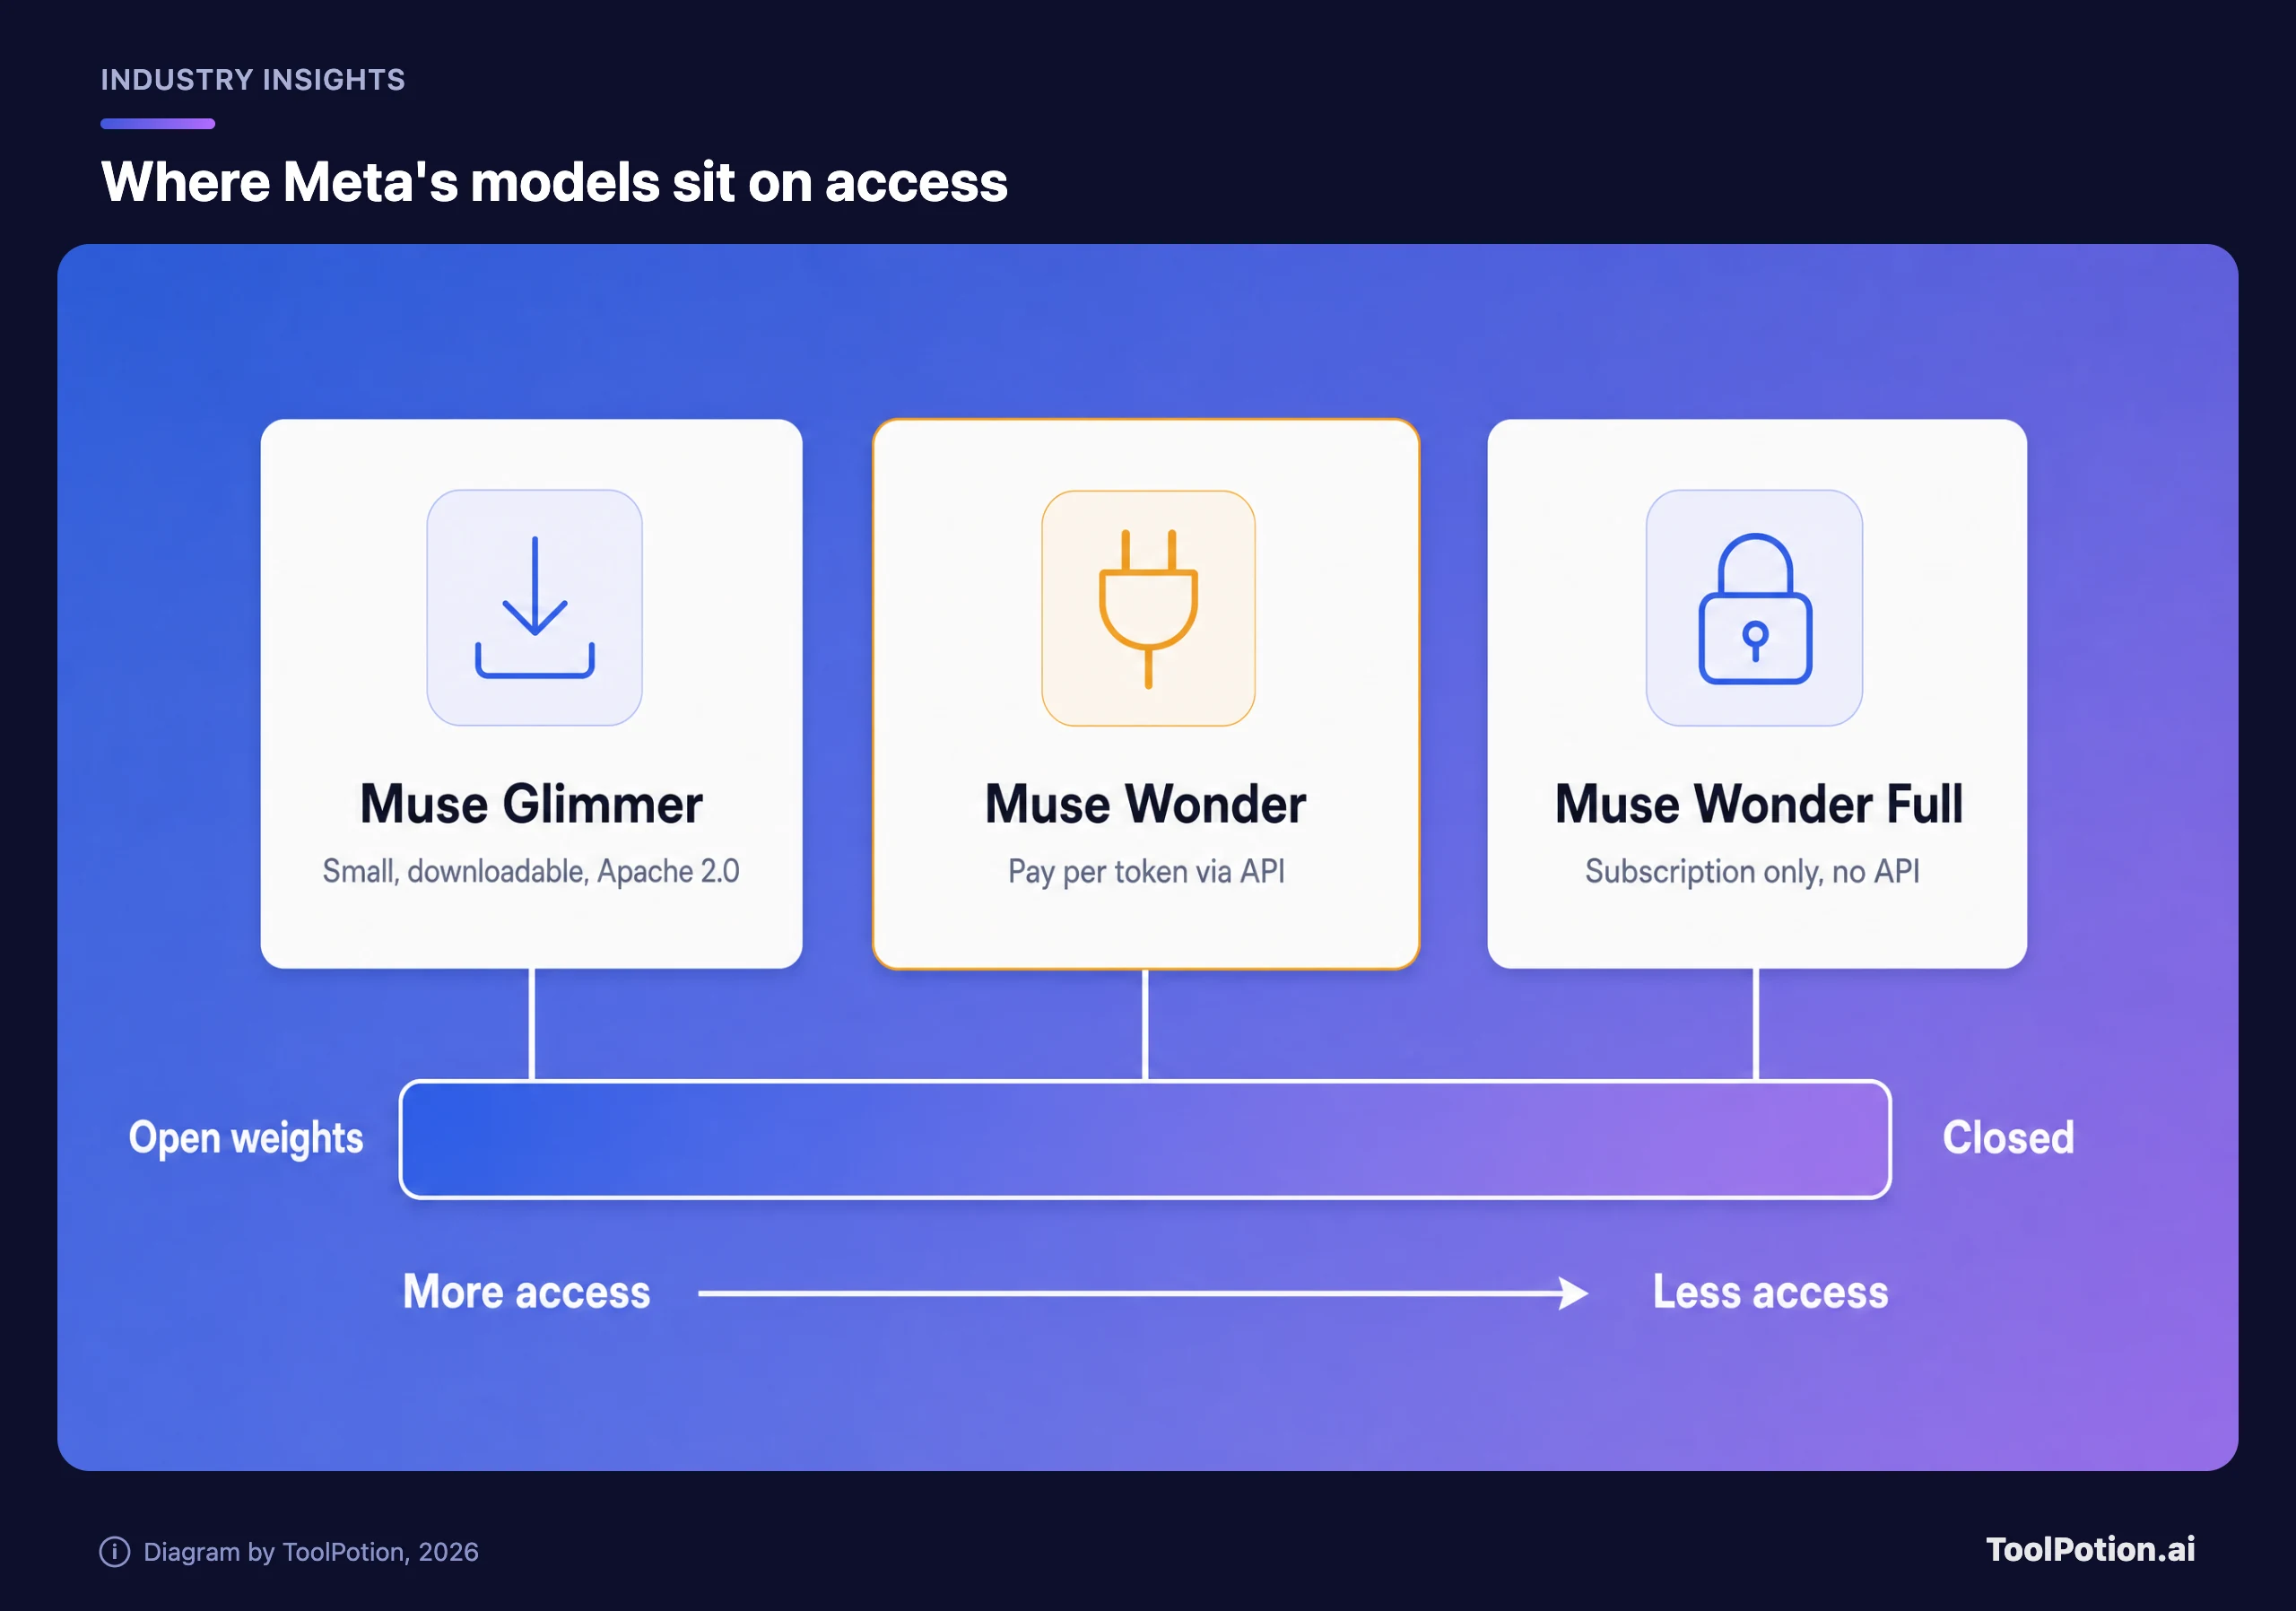
这是它和 Llama 的分野所在。Meta 靠可下载的模型打出了名气。VentureBeat 直接转述了 Meta 的说法:两个 Wonder 模型都不会发布可下载的权重(VentureBeat)。开放的是小型的 Muse Glimmer,一个 300 亿参数的模型,Meta 把它列在 Hugging Face 上(Meta developers),采用 Apache 2.0 许可证(模型卡)。
价格方面,根据 VentureBeat 的定价表,$4 和 $20 与 Claude Opus 5.5 的标价相同(VentureBeat)。Wonder Full 根本没有按 token 计费的价格。Muse Code 的套餐是每月 $5、$15、$50 和 $200,Wonder Full 从 $50 档起可用(Meta 帮助中心)。这些套餐默认开启 Contributor 模式,也就是允许 Meta 用你的 prompt、代码和输出来训练模型。你可以随时关掉,Meta 说明这个开关针对的是之后的内容(Meta 帮助中心)。
如果你的代码是保密的,这个默认设置比任何基准测试都重要。走 API 更稳妥:Meta 的定价页说明,Standard 模式的内容不会用于训练,而且 API 上的 Wonder 不提供 Contributor 模式([Meta 定价]({PRC}))。
Meta 怎么说,外部测试又发现了什么
Meta 称,Wonder 和 Wonder Full 在个人与职业 agent 任务、记忆和编码方面都达到了业界最先进水平。它的模型卡把这两个模型与 GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5(均为最高推理强度)做了对比,并表示 Wonder 在 MemoryBench 上全部胜出,而 MemoryBench 是 Meta 自己做的基准测试(TechCrunch、模型卡)。不过要看小字部分。Meta 说它对竞品模型的测试是尽力而为,同一模型有多个分数时,取的是最高的那个。
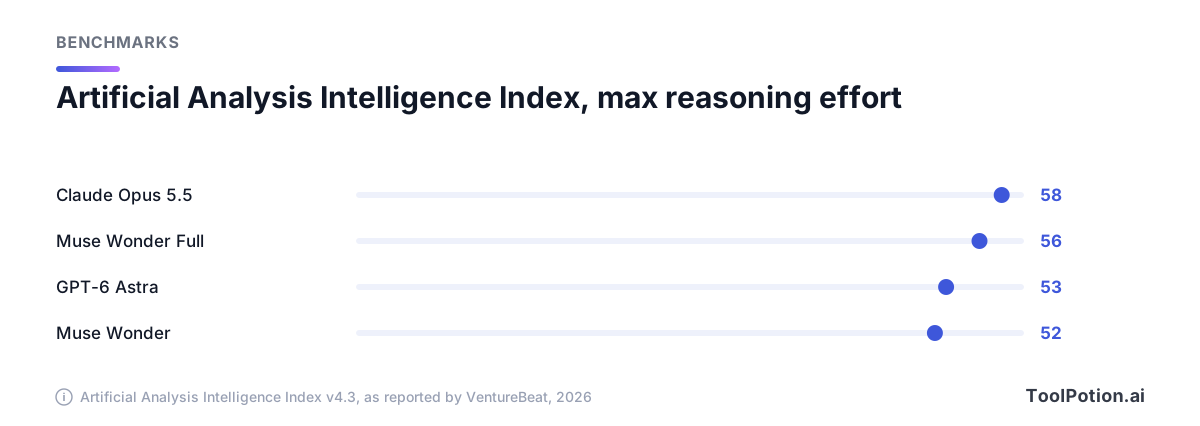
独立机构的数据没那么好看,但更有参考价值。Artificial Analysis 的智能指数里,Wonder Full 是 56,Opus 5.5 是 58,GPT-6 Astra 是 53,Wonder 是 52([VentureBeat]({VB})、Artificial Analysis)。
具体到单项测试,结果就分化了。Wonder Full 在长时间运行的软件基准 SWE-Marathon 上领先,得分 57.5,Opus 5.5 是 46.3,Astra 是 42.5。Opus 5.5 在总指数、Terminal-Bench 和 HealthBench Pro 上仍略占上风,JobBench 则是 75.4 对 75.3 的险胜(VentureBeat)。这张表混合了第三方和 Meta 自己跑的结果,而且 Meta 的模型卡也承认,SWE-Marathon 那一行不是严格受控的对比,因为部分模型是在各自厂商的编程工具里跑的(模型卡)。
与 GPT-6 Astra、Gemini 和 Claude 比较
在获取方式上,Wonder 更接近闭源阵营,而不是以前的 Meta。它比 OpenAI 的顶级档便宜:GPT-6 Astra 的标价是每百万 token 输入 $10、输出 $50(OpenAI 定价),我们在 GPT-6 Astra 详解里讲过。OpenAI 更便宜的 GPT-6 Sol 标价是 $2 和 $10,所以在那一档上 Wonder 并不算划算。对比 Anthropic,价格和 Opus 5.5 一样,你只能根据效果和条款来选,而不是价格。两边都可以在 ChatGPT 或 Claude 应用里试用。
Gemini 是个空白。Meta 的模型卡没有和它对比,我们也没见过正面较量的结果,所以不瞎猜。Google Gemini 凭自身实力仍然该留在你的备选清单里。想看更全面的格局,可以看我们的 LLM 排行榜和 AI 模型与 LLM 榜单。
谁现在就该试,谁该再等等
如果你在做 agent 或编程工具,能接受 API 条款,并且已经有自己的测试集,现在就可以试。把 Wonder 放在你现在用的模型旁边,比较每个完成任务的成本,因为 Artificial Analysis 估算 Wonder 在指数中平均每个任务约 $4.52,Opus 5.5 是 $5.98,Astra 是 $3.26([VentureBeat]({VB}))。如果你想要一个日常聊天助手,就再等等,Muse 应用的上线还没发生。如果你需要开放权重,就别考虑了。如果你是个人开发者,在考虑 $200 的 Muse Code 套餐,要记住这笔钱买到的是 Wonder Full 的使用权,但同时也带着前面说的训练默认设置。
一次公平的测试只要一个下午。挑十个你已经在花钱让模型做的任务,分别用 Wonder 和你现在的模型跑一遍,比较三件事。
- 有多少任务在你不插手的情况下正确完成。
- 每次运行消耗了多少 token,因为 Wonder 可能想得更久。
- 你们的法务或隐私团队能不能接受 Meta 的 API 条款。
再提醒一点:它太新了。独立的评测还很少,Meta 的安全报告还没出来,而且这么小的基准差距,一旦大家拿真实工作负载去测,往往会变。
常见问题
Muse Wonder 是开源的吗?
不是。Muse Wonder 和 Muse Wonder Full 都没有可下载的权重。开放的是小型的 Muse Glimmer 模型。
Muse Wonder 多少钱?
通过 Meta Model API 调用,每百万输入 token $4,每百万输出 token $20。Wonder Full 没有 API 价格,只在 Muse Code 套餐里提供,套餐每月 $5 到 $200,Wonder Full 从 $50 档起可用。
Muse Wonder 比 GPT-6 Astra 或 Claude 更好吗?
Meta 说它们不相上下,在记忆方面领先。Artificial Analysis 给 Wonder Full 的分数高于 Astra、低于 Opus 5.5,而 Wonder 本身比 Astra 低一分。
我能在 Meta AI 应用里用 Muse Wonder 吗?
暂时不行。Meta 表示 Wonder 很快会进入 Muse 助手,订阅用户优先。在那之前,助手跑的是 Meta 更轻量的模型,所以你现在在应用里体验不到 Wonder 的优势。