

到 2026 年,AI 版权诉讼大部分仍未有定论,但整体格局比一年前清晰多了。Anthropic 花 15 亿美元与作者达成和解,唱片公司正与 Suno 和 Udio 签订授权协议,规模最大的新闻业案件——《纽约时报》诉 OpenAI 和 Microsoft——已进入简易判决阶段。目前还没有任何美国法院裁定用受版权保护的作品训练 AI 模型一定合法,也没有裁定一定非法。
一家独立追踪网站统计,美国已有 148 起针对 AI 公司的版权诉讼(ChatGPT Is Eating the World)。你不用把它们全看一遍。这篇指南只讲真正会影响法律走向的案件、它们目前的进展,以及如果你在实际工作中用 ChatGPT、Claude 或 Midjourney,这意味着什么。下文中凡是称为"指控"的内容,都只是原告的主张,大多数案件法院还没有裁决。
本文是进展汇总,不构成法律意见。内容来自法院报道、案件追踪站和各厂商自己的条款,部分信息很快会过时。如果有真金白银系在某个决定上,请咨询律师。
简短结论:AI 版权案件,谁占上风
没有谁赢得干净利落。整体情况如下。
和解与授权的速度快过判决,说明双方都更愿意花钱买确定性,而不是冒被判决的风险。目前唯一发声的上诉法院是在 Ross 案中,判决对 AI 公司不利,但涉及的是非生成式工具。德国法院对同一问题的解读比美国法院更严格。至于大多数用户最关心的问题——AI 生成的内容归谁——美国的答案很稳定:必须由人来贡献表达。
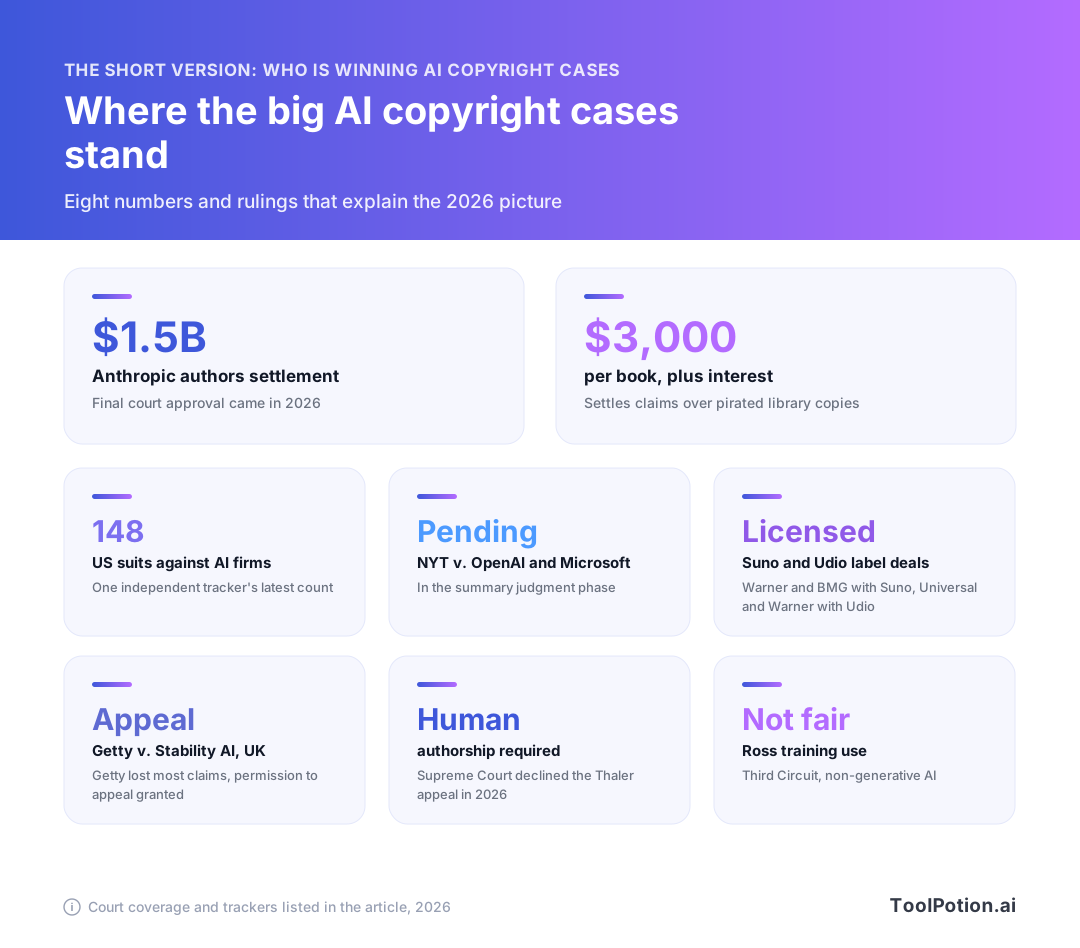
上面这张图用八个板块概括了全文,下面的内容会逐一展开背后的细节。
四年来的来龙去脉
第一波诉讼出现在 2023 年。艺术家起诉了 Stability AI、Midjourney 和 DeviantArt,Getty 在英国起诉 Stability AI,《纽约时报》则在年底起诉了 OpenAI 和 Microsoft。2024 年,唱片公司接连起诉 Suno 和 Udio。2025 年首批实质性裁决出炉,电影公司也加入进来:迪士尼和环球起诉 Midjourney,随后华纳兄弟探索公司也跟进了。
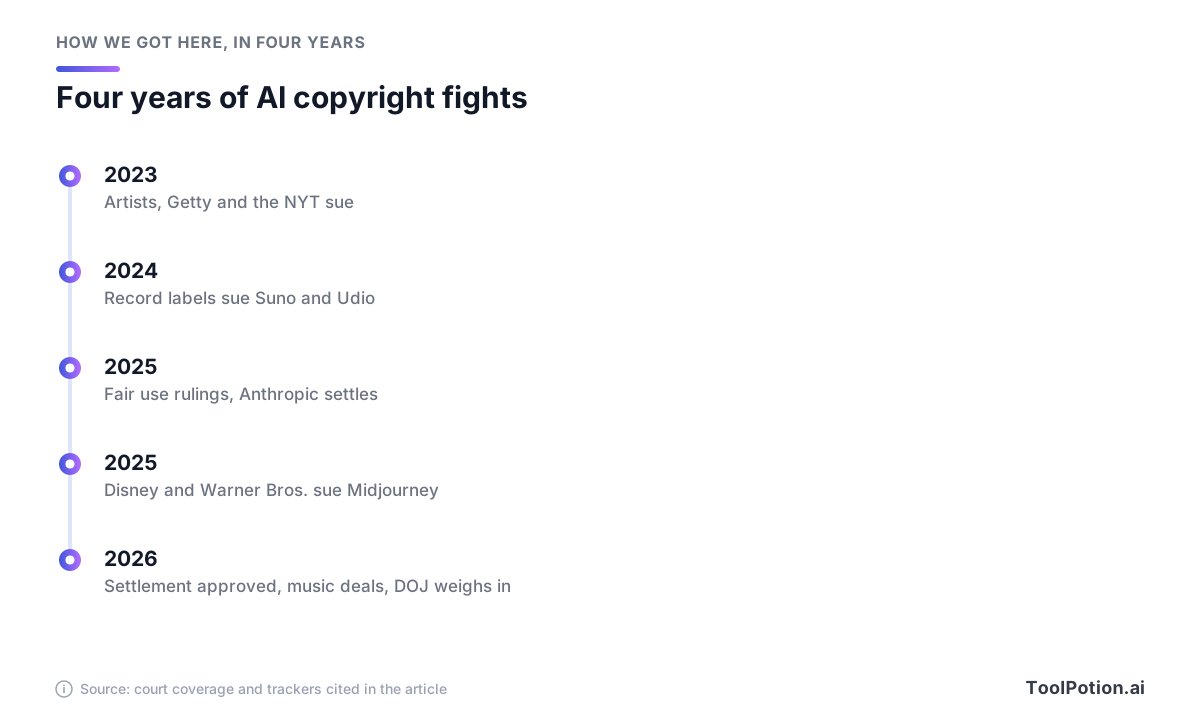
2026 年的变化是,未决案件开始走向成熟。一笔巨额和解获得最终批准,上诉法院开始表态,美国政府也站到了一方。接下来我们按重要程度依次介绍。
《纽约时报》诉 OpenAI 和 Microsoft
大多数人说"AI 版权诉讼"时,指的就是这一起。《纽约时报》2023 年底提起诉讼,指控 OpenAI 未经许可用其文章训练模型,并称 ChatGPT 和 Microsoft 的 Copilot 能够复现这些文章。OpenAI 则称训练属于合理使用。其他新闻机构和作者的案件已并入纽约的同一程序,追踪网站称该案"已进入简易判决阶段"(ChatGPT Is Eating the World)。
最近的重大动向来自华盛顿。特朗普政府向曼哈顿联邦法院提交了一份意见书,支持 OpenAI,称 AI 训练总体上属于对受版权保护材料的合理使用。路透社报道称,这似乎是美国政府首次就这一波 AI 训练案件表态,并指出这类意见书只有参考意义,不具法律效力。《纽约时报》回应称,政府是在牺牲创作者的利益,偏袒使用其作品的 AI 公司(Reuters)。
别把它当成判决。政府意见书只是一种主张,不是裁决,而且简易判决的结果也可以上诉。据追踪网站,《今日美国》此后也对 OpenAI 提起了诉讼,主张与《纽约时报》的指控类似。所以在这起带头的案件走向判决的同时,诉讼的数量还在不断增加。
作者诉 Anthropic:15 亿美元和解
Anthropic 案是目前赔付金额最大的一起。作者指控 Anthropic 在开发 Claude 模型时,从 Library Genesis 和 Pirate Library Mirror 网站下载盗版图书。Anthropic 以 15 亿美元达成和解,约合每部作品 3,000 美元外加利息。据 Authors Guild 称,Araceli Martinez-Olguin 法官在 2026 年给予最终批准(Authors Guild)。Anthropic 并未承认责任。
和解的免责范围很窄。作者放弃的只是针对 Anthropic 过去获取和复制其图书的主张。针对 AI 输出内容和未来行为的主张不在免除之列,不在和解作品清单上的作品也不在其内(同一来源)。音乐出版商也曾就歌词起诉 Anthropic,这些目前仍是指控。
对行业里的其他公司来说,教训是:训练数据的来源很重要。这里赔的钱是为盗版图书库的副本,而不是为训练行为本身。
Thomson Reuters 诉 Ross 与合理使用裁决
路透社指出,2025 年美国最先就 AI 训练与合理使用作出裁决的两位法官,给出了相互分歧的判决。最新的标志性裁决来自上诉法院。Ross Intelligence 是一家现已倒闭的初创公司,曾用 Westlaw 的判例要点训练法律检索工具。2026 年,第三巡回上诉法院维持原判,认为这些判例要点受版权保护,Ross 的使用不属于合理使用(Courthouse News)。
合议庭称 Ross 的使用"充其量只有极低程度的转化性",并强调 Ross 想要与 Westlaw 直接竞争。这对其他公司是个重要的限定条件。Ross 不是生成式模型,所以 OpenAI 这样的被告会主张该裁决不适用于自己。尽管如此,这仍是上诉层级第一次就训练与合理使用表态,而且对 AI 公司不利。
音乐、图像和视频:先授权,后判决
Suno 和 Udio
音乐领域的交易推进得最快。Udio 称已与 Universal Music Group 和 Warner Music Group 达成授权协议,可用其曲库训练新模型,并称与 Warner 的安排同时解决了双方的版权诉讼(Udio)。Suno 宣布与 Warner Music Group 和 BMG 建立合作,并称其 v6 模型是与包括 Warner、BMG 和 Believe 在内的行业伙伴共同开发的。Suno 的公告说的是合作而不是和解,所以我们在这里也不称之为和解。我们无法从一手来源确认还有哪些唱片公司(如果有的话)仍在起诉 Suno,所以在默认某个曲库已获授权之前,请先自己核实。
Udio 和 Suno 现在看起来不再只是单纯的被告,而更像是部分唱片公司的被授权方。对你来说,"这首曲子能不能放进我的广告"取决于某次输出究竟参考了哪个曲库,而你看不到这一点。我们会在实操部分再回到这个问题。
德国的 GEMA
在美国之外,慕尼黑的法院对 AI 公司没那么友好。德国集体管理组织 GEMA 在 2025 年就歌词问题胜诉 OpenAI。2026 年,慕尼黑地方法院判 GEMA 胜诉 Suno。芬兰集体管理组织 Teosto 这样概括该判决:法院认定模型会记忆受保护作品并保留副本,因此用这些作品训练和在输出中复现它们都构成侵权。Suno 可以上诉(Teosto)。
合理使用是美国的法律原则,德国法院的推理方式不同,但如果你的产品要卖到欧洲,应该留意这个走向。
Midjourney、Getty 和 Stability AI
迪士尼和环球在 2025 年起诉了 Midjourney,华纳兄弟探索公司随后跟进。Midjourney 已通过约定同意向原告交出其视频训练数据集(ChatGPT Is Eating the World)。这属于证据开示,不是裁决,但意味着电影公司将能查看训练数据的内部情况。
Getty 在英国起诉 Stability AI 的案件则是另一个走向。法官驳回了 Getty 的版权侵权主张,随后允许 Getty 上诉,Chambers 指出这对一审法官来说并不常见(Chambers)。Getty 在美国还有一起针对 Stability AI 的独立案件,本文不涉及。如果你在用开放权重的 Stable Diffusion Web UI,英国的这起上诉值得关注。
下表列出了主要案件的最新状态。
| 案件 | 指控内容 | 当前进展 |
|---|---|---|
| NYT、作者诉 OpenAI 和 Microsoft | 未经许可用文章和图书训练 | 纽约处于简易判决阶段。美国政府意见书支持 OpenAI |
| 作者诉 Anthropic | 用盗版图书训练 | 以 15 亿美元和解,2026 年获最终批准 |
| Thomson Reuters 诉 Ross | 用 Westlaw 判例要点训练 | 第三巡回上诉法院维持原判:不属于合理使用 |
| 唱片公司诉 Suno | 用录音作品训练 | 已宣布与 Warner 和 BMG 合作;其他唱片公司的情况未能确认 |
| 唱片公司诉 Udio | 用录音作品训练 | 与 Universal 和 Warner 达成授权协议(Udio 的说法) |
| 迪士尼、环球、华纳兄弟诉 Midjourney | 用角色训练并复现角色 | 证据开示阶段,将共享训练视频数据 |
| Getty 诉 Stability AI(英国) | 用照片训练、使用水印 | 版权主张被驳回,获准上诉 |
使用 AI 工具时,法律风险在哪
上面大多数案件都是权利人与 AI 公司之间的争斗,争的是模型是怎么造出来的。作为用户,你处在流程的另一端,你的风险主要来自你发布了什么。
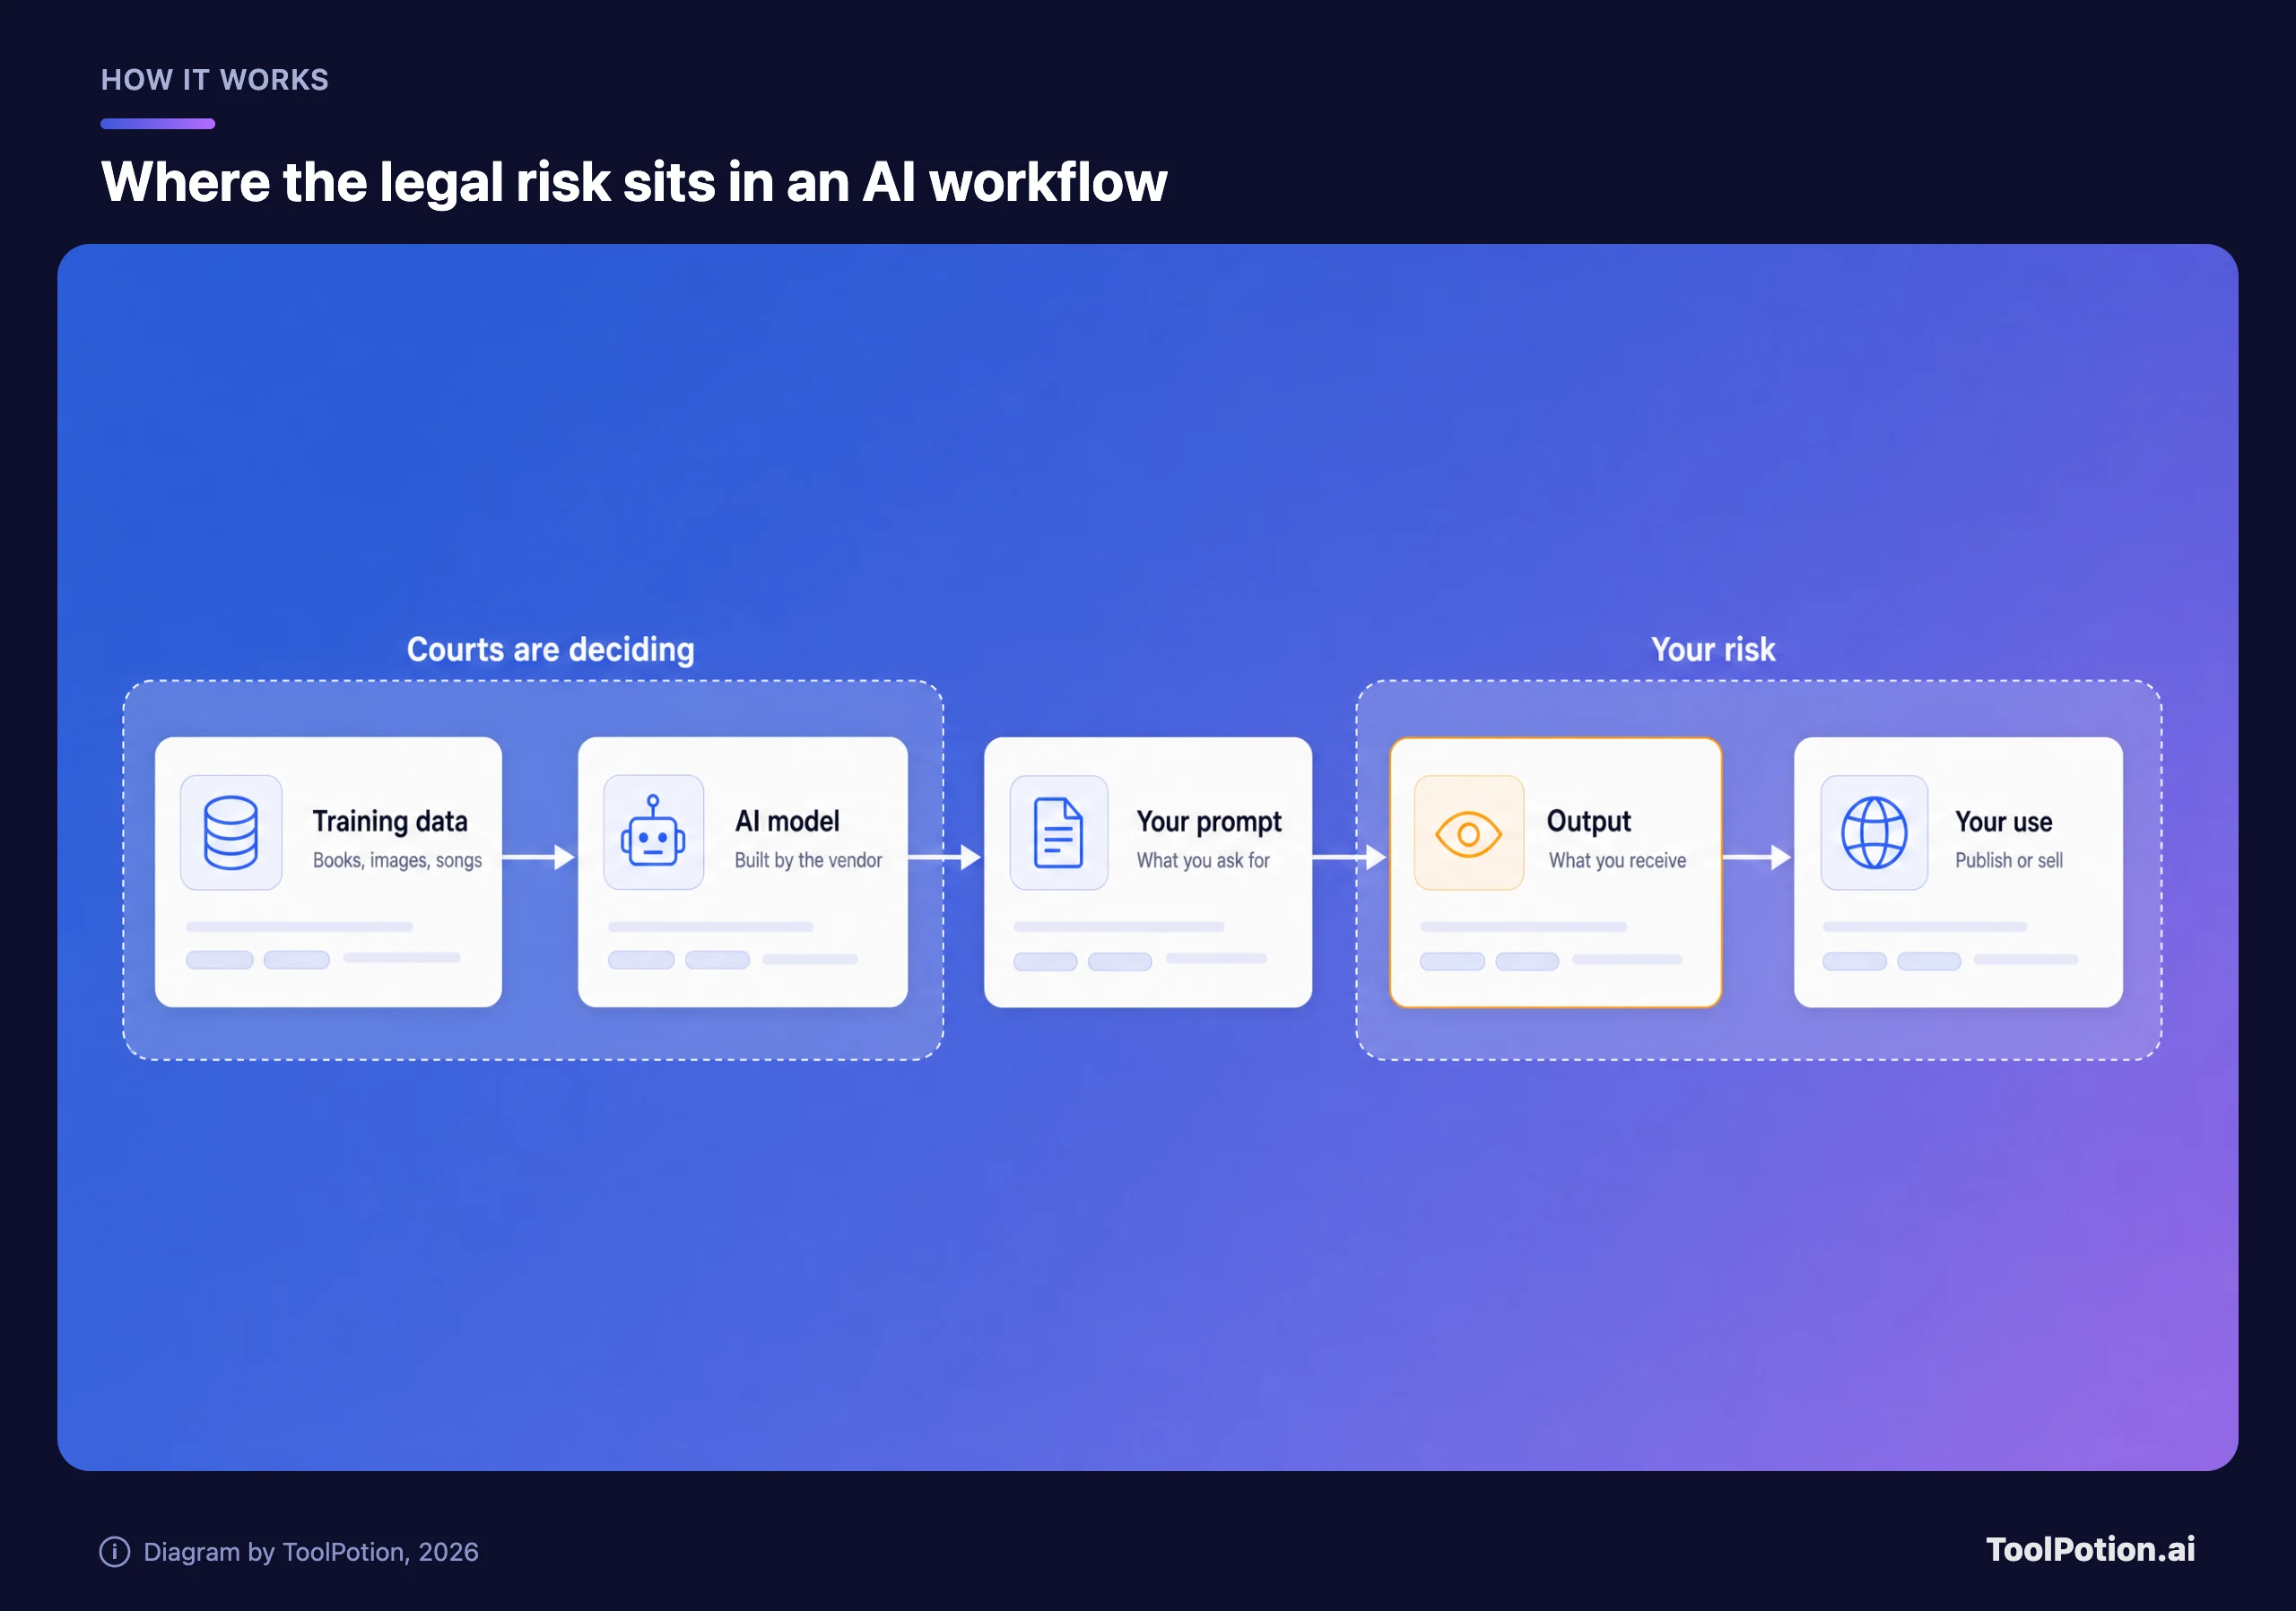
左边那一块是厂商的问题,至少在法院另有说法之前是这样。右边那一块才是你的。点名终端用户的诉讼很少见,而针对 AI 公司的诉讼大多建立在输出内容复现了特定角色、歌曲或文本的基础上,这恰恰是你能通过 prompt 和审核来控制的部分。一张普通的风景图或一篇博客初稿,与一首听起来像签约艺人的曲子,风险完全不在一个量级。
厂商的赔偿承诺覆盖什么,不覆盖什么
有几家厂商承诺,如果有人就输出内容起诉,会为企业客户辩护。这些承诺是真实的合同条款,但都附带条件。以下是各家自己文件里的说法。
| 厂商 | 内容 | 限制条件 |
|---|---|---|
| Anthropic | 就付费使用其服务或其输出内容引发的第三方知识产权索赔,为客户辩护(条款) | 不包括经修改的输出、与其他内容的组合、你的输入、明知故犯的滥用,以及在商业活动中将输出作为商标使用 |
| Microsoft | Customer Copyright Commitment:就输出内容引发的部分知识产权索赔为客户辩护(Microsoft) | Azure OpenAI 客户必须落实所要求的缓解措施,例如 metaprompt、测试和受保护材料过滤器 |
| Google Cloud | 2023 年宣布,针对训练数据和生成输出分别提供赔偿。Google 现在公布了一份涵盖服务的清单(Google) | 仅涵盖清单上的生成式 AI 服务(Google 该页面最后修改于 2026 年),且条款附有条件。请核对当前条款 |
| OpenAI | 商业条款:就服务侵权的指控为客户辩护(条款) | 不包括组合使用、修改以及客户内容;另外还提到一份针对特定服务的单独赔偿条款 |
规律是,保障往往属于付费的商业级使用,包括 Claude、Microsoft Copilot、Google Gemini、ChatGPT 的商业方案和 GitHub Copilot。Microsoft 的页面称,截至今年早些时候,GitHub 的产品没有额外要求的缓解措施,而 Copilot Studio 则不覆盖来自外部模型的输出,除非这些模型在 Azure OpenAI 中按要求的设置运行。免费的个人账户通常不在任何此类保障范围内。
图像工具对安全性的宣传方式不同。Adobe Firefly 把自家模型宣传为"商业安全",而 Generative AI by Getty Images 本身就是版权方自己的产品。这类营销说法针对的是训练数据。合同是否也保护你,是另一个问题,所以要看赔偿条款的原文,别只看宣传。
AI 生成的内容归谁
美国版权局在 2025 年给出了政策层面的答案。其版权可保护性报告指出,只有在由人决定表达性要素的情况下,AI 输出才能受到保护。把 AI 当工具使用并不会让作品丧失资格,但只靠 prompt 是不够的(US Copyright Office)。
法院的态度一致。哥伦比亚特区巡回上诉法院认定,对于 Stephen Thaler 的 AI 系统自行创作的一幅图像,版权局拒绝登记是正确的,最高法院在 2026 年拒绝受理他的上诉(最高法院案卷、Chambers)。不予受理不等于对实质问题作出裁决,但下级法院的判决因此保留了下来。
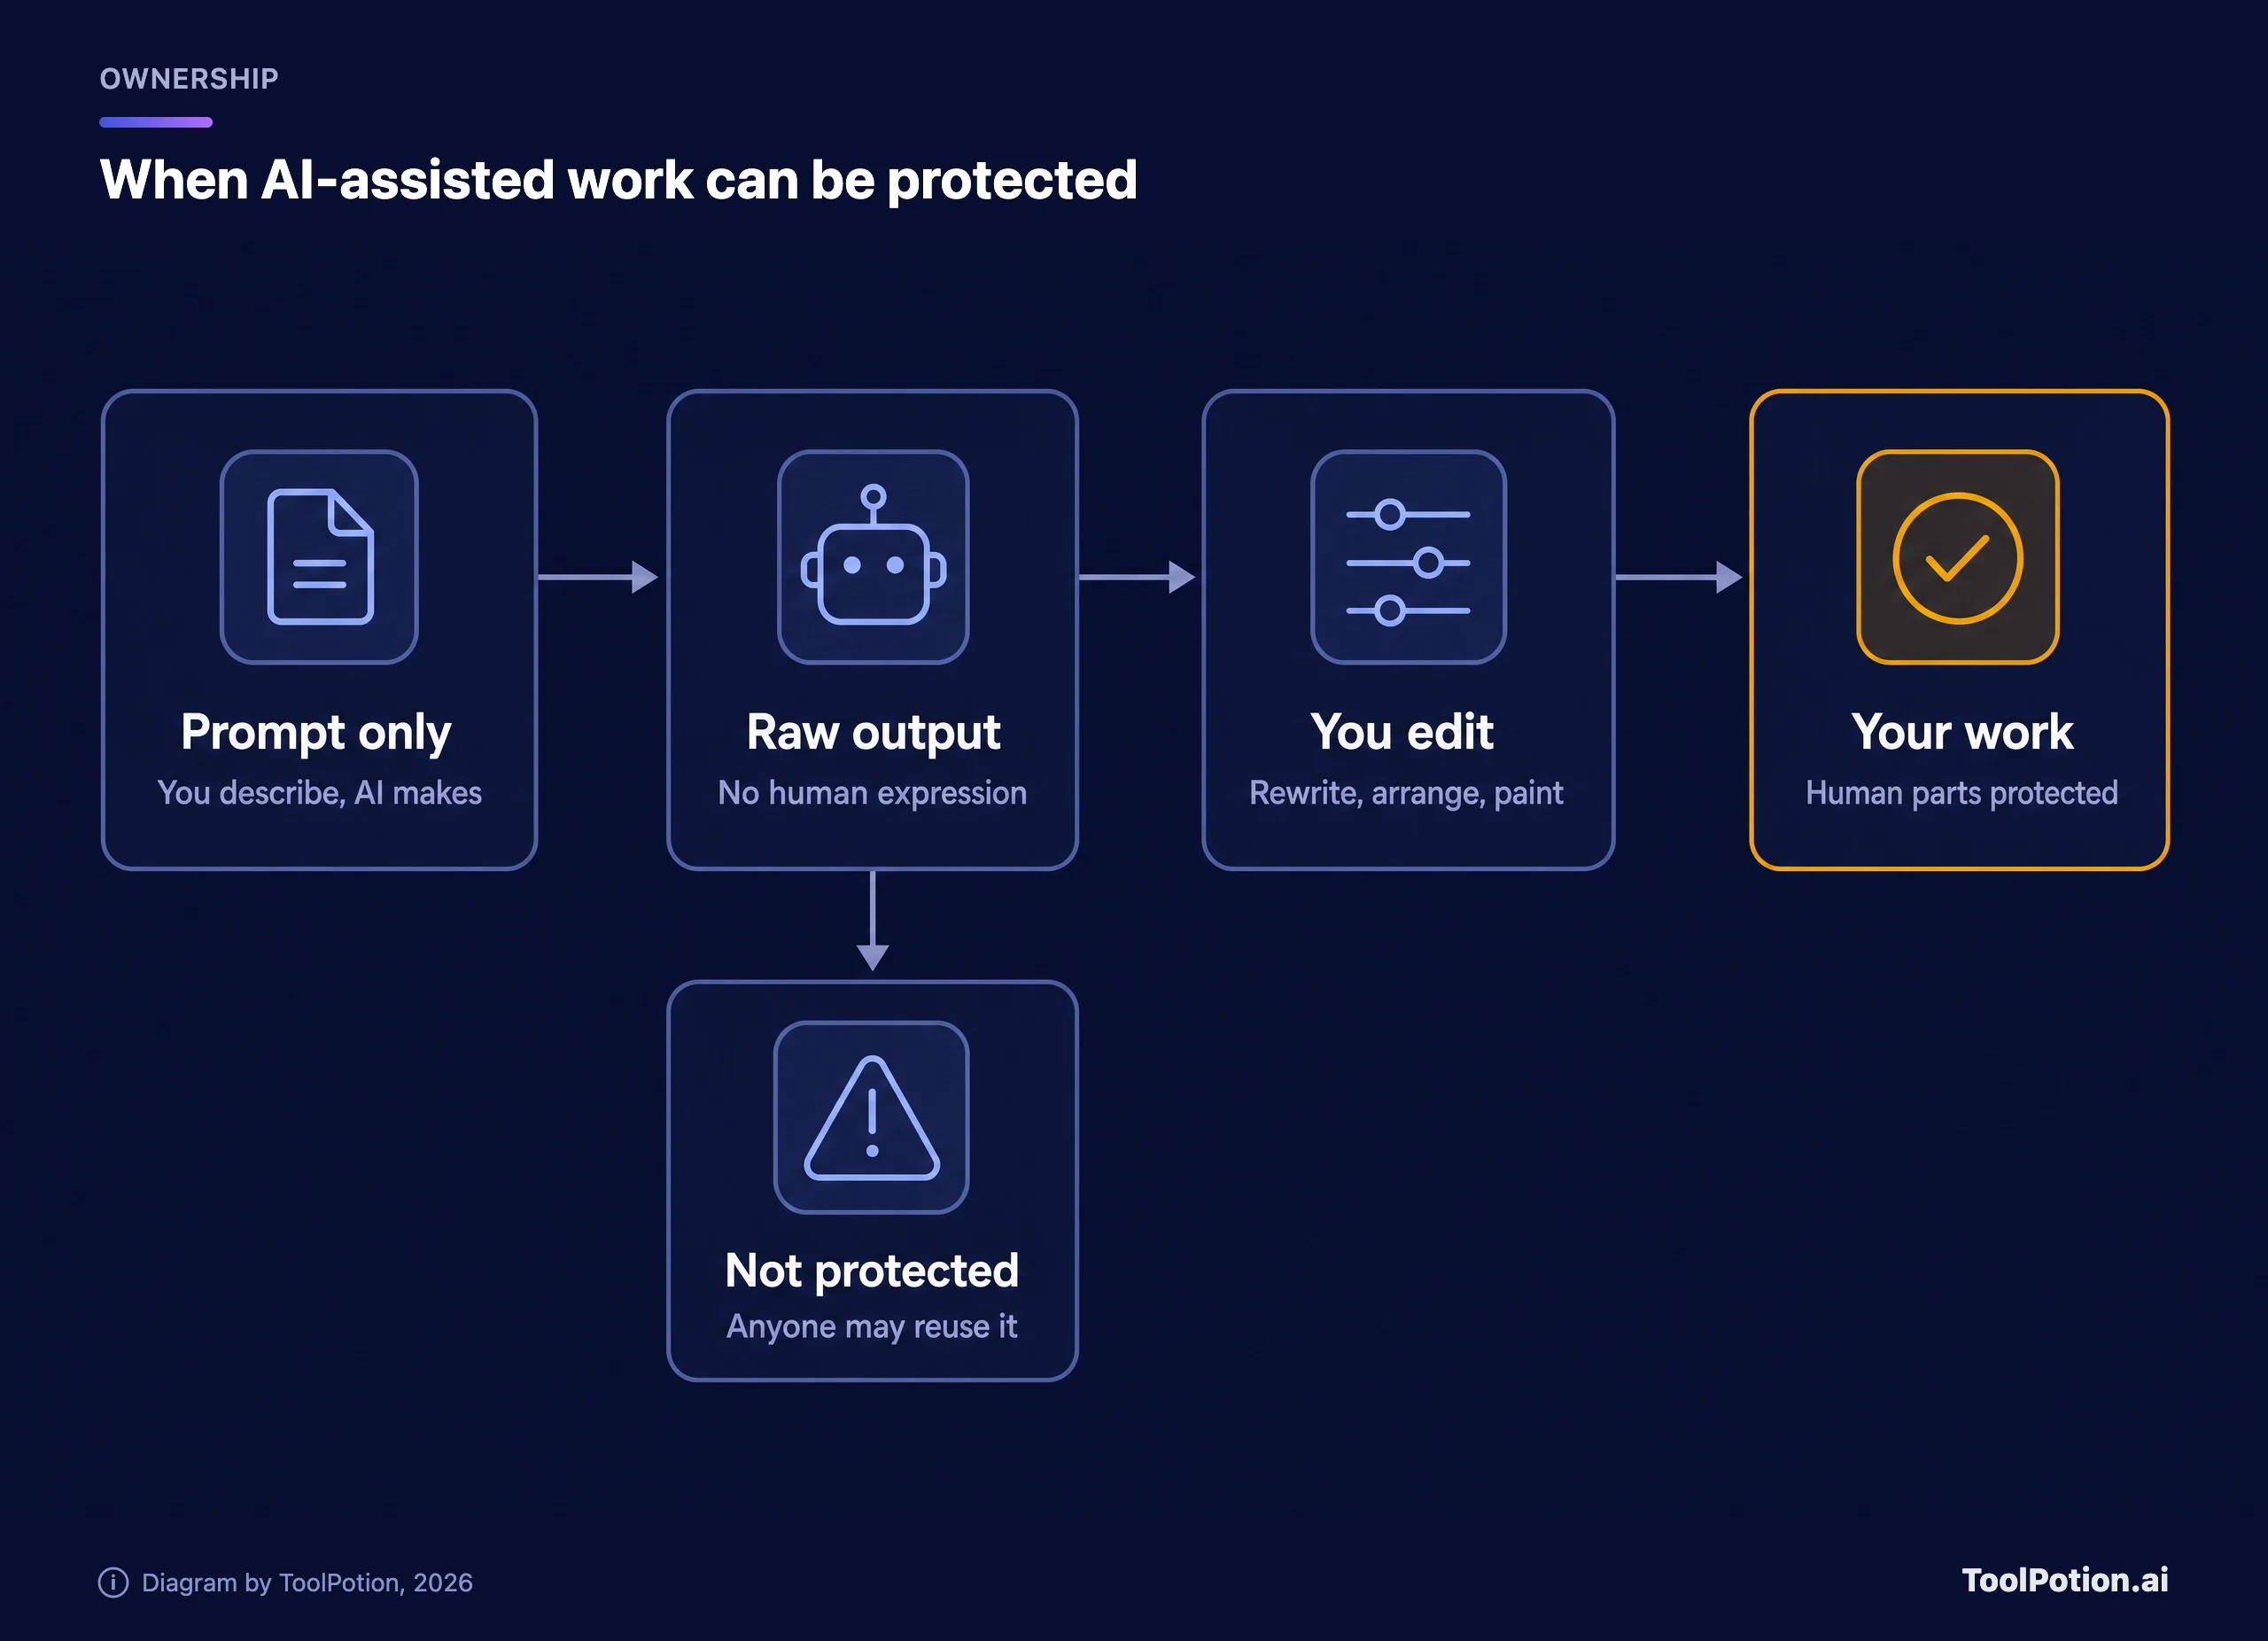
实际上,一个 prompt 得到的原始输出,任何人都可以复制。如果你改写文字、在图像上重新绘制,或者把多个输出挑选编排成新的东西,你就可以主张自己的人类贡献,而不是机器的贡献。请保留草稿和编辑记录,万一有人质疑,这就是你的证据。
如果你工作中用 AI 工具,现在该怎么做
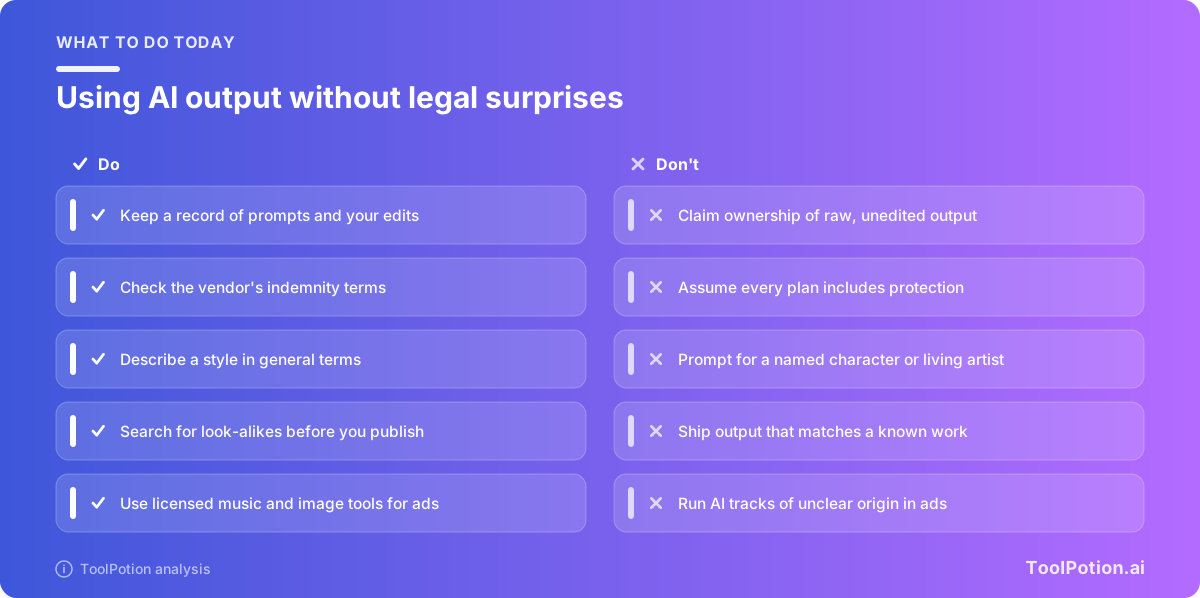
这些都不需要法务团队,降低风险主要靠养成习惯。
- 读一读厂商的赔偿条款,留意其中的除外情形,尤其是针对编辑过的输出和你自己接入的工具。
- 凡是要公开发布的东西,不要在 prompt 里点名角色、品牌或在世艺术家。电影公司的诉讼正是盯着这些。
- 重要的内容要自己动手改。人工修改既能加强你对成果的权属主张,也能降低发布出抄袭内容的概率。
- 大范围发布前,做一次相似性检查:图片用以图搜图,文字搜一下有特色的句子,音乐则听一听。
- 付费投放的广告,优先选训练数据有授权或商业条款明确的工具,并保存好你所依据的条款页面。
- 重要工作的 prompt 和草稿要留存。
用下面的决策树,给具体的某份输出在风险等级上定个位。
然后给你团队的习惯打个分。这份清单不能给你法律上的保证,但能告诉你该先补哪个缺口。
还有哪些悬而未决
很多。还没有哪家上诉法院裁定过,用受版权保护的图书或新闻训练生成式模型是否属于合理使用。《纽约时报》案可能会产出第一个重要裁决,随后的上诉又要耗上好几年。版权局关于训练的报告目前只有预发布版本,最终版还没出来。英国、德国和美国的法院推理方式各不相同,所以同一个工具可能在一个市场没问题,在另一个市场就有风险。
和解还会隐藏信息。Anthropic 的和解让作者拿到了钱,却没有产生关于训练本身是否合法的裁决。而音乐领域的交易意味着有些曲库已获授权,有些没有,输出内容上也没有任何标记告诉你是哪种情况。
如果你在 AI 模型之上构建产品,或者销售用 AI 制作的内容,稳妥的做法是假定规则还会不断变化。如果你想从质量而不是法律风险的角度对比工具,ToolPotion 的音频、语音与音乐榜单和 AI 音频编辑器榜单是不错的起点,助手类工具可以看 ChatGPT 替代品指南。
常见问题
AI 公司用受版权保护的作品训练模型合法吗?
目前还没有定论。第三巡回上诉法院认定 Ross 用 Westlaw 判例要点训练不属于合理使用,但 Ross 不是生成式模型。Anthropic 为盗版图书付了 15 亿美元,但并没有对训练本身作出裁决。美国以外的法院,比如慕尼黑法院在 Suno 案中,适用的是不同的规则。
用 AI 生成的图片或文字,我会被起诉吗?
有可能,但针对普通用户的诉讼很少见。如果输出内容复制了可辨认的作品、角色或声音,或者被用于广告,风险就会上升。部分厂商的企业客户可以获得赔偿保障,所以要确认自己用的是哪种方案。
在美国,AI 生成的内容归谁?
由人创作的部分你可以拥有,比如你的修改、挑选和编排。纯机器生成的内容不受保护,最高法院在 2026 年拒绝重新审视这一点。厂商条款通常会把现有的全部权利转让给你,但它们无法创造法律没有赋予的权利。
Suno 生成的音乐可以放心商用吗?
在把输出用于付费工作之前,先读一下 Suno 当前的条款和方案细节。Suno 称已与 Warner Music Group 和 BMG 建立合作,而慕尼黑法院在 2026 年的 GEMA 案中判决 Suno 败诉(Suno 可以上诉)。来自已获授权曲库的输出不会被标注出来。
《纽约时报》案什么时候会有结果?
目前没人说得准。案件正处于简易判决阶段,败诉的一方可以上诉,而上诉通常要花很长时间。任何裁决都只是其中一个阶段,不是终点。