描述
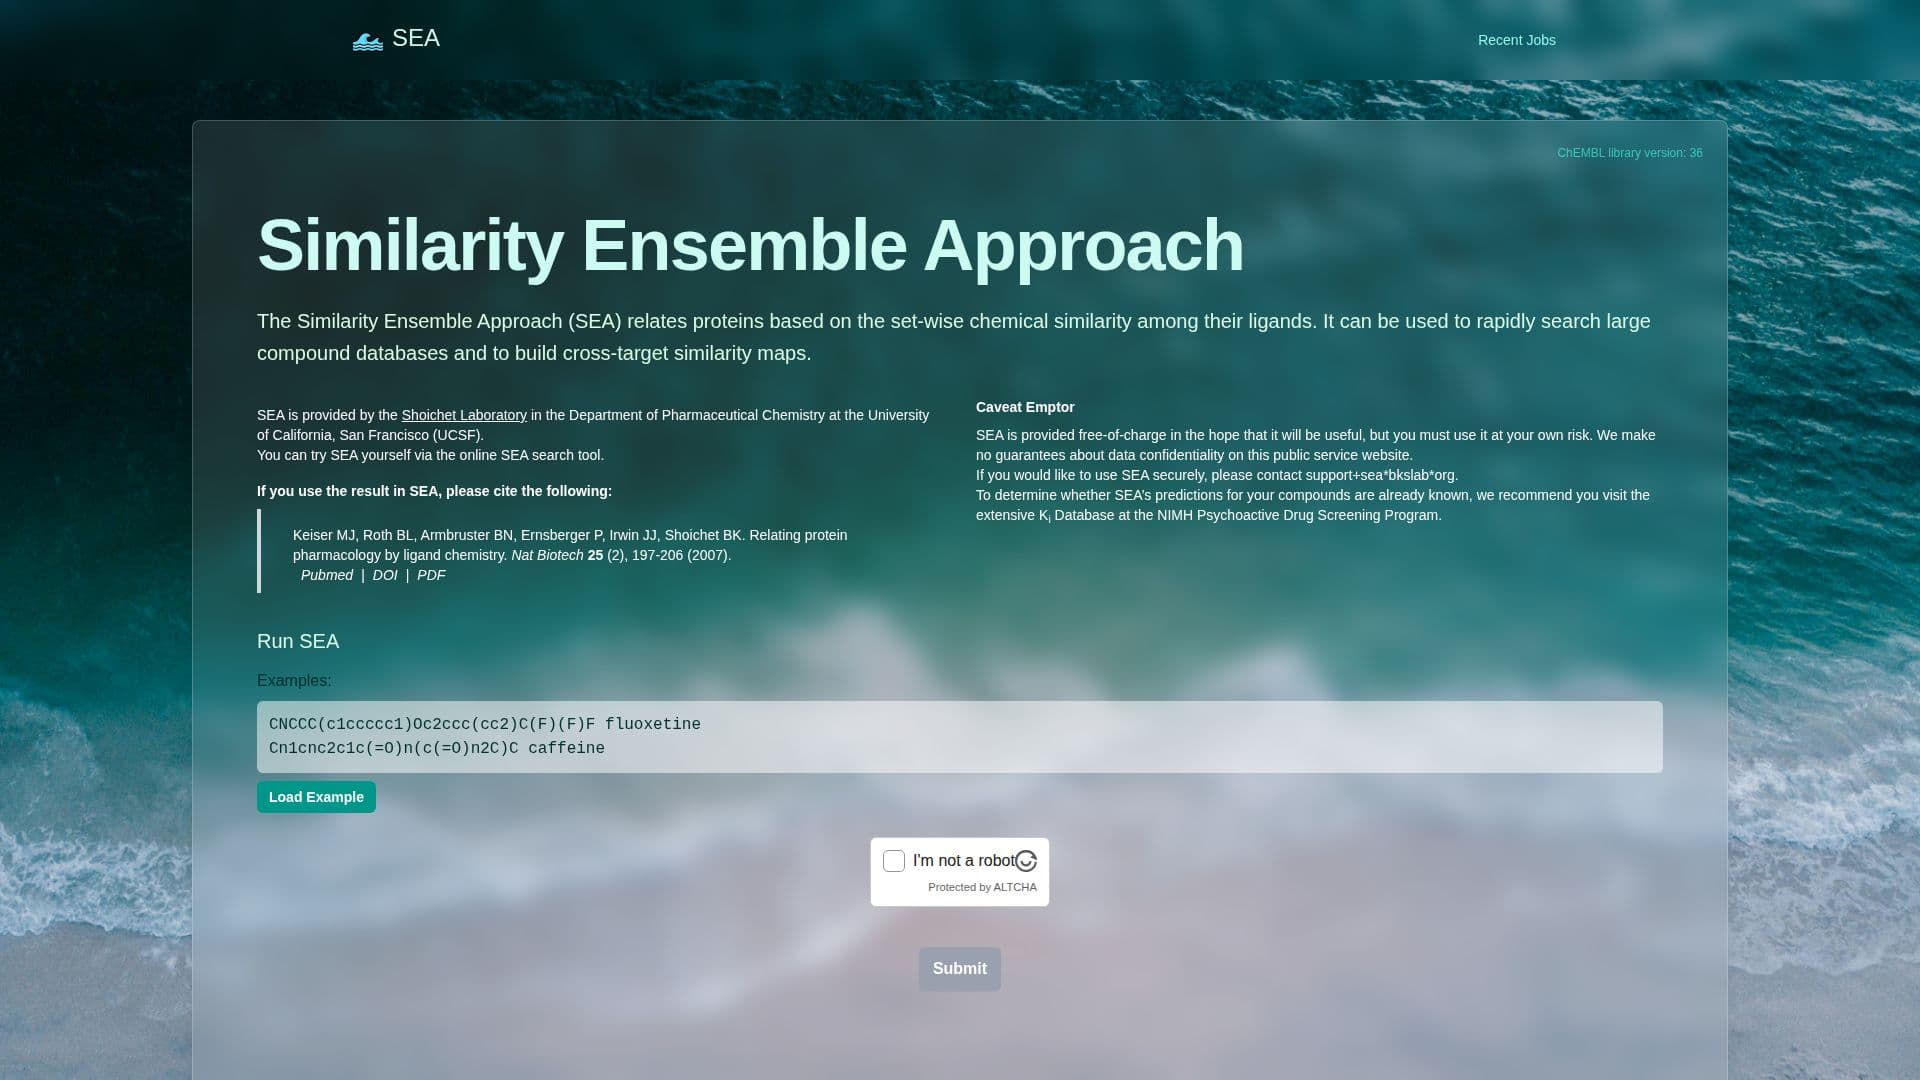
相似性集成方法(SEA)是一种计算技术,旨在预测各种生物实体(如蛋白质、化合物或其他分子结构)之间的相似性。这种方法在药物发现和生物研究领域特别有用,因为理解不同分子之间的相互作用和关系至关重要。
阅读更多
SEA通过分析生物实体的集成特征来工作。它比较这些特征以识别潜在的相似性和相互作用。这种方法使研究人员能够预测不同分子之间可能的相互作用,这对于识别潜在的药物候选者或理解生物通路至关重要。
SEA的一个关键能力是其处理大数据集的能力,使其适合高通量筛选过程。这一特性在制药研究中尤为重要,因为需要快速高效地分析大量化合物库。
SEA的目标受众包括生物信息学、药理学和分子生物学领域的研究人员和专业人士。这些用户受益于SEA在识别潜在药物相互作用和理解复杂生物系统方面的能力。
虽然SEA在速度和效率方面提供了显著优势,但需要注意的是,其预测的准确性取决于输入数据的质量。因此,用户必须确保使用可靠的数据集以获得最佳结果。
- 类别科学发现与实验室工具
- 部署云端
- 平台网页
相似性集成方法的核心功能
预测生物实体之间的相似性
分析集成特征
促进药物发现
处理大数据集
适合高通量筛选
识别潜在药物相互作用
支持生物信息学研究
简化分子分析
如何使用 相似性集成方法?
配置:使用您的数据集设置SEA工具
使用:运行分析以预测相似性
解释:审查结果以寻找潜在的相互作用
优化:优化您的数据集以提高准确性
相似性集成方法的使用案例
- 药物发现
- 生物信息学研究