描述
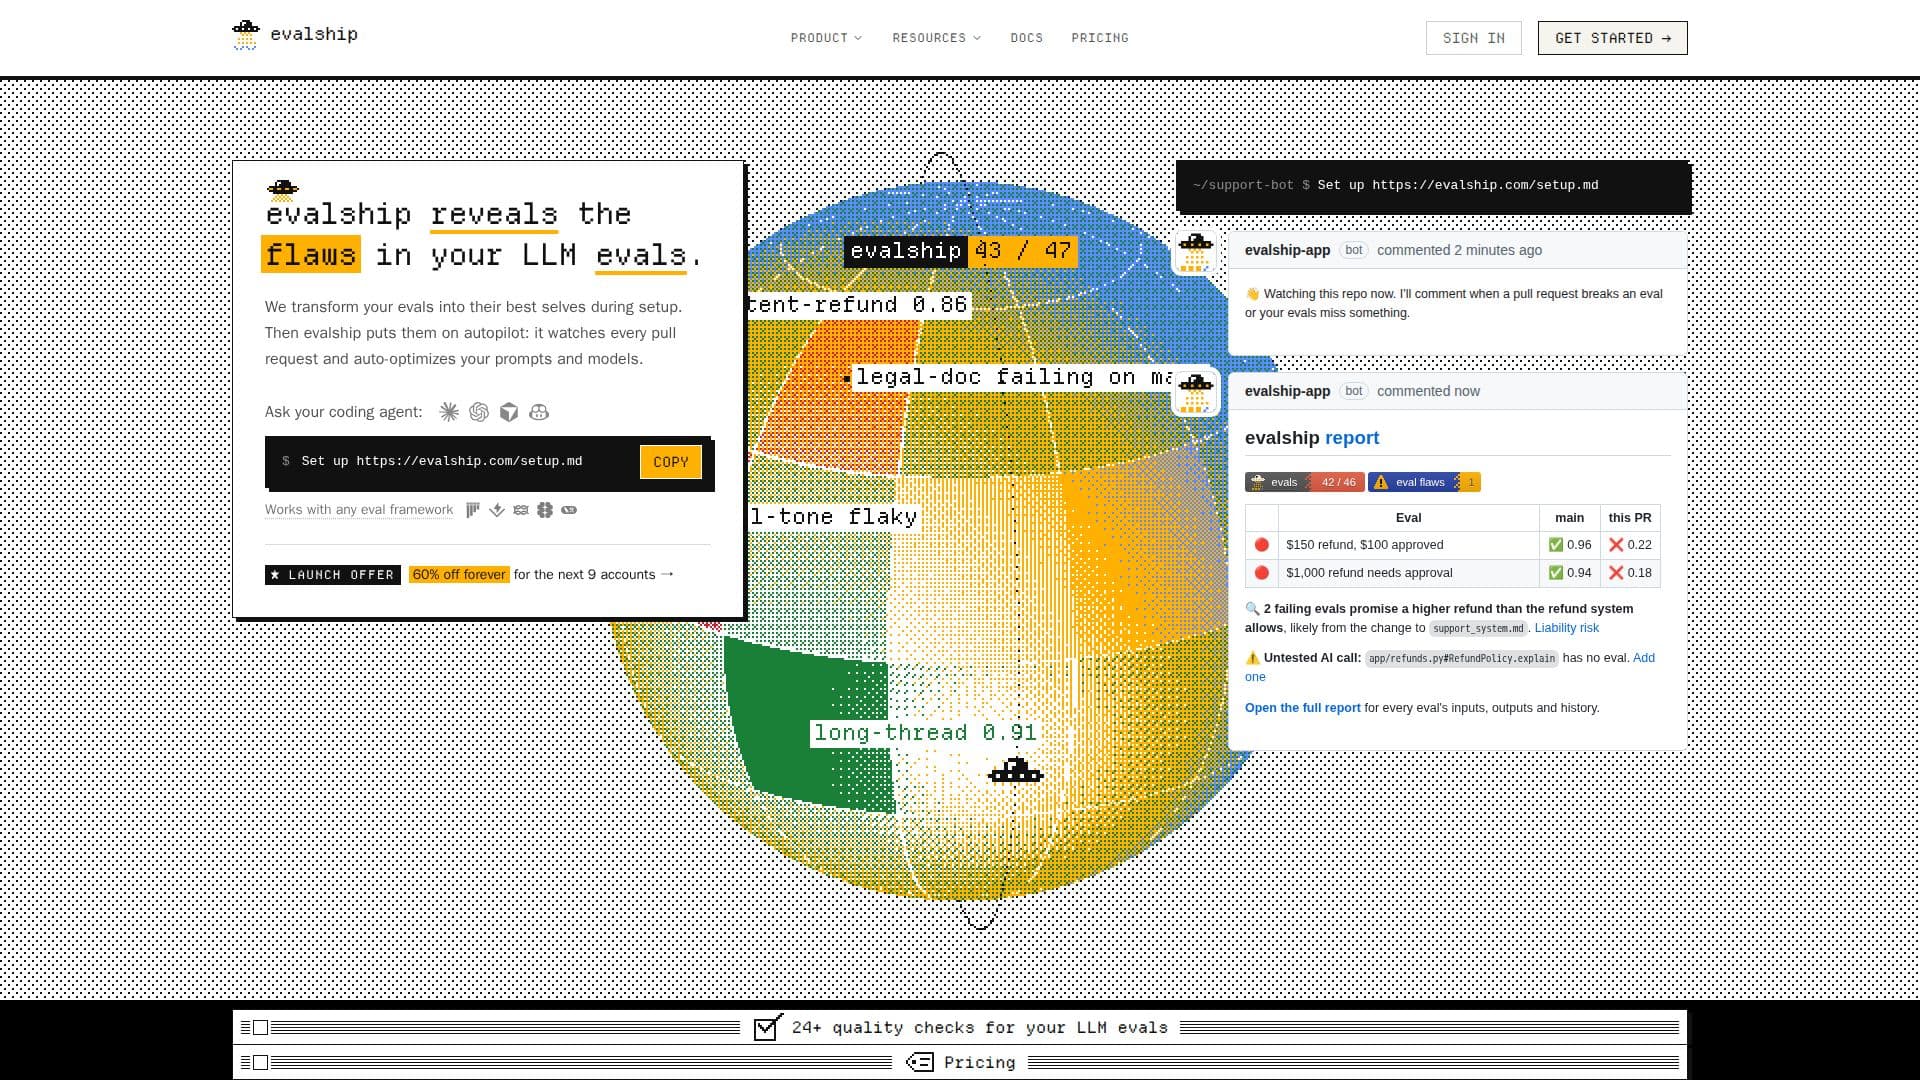
evalship 提供了一种专门为大型语言模型(LLM)评估设计的全面质量控制解决方案。它直接集成到您的 GitHub 工作流程中,充当您 LLM 开发过程的警惕守护者。evalship 的核心目的是识别并解决评估设置中的缺陷,确保您的 LLM 按预期执行,并且不会引入回归。
阅读更多
在设置完成后,evalship 会彻底审查您现有的评估者、评判标准和提示,以找出诸如错误通过的评估或缺乏适当测试覆盖的规则等弱点。然后,它会监控每个拉取请求,提供关于故障原因和可能原因的即时反馈。这包括标记未经过测试的 AI 调用,并通过分析您默认分支的历史性能,将真正的回归与不稳定的评估结果分开。
该平台与多种评估框架无缝协作,包括生成 JUnit XML、promptfoo JSON 或 evalship JSON 的框架,如 pytest、Vitest、Jest、RSpec、Go、Java、PHPUnit、Rust、Langfuse、Braintrust 和 LangSmith。它不会直接运行您的评估;相反,您的 GitHub Actions 工作流程或编码代理使用您的 API 密钥执行它们,而 evalship 处理结果。
除了识别问题外,evalship 还帮助优化您的提示和模型。通过您的编码代理,它在您的机器上测试不同的更改,例如更便宜的模型或更清晰的规则,并报告哪些更改带来了统计显著的改进。这使团队能够做出基于数据的决策,以提高模型性能和成本效率。evalship 还提供每周报告,总结评估性能并突出在生产之前捕获的关键问题。
定价包括公共存储库的免费层和一个私人存储库,支持一个用户,提供 100 次 PR 分析和 30 天的评估历史。付费计划(团队、专业、商业)提供更多用户、私人存储库、PR 分析和更长的评估历史,支持按月或按年计费。启动优惠为早期采用者提供显著折扣。evalship 通过不存储您的源代码或 API 密钥来确保安全,仅处理差异和评估结果。
- 类别AI 代码审查与测试
- 定价模式免费增值
- 部署云端
- 平台网页版
evalship的核心功能
在设置过程中识别 LLM 评估中的缺陷
对每个拉取请求进行详细的评估失败分析评论
根据性能数据自动优化提示和模型
与任何现有评估框架(JUnit XML、promptfoo、evalship JSON)兼容
为 LLM 评估提供 24 种以上的质量检查
使用历史数据将回归与不稳定评估结果分开
检测拉取请求中的未测试 AI 调用
阻止违反评估规则的合并(可配置)
一旦问题解决,解除拉取请求的阻止
每周发送评估报告,汇总性能和问题
支持单一代码库和多个评估工作流程
与 Langfuse、Braintrust 和 LangSmith 集成,无需切换
在设置时提供评估的免费审查
允许编码代理在打开拉取请求之前检查更改
通过不存储源代码或 API 密钥确保安全
如何使用 evalship?
设置:连接您的 GitHub 存储库,并要求您的编码代理设置 evalship,评审您的评估并创建设置拉取请求。
监控拉取请求:evalship 自动监视每个拉取请求,评论破坏评估或引入未测试 AI 调用的更改。
审查报告:访问每个评估的输入、输出和历史的详细报告,以了解故障原因。
优化:使用 evalship 的优化功能,通过您的编码代理测试提示和模型更改,识别超出偶然的改进。
接收报告:每周获取电子邮件报告,汇总评估性能并突出在合并之前捕获的关键问题。
evalship的使用案例
- LLM 评估质量控制
- 自动化拉取请求审查
- 提示和模型优化
- 回归预防
- 未测试 AI 调用检测
- 不稳定评估管理
- 合规性和责任风险缓解
- 开发者工作流程增强