描述
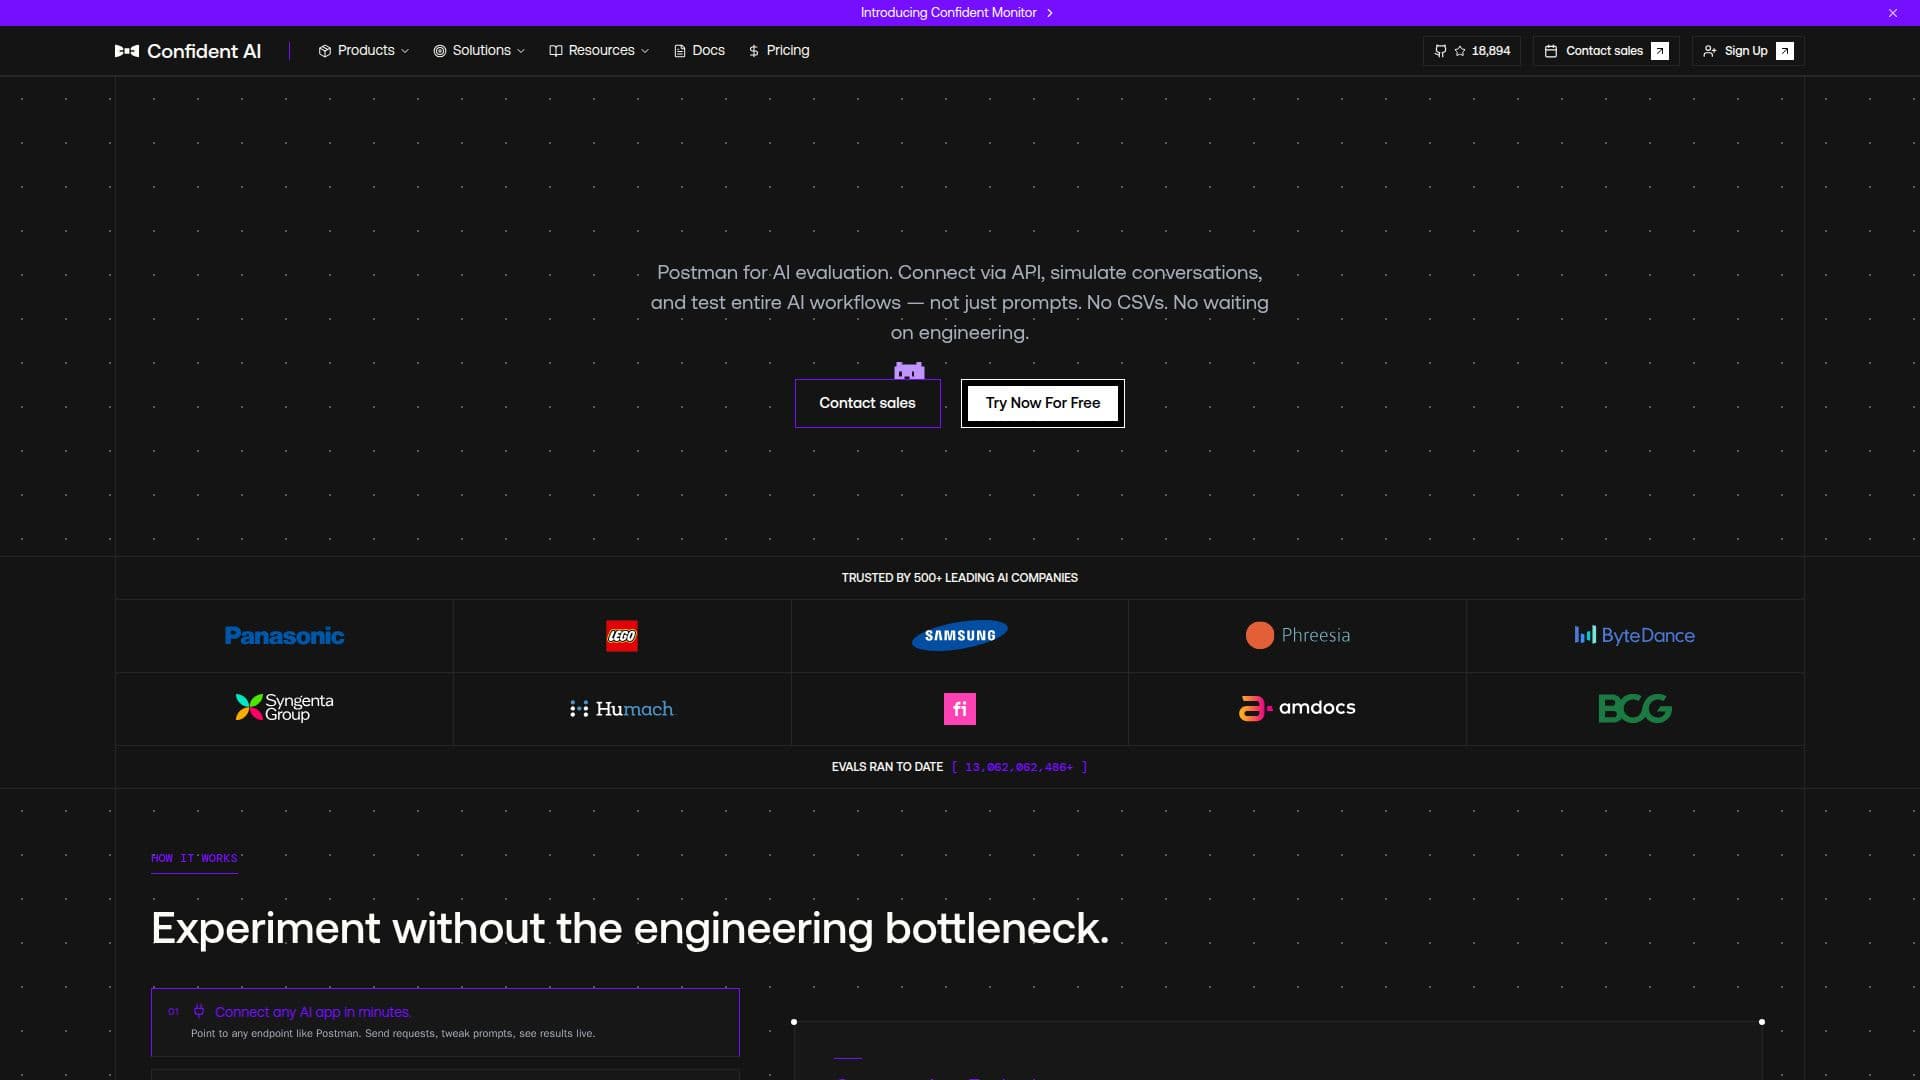
Confident AI 提供一个强大的大型语言模型 (LLM) 评估平台。由 DeepEval 的创建者构建,它允许用户基准测试 AI 系统,比较提示和模型,并使用超过 50 个基于研究的指标捕捉回归。这些指标评估质量、语气、安全性等,利用 LLM 作为评估者。
阅读更多
该平台支持多轮对话测试,使用户能够模拟完整的对话并识别可能仅在多个交流中显现的失败。用户可以更改模型、提示和系统逻辑等变量,并运行实验以在每个指标和管道步骤之间并排比较结果。
Confident AI 旨在用户友好,使产品经理和领域专家能够调整提示、运行实验并评估结果,而无需工程支持。它支持 OpenAI、Anthropic 和 Google 等主要 LLM 提供商,并与云提供商和网关集成。
Confident AI 的定价从个人开发者的 $0 开始,计划可扩展至每月 $2,000,适用于运行业务关键 AI 的团队。企业定价根据组织需求定制。该平台提供慷慨限制的免费层,用户可以随时升级或降级计划。
Confident AI 受到重视 AI 质量的公司的信任,提供将生产失败转化为数据集、对齐指标并防止回归的工具,而无需定制工程工作。它在 AI 评估中节省了大量时间,并提供数据以支持跨团队的质量决策。
- 类别机器学习平台
- 定价模式免费增值
- 部署云端
- 平台网页版
Confident AI的核心功能
LLM 评估套件
50+ 个基于研究的指标
多轮对话测试
无工程依赖
支持主要 LLM 提供商
并排实验比较
可定制的评估模型
与 CI/CD 管道集成
如何使用 Confident AI?
连接:指向任何 AI 应用程序端点
定义:上传测试用例并设置指标
运行:在实时应用程序上执行实验
交付:将评估集成到 CI 中进行质量检查
Confident AI的使用案例
- AI 基准测试
- 提示测试
- 回归检测
- 多轮对话
- 自定义模型评估