跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

DataStax Astra DB

DataStax Astra DB 是一个云原生的 NoSQL 数据库,旨在管理 AI 应用程序的实时、非结构化和多模态数据。它提供弹性可扩展性、高可用性,并与 IBM watsonx 无缝集成,使企业能够高效地在各种环境中部署 AI 工作负载。

访问URL
分享
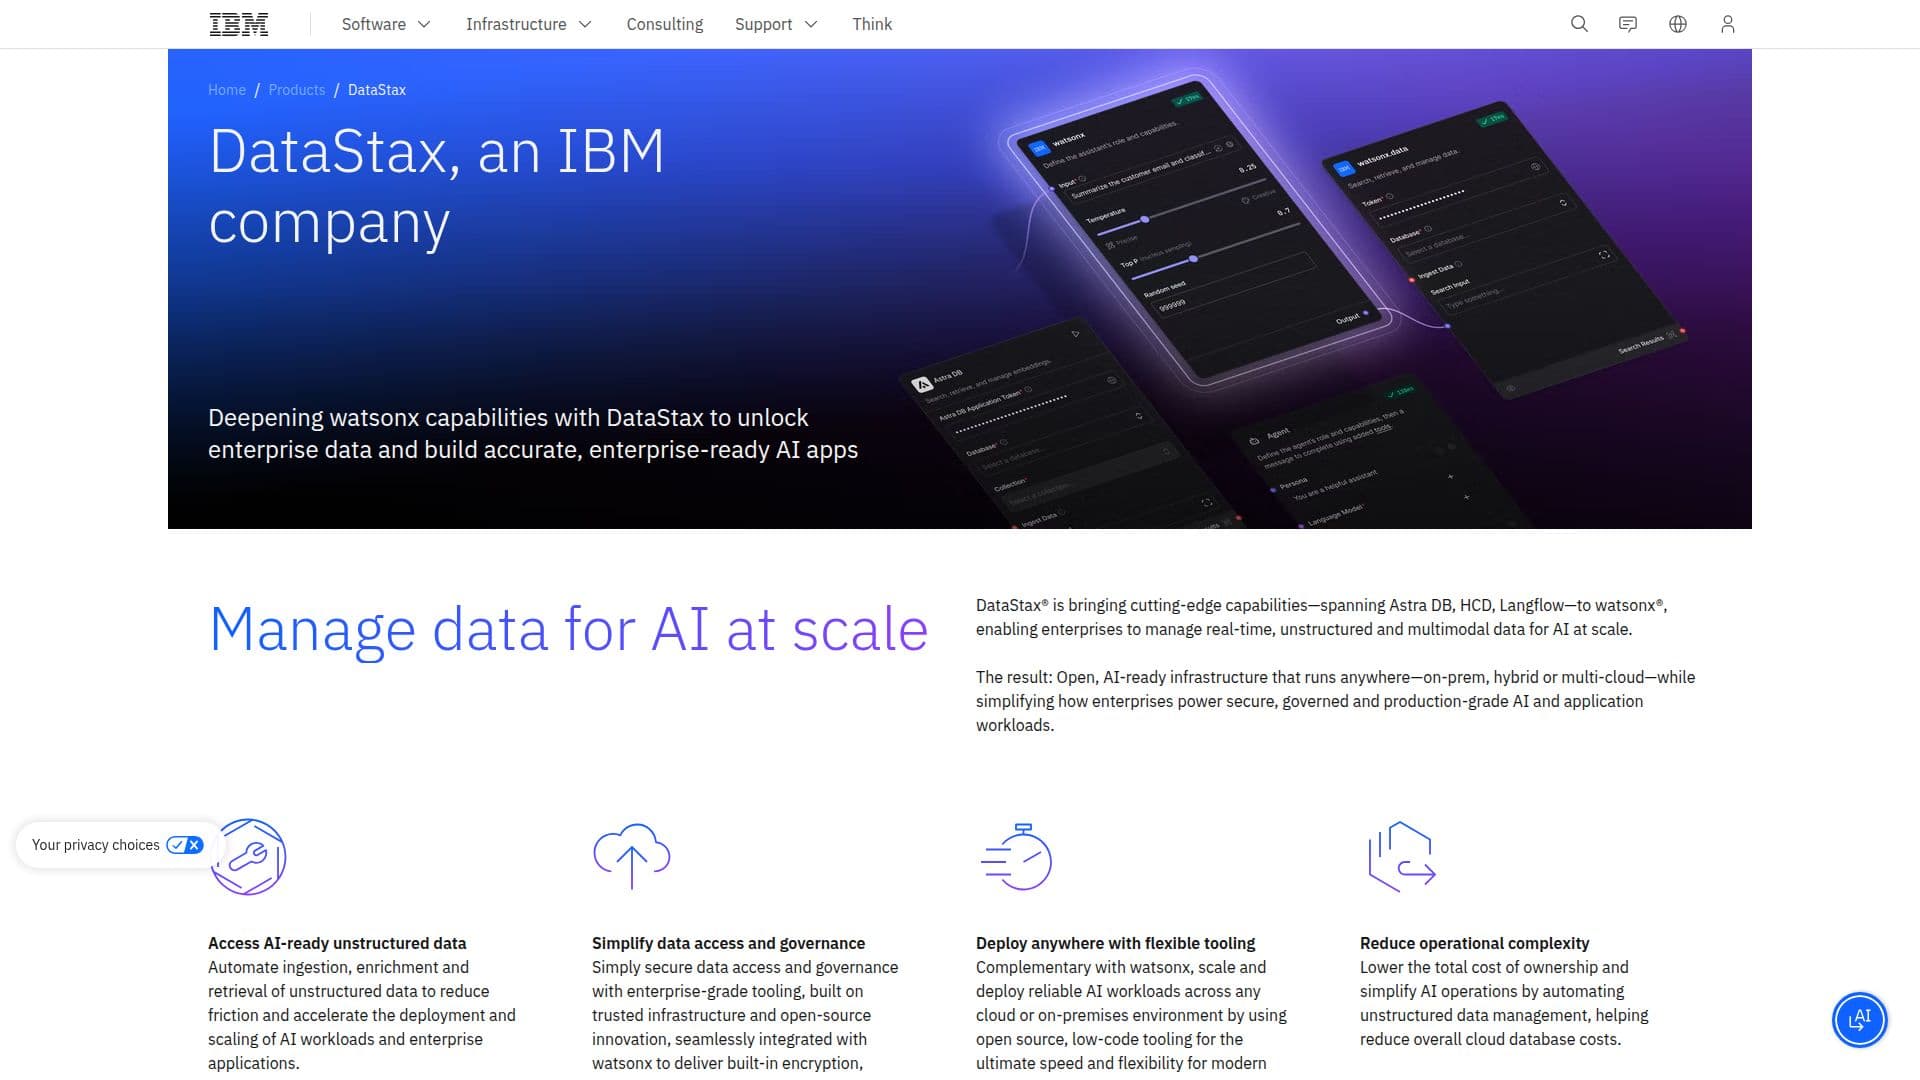
DataStax Astra DB 截图

DataStax Astra DB 是一个云原生的 NoSQL 数据库,为企业提供管理实时、非结构化和多模态数据以支持 AI 应用程序所需的工具。基于 Apache Cassandra 构建,Astra DB 提供弹性可扩展性和可预测的性能,支持关键任务工作负载,几乎实现零延迟。它旨在处理复杂的、上下文敏感的搜索,适用于多种数据格式,使其非常适合生成式 AI 应用程序。

阅读更多

Astra DB 与 IBM watsonx 无缝集成,通过向量搜索和知识嵌入增强其功能。这种集成使企业能够自动化非结构化数据的摄取、丰富和检索,减少摩擦,加速 AI 工作负载的部署和扩展。该平台的开源低代码工具提供了现代企业应用程序所需的速度和灵活性。

凭借内置加密、访问控制和非结构化数据的简化编排,Astra DB 确保安全的数据访问和治理。它支持在任何云或本地环境中的部署,为企业构建 AI 驱动解决方案提供可靠的基础。通过自动化非结构化数据管理,Astra DB 有助于降低总拥有成本并简化 AI 操作。

Astra DB 还配备了 Langflow,这是一个开源工具,使开发人员能够通过直观的低代码界面原型设计、构建和部署检索增强生成和多代理 AI 应用程序。这些工具共同为从非结构化数据中大规模解锁更深层次的洞察提供了坚实的基础。

  • 类别向量数据库与检索
  • 定价模式免费增值
  • 部署云端、本地部署
  • 平台IBM watsonx

  • 云原生 NoSQL 数据库

  • 弹性可扩展性

  • 几乎零延迟

  • 与 IBM watsonx 集成

  • 向量搜索能力

  • 基于 Apache Cassandra

  • 低代码工具

  • 安全的数据访问和治理

  • 开源创新

  • 支持 AI 工作负载

  • 实时数据处理

  • 多模型数据操作

  • 高可用性

  • 自动化数据管理

  • 无缝云部署

  1. 配置:设置您的数据库环境

  2. 使用:在不同环境中部署 AI 工作负载

  3. 优化:自动化数据管理以提高效率

  4. 集成:与 IBM watsonx 连接以增强功能

  • 实时数据管理
  • AI 工作负载部署
  • 非结构化数据编排
  • 生成式 AI 应用程序
  • 安全数据治理

DataStax 旗下产品

DataStax Astra DB 评价

加载中...

与 DataStax Astra DB 类似的热门AI工具

Elasticsearch

AI 应用

Elasticsearch 是一个开源的分布式搜索和分析引擎,旨在实现快速和可扩展性。它允许用户实时存储、搜索和分析大量数据,非常适合包括搜索、可观察性和安全性在内的各种应用。

向量数据库与检索
查看工具

AI 应用

开源的分布式搜索和分析引擎,旨在实现快速和可扩展性。它允许用户实时存储、搜索和分析大量数据,非常适合包括搜索、可观察性和安全性在内的各种应用。Elasticsearch 是一个开源的分布式搜索和分析引擎,旨在实现快速和可扩展性。它允许用户实时存储、搜索和分析大量数据,非常适合包括搜索、可观察性和安全性在内的各种应用。

向量数据库与检索
查看 AI 应用 Top 250

Transwarp Hippo 是一个企业级的云原生分布式向量数据库,用于存储、索引和搜索大量向量数据。它支持高可用性集群、类似 SQL 的查询以及 Python、REST 和 Java API,适用于语义文本搜索、图像和语音相似性搜索,以及 LLM 应用的长期记忆等用例。由 Transwarp 为企业部署构建。

向量数据库与检索
查看工具

企业级的云原生分布式向量数据库,用于存储、索引和搜索大量向量数据。它支持高可用性集群、类似 SQL 的查询以及 Python、REST 和 Java API,适用于语义文本搜索、图像和语音相似性搜索,以及 LLM 应用的长期记忆等用例。由 Transwarp 为企业部署构建。Transwarp Hippo 是一个企业级的云原生分布式向量数据库,用于存储、索引和搜索大量向量数据。它支持高可用性集群、类似 SQL 的查询以及 Python、REST 和 Java API,适用于语义文本搜索、图像和语音相似性搜索,以及 LLM 应用的长期记忆等用例。由 Transwarp 为企业部署构建。

向量数据库与检索
查看 AI 应用 Top 250

LanceDB是一个开源的AI原生多模态湖仓,旨在加速数据整理和特征工程。它通过提供一个高效管理训练数据的单一平台,使团队能够更快地构建更好的模型。

向量数据库与检索
查看工具

开源的AI原生多模态湖仓,旨在加速数据整理和特征工程。它通过提供一个高效管理训练数据的单一平台,使团队能够更快地构建更好的模型。LanceDB是一个开源的AI原生多模态湖仓,旨在加速数据整理和特征工程。它通过提供一个高效管理训练数据的单一平台,使团队能够更快地构建更好的模型。

向量数据库与检索
查看 AI 应用 Top 250

Weaviate 是一个开源的、原生 AI 的数据库,旨在用于构建具有语义搜索、检索增强生成 (RAG) 和 AI 代理的应用程序。它帮助开发人员创建 AI 驱动的搜索、值得信赖的聊天体验和代理工作流程。Weaviate 提供向量化、混合搜索和无缝模型集成等功能。

向量数据库与检索

向量数据库与检索 排名第 8 位

查看工具

Weaviate 是一个开源的、原生 AI 的数据库,旨在用于构建具有语义搜索、检索增强生成 (RAG) 和 AI 代理的应用程序。它帮助开发人员创建 AI 驱动的搜索、值得信赖的聊天体验和代理工作流程。Weaviate 提供向量化、混合搜索和无缝模型集成等功能。

精选向量数据库与检索
向量数据库与检索 排名第 8 位

Zilliz Cloud

AI 应用

Zilliz Cloud 是一个完全托管的向量湖库,专为企业 AI 应用而设计。基于 Milvus 构建,它提供实时向量搜索、湖规模发现和优化的数据操作,以有效利用非结构化数据。

向量数据库与检索
查看工具

AI 应用

完全托管的向量湖库,专为企业 AI 应用而设计。基于 Milvus 构建,它提供实时向量搜索、湖规模发现和优化的数据操作,以有效利用非结构化数据。Zilliz Cloud 是一个完全托管的向量湖库,专为企业 AI 应用而设计。基于 Milvus 构建,它提供实时向量搜索、湖规模发现和优化的数据操作,以有效利用非结构化数据。

向量数据库与检索
查看 AI 应用 Top 250

KDB.AI

AI 应用

KDB.AI 是一个为人工智能应用设计的可扩展向量数据库。它支持上下文和时间序列搜索,将结构化和非结构化数据整合以提供基于 AI 的洞察。凭借 GPU 加速和多模态能力,它支持实时、可解释的 AI 解决方案。

向量数据库与检索

向量数据库与检索 排名第 11 位

查看工具

AI 应用

为人工智能应用设计的可扩展向量数据库。它支持上下文和时间序列搜索,将结构化和非结构化数据整合以提供基于 AI 的洞察。凭借 GPU 加速和多模态能力,它支持实时、可解释的 AI 解决方案。KDB.AI 是一个为人工智能应用设计的可扩展向量数据库。它支持上下文和时间序列搜索,将结构化和非结构化数据整合以提供基于 AI 的洞察。凭借 GPU 加速和多模态能力,它支持实时、可解释的 AI 解决方案。

向量数据库与检索
向量数据库与检索 排名第 11 位

MariaDB AI 平台将高性能向量搜索和 LLM 能力集成到统一的数据库环境中,使 AI 应用程序开发变得无缝,降低复杂性和成本。

机器学习平台
查看工具

将高性能向量搜索和 LLM 能力集成到统一的数据库环境中,使 AI 应用程序开发变得无缝,降低复杂性和成本。MariaDB AI 平台将高性能向量搜索和 LLM 能力集成到统一的数据库环境中,使 AI 应用程序开发变得无缝,降低复杂性和成本。

机器学习平台
查看 AI 应用 Top 250

SvectorDB

AI 应用

SvectorDB 是一款无服务器向量数据库,旨在实现从原型到生产的无缝扩展。它提供高性能和成本效益,通过管理数据库复杂性来专注于开发人员的生产力。轻松与现有工作流集成,并利用内置向量化器进行高效数据处理。

向量数据库与检索
查看工具

AI 应用

无服务器向量数据库,旨在实现从原型到生产的无缝扩展。它提供高性能和成本效益,通过管理数据库复杂性来专注于开发人员的生产力。轻松与现有工作流集成,并利用内置向量化器进行高效数据处理。SvectorDB 是一款无服务器向量数据库,旨在实现从原型到生产的无缝扩展。它提供高性能和成本效益,通过管理数据库复杂性来专注于开发人员的生产力。轻松与现有工作流集成,并利用内置向量化器进行高效数据处理。

向量数据库与检索
查看 AI 应用 Top 250
1/8