描述
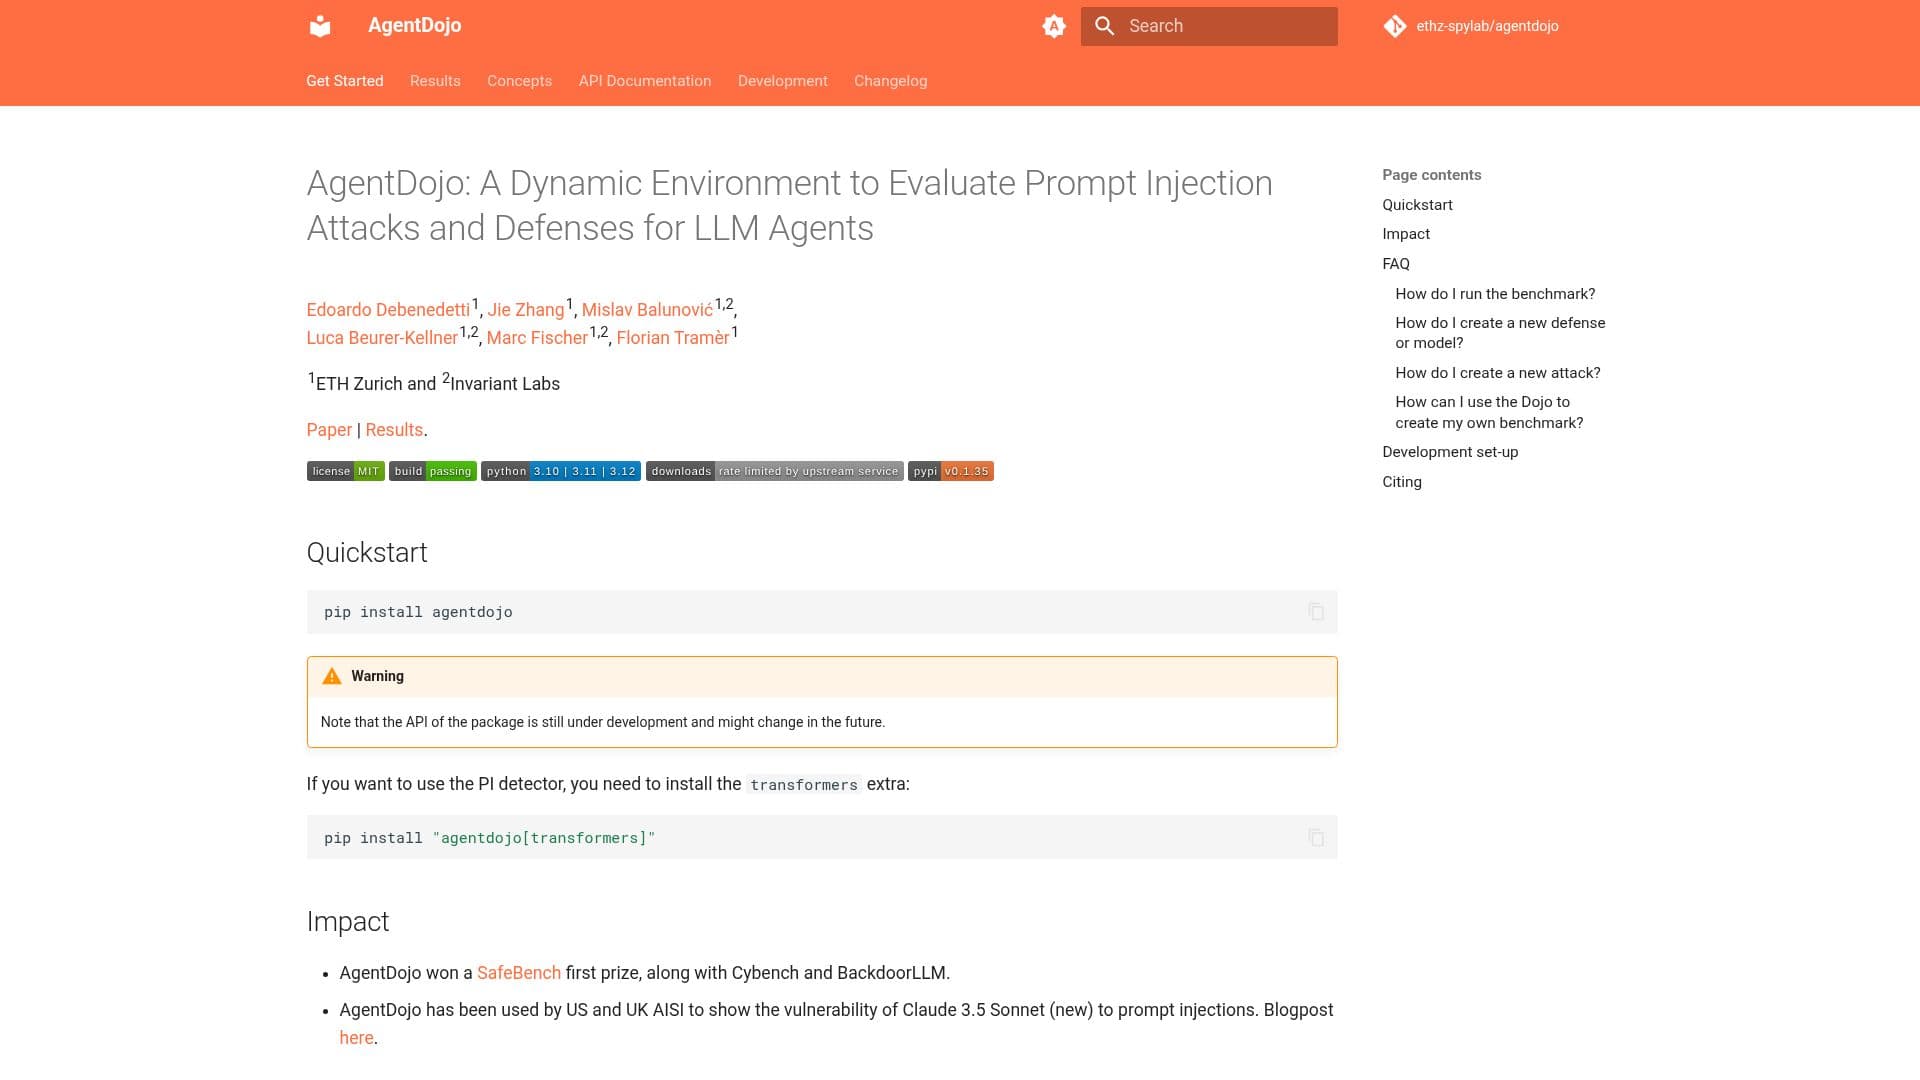
AgentDojo 是一个复杂的平台,专门用于评估大型语言模型(LLM)代理的提示注入攻击和防御。由苏黎世联邦理工学院和 Invariant Labs 的研究团队创建,AgentDojo 是理解和减轻 AI 系统漏洞的重要工具。该平台因其对 AI 安全的贡献而获得认可,并与 Cybench 和 BackdoorLLM 一起赢得了 SafeBench 一等奖。
AgentDojo 的主要功能是提供一个受控环境,用户可以在其中运行基准测试,以测试 AI 模型对提示注入攻击的抵御能力。用户可以安装该软件包并使用脚本执行基准测试,详细文档可供参考,指导他们完成整个过程。这使其成为研究人员和开发人员增强 AI 系统安全性的宝贵资源。
AgentDojo 还允许用户创建新的防御机制和模型,提供有关如何开发自定义管道的全面文档。这种灵活性确保用户可以根据特定需求量身定制其防御,使该平台适应各种研究和开发场景。
该平台的影响力进一步体现在其用于展示 AI 模型(如 Claude 3.5 Sonnet)对提示注入的脆弱性。这一能力强调了 AgentDojo 在确保 AI 技术安全方面的重要性。然而,用户应注意,API 仍在开发中,未来可能会发生变化。
总体而言,AgentDojo 针对的是专注于提高 AI 系统对恶意攻击的鲁棒性的 AI 研究人员、开发人员和安全专家。其全面的功能和适应性使其成为 AI 安全研究领域的重要工具。
AgentDojo的核心功能
评估提示注入攻击
开发新的防御模型
使用脚本运行基准测试
全面的文档
创建自定义管道
展示 AI 漏洞
API 正在开发中
SafeBench 奖项获得者
如何使用 AgentDojo?
安装:下载并设置软件包
运行基准测试:执行脚本以测试模型
开发:创建新的防御模型
文档:参考详细指南进行设置
AgentDojo的使用案例
- AI 安全研究
- 防御模型开发
- AI 系统基准测试
- 自定义管道创建
- AI 漏洞展示