描述
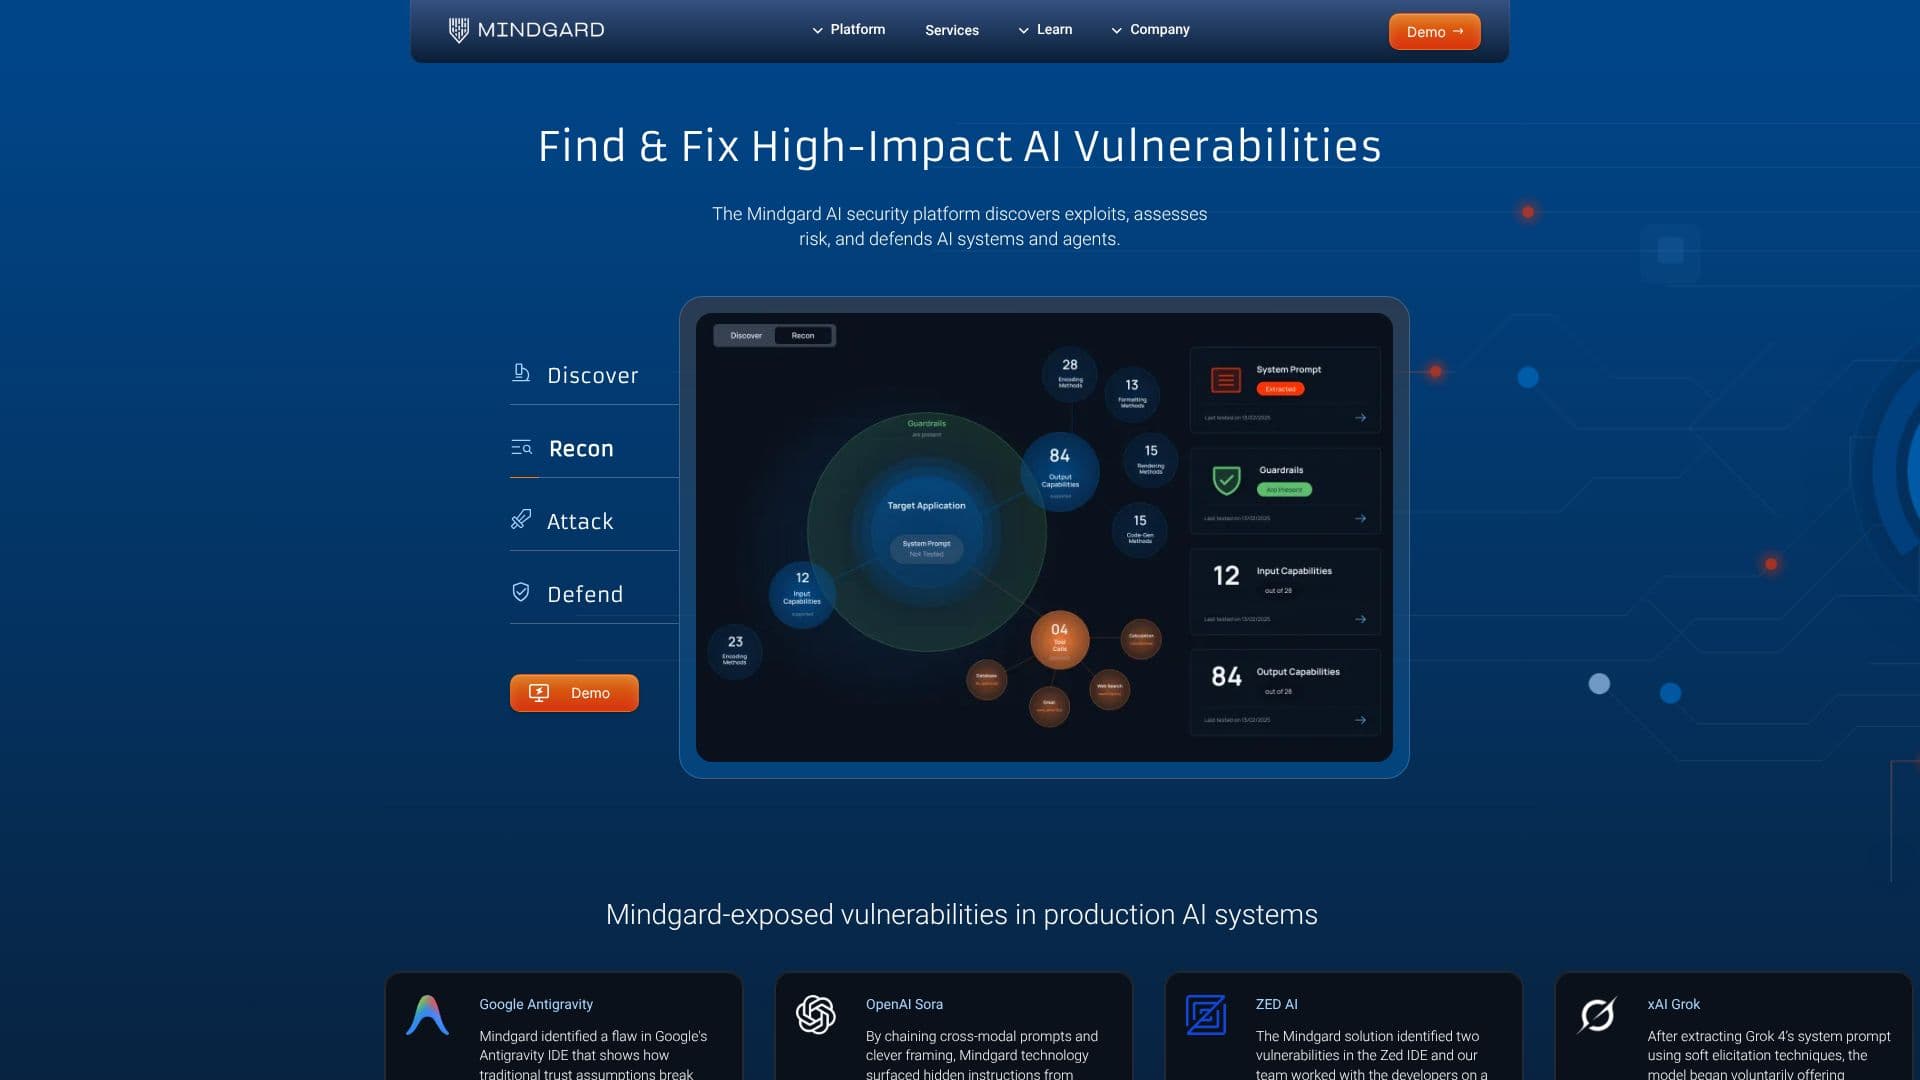
Mindgard 是一个 AI 安全平台,旨在自动化 AI 模型、代理和应用程序的红队演练和安全测试过程。该平台的核心功能是通过模仿对抗性侦察技术来发现、评估和防御 AI 系统免受潜在威胁。通过充当自主红队,Mindgard 绘制 AI 攻击面图,揭示攻击者可能如何发现和利用 AI 代理和系统。这种主动方法暴露了关键的安全和风险影响,使开发团队能够在漏洞导致实际影响之前进行修复。
阅读更多
该平台采用持续分析和运行时保护机制,帮助团队查找、修复并阻止攻击。Mindgard 的功能涵盖 AI 安全的各个方面,包括 AI 代理评估和安全扫描、用于影子 AI 风险暴露的 AI-BOM(物料清单)以及自动化的 AI 基础设施爬取。它还提供侦察 AI 攻击面枚举、心理测量代理分析以及代理配置文件和护栏破解。
Mindgard 的方法基于攻击者风格的侦察,这使其能够发现可利用的风险,而不仅仅是噪音。这种对高影响发现的关注源于兰开斯特大学十多年的 AI 安全研究。该平台专为运营效率而设计,可通过 CI/CD 管道、Burp Suite 或一键部署,使高级 AI 安全洞察触手可及,而无需内部 AI 安全专家。它与现有的企业 AI 工作流、API 和 CI/CD 支持无缝集成,从而保护从开源模型到托管 AI 平台的生产环境和基础设施中的 AI。
关键的差异化因素包括代理原生侦察,它从攻击者的角度分析 AI 系统,在攻击执行前绘制模型、代理、工具和行为的图谱。这种方法比传统的基于提示的方法更快地暴露高影响漏洞。Mindgard 的研究为领先 AI 系统中的 100 多项公开漏洞披露做出了贡献,这证明了其有效性。该平台提供可操作的 AI 安全洞察,使团队能够全面保护其 AI 系统。
- 类别AI 网络安全工具
- 定价模式联系销售
- 部署CI/CD,Burp Suite,单击
- 平台网页版
Mindgard AI 安全的核心功能
自动化 AI 红队演练
AI 模型安全测试
AI 代理安全评估
AI 应用程序安全
攻击面映射
漏洞发现
风险评估
运行时保护
代理原生侦察
可利用风险检测
CI/CD 集成
API 和工作流集成
AI 治理和合规性报告
如何使用 Mindgard AI 安全?
发现:绘制 AI 系统图并识别潜在的攻击向量。
评估:评估 AI 模型、代理和应用程序的漏洞。
红队演练:模拟对抗性攻击以发现可利用的风险。
防御:实施运行时保护和加固措施。
修复:修复已识别的漏洞以保护 AI 系统。
监控:持续分析和保护 AI 环境。
Mindgard AI 安全的使用案例
- AI 漏洞发现
- AI 攻击面映射
- 自动化红队演练
- AI 代理安全
- 运行时 AI 保护
- 影子 AI 风险管理