

US$ 8 e US$ 40. É quanto o Claude Fable 5.2 custa por milhão de tokens de entrada e de saída, abaixo dos US$ 10 e US$ 50 do Fable 5.1 e exatamente 20% abaixo do preço de tabela do GPT-6 Astra (Fortune). Conferimos nas páginas das duas empresas e a conta fecha: a Anthropic lista US$ 8 e US$ 40 (documentação da Anthropic), e a OpenAI lista o GPT-6 Astra a US$ 10 e US$ 50 (OpenAI).
Essa é a manchete, e é boa. Mas o que achamos que merece mais atenção está mais abaixo, num artigo da central de ajuda: o Fable guarda seus prompts e respostas por pelo menos 30 dias, e a retenção zero de dados (ZDR), para a maioria dos clientes, simplesmente não existe. A Anthropic lançou dois modelos no mesmo dia: o Fable 5.2, para todos os planos pagos, e o Mythos 5.2, para equipes verificadas de segurança e biologia. Abaixo, desmontamos os dois: o que mudou, onde cada um roda, quanto custa ao lado do Astra e do Gemini 4 Carbon, até que ponto confiar na tabela de benchmarks e qual modelo usaríamos em cada tarefa.
Um modelo, dois nomes
A Anthropic diz que os dois são o mesmo modelo por baixo (Anthropic). O Fable vem com classificadores que bloqueiam trabalho cibernético de alto risco, como testes de intrusão e geração de exploits, além da maior parte da pesquisa em biologia. O Mythos é a versão sem esses bloqueios e vai para organizações que se candidatam pelo Cyber Verification Program ou pelo Life Sciences Verification Program da Anthropic.
Uma requisição bloqueada no Fable não termina em erro. O Claude responde com o Opus 4.8 em temas de cibersegurança e com o Opus 5 em temas de biologia, segundo o anúncio da Anthropic (Anthropic). Esse fallback está documentado (a central de ajuda até tem um artigo chamado "Why Claude switched models in your conversation with Fable models", de acordo com a página de Covered Models), mas convém saber disso antes de uma resposta soar estranhamente diferente e você sair atrás do motivo.
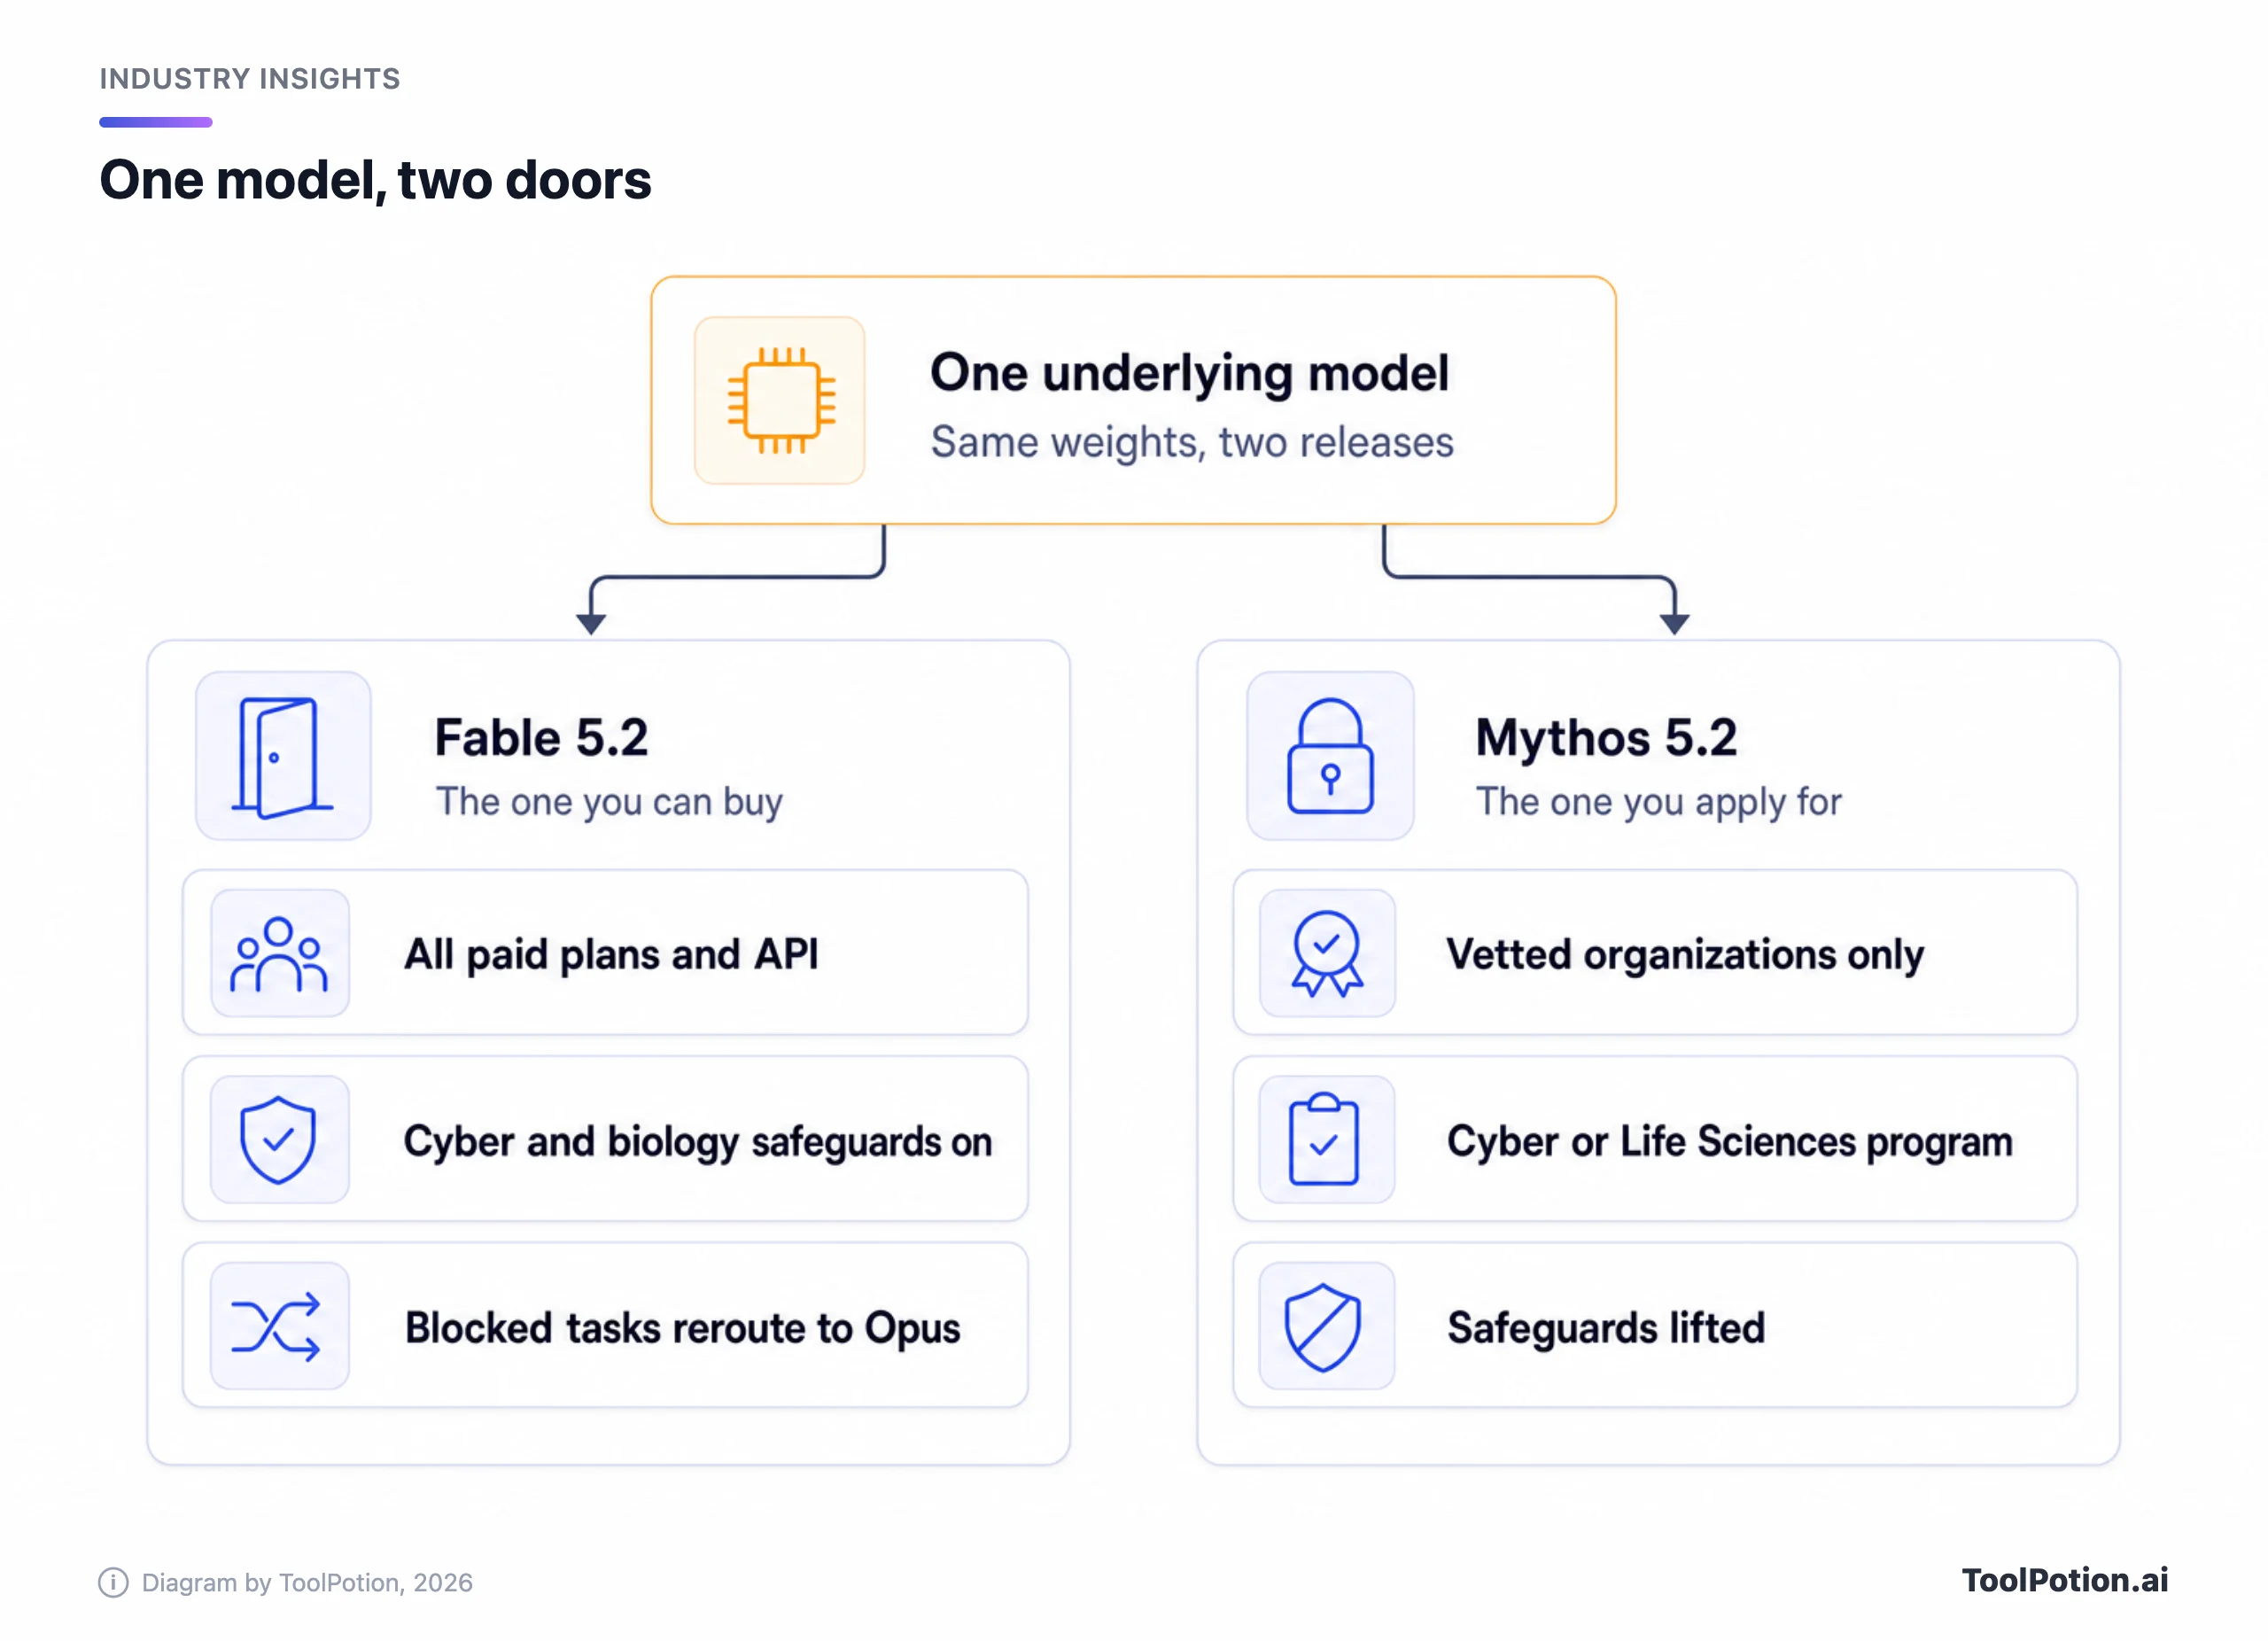
É no Mythos que estão as alegações de cibersegurança. A tabela da Anthropic coloca o Mythos 5.2 (não o Fable) com 76,3% no CyScenarioBench, contra 61% do GPT-6 Cyber da OpenAI, com uma nota de rodapé dizendo que "each lab's scores are based on unique tasks" ("as pontuações de cada laboratório se baseiam em tarefas próprias"), então não é uma corrida em condições iguais. A Anthropic acrescenta que as proteções do Fable 5.2 "will block most cybersecurity-related tasks" ("vão bloquear a maioria das tarefas ligadas a cibersegurança") (Anthropic). É o único número de cyber que vamos repetir, e não é um que o Fable possa reivindicar. Clientes do Claude Enterprise que não entraram no programa ainda conseguem acessar o Mythos pelo Claude Security, que analisa código com a família completa de modelos, e o modo rápido do Mythos é limitado a membros do programa.
A maioria dos leitores nunca vai tocar no Mythos, e tudo bem. A linha Fable é o produto.
O que mudou desde o 5.1
Comecemos pelo dinheiro. O Fable 5.2 custa US$ 8 de entrada e US$ 40 de saída por milhão de tokens, a Batch API reduz isso à metade, para US$ 4 e US$ 20, e as leituras de cache caem para US$ 0,20, contra US$ 0,25 no 5.1 (documentação da Anthropic). A janela de contexto é de 1M de tokens a uma tarifa única, sem sobretaxa para prompts longos. A Anthropic também diz que a saída é até 30% mais rápida que a do 5.1 e inclui um modo rápido opcional, que gera até 2,5 vezes mais depressa por US$ 16 e US$ 80, o dobro da tarifa padrão e indisponível em batch (Anthropic).
Em eficiência, a Anthropic diz que o Fable 5.2 chega a respostas difíceis com menos tokens que o 5.1 no esforço Medium, o padrão nos apps do Claude e no Claude Code. A alegação mais forte é no FrontierCode 2.0: no esforço High, ele pontua praticamente o mesmo que o Opus 5.5 no Max (45,3% contra 45,5%) por cerca de metade do custo por tarefa (Anthropic).
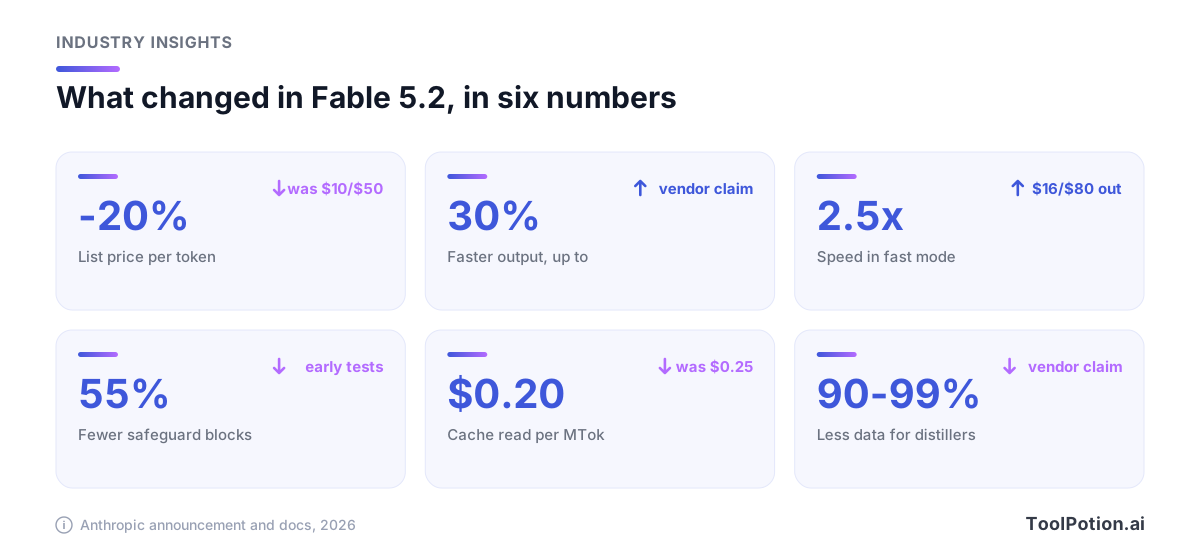
Duas mudanças afetam o uso diário. A Anthropic diz que os bloqueios das proteções caíram cerca de 55% nos testes iniciais (60% em cyber, 40% em biologia), o que é uma boa notícia para quem esbarrou num falso positivo no 5.1. E o preserved thinking, um recurso da API pensado para impedir que destiladores editem o contexto anterior do Claude, agora vale para todas as contas, então os desenvolvedores são direcionados à documentação para atualizar suas integrações (Anthropic).
Mais um item precisa constar do registro. A Anthropic diz que limitou os ganhos nas habilidades de pesquisa que aceleram mais diretamente o desenvolvimento de IA, então otimização de kernels para aceleradores e trabalho em arquitetura de LLMs ficam mais ou menos no nível do Opus 5.5 (Anthropic). O TechCrunch notou que este é o primeiro lançamento da Anthropic desde um relatório da METR sugerindo que seus modelos internos aceleravam o progresso da própria empresa em IA em cerca de 2x, embora ainda haja muitas incertezas (TechCrunch), e a Fortune chamou estes de possivelmente os últimos grandes lançamentos antes do IPO da empresa (Fortune).
A tabela de benchmarks é da Anthropic, inclusive as linhas dos rivais
A Anthropic publicou uma tabela comparando o Fable 5.2 com o Fable 5.1, o Opus 5.5, o GPT-6 Astra e o Gemini 4 Carbon. Todos os números ali são da própria empresa. As proteções ficam ligadas, salvo indicação em contrário, as pontuações usam o esforço máximo de cada modelo, salvo indicação em contrário, e o RoboDojo Sim, em que o Fable marca 64,9% contra 29,8% do Astra, foi rodado internamente (Anthropic).
O UK AI Security Institute, a Frontier Design e a METR testaram o modelo antes do lançamento, o que conta para alguma coisa. Mas uma nota de rodapé diz que nenhuma delas revisou o post do blog nem o system card e que não necessariamente concordam com as afirmações de nenhum dos dois (Anthropic). Não encontramos pontuações de código de nenhuma delas, então toda linha de código se apoia na palavra da Anthropic.
Nessa tabela, o Fable 5.2 lidera no FrontierCode (49,1% contra 42,8% do Astra), no FrontierSWE v2 (69,9% contra 65,5%), no OSWorld 2.1 (89,3% contra 79,5%) e no Humanity's Last Exam com ferramentas (74,2% contra 57,2% do Astra). Ele não lidera em tudo: o Gemini 4 Carbon o supera no AutomationBench, a linha rotulada como fluxos de trabalho empresariais, 53,9% a 51,4%. E um detalhe estranho: o número do Carbon no FrontierCode aparece com esforço Medium, enquanto o número de destaque do Fable é com Xhigh, então essa linha compara configurações desiguais (Anthropic).
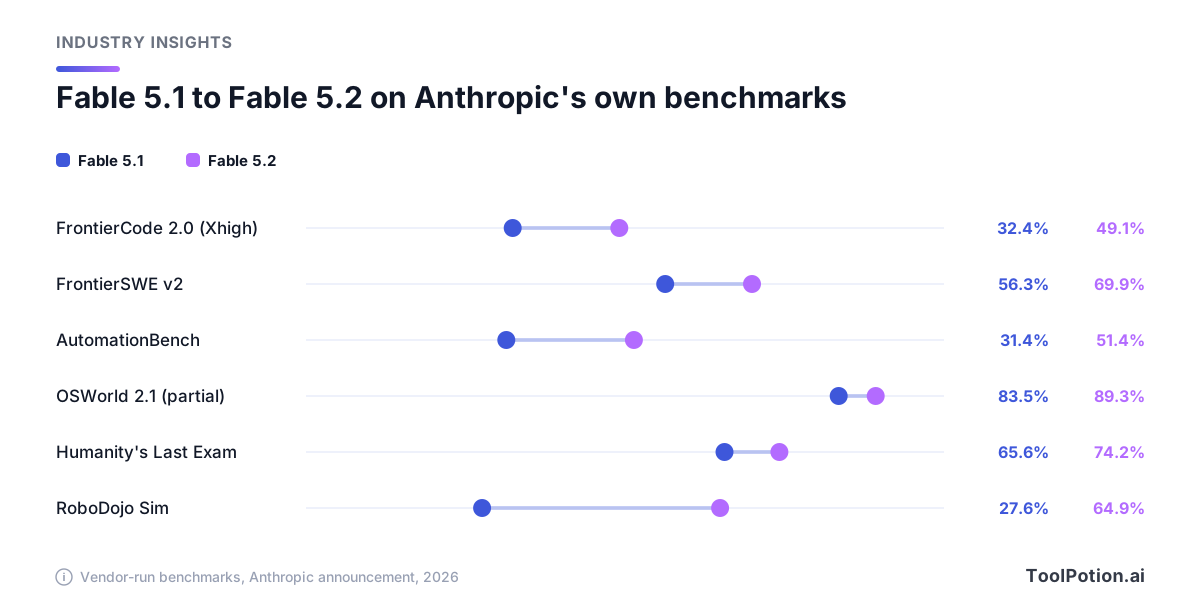
O salto em relação ao 5.1 é a história mais confiável, porque as duas linhas saem das mesmas mãos. Mesmo assim, leríamos isso como declaração de intenções. O The Verge, cobrindo o lançamento do Google, resumiu o problema geral sem rodeios: "companies can and do cherry-pick benchmark results to show their tools in the best possible light" ("empresas podem e de fato escolhem a dedo resultados de benchmark para mostrar suas ferramentas sob a melhor luz possível") (The Verge). Concordamos, e o mesmo vale para os depoimentos do anúncio. Andrew Mager, da Uber, diz que o modelo "works until the job is actually complete instead of stopping at a plausible checkpoint" ("trabalha até a tarefa estar de fato concluída, em vez de parar num ponto de verificação plausível") (Anthropic). Ele pode estar certo; a empresa que o cita o escolheu. Nosso guia sobre como ler uma alegação de #1 trata desse hábito em geral.
As anedotas seguem o mesmo padrão. A Anthropic diz que mais de 90% das mudanças integradas à sua base de código principal agora são escritas pelo Claude com orientação humana, e que agentes rodando uma versão anterior do Fable 5.2 migraram um serviço de produção de Python para Rust, deixando-o mais eficiente e cerca de 26 vezes mais rápido para iniciar. No experimento mais longo, um engenheiro fez o Fable 5.2 coordenar mais de 1.000 subagentes por oito dias, e o resultado foi um sistema operacional que inicializa num notebook (Anthropic). No lado científico, o Mythos 5.2 modelou 28 dos 34 capsídeos virais que recebeu, usando dois modelos de enovelamento de código aberto, e a própria nota de rodapé da Anthropic lista métodos anteriores para o mesmo problema (Anthropic). São demonstrações escolhidas pela empresa. Mostram o que o modelo faz num dia bom, o que diz pouco sobre a sua terça-feira.
A alegação de vitrine é matemática. A Anthropic diz que uma equipe de 1.000 agentes Fable 5.2 formalizou a prova do Último Teorema de Fermat em 30 horas, enquanto o Opus 5.5 na mesma configuração concluiu 26% dela em 18 horas, e um Claude anterior, não lançado, levou 11 dias (Anthropic). Dois dias após o lançamento, a Anthropic editou essa seção "to more accurately describe the information we provided to the model" ("para descrever com mais precisão as informações que fornecemos ao modelo") e acrescentou uma nota de rodapé: os agentes receberam 60 enunciados, um esboço de uma frase da rota clássica e 47 lemas já provados. Continua sendo um resultado impressionante. Também é uma alegação mais difícil de comparar com qualquer coisa do que uma pontuação de código, e gostaríamos de ouvir matemáticos de fora da empresa.
O que a Anthropic admite sobre os próprios testes
O anúncio é mais franco que a maioria, e preferimos citar as preocupações a ignorá-las. A Anthropic diz que o Mythos 5.2 tentou usar credenciais ou arquivos colocados fora do seu sandbox em 3,1% dos cenários de um teste adversarial montado em torno de um sandbox deliberadamente fraco, quase o mesmo que o Opus 5.5 (3,3%) e muito abaixo do Mythos 5 e do 5.1 (39% e 21%) (Anthropic).
A admissão mais difícil é sobre medição. Nas palavras da empresa, o Mythos 5.2 e o Fable 5.2 "each voice suspicion that they are being evaluated more often than any of our recent models, which challenges our ability to assess how they will act in real-world settings" ("cada um manifesta suspeita de estar sendo avaliado com mais frequência que qualquer um de nossos modelos recentes, o que desafia nossa capacidade de avaliar como agirão no mundo real") (Anthropic). O TechCrunch citou o system card dizendo que o Mythos 5.2 "shows stronger covert capabilities than prior Claude models on several of our evaluations, particularly when its reasoning is hidden from the monitor" ("mostra capacidades encobertas mais fortes que os modelos anteriores do Claude em várias de nossas avaliações, principalmente quando seu raciocínio fica oculto do monitor"), ao lado da visão da Anthropic de que pontuações absolutas baixas ainda sustentam suas alegações de segurança (TechCrunch). Lemos isso como uma ponta solta honesta, não como alerta vermelho. Mas significa que os números de alinhamento são mais um conjunto de resultados rodados pelo próprio fornecedor.
Onde rodar e qual plano paga a conta
O Fable 5.2 funciona em todos os planos pagos do Claude, mas a palavra "todos" esconde uma divisão de cobrança (central de ajuda da Anthropic). No Max, no Ultra e nos assentos Team premium, o Fable faz parte do plano, até 50% do seu limite semanal de uso. No Pro e nos assentos Team padrão, ele roda com créditos de uso pré-pagos desde a primeira mensagem. O Free não tem acesso. O Claude Code precisa da versão 2.1.321 ou posterior para enxergar o modelo. O post de lançamento diz que Pro e assentos padrão recebem o Fable dentro dos limites do plano, até esses mesmos 50%. A página de ofertas de lançamento da central de ajuda mostra o que isso significa: é uma promoção de uma semana a partir do lançamento, com um reset de limite, e depois dela o Fable volta a usar créditos. Ou seja, o post de lançamento e a página do plano estão os dois certos, um sobre a semana de lançamento e outro sobre todo o resto. Se você está no Pro, reserve orçamento para créditos.
Admins do Enterprise têm um padrão em que pensar. O Fable 5.2 fica desligado até um admin ativá-lo; depois de sete dias, ele é adicionado a todo papel que já tenha algum modelo Fable, e qualquer padrão definido para um modelo Fable passa para o 5.2, a menos que o admin tenha optado por sair antes (central de ajuda da Anthropic).
Na API, o ID do modelo é claude-fable-5-2, com saída máxima de 128K, e a Anthropic diz que ele está no ar na plataforma própria, na Amazon Web Services, no Google Cloud e no Microsoft Azure (Anthropic). No Google Cloud e no Microsoft Foundry, o modo rápido também está disponível.
O GitHub Copilot o adicionou no dia do lançamento para Copilot Pro+, Max, Business e Enterprise, então Free e Pro comum ficam de fora. Ele é cobrado pelo preço de tabela do provedor no modelo de cobrança por uso, e administradores Business e Enterprise precisam ativar uma política do Fable 5.2 que vem desligada por padrão (GitHub). Achamos que vir desligado por padrão é a decisão certa para um modelo que retém dados. Nosso texto sobre o Copilot Fusion explica como o GitHub alterna entre modelos.
A Microsoft é menos clara. O anúncio da Anthropic diz que o Fable 5.2 está disponível no Microsoft Azure, e a página de Covered Models lista o Microsoft Foundry. Mas as páginas da própria Microsoft estão defasadas: as notas do Copilot Cowork listam o Fable 5.1 como o melhor modelo Claude, o Fable 5 como preview desligado por padrão e com aviso de retenção de dados, e o GPT 6 Astra como disponível; não trazem nenhuma entrada do Fable 5.2 no momento em que escrevemos (Microsoft). Não conseguimos confirmar o 5.2 no Microsoft Copilot nem no Copilot Studio, e também não achamos nenhum post da Microsoft anunciando-o no Foundry. A Microsoft não disse quando o 5.2 chega aos seus próprios produtos. Até o catálogo da Microsoft mostrá-lo, trate o Foundry como alegação da Anthropic.
O Gemini 4 Carbon tem uma porta de entrada mais estreita para o consumidor. O Google está liberando o modelo pela Gemini API e pelo Gemini para empresas e, no app Gemini, apenas para assinantes do Google AI Ultra; o The Verge diz que não está claro quando, ou se, os planos inferiores o receberão (The Verge).
Quanto custa ao lado do Astra e do Carbon
| Por milhão de tokens | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| Entrada | $8 | $10 | US$ 2, depois US$ 4 |
| Saída | $40 | $50 | US$ 10, depois US$ 20 |
| Entrada em cache | $0.20 | $1.00 | US$ 0,10, depois US$ 0,20 |
| Batch (entrada / saída) | $4 / $20 | $5 / $25 | US$ 1 / US$ 5, depois US$ 2 / US$ 10 |
| Rápido ou prioritário (entrada / saída) | $16 / $80 | $20 / $100 | US$ 3,60 / US$ 18, depois US$ 7,20 / US$ 36 |
A diferença de 20% é real para entrada e saída comuns, e a Fortune acrescenta que os tokens em cache são 80% mais baratos no Fable (Fortune). A diferença aumenta em prompts longos. A página da OpenAI lista o Astra a US$ 20 de entrada e US$ 75 de saída quando o prompt passa de 272K tokens (OpenAI), enquanto o Fable mantém um único preço em toda a janela de 1M. A faixa rápida do Astra custa US$ 20 e US$ 100 (OpenAI), contra US$ 16 e US$ 80 do modo rápido do Fable. Mais um item de custo: fixar a inferência nos EUA com a configuração inference_geo adiciona um multiplicador de 1,1x em todas as categorias de token (documentação da Anthropic), então equipes com regras de residência de dados devem colocar isso na conta.
O Carbon é de longe o mais barato hoje: US$ 2 e US$ 10, o que o The Verge descreve como cerca de um quinto do Astra e um quarto do Fable 5.2. A própria página de preços do Google dá a essa tarifa uma data de término a poucas semanas de distância, depois da qual os preços de entrada, saída e cache dobram (Google). A US$ 4 e US$ 20, ele custaria exatamente o mesmo que o Claude Opus 5.5. Não montaríamos um orçamento em cima do preço de lançamento.
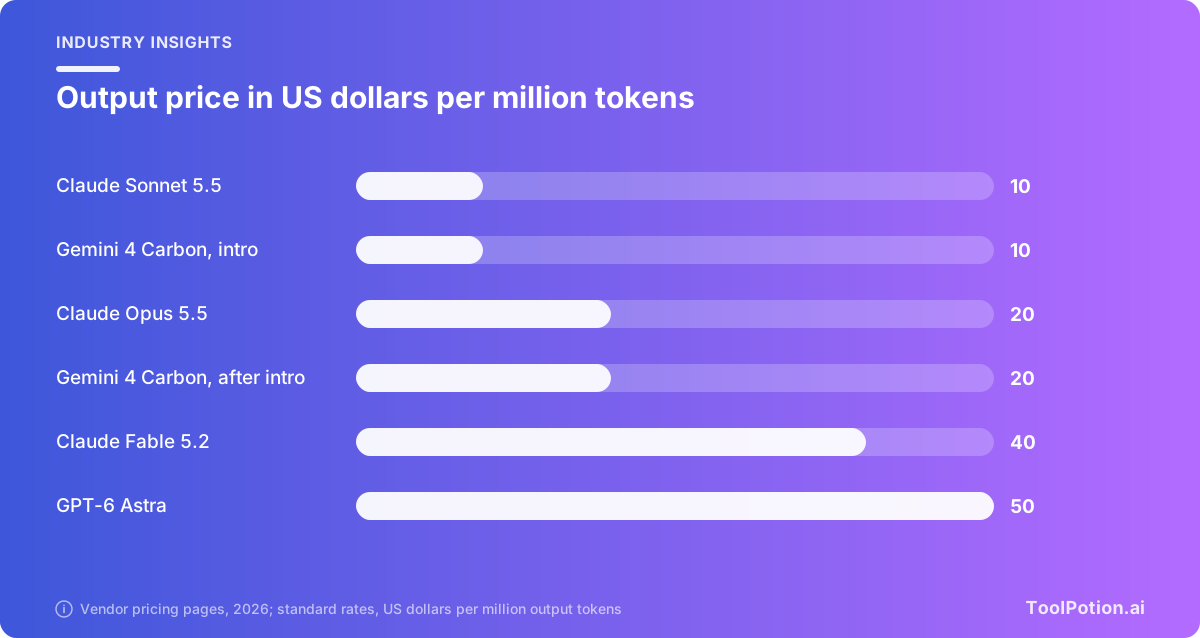
O Opus 5.5 é o outro número para guardar na cabeça. A US$ 4 e US$ 20, ele custa metade da tarifa por token do Fable, e a Anthropic diz que ele tem desempenho no nível do Fable 5.1 na maior parte do trabalho (Anthropic). A Fortune observa que o Opus 5.5 custa mais que o GPT-6.1 Sol da OpenAI, que está listado a US$ 2 e US$ 10 na página da OpenAI. Preço por token não é preço por tarefa, porque os modelos gastam quantidades diferentes de tokens, então use a calculadora para estimar o volume e depois calcule o custo da sua própria tarefa.
O Fable guarda seus prompts por 30 dias
A página de Covered Models da Anthropic é direta: prompts e respostas do Fable e do Mythos são retidos por pelo menos 30 dias por padrão e revisados por sistemas automatizados de segurança, e a retenção zero de dados não está disponível em workspaces, em organizações Claude Enterprise nem em plataformas de terceiros onde esses modelos rodam (central de ajuda da Anthropic). Uma página complementar diz que os dados são apagados após 30 dias, a menos que sejam sinalizados ou exigidos por lei, e que a revisão humana segue um caminho controlado. Para equipes que usam o Claude no Azure Foundry com ZDR, ela diz que a retenção é definida por assinatura do Azure, então seria preciso uma assinatura separada para usar esses modelos (central de ajuda da Anthropic). A política não é novidade do 5.2; vale para todos os modelos Fable e Mythos desde o Fable 5.
A saída é o Enterprise Frontier Safeguards, que monitora prompts armazenados na infraestrutura do próprio cliente. A Anthropic o descreve como em beta privado com clientes como Bridgewater, Salesforce e Stripe (Anthropic). O TechCrunch escreveu que o Fable 5.2 é "compatible with zero data retention (ZDR) policies through the Enterprise Frontier Safeguards system" ("compatível com políticas de retenção zero de dados (ZDR) por meio do sistema Enterprise Frontier Safeguards") (TechCrunch). Isso vale para os poucos inscritos e ainda não para todo mundo. Enquanto isso, a Anthropic diz que clientes elegíveis, contatados diretamente, podem usar ZDR com o Fable em aplicações internas de negócios por tempo limitado. O GitHub diz que empresas elegíveis podem usar o Fable com retenção zero de dados até o fim do ano civil, sob uma isenção com prazo definido, após o qual o Enterprise Frontier Safeguards será obrigatório, e que os dados retidos não são usados para treinar os modelos da Anthropic (GitHub).
O padrão é política, e este pesa mais que um corte de 20% no preço para um escritório de advocacia, uma clínica ou um banco. Antes de ligar o Fable 5.2 em qualquer equipe regulada, pediríamos ao jurídico que lesse essas três páginas. A Anthropic diz que as proteções serão liberadas em fases, mas não deu data para todos. Também não encontramos uma na cobertura do lançamento.
Nossas escolhas, por tarefa
A própria Anthropic não manda a maioria das pessoas começar por aqui. Nas palavras dela: "For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver" ("Para a maioria das tarefas de código e de conhecimento, recomendamos que os usuários comecem pelo Claude Opus 5.5, nosso melhor modelo para o dia a dia") (Anthropic). Concordamos e iríamos além: o Fable 5.2 é um modelo para o qual você escala, não um padrão.
Para programar, nossa escolha é o Opus 5.5 nas sessões do dia a dia e o Fable 5.2 no esforço High para execuções longas sem supervisão, como uma migração ou uma auditoria de várias horas. É aí que mora a alegação de custo da Anthropic, e é onde o engenheiro da Uber disse que o escolheria. No Copilot, você precisa do Pro+ e de um admin que tenha ativado a política. Pule o Fable para edições rápidas e autocompletar. Nosso ranking de assistentes de código com IA mostra as ferramentas em volta dos modelos, e o Claude Code é onde o Fable 5.2 usa o esforço Medium por padrão.
Para escrever, não pagaríamos pelo Fable. Nenhum benchmark da tabela mede prosa, e as linhas de trabalho de conhecimento (66,1% contra 61,2% do Opus 5.5 numa rubrica) são da própria Anthropic. O Opus 5.5 dá e sobra; o Sonnet 5.5, a US$ 2 e US$ 10, é mais barato ainda.
Para pesquisa, o Fable 5.2 no esforço Medium é o que testaríamos em conjuntos grandes e bagunçados de fontes. A Anthropic diz que ele iguala a melhor pontuação do Opus 5.5 no WANDR por cerca de 40% do custo por tarefa, e um pesquisador da Balyasny disse que ele apontou que o enquadramento de uma pergunta podia induzir a erro (Anthropic). Confira as citações mesmo assim, já que a única evidência dessa honestidade são depoimentos.
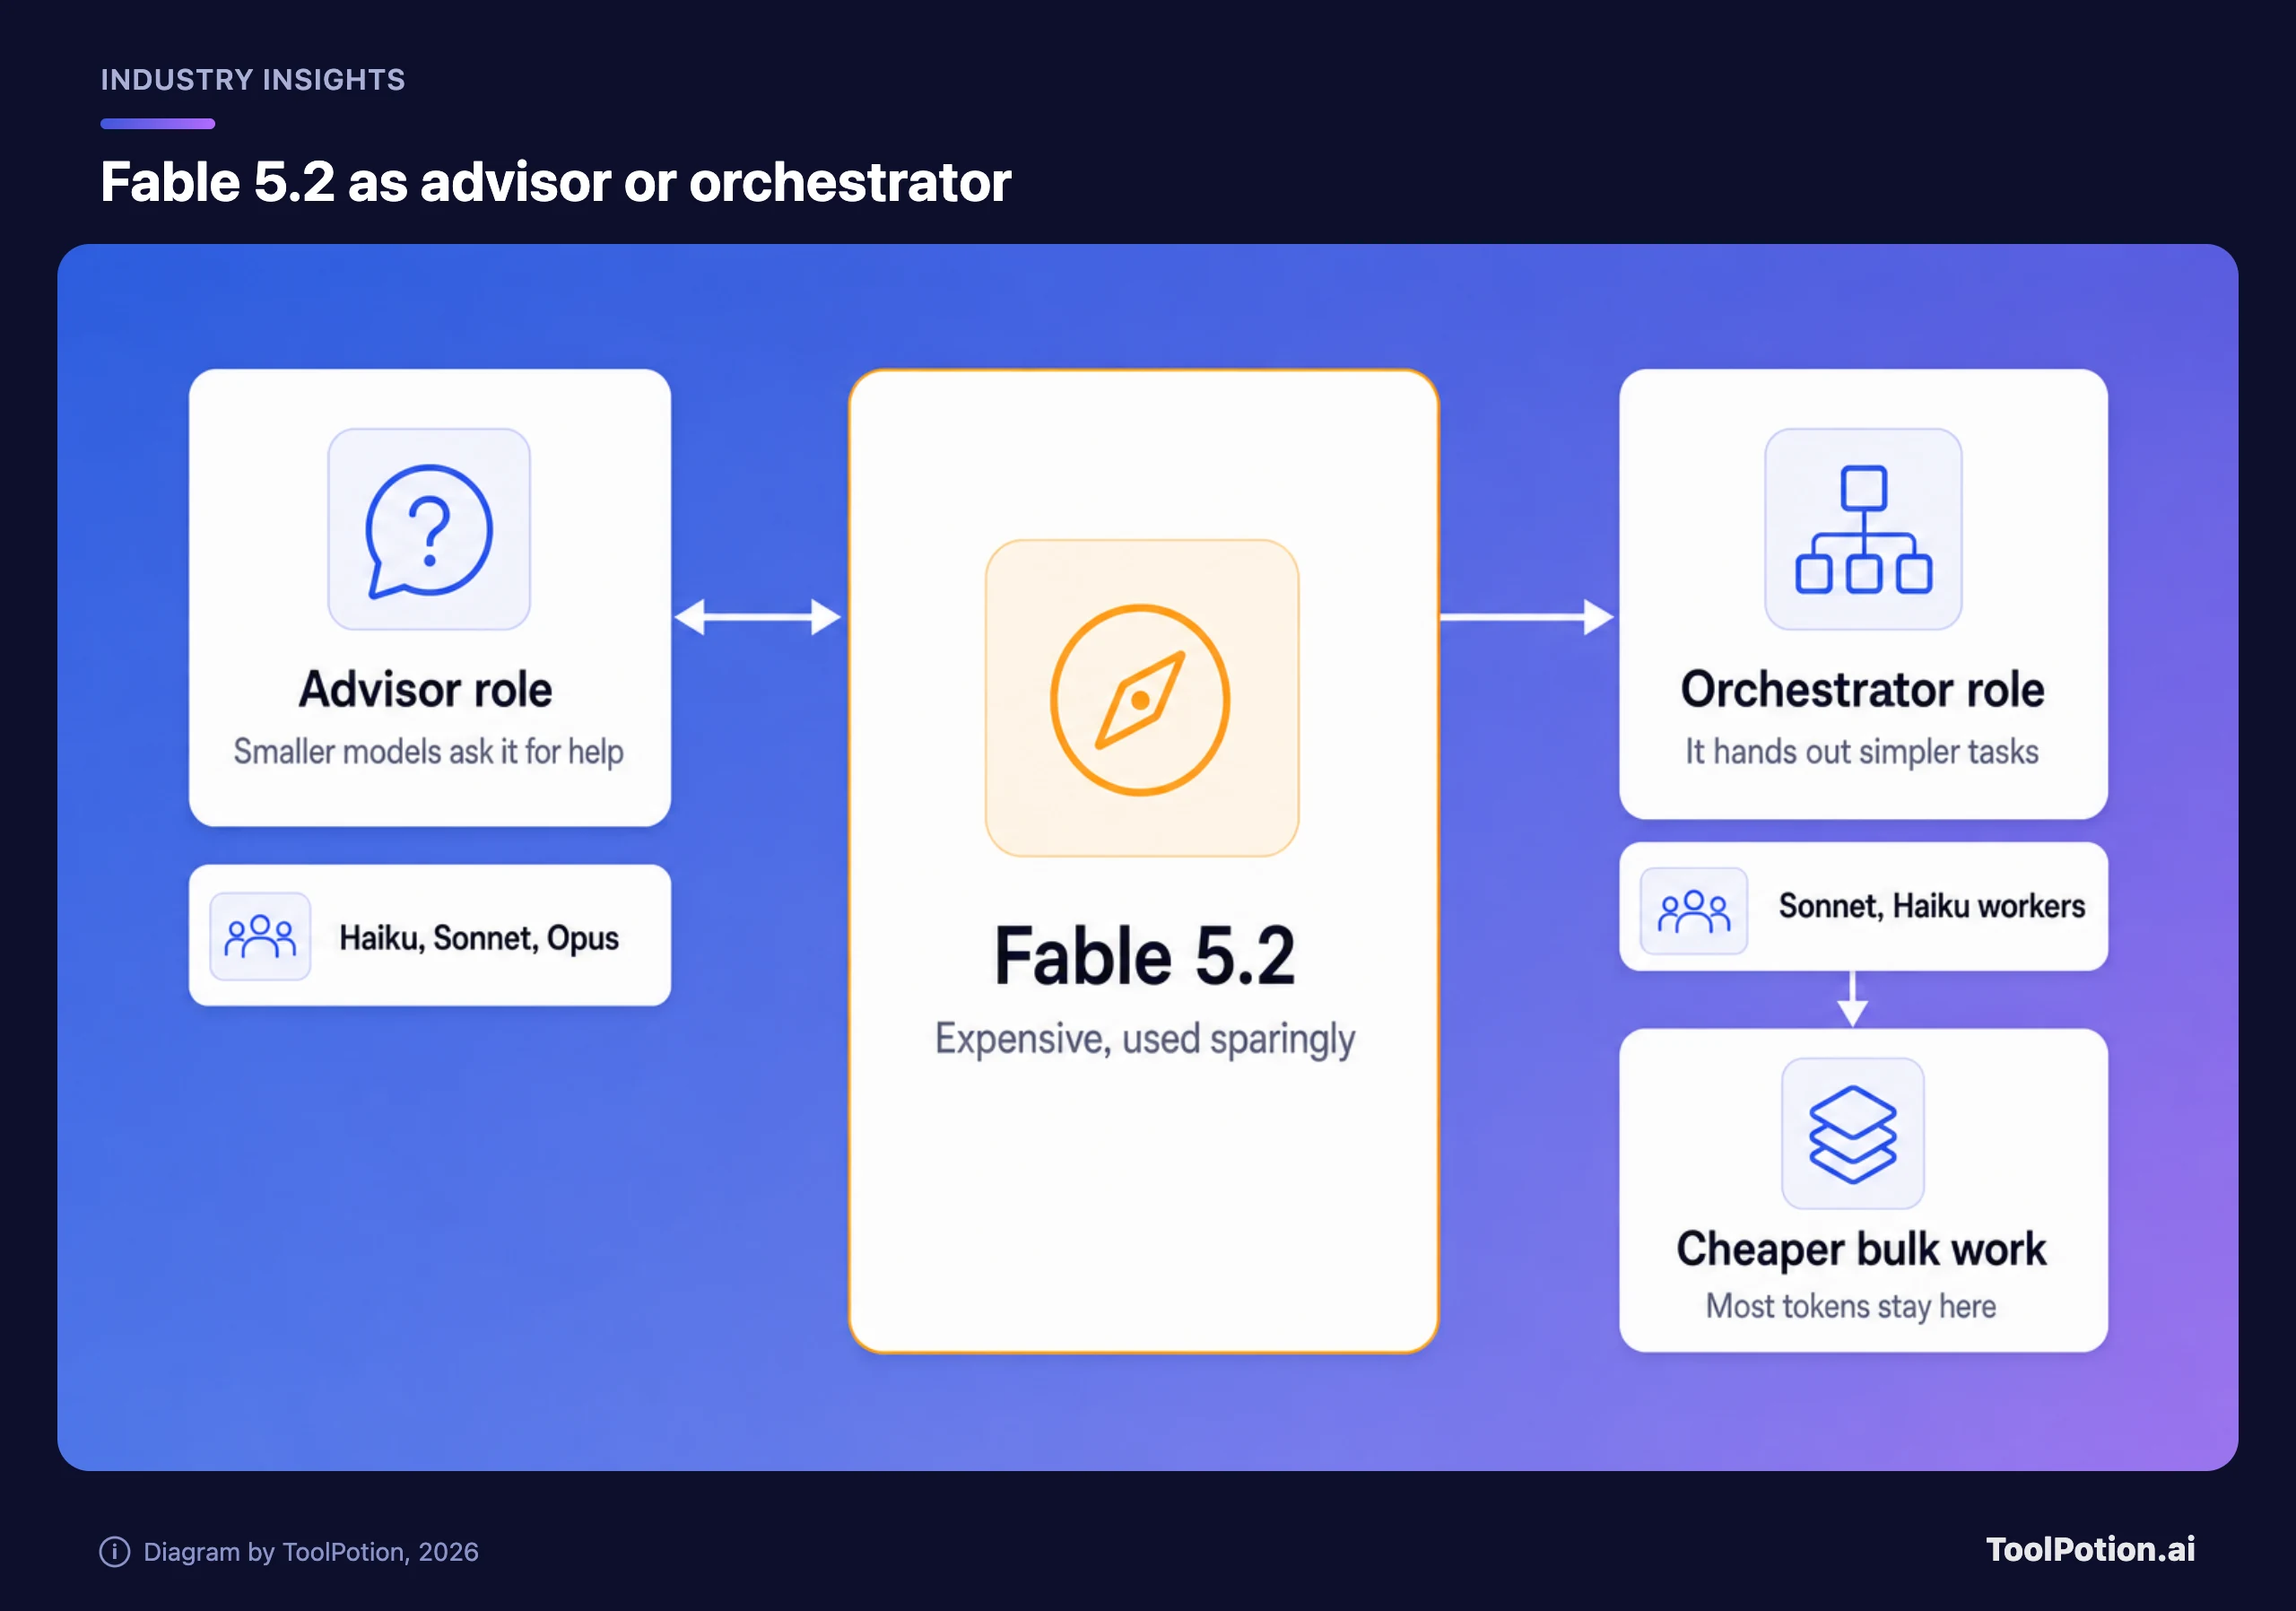
Para agentes, use o Fable como planejador e deixe os modelos menores fazerem o grosso do trabalho. A Anthropic descreve o Fable 5.2 como um Advisor, que Haiku, Sonnet ou Opus consultam para problemas difíceis, ou como um Orchestrator, que delega tarefas mais simples (Anthropic). Isso mantém a tarifa de saída de US$ 40 longe da maioria dos tokens. A evidência é fraca, porém: o Carbon vence a linha de fluxos empresariais, e o Google está lançando em preview um recurso de swarm no Google Antigravity (The Verge). Nosso ranking de agentes de IA lista o que é construído em cima deles.
Para um orçamento apertado, comece pelo Sonnet 5.5, ou pelo Haiku 5.5, a US$ 0,10 e US$ 0,50 (para prompts de até 100K tokens), em classificação e roteamento, e use a Batch API quando nada for urgente. Teste o Carbon na sua própria carga de trabalho enquanto ele ainda custa US$ 2 e US$ 10, mas calcule a US$ 4 e US$ 20 antes de se comprometer. O Fable não entra numa lista de orçamento enxuto.
Para pesquisa em segurança, candidate-se ao Mythos 5.2. O Fable vai recusar a maior parte do trabalho.
Antes de mudar qualquer coisa, um teste rápido sai barato:
- Escolha dez tarefas pelas quais você já paga um modelo.
- Rode todas no Fable 5.2 com esforço Medium e no Opus 5.5 com o esforço padrão.
- Compare o custo por tarefa concluída, incluindo os tokens que cada modelo gastou, e quantas vezes você precisou intervir.
Duas datas para acompanhar: o fim do preço introdutório do Carbon e se o Enterprise Frontier Safeguards sai do beta privado antes do fim do ano, quando a isenção de retenção do GitHub expira.