

A página de preços do Google lista o Gemini 4 Carbon a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Algumas linhas abaixo, a mesma página diz que os dois valores dobram quando o período introdutório acabar, o que acontece em poucas semanas (preços da API para desenvolvedores do Google AI). O post de lançamento do Google destaca o número mais baixo. Nós faríamos o orçamento com o mais alto.
O Carbon é o modelo de topo da linha Gemini 4 do Google. Ele chegou ao público cerca de duas semanas depois de uma fase limitada para equipes de segurança (Google) e veio com um recurso em preview chamado /swarm no Google Antigravity. Abaixo estão as perguntas que gostaríamos de ver respondidas antes de encostar em qualquer coisa disso: o que é um swarm, quem pode rodar um, quanto custa, onde ele tropeça e como se compara ao Claude Fable 5.2 e ao GPT-6 Astra. Tudo vem das páginas do Google, do changelog do GitHub, da Artificial Analysis e de reportagens. Nós mesmos não rodamos o Carbon.
Um swarm é um coordenador, workers e um verificador em um único quadro
A documentação do Antigravity, do Google, descreve de forma direta. Quando você digita /swarm e uma tarefa, sua conversa atual vira o coordenador. Ele divide o trabalho em partes que não colidem (um worker por arquivo ou pacote, por exemplo), entrega a cada worker um briefing público e um contexto limpo, e geralmente adiciona um verificador para cada dois a quatro workers. O verificador lê os diffs, roda os testes e reporta os problemas ao worker que escreveu o código (documentação do Antigravity).
Todos conversam em um quadro compartilhado. Os workers não trocam mensagens privadas. Um worker sem nada para fazer dorme e não consome tokens até alguém mencioná-lo, e um worker monitor só se manifesta se o time inteiro ficar em silêncio antes de o trabalho terminar. O post de lançamento do Google resume a proposta em uma frase: é "transformar um único prompt em uma equipe coordenada de agentes que você acompanha em tempo real".
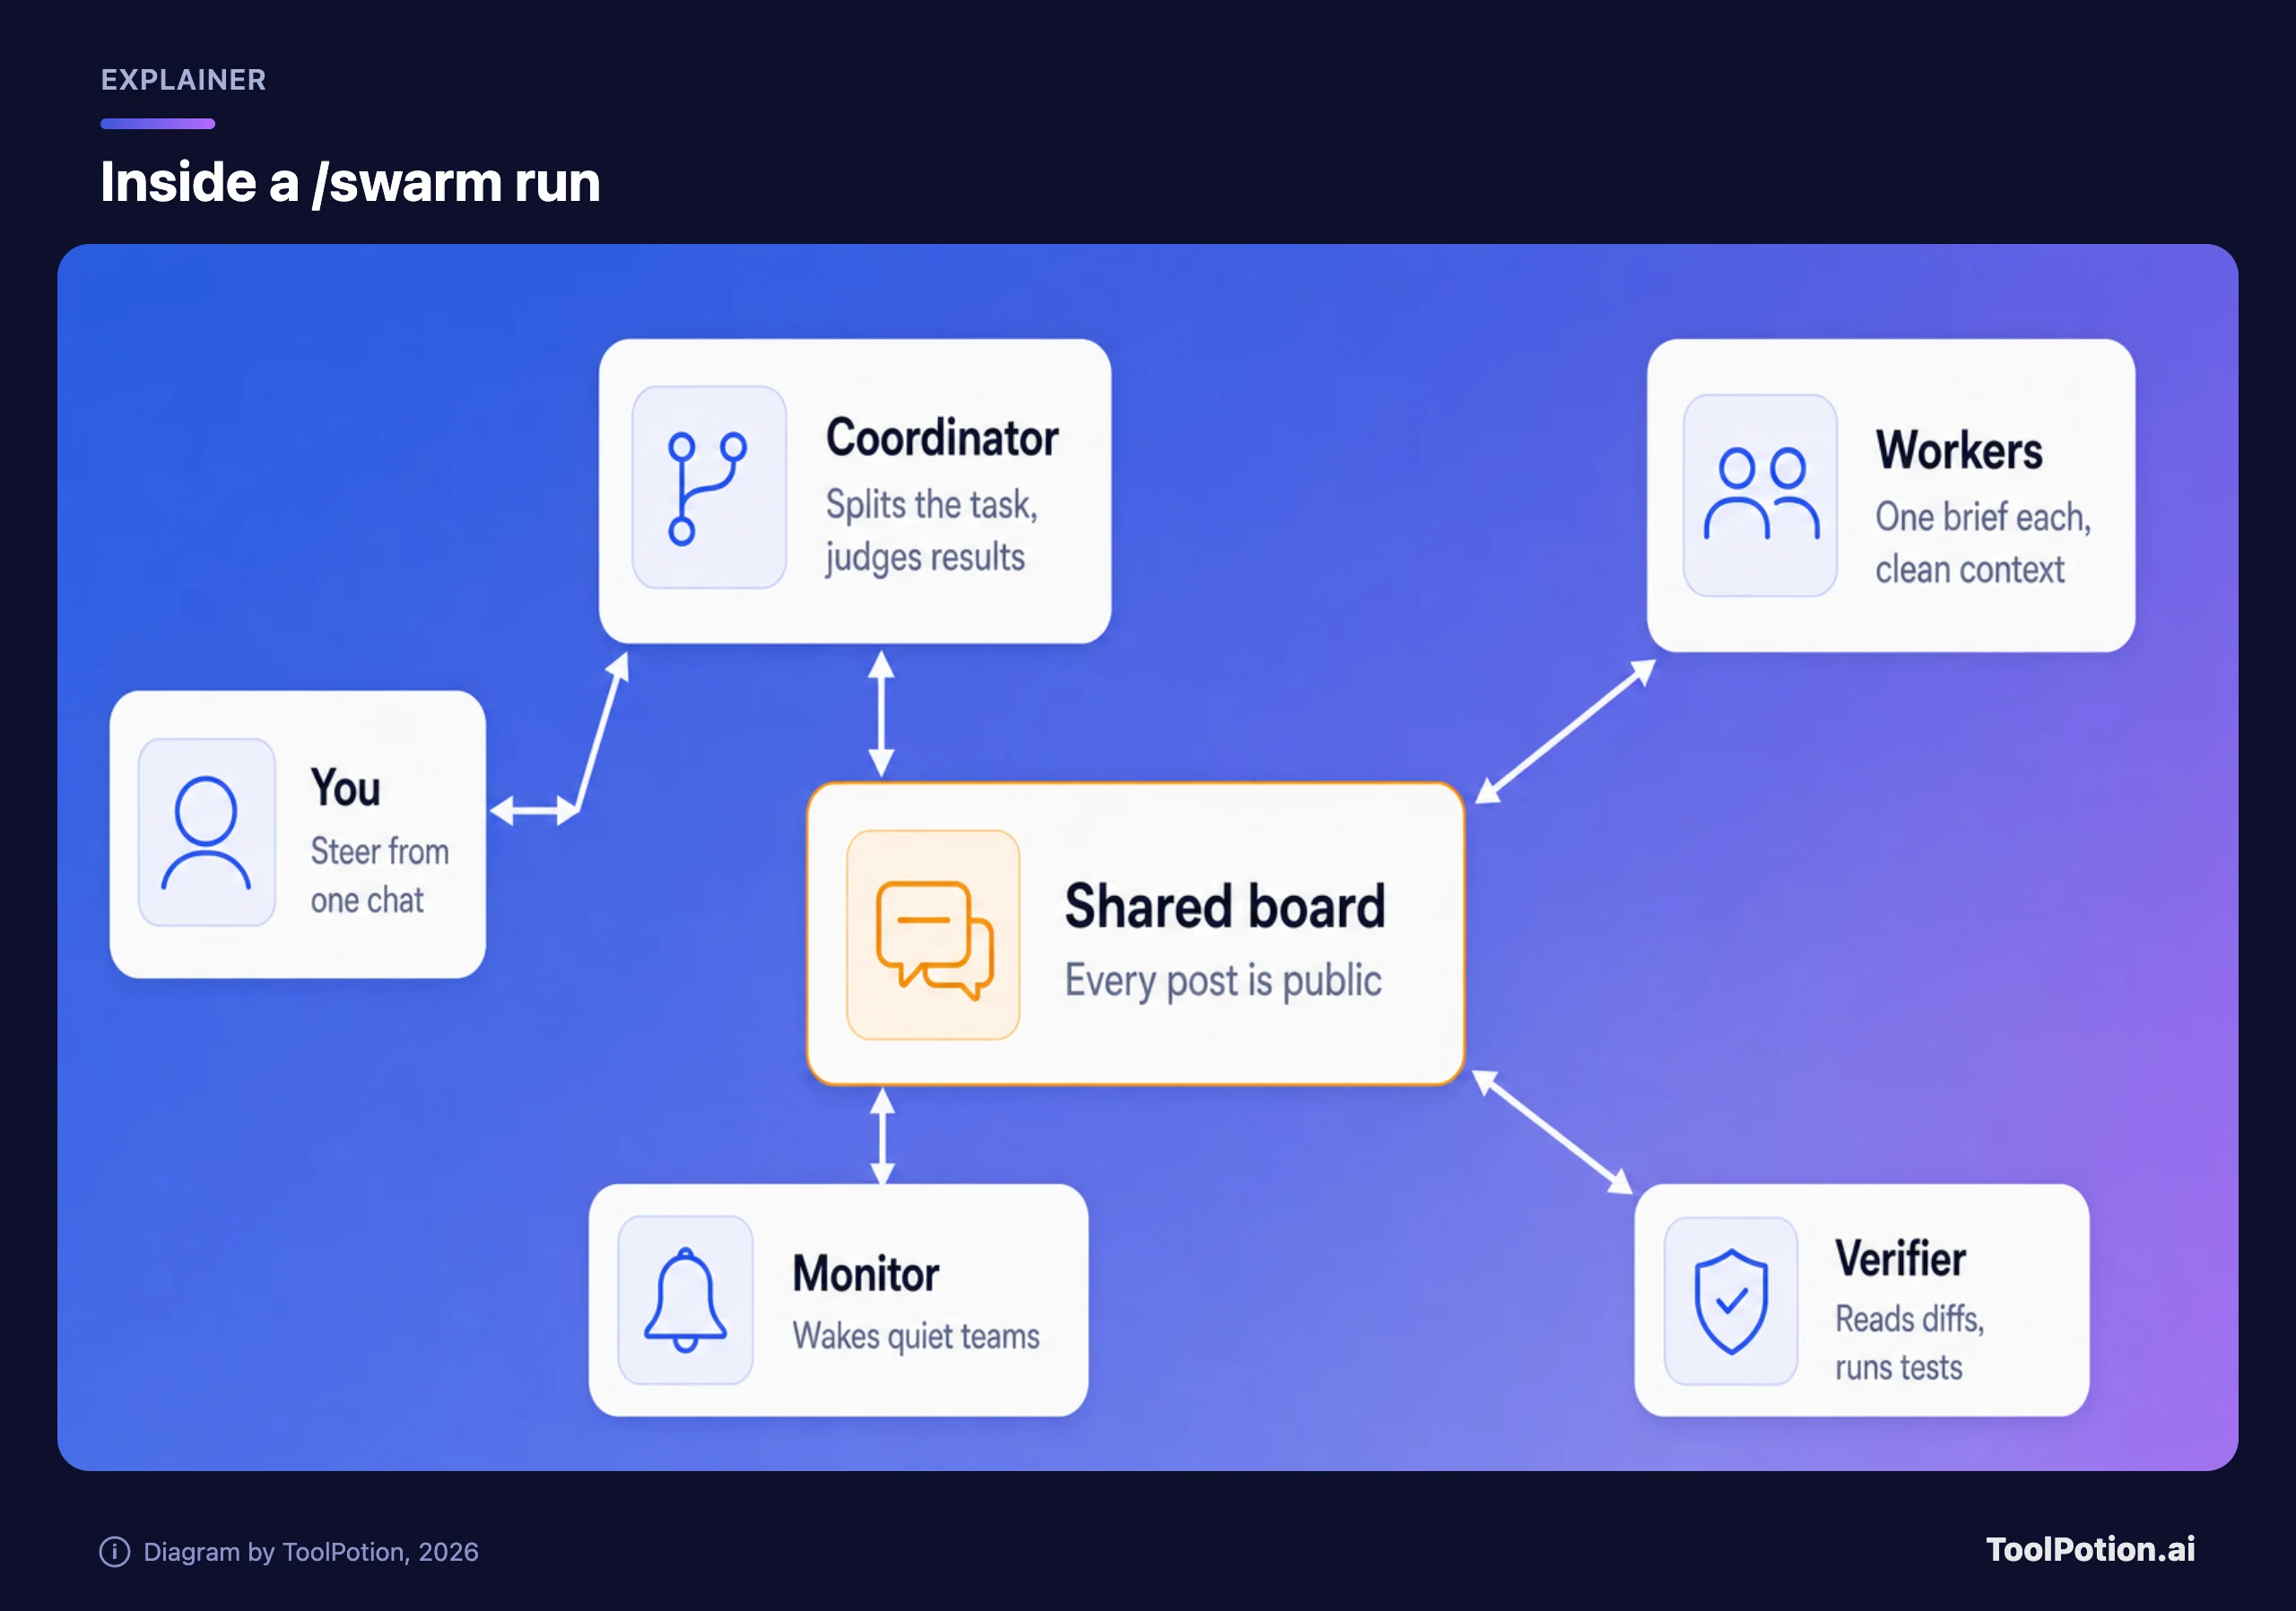
Os workers rodam no mesmo modelo da sua conversa, a menos que você peça outro, e a documentação traz um prompt de exemplo que coloca o verificador em um modelo diferente do dos workers. O post de lançamento do Google sugere o Carbon para as funções que exigem o raciocínio mais profundo (arquitetura, coordenação, auditoria), com modelos mais rápidos e leves cuidando do trabalho paralelo. Quando vários workers editam ao mesmo tempo, o coordenador pode dar a cada um sua própria cópia do seu repositório.
O Google também diferencia o swarm de seus irmãos. Subagentes cuidam de uma tarefa lateral. O /boost é para problemas difíceis, não grandes. O /teamwork toca projetos de vários marcos, com uma entrevista de escopo e portões de auditoria. O /swarm é para trabalho que é "grande, mas se divide de forma limpa". Essa última expressão é o teste que levaríamos para qualquer lugar. Cinco workers em uma tarefa que não se divide são cinco agentes esperando uns pelos outros, e você paga por todos eles.
O swarm está aberto ao Pro; o Carbon, quase só ao Ultra
O swarm está em preview, e o Google diz que ele funciona nos planos Google AI Pro e AI Ultra, tanto no Antigravity App quanto no Antigravity CLI. O Carbon é mais restrito. Segundo o post de lançamento do Google, a API está aberta a todos os desenvolvedores e empresas pagantes pelo Google AI Studio e pelo Gemini for business (o Gemini Enterprise app é a porta de entrada corporativa). No lado do consumidor, ele está sendo liberado aos assinantes do Google AI Ultra no Antigravity, no app do Gemini e no AI Mode da Busca.
A página de assinaturas do Google nos EUA lista o Argon, o irmão mais leve, no AI Pro a US$ 19,99 por mês, e o Carbon no Ultra, que começa em US$ 99,99 por mês com cinco vezes os limites de uso do Pro e chega a US$ 199,99 para vinte vezes (Google). Juntando as duas páginas, um assinante do Pro consegue iniciar um swarm, mas não com o Carbon, e a tabela de modelos do próprio Antigravity confirma: o Carbon aparece marcado para Ultra e Enterprise, não para Pro (documentação do Antigravity). Nem o post de lançamento nem a página de assinaturas diz quando, ou se, o Pro vai receber o modelo. Usuários gratuitos ficam sem nada: a página de preços marca o Carbon como "Not available" no nível gratuito da API, e a Business Insider diz que tanto o Carbon quanto o Argon são limitados a usuários pagantes.
O GitHub Copilot é a outra porta. O Carbon está em disponibilidade geral lá para Copilot Pro+, Max, Business e Enterprise, selecionável no seletor de modelos no VS Code, Visual Studio, IDEs JetBrains, Xcode, Eclipse, no Copilot CLI, no coding agent, no github.com e nos apps móveis, com liberação gradual (changelog do GitHub). O changelog não menciona o swarm, então trataríamos o GitHub Copilot e o Copilot CLI como formas de usar o modelo, não o recurso.
Um padrão merece atenção se você administra um time. Na habilitação padrão de modelos, diz o GitHub, os novos modelos são ativados automaticamente, a menos que um administrador tenha desligado o padrão global ou desabilite o modelo explicitamente. O Carbon é cobrado pelo preço de tabela do provedor, então um desenvolvedor que o escolhe no menu suspenso gasta o seu dinheiro na tarifa do modelo. O Fable 5.2 funciona ao contrário: a política dele continua desligada até que um administrador a habilite (changelog do GitHub). Confira a política do Carbon antes que a liberação chegue à sua organização.
O preço dobra em poucas semanas
Na API do Gemini, a tarifa padrão do Carbon é de US$ 2 de entrada e US$ 10 de saída por milhão de tokens enquanto durar o período introdutório, e depois US$ 4 e US$ 20. Tokens de raciocínio contam como saída. A entrada em cache custa US$ 0,10 agora e US$ 0,20 depois, e só funciona o cache implícito (o cache explícito não é suportado). Batch e Flex custam metade da tarifa padrão, e o Priority custa US$ 3,60 e US$ 18 agora. O grounding com o Google Search dá 5.000 requisições gratuitas por mês (compartilhadas entre o Gemini 3 e modelos mais novos), depois US$ 14 por 1.000. O Argon tem os mesmos preços por token, então a economia dele está nos tokens, não nas tarifas (página de preços).
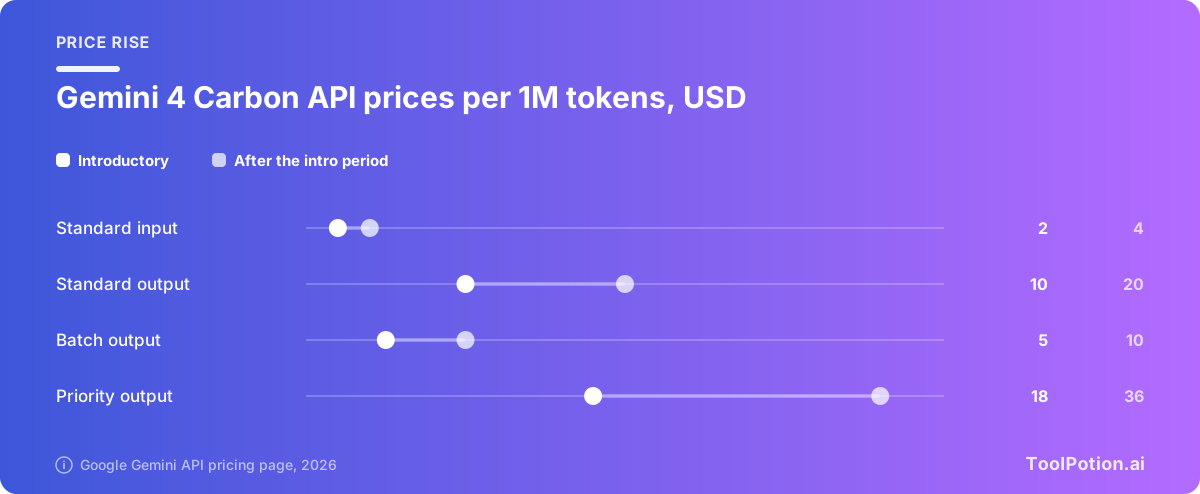
Mesmo dobrado, o Carbon continua mais barato por token do que os dois concorrentes abaixo. Por token, porém, não é por tarefa, porque cada modelo gasta uma quantidade diferente de tokens no mesmo trabalho, e os números medidos na próxima seção vão contra a manchete.
Um swarm é mais difícil de precificar. Em uma assinatura, você paga em cota, e a documentação é direta: "Every worker is its own agent, so a swarm uses quota much faster than a single conversation." (Cada worker é um agente próprio, então um swarm consome cota muito mais rápido do que uma conversa única.) Um worker que fica sem cota pausa e continua pausado até alguém postar no quadro, o modelo dele ser trocado ou você mandar uma mensagem. Ele não recomeça quando sua cota é renovada (documentação do Antigravity). O Google não diz quantos tokens uma execução típica de swarm queima. Uma cota que se recompõe em intervalos fixos, sem nenhum número por execução, é exatamente o tipo de custo de que não gostamos. Até o Google publicar um número, trataríamos o swarm como um multiplicador sobre o que um único agente já custa para você.
Dentro do Copilot, o quadro é mais simples. O modelo é cobrado pelo preço de tabela no faturamento por uso, e a tabela de preços do GitHub traz os mesmos US$ 2 e US$ 10, com a mesma duplicação no fim do período introdutório (GitHub Docs).
Onde o Carbon fica devendo?
O Google é transparente sobre o principal ponto. O Carbon gasta mais tokens de raciocínio do que o Argon para explorar e verificar, o que "aumenta o uso de tokens por turno e a latência" (documentação do Google AI). As notas de migração dizem que prompts difíceis "podem levar vários minutos" e orientam os desenvolvedores a definir timeouts de cliente de pelo menos 15 minutos, aumentar o máximo de tokens de saída para 32.768 ou mais, porque o Carbon pode gastar mais do limite com raciocínio, e parar de enviar temperature, top_p e top_k, que são ignorados.
A Artificial Analysis, uma empresa independente de benchmarks, mediu a mesma característica. A página dela chama o modelo de "notably slow per task and very verbose" (notavelmente lento por tarefa e muito verboso). O Carbon escreveu 205 milhões de tokens ao longo do Intelligence Index, contra uma mediana de 72,8 milhões para modelos comparáveis, e levou 25,3 minutos por tarefa, contra uma mediana de 12,7 minutos (Artificial Analysis).
A página do modelo lista apenas saída em texto. Sem geração de imagem, sem geração de áudio, sem Live API (página do modelo). A prompt injection é a outra ponta solta. O Google reporta 0% de taxa de sucesso de ataque no benchmark de injeção indireta da Gray Swan e depois acrescenta que sabe que "prompt injection robustness remains an area for continued improvement" (a robustez contra prompt injection continua sendo uma área de melhoria contínua) (Google). Achamos que essa frase merece mais peso do que o 0%, porque agentes que leem páginas web e PDFs são o caso de uso que o Google está vendendo, e um swarm lê mais deles ao mesmo tempo.
Depois, há a questão das evidências. A maior parte dos elogios no post de lançamento vem de empresas que o Google escolheu citar. Um cliente cita "16 correções reais de bugs" na sua base de código como base para uma taxa de resolução de 94%, uma amostra tão pequena que mais um erro mudaria o número em seis pontos. Kit Langton, do OpenCode, chama o Carbon de "a preferred planning model for our hardest tasks" (um modelo de planejamento preferido para as nossas tarefas mais difíceis), o que é um aval útil de alguém que constrói ferramentas de código, mas é uma voz só em um post escrito pelo fornecedor. As demos também não nos convencem: a reconstrução de escritório com 906.000 triângulos e a exposição da Torre Eiffel são execuções do próprio Google. Esperaríamos resultados de gente que não está no comunicado de imprensa.
Mais barato por token que o Fable 5.2 e o Astra, nem sempre por tarefa
No preço de tabela, o Carbon vence com folga. Na tarifa introdutória, o Carbon custa um quinto do GPT-6 Astra por token e um quarto do Claude Fable 5.2, que chegou ao GitHub Copilot um dia antes do Carbon (changelog do GitHub). Depois da duplicação, passa a ser dois quintos e metade. As páginas dos próprios fornecedores (OpenAI, Anthropic) trazem os números da tabela abaixo.
| Modelo | Entrada / saída por 1M de tokens | Onde usar | Custo medido por tarefa |
|---|---|---|---|
| Gemini 4 Carbon | US$ 2 / US$ 10 agora, US$ 4 / US$ 20 depois | API paga do Gemini, Google AI Ultra, Antigravity (Ultra), Copilot Pro+, Max, Business, Enterprise | $7.76 |
| GPT-6 Astra | US$ 10 / US$ 50 (entradas de até 272K) | API da OpenAI, GitHub Copilot | $6.24 |
| Claude Fable 5.2 | $8 / $40 | API da Claude, Copilot Pro+, Max, Business, Enterprise | $26.54 |
A última coluna é o custo médio da Artificial Analysis para rodar o Intelligence Index, e para o Carbon ela usa a tarifa dobrada. Por tarefa, o Carbon (US$ 7,76) custa mais que o Astra (US$ 6,24) apesar do preço menor por token, porque escreve muito mais tokens. O Fable 5.2 é bem mais caro, com US$ 26,54, e o mais lento dos três, com 48 minutos por tarefa, mas também lidera o gráfico comparativo da página, com nota 65 contra 60 do Carbon e 57 do Astra (Artificial Analysis). Uma ressalva: o índice lista o Carbon em raciocínio high e os outros dois em max. No preço introdutório, o valor do Carbon cairia mais ou menos pela metade, para cerca de US$ 3,90 pela nossa conta, o que o colocaria abaixo do Astra enquanto o desconto durar.
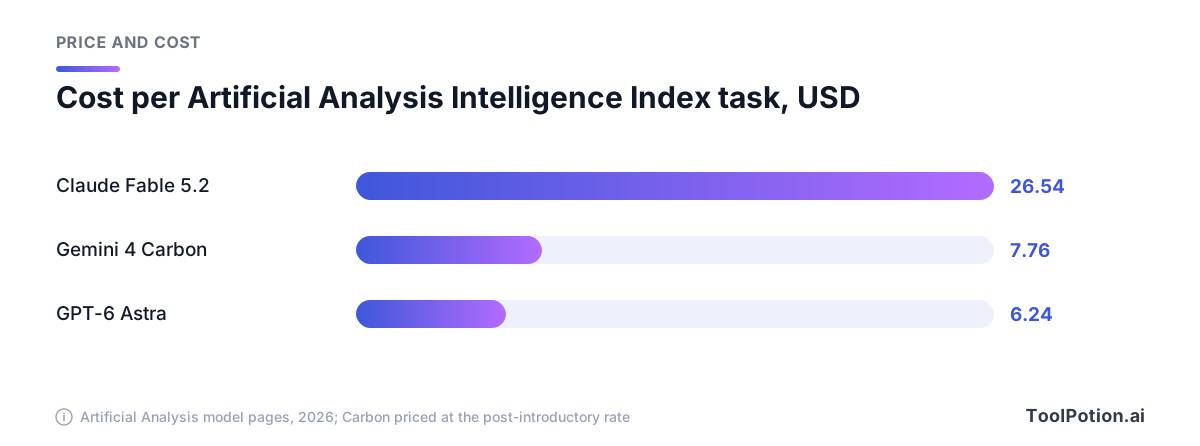
A afirmação do próprio Google é diferente. Ele diz que o Carbon fica em primeiro no CursorBench 4.0 do Cursor, no WANDR da Perplexity e no AutomationBench da Zapier, custando menos da metade por tarefa em relação ao melhor modelo externo seguinte (Google). São tarefas diferentes das da Artificial Analysis, e o Google escolheu quais citar. As duas coisas podem ser verdade. Duvidamos que essa economia se repita no seu repositório sem um teste.
Os termos de dados também diferem. O changelog do GitHub diz que o Claude Fable 5.2 "requires data retention by default" (exige retenção de dados por padrão) para rodar os classificadores de segurança da Anthropic, com retenção zero de dados disponível apenas para certos clientes enterprise elegíveis (changelog do GitHub). A página de preços do Google diz que o conteúdo enviado no nível pago da API do Gemini não é usado para melhorar seus produtos. Padrões são política, e nesse ponto o do Google é mais amigável.
A calculadora abaixo usa preços de tabela. Preencha a contagem de tokens com as suas próprias execuções, não as nossas, já que os três modelos gastam quantidades muito diferentes no mesmo trabalho.
Quando recorreríamos a ele?
Nossa escolha para o dia a dia é o Argon. O próprio Google diz isso: o Argon "remains the ideal choice for the majority of software engineering and knowledge work" (continua sendo a escolha ideal para a maioria do trabalho de engenharia de software e de conhecimento), enquanto o Carbon é "built for tasks that test the limits of a model's intelligence" (feito para tarefas que testam os limites da inteligência de um modelo) (Google). O Carbon compensa seus tokens em migrações de vários pacotes, caças à causa raiz entre subsistemas e auditorias de segurança, os trabalhos que a documentação cita. Um swarm só compensa a cota quando a tarefa se divide em partes que não se tocam.
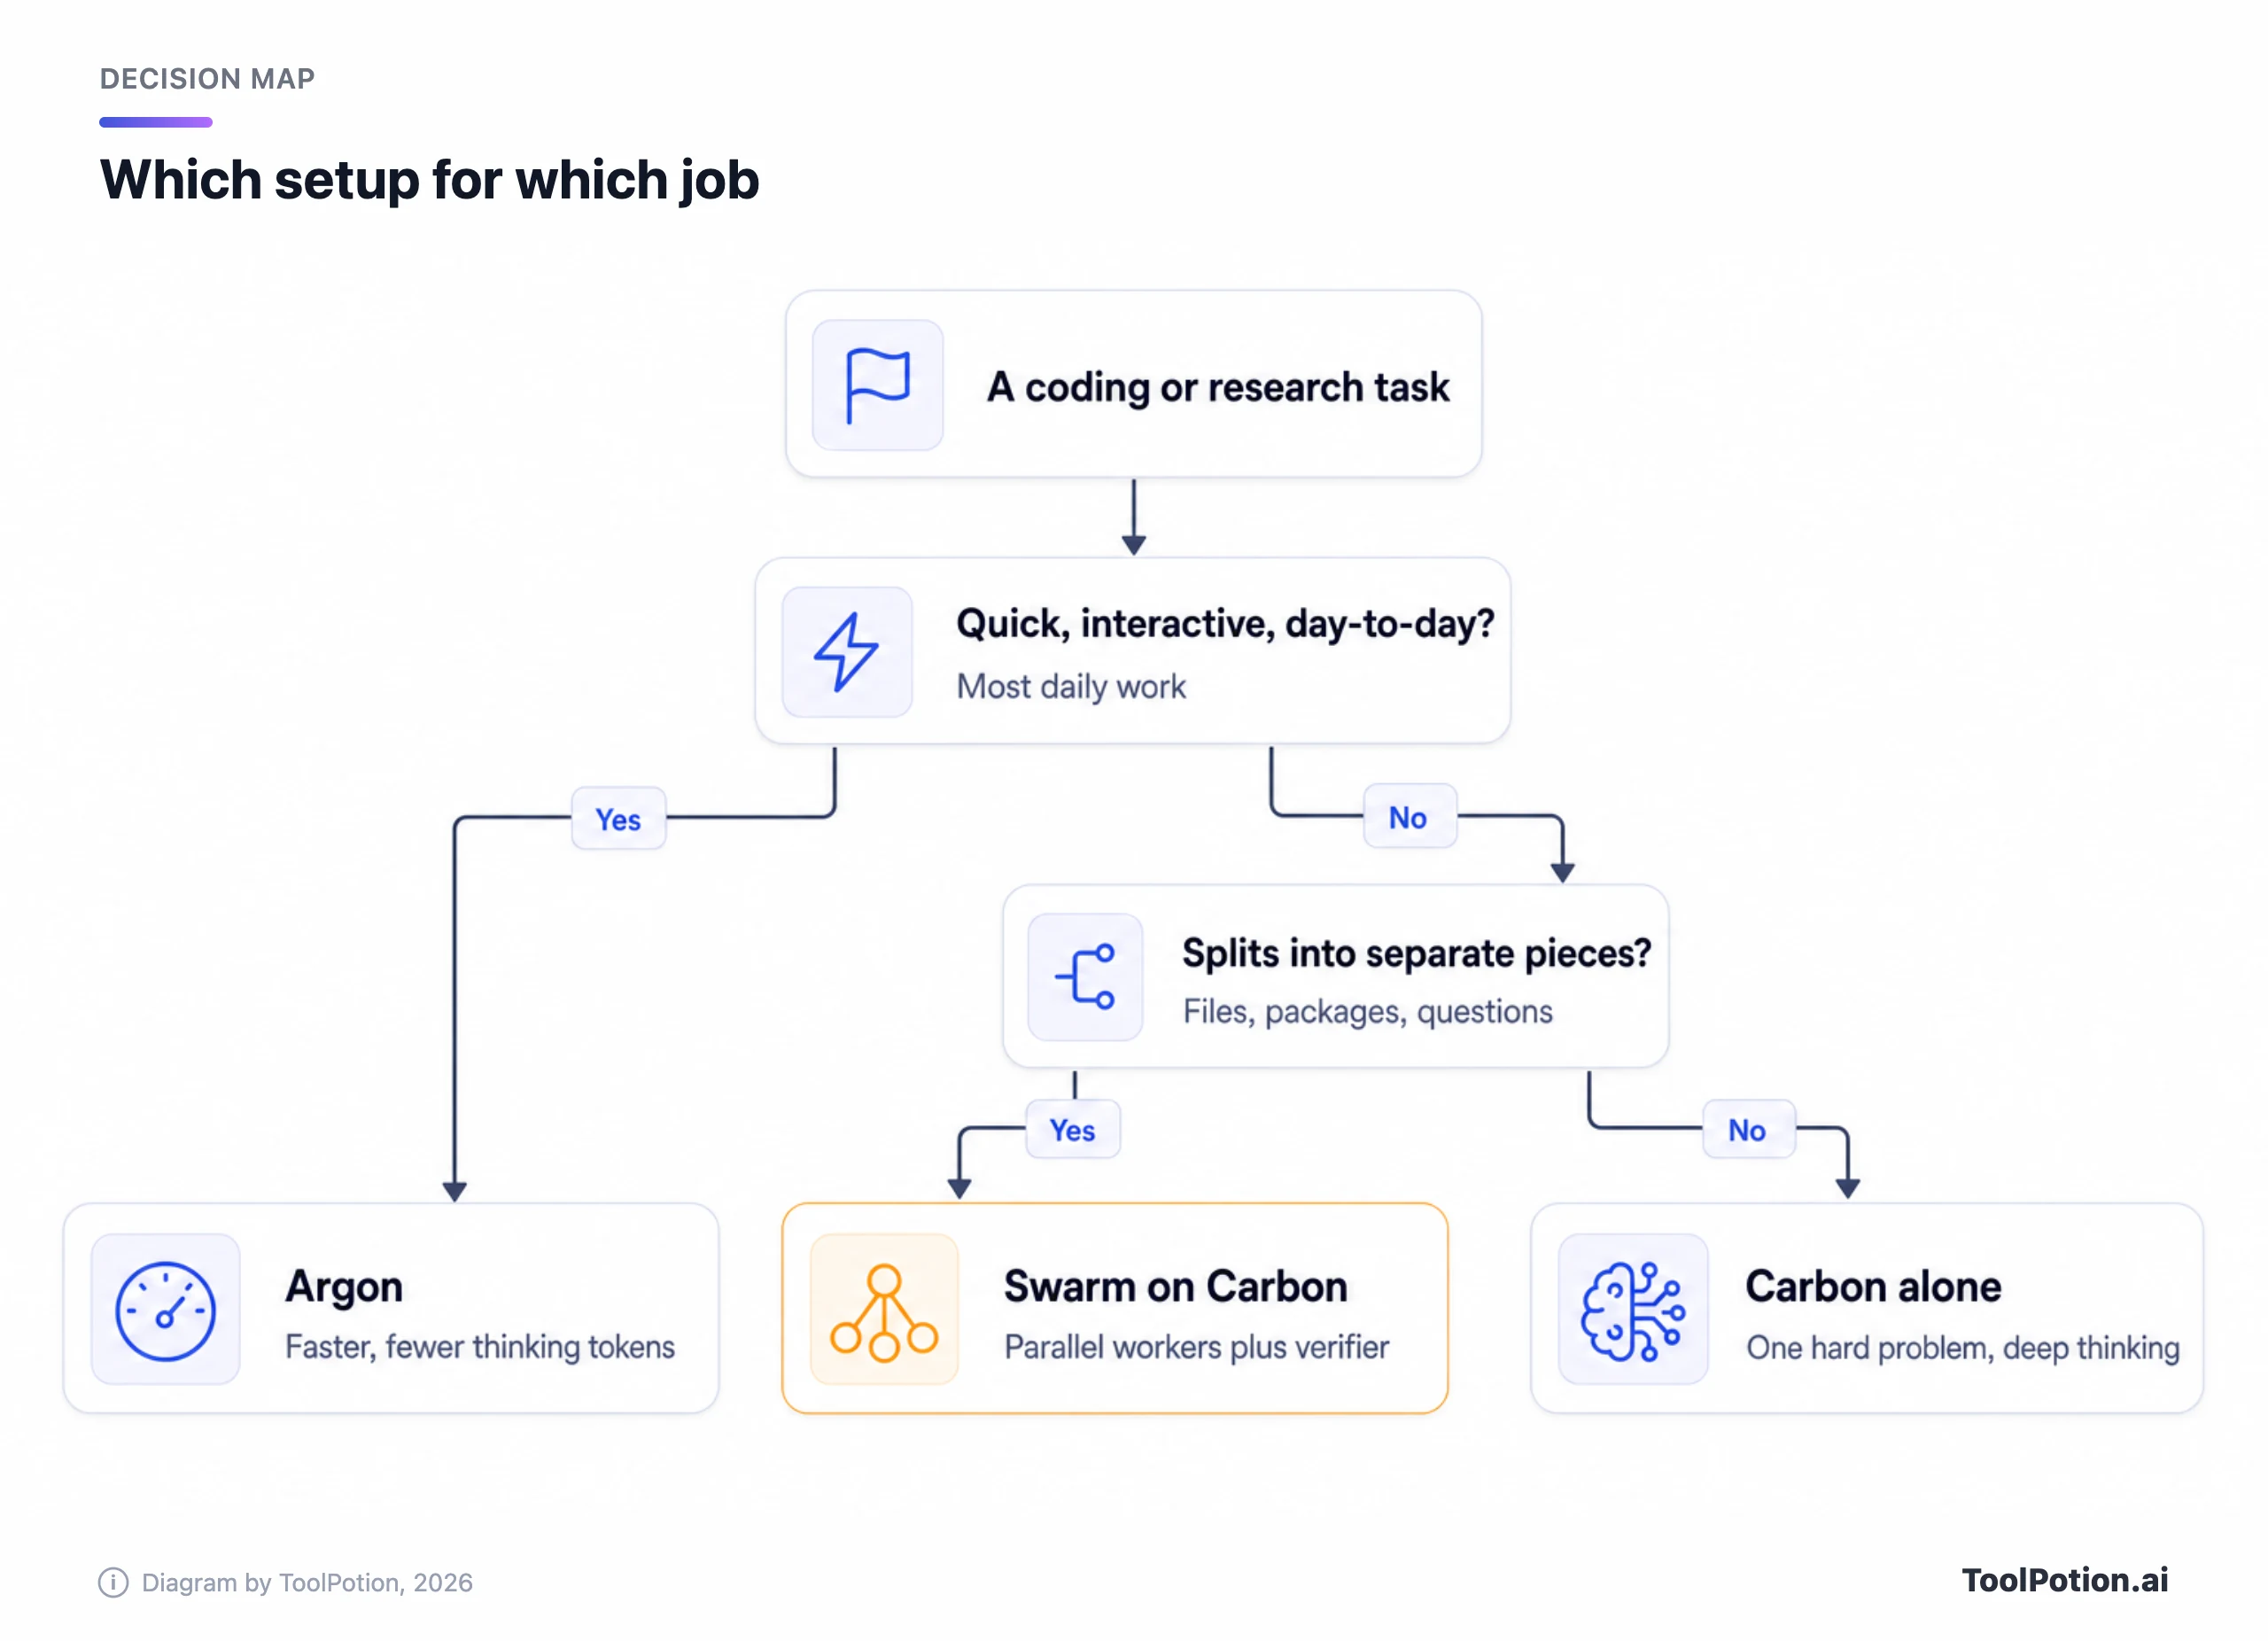
- Rode o trabalho primeiro no Argon. A maioria não vai precisar de mais.
- Se o Argon não der conta, teste o Carbon no nível de raciocínio medium padrão e depois no high. O conselho do próprio Google é testar os três níveis e escolher o mais baixo que atenda ao seu critério (documentação do Google AI).
- Inicie o /swarm só para trabalho que se divide por arquivo, pacote ou pergunta, e peça o verificador em um modelo diferente do dos workers.
- Faça o orçamento com US$ 4 e US$ 20, não com US$ 2 e US$ 10.
Em termos de dinheiro, pularíamos o Ultra se o Carbon for o único motivo para comprá-lo. Começando em US$ 99,99 por mês, é muito para pagar por um único modelo quando a API o vende por token em saldo pré-pago. Teste por lá com um orçamento pequeno e reavalie se você se pegar rodando agentes o dia todo. Se o seu time vive no editor, o seletor do Copilot é o teste de menor atrito; nosso artigo sobre o Copilot Fusion explica o que o roteamento de modelos significa para o custo, e nossa comparação entre Cursor, Copilot e Windsurf cobre os editores em si. Quem está escolhendo ferramentas de agentes pode ver todos os rankings do ToolRank para agentes de IA ou o hub de agentes de IA.
Hydrogen é um boato, não um produto
O Google pode ter algo mais leve a caminho, mas até agora é só um relato e nada mais. A Business Insider diz que o Google está deixando funcionários testarem um modelo rápido chamado Hydrogen, citando uma mensagem interna em que um engenheiro o chamou de "very capable, fast and efficient" (muito capaz, rápido e eficiente). Um funcionário disse à publicação que ele lembra os modelos Flash do Google, os burros de carga mais baratos. A BI diz que não está claro se um lançamento público seria gratuito ou pago, e o Google se recusou a comentar (Business Insider). Não há nome, preço ou data anunciados. Se os workers mais leves de um swarm são para onde iria a sua conta, o Hydrogen é o modelo a observar. Não planejaríamos nada em cima dele.
Perguntas frequentes
O Gemini 4 Carbon é gratuito para testar?
Não. A página de preços do Google o marca como indisponível no nível gratuito da API, e no app do Gemini ele exige o Google AI Ultra. A forma mais barata de entrar é com saldo pago na API.
O Google treina com os meus dados da API?
A página de preços do Google diz que o conteúdo no nível pago não é usado para melhorar seus produtos. O nível gratuito é outra história para outros modelos, mas o Carbon não é oferecido nele.
O Carbon gera imagens ou fala?
Não. Ele aceita texto, imagem, vídeo, áudio e PDF como entrada e devolve apenas texto, com geração de imagem, geração de áudio e Live API marcados como não suportados na página do modelo.
Qual é o tamanho da janela de contexto?
Uma janela compartilhada de 1.048.576 tokens para entrada, raciocínio e saída. Uma resposta normal tem limite padrão de 65.536 tokens, e a execução em segundo plano com decodificação longa permite que uma única resposta chegue até a janela menos a sua entrada.
O /swarm funciona no app do Gemini?
A documentação do Google lista apenas o Antigravity App e o Antigravity CLI.
O que devemos fazer antes de o preço introdutório acabar?
Rode de novo uma das suas próprias tarefas no Carbon nos três níveis de raciocínio e depois calcule o preço das contagens de tokens a US$ 4 e US$ 20. Esse segundo número é aquele com o qual você vai conviver.