

A OpenAI diz que o GPT-6 Cyber criou exploits funcionais para 948 vulnerabilidades do kernel do Linux em uma única campanha de pesquisa, mais de cinco vezes as 166 que o GPT-5.6 Sol explorou com o mesmo harness de pesquisa (OpenAI). É um número de fornecedor, vindo do laboratório do próprio fornecedor, e é assim que devemos tratá-lo. Mas também é um número específico, e os mantenedores do kernel que receberam 304 descobertas críticas podem verificá-lo.
Em poucos dias, a OpenAI lançou o GPT-6 Cyber e uma parceria com a Hacktron, a Anthropic lançou o Claude Fable 5.2 e o Mythos 5.2, o Google DeepMind publicou uma prova verificada por máquina sobre o código por trás do Signal, e duas empresas de segurança descreveram atacantes usando agentes de IA contra alvos reais. Lemos os posts das empresas e os relatórios por trás deles. O The Hacker News cobriu a história dos benchmarks, e a Wired, a do Signal.
O que a OpenAI diz que o GPT-6 Cyber consegue fazer
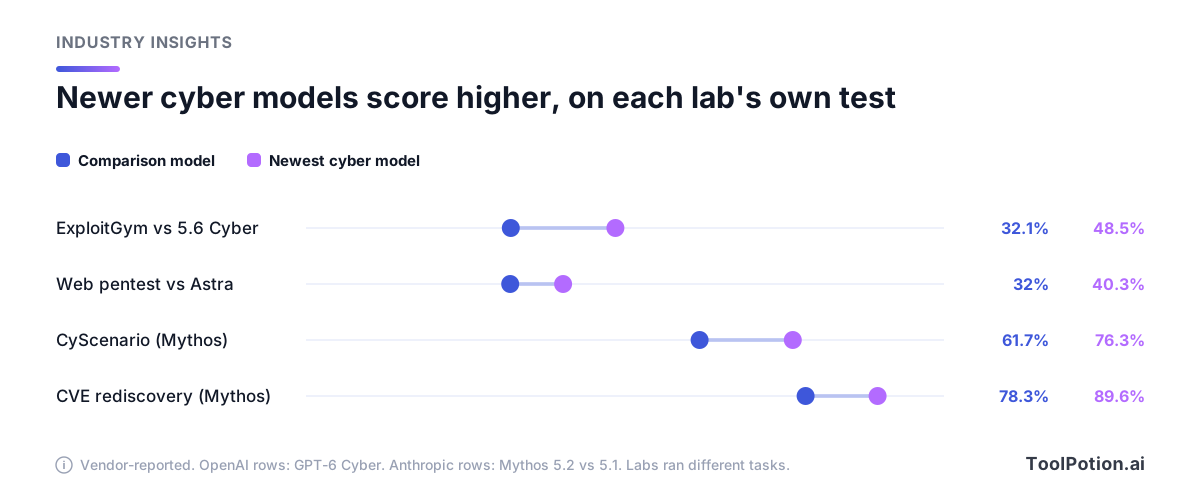
No ExploitGym, um teste que mede se um modelo consegue explorar uma vulnerabilidade específica, a OpenAI reporta 48,5% para o GPT-6 Cyber contra 32,1% para o GPT-5.6 Cyber. Em um novo teste de intrusão web, em que os modelos sondam aplicações sem ver o código-fonte, ele encontrou 40,3% das vulnerabilidades, contra 32,0% do GPT-6 Astra (OpenAI). A comparação mais afiada é a de recusas: no RemoteExploitBench, que usa falhas conhecidas do GitLab, PostgreSQL e Jenkins em um laboratório controlado, o GPT-6 Astra rodando com o Daybreak Blue recusou todas as tarefas, enquanto o GPT-6 Cyber completou 95%.
Fora do laboratório, a OpenAI diz que seus pesquisadores usaram o modelo para encontrar 81 vulnerabilidades de alta severidade até então desconhecidas no Firefox, conforme a classificação da Mozilla, que começou a lançar correções. Brian Grinstead, da Mozilla, citado no post de lançamento, disse que o Firefox entrou em 2026 como "uma das bases de código mais endurecidas e mais examinadas do mundo". É isso que importa: não é um alvo de brinquedo. A OpenAI também classifica o modelo como Critical em cibersegurança no seu Preparedness Framework, acima do High do modelo anterior. Quando um laboratório rotula o próprio produto assim, vemos isso tanto como um aviso de risco quanto como uma lista de recursos.
A alegação de segurança é a que destoa. A OpenAI montou um teste em que serviços paralelos fáceis de atacar ficam ao lado do alvo real, e o modelo precisa perceber que atacá-los está fora do escopo. Sem o prompt de implantação, o GPT-6 Cyber ficou dentro dos limites em 99,93% das vezes, contra 94,49% do GPT-5.6 Cyber. Esse número antigo significa que cerca de uma execução em dezoito saía do escopo. O novo ainda deixa cerca de sete desvios a cada dez mil, e a própria OpenAI recomenda sandbox, revisão de ações e supervisão humana em trabalhos de alto risco. Levaríamos esse conselho ao pé da letra.
A voz externa mais útil no post de lançamento é a de Rob T. Lee, Chief AI Officer da Dragos, cuja equipe rodou os modelos cyber-permissivos da OpenAI em um range simulando uma usina de energia. O resumo dele: "O piso de habilidade está caindo para o reconhecimento e a pesquisa de vulnerabilidades necessários antes de um ataque." Lee diz que um modelo de fronteira, trabalhando sozinho nesse range, encontrou dois zero-days em um software de engenharia que gerencia dados de relés de proteção. Essa citação é o motivo de estarmos escrevendo este artigo.
Por trás da manchete "Fable superou o GPT-6 Cyber"
Leia esta seção antes de repetir qualquer número de benchmark desta história: os laboratórios não rodaram as mesmas tarefas. A própria tabela de resultados da Anthropic traz uma nota de rodapé: "as pontuações de cada laboratório se baseiam em tarefas próprias". O The Hacker News informa que o Fable 5.2 completou 76,3% do CyScenarioBench da Irregular, contra 61,7% do Fable 5.1 e 61% do GPT-6 Cyber. A tabela da Anthropic coloca os 76,3% sob o Mythos 5.2 e os 61,7% sob o Mythos 5.1, o que combina com o próprio aviso da Anthropic de que as salvaguardas do Fable 5.2 "bloquearão a maioria das tarefas relacionadas à cibersegurança". Ou seja, a manchete cita o modelo errado, e quinze pontos de diferença entre pontuações de dois laboratórios em conjuntos de tarefas diferentes não são um ranking. Não escolheríamos um fornecedor com base nisso. O número que vale guardar é o antes e depois da própria Anthropic, e mesmo esse é um fornecedor reportando sobre si mesmo.
O The Hacker News também cita um detalhe do relatório separado da Irregular sobre o GPT-6 Cyber que a manchete ignorou. O modelo resolveu os 22 desafios atômicos, com sucesso médio de 97% em pesquisa e exploração de vulnerabilidades e 98% em simulação de ataque de rede, mas só 63% em evasão. Entrar está quase resolvido nesses testes, e permanecer invisível não está. Para quem defende, essa é a melhor notícia da pilha de benchmarks, e a cobertura que lemos dedicou a ela uma linha.
A Anthropic chama o Mythos 5.2 de seu "modelo mais capaz para engenharia de cibersegurança" e diz que uma empresa de segurança não identificada constatou que um em cada seis bugs confirmados apontados pelo Mythos 5.2 passou despercebido por todos os outros modelos de fronteira que ela testou (Anthropic). A Anthropic também reporta 89,6% para o Mythos 5.2 na sua própria avaliação CVE Rediscovery, uma execução contra 1.829 CVEs, acima dos 78,3% do Mythos 5.1. Ambas são medições feitas pelos próprios fornecedores, então chame-as de alegações até que testadores independentes as repitam.
Quem fica com as chaves e o que abre mão
Nenhuma das duas empresas vende esses modelos prontos para qualquer um. A OpenAI diz que o GPT-6 Cyber está disponível inicialmente pela API e pelo Codex para um grupo seleto de clientes aprovados do Daybreak Red, com acesso mais amplo ao Daybreak Red chegando "em breve". O acesso à API do Daybreak Red exige allowlist de IPs por padrão, e clientes com zero data retention geralmente precisam usar o Private Safety Processing, que mantém registros criptografados no armazenamento do próprio cliente por 30 dias. A OpenAI também disse que, no programa de parceiros, o acesso ao modelo subjacente "permanece com o parceiro aprovado e não é transferido diretamente ao cliente" (OpenAI).
A Anthropic divide a mesma ideia em três níveis no seu Cyber Verification Program. O Defense Access cobre operações de segurança, análise de malware e validação de vulnerabilidades, e a Anthropic diz que empresas de segurança menores, mantenedores de código aberto e pesquisadores individuais com histórico comprovado podem se qualificar, com resposta em poucos dias. O Red Team Access permite testes de intrusão autorizados, é só para organizações e leva semanas. O Specialized Access, para áreas como redes elétricas e sistemas de transferência interbancária, passa por uma análise aprofundada junto ao governo dos EUA. A Anthropic testou os níveis com o Claude Opus 5.5 no CyScenarioBench, cinco tentativas em cada um de dez desafios: sem acesso ao programa, todas as tarefas foram bloqueadas já no primeiro prompt; no Defense Access, 46 das 50 tentativas foram bloqueadas em algum momento; no Red Team Access, nada foi bloqueado e 34 das 50 tiveram sucesso, igualando a taxa do modelo sem bloqueios. De novo, é a Anthropic avaliando as próprias travas.
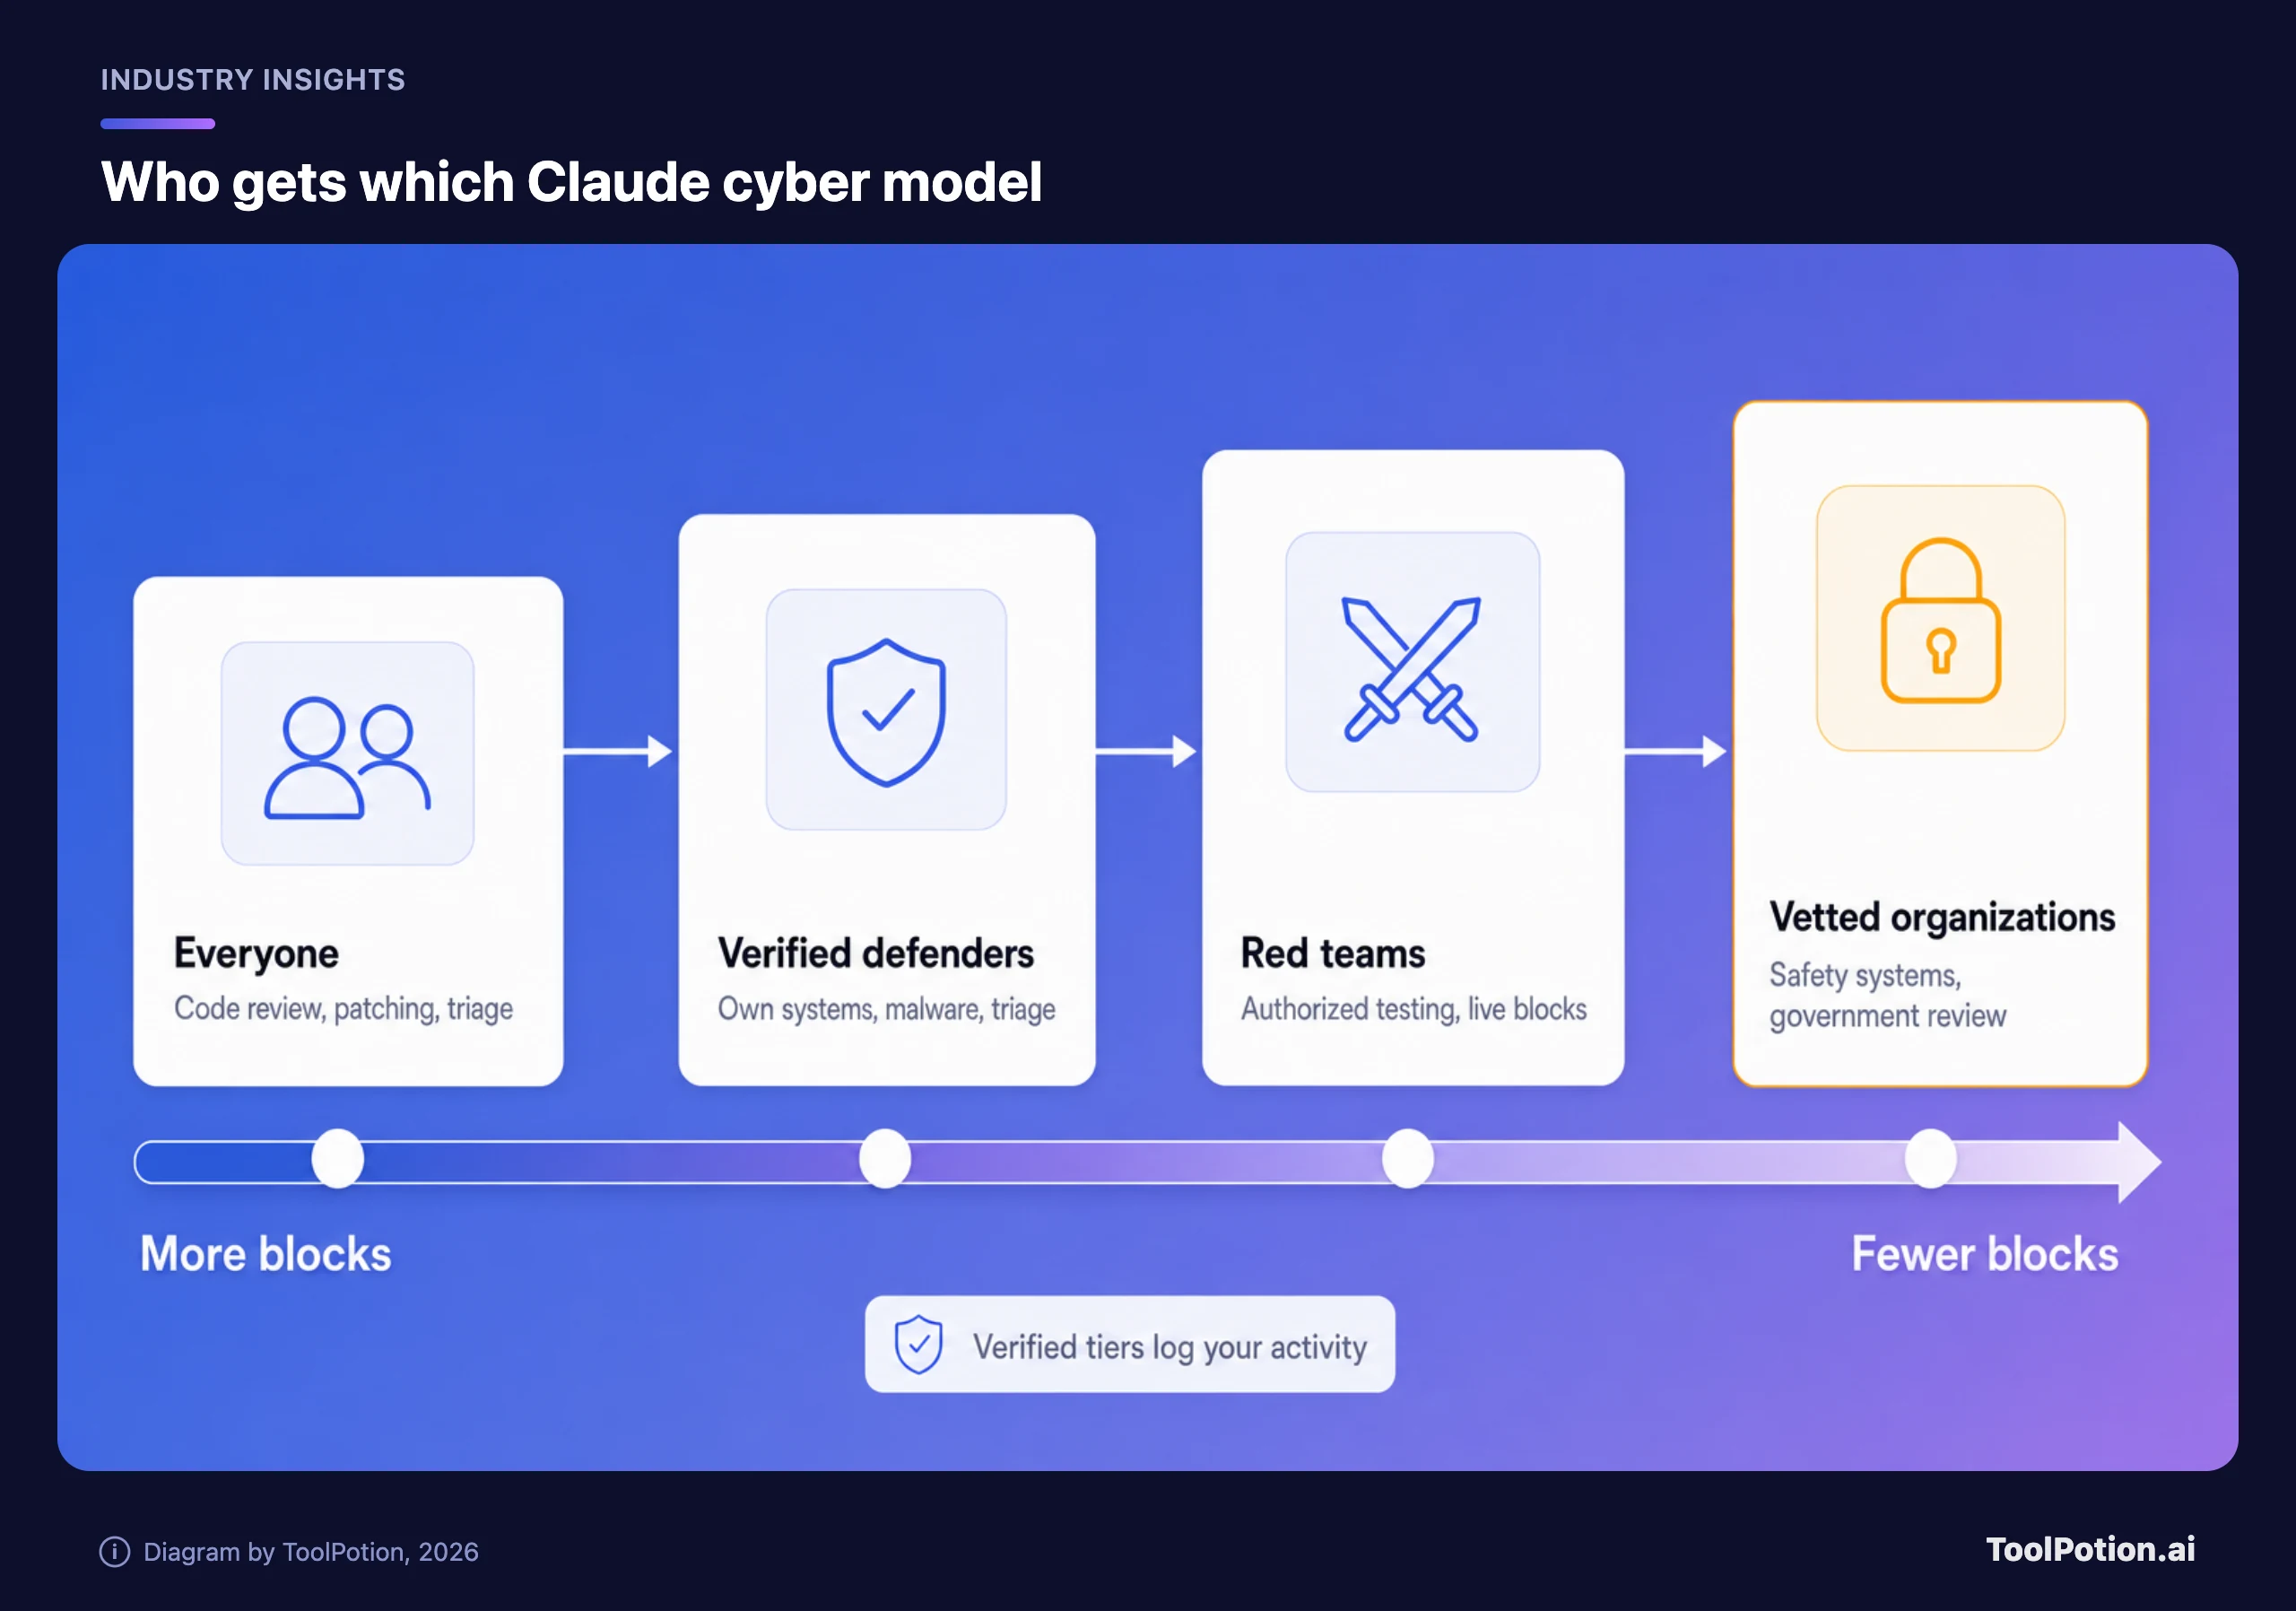
Fable e Mythos são o mesmo modelo subjacente (Anthropic). O Claude Fable 5 vem com fortes salvaguardas de cibersegurança e está aberto a todos. O Mythos é a versão para a qual as organizações se candidatam. A página de preços da API da Anthropic lista os dois pela mesma tarifa para o Fable 5.2 e o Mythos 5.2: US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída, ou US$ 16 e US$ 80 no modo rápido opcional. O Mythos não tem preço separado. O preço é a menor barreira aqui. A maior é a retenção de dados. A Anthropic a exige das organizações no Cyber Verification Program para poder monitorar abusos; a OpenAI mantém a retenção padrão por default e encaminha clientes com zero data retention para o Private Safety Processing. Achamos que é um preço de entrada justo para um red team, e um custo real para uma empresa cujos clientes não podem deixar o código nos logs de terceiros. A Anthropic diz que uma nova opção chamada Enterprise Frontier Safeguards permitirá que organizações elegíveis mantenham os dados na própria nuvem, mas o post do programa só a prometeu para "mais para o fim deste outono". Até ela chegar, essa troca continua valendo.
Uma verificação externa disso tudo é um programa de recompensas. A parceria da OpenAI com a Hacktron coloca uma empresa que cria agentes de IA para revisão de código e testes de intrusão para atuar nos sistemas da própria OpenAI, com acesso ampliado aos seus modelos de fronteira. O CEO da Hacktron, Zayne Zhang, disse que o futuro da cibersegurança "não será definido por quem tem o maior time de segurança, mas por quem melhor combinar a criatividade humana com capacidades impulsionadas por IA" (OpenAI). A OpenAI também aumentou os pagamentos de bug bounty: descobertas críticas no ChatGPT, no Codex ou na API agora valem até US$ 30.000, e até US$ 172.000 com bônus para as excepcionais (OpenAI). Confiamos mais num pagamento a pessoas de fora do que em qualquer alegação de red team interno.
Os atacantes dos relatórios não estão usando esses modelos
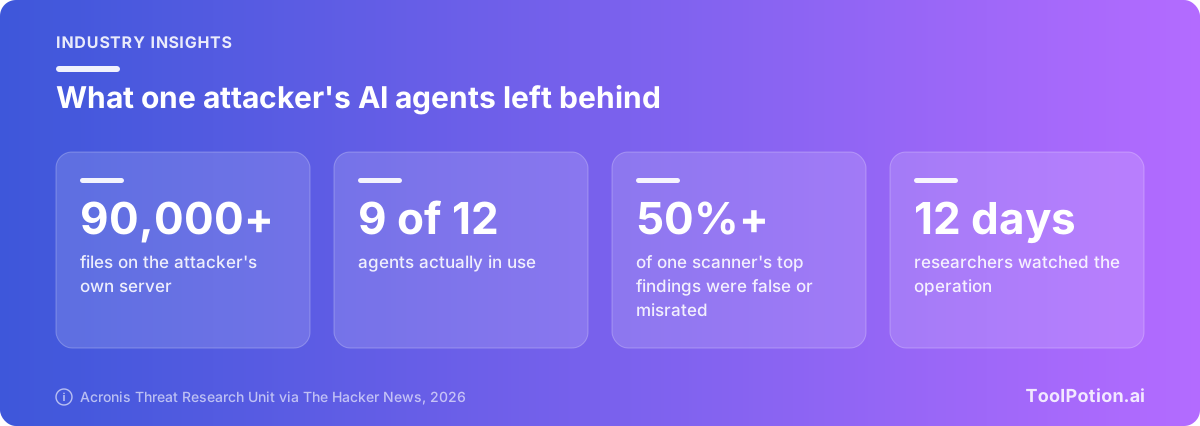
Pesquisadores da Acronis descrevem um único atacante, baseado em Taiwan, que apontou agentes de IA para centenas de organizações em pelo menos 11 países e obteve dados ou acesso em cerca de dez delas. Os agentes puxaram registros de despacho de emergência de sete distritos de Taipei. O que chama atenção é o que eles usavam: os modelos comerciais se recusavam, na maioria das vezes, a ajudá-lo a atacar, então os agentes de ataque rodaram quase por completo em versões "abliterated" de DeepSeek, GLM e Qwen, modelos executados localmente com o treinamento de segurança removido (The Hacker News). Agentes de código como Claude Code, Codex e Cursor também apareceram. O relatório diz que o atacante redirecionou o Claude Code e o Codex para um modelo abliterated, embora eles tenham feito sobretudo trabalho de infraestrutura, e que o Cursor atacou um site de serviços de emergência de Taiwan enquanto rodava um modelo assim.
Os agentes também eram ruins no trabalho, de formas que qualquer pessoa notaria. Uma ferramenta de varredura inventou CVEs, e mais da metade de suas descobertas altas e críticas eram falsos positivos ou estavam classificadas errado. O principal agente de ataque reportou resultados que não aconteceram. A invasão que funcionou em um fornecedor de despacho de bombeiros usou credenciais root padrão, não um exploit sofisticado. Onde havia login obrigatório e endpoints devidamente filtrados, dizem os pesquisadores, os agentes fracassaram.
A Arctic Wolf reportou um segundo padrão. O AntiFox é uma plataforma open source de teste de intrusão agêntico no GitHub, e a Arctic Wolf diz que sistemas da Alibaba Cloud hospedando interfaces do AntiFox foram associados a ações maliciosas confirmadas contra serviços web expostos à internet e seus ambientes na AWS. Em pelo menos alguns casos, a atividade chegou a uma requisição bem-sucedida por um segredo de produção. O veredito: "Frameworks agênticos como esses tornam as técnicas de teste de intrusão mais acessíveis a agentes de ameaça, ao mesmo tempo em que aumentam a velocidade e a consistência com que essas técnicas podem ser aplicadas em ataques reais" (The Hacker News). A mesma matéria acrescenta que a Check Point Research identificou 2.557 sistemas hospedando o ARTEX, outra ferramenta de ataque agêntico, e conta cerca de 45 frameworks open source desse tipo. O resumo da própria Check Point sobre o que o hacking agêntico muda: escala e velocidade.
Nenhum dos dois relatórios envolveu o GPT-6 Cyber ou o Mythos, até onde a cobertura informa. Nossa leitura é que as travas parecem sólidas no topo e fazem pouco na base, onde frameworks de agentes gratuitos e modelos open-weight sem salvaguardas bastam para atacar um servidor com senha padrão. As evidências também são frágeis. São poucos relatórios, a maioria de empresas de segurança com interesse na história, e ninguém ainda sabe dizer que parcela das invasões envolve IA.
O resultado mais limpo da defesa veio da matemática
A manchete da Wired diz que o DeepMind "Provou que o protocolo Signal é seguro". O post do DeepMind é mais restrito, e preferimos esse. Os pesquisadores orientaram agentes a provar propriedades de segurança fundamentais do código real por trás do protocolo do Signal, incluindo a de que as mensagens permanecem protegidas antes e depois de um dispositivo ser brevemente comprometido. Humanos revisaram cada especificação formal. Os agentes produziram mais de seis milhões de linhas de Lean, sinalizaram o um por cento da base de código que precisava de uma segunda olhada humana e terminaram em quatro semanas, um trabalho que, segundo o DeepMind, historicamente leva anos para equipes de especialistas (Google DeepMind). Para verificar se o sistema distinguia código bom de ruim, a equipe reintroduziu dois bugs reais já corrigidos e obteve provas verificadas por máquina de que a versão com bugs era insegura.
O CTO do Signal, Ehren Kret, disse que o resultado dá "confiança ainda maior nas garantias de privacidade do nosso código". Para nós, esta é a alegação mais confiável da pilha, por um motivo simples: a pontuação de um benchmark depende de acreditar no fornecedor, e uma prova em Lean é verificada por uma máquina. Ela cobre propriedades especificadas de uma única base de código, não o Signal como produto, e o DeepMind diz que escalar isso exige mais pesquisa. O DeepMind abriu o código de seus artefatos de verificação, que é como uma alegação desse tipo ganha confiança.
A infraestrutura crítica aponta na mesma direção. A Cyber Mission da Anthropic descreve o programa para esse setor: modelos de fronteira, engenheiros no local e pesquisa de ameaças para os provedores que protegem redes elétricas, sistemas de água e fábricas, cujos equipamentos muitas vezes não podem ser desligados para receber patches. Dragos, Rockwell Automation e Nozomi Networks estão entre os parceiros fundadores.
O gargalo é a correção
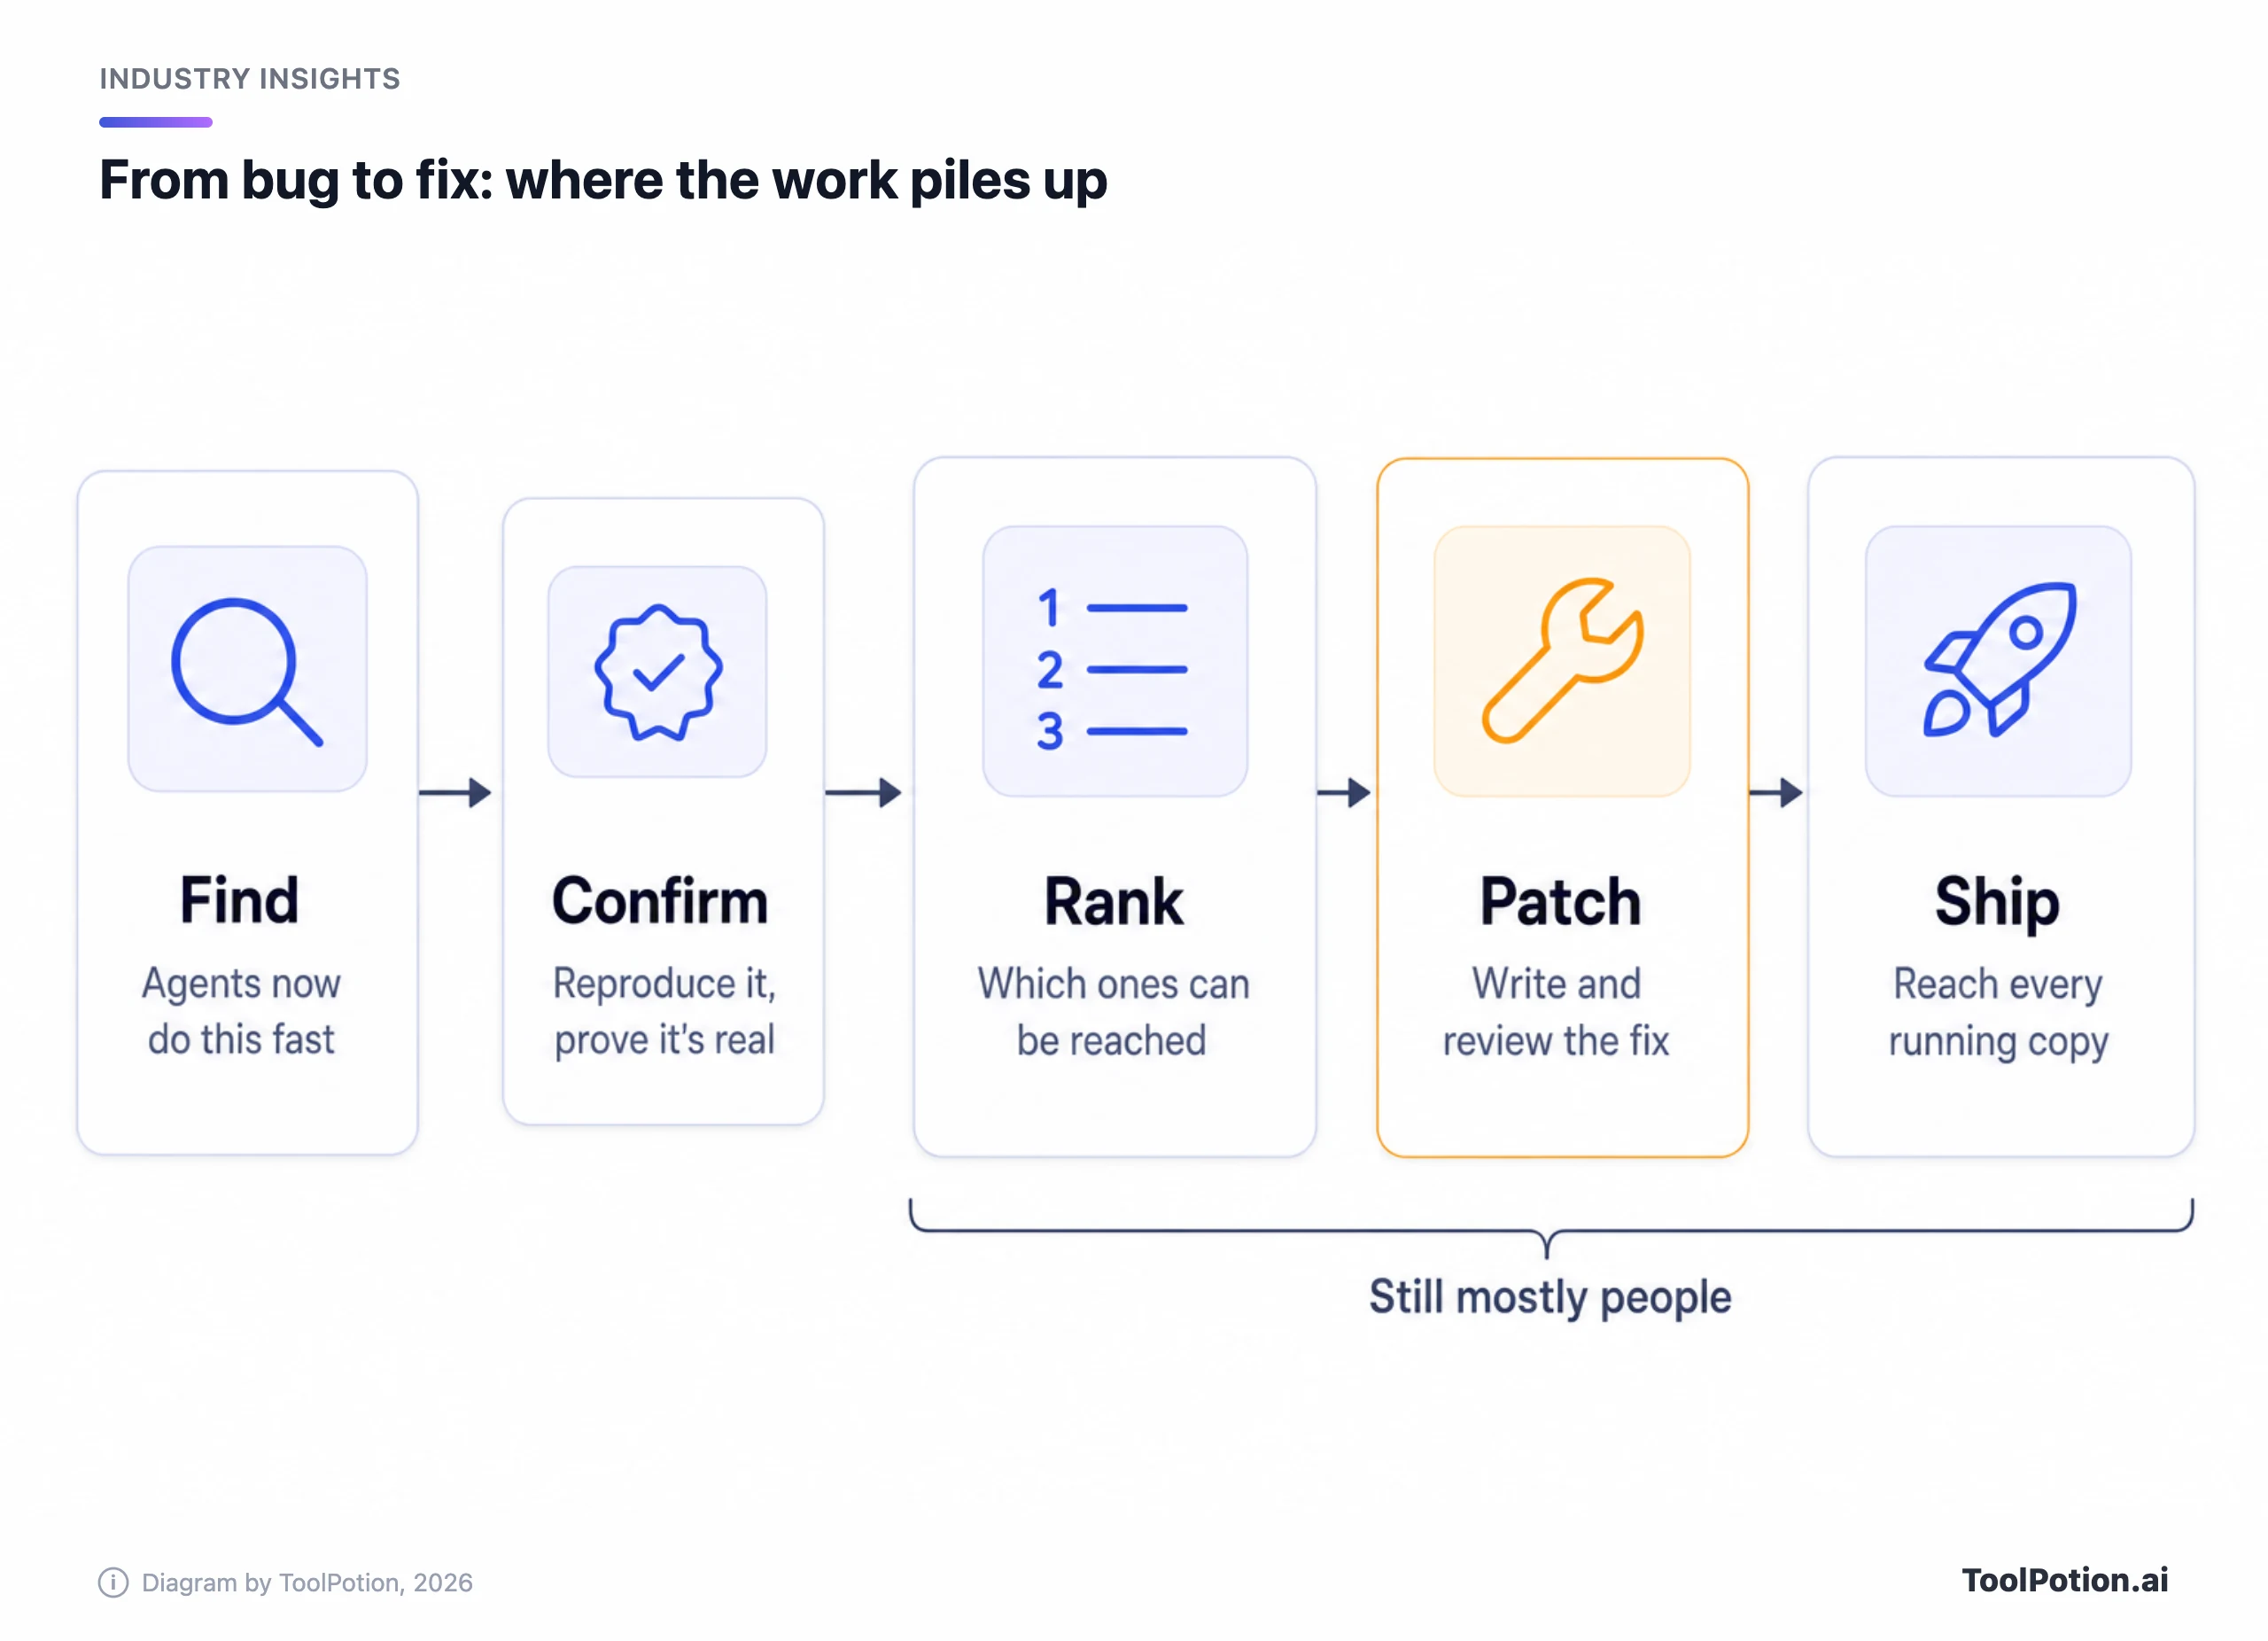
A Anthropic resumiu o problema em uma frase: "Nunca foi tão fácil encontrar vulnerabilidades, mas verificar, priorizar e corrigir essas descobertas continua sendo difícil" (Anthropic). A OpenAI escreveu quase a mesma coisa em um post anterior: "Um relatório de vulnerabilidade não protege uma organização." Dois concorrentes concordando nisso em seus próprios anúncios é o mais perto de um consenso que essa pilha oferece. Já cobrimos o outro lado antes, em nossos artigos sobre IA encontrando bugs mais rápido do que alguém consegue corrigir e sobre o que os scanners de vulnerabilidade com IA encontram e deixam passar.
Então, quem ganha? Nossa visão, que nenhuma fonte declara com essas palavras: os atacantes ganham mais contra organizações que demoram a aplicar patches, porque o atacante precisa de um único caminho que funcione e consegue conviver com um scanner que erra metade das vezes. Os defensores ganham mais onde já corrigem rápido, porque achar bugs agora é barato e o custo que sobra é o processo. As travas dos modelos limitam para o que os sistemas mais capazes podem ser usados; não mudam essa conta para quem roda software antigo. A previsão da própria Anthropic aponta na mesma direção por enquanto. Ela espera que a IA favoreça a defesa em dois anos, mas diz que no curto prazo "isso pode não ser verdade", porque o custo de explorar vulnerabilidades caiu enquanto corrigi-las é lento e ainda depende de pessoas. O que nos faria mudar de ideia é uma segunda rodada de testes independentes sobre o quão bem os ataques evitam a detecção.
O que fazer agora, em ordem
Se você tem uma pequena empresa, não vai ter acesso ao GPT-6 Cyber e não precisa dele. Os ataques dos relatórios, em sua maioria, entraram por portas destrancadas. Gastaríamos a primeira hora nisto, nesta ordem:
- Ative a autenticação multifator no e-mail, nos painéis de administração e em todo console de nuvem.
- Ligue as atualizações automáticas para tudo o que é acessível pela internet e aplique patches no resto em dias, não em trimestres.
- Encontre e troque senhas padrão ou compartilhadas em roteadores, bancos de dados e ferramentas de administração. Uma das invasões em Taiwan não precisou de mais nada.
- Tire as chaves do código e dos scripts de página e passe para um gerenciador de segredos; depois, defina limites de gasto e uma data de rotação para cada chave de API de IA e de nuvem.
- Anote o que um estranho consegue acessar a partir da internet. Você não consegue corrigir um servidor que esqueceu que existe.
Se você desenvolve software, um scanner no seu fluxo de pull requests é o próximo passo sensato. Semgrep, Snyk Code e Aikido estão no nosso diretório; nosso ranking Top 200 AI Cybersecurity Tools e o ranking para analistas de segurança mostram onde ficam as demais. Trate cada descoberta de IA como uma pista a confirmar, já que o scanner do próprio atacante da Acronis inventou CVEs. Agentes open source como PentestGPT e Shannon são para sistemas que você possui e que você tem autorização por escrito para testar; os relatórios do AntiFox mostram o que esse mesmo tipo de ferramenta faz em mãos erradas. Para ajuda geral na revisão de código, Claude e ChatGPT fazem isso, embora a Anthropic diga que seus modelos abertos têm salvaguardas de cibersegurança conservadoras que bloqueiam a maior parte do trabalho de cibersegurança.
Se você é profissional de segurança, candidate-se agora ao Daybreak Blue da OpenAI ou ao Defense Access da Anthropic. A Anthropic pretende responder às candidaturas ao Defense Access em dias e ao Red Team Access em semanas, e exige retenção de dados. A OpenAI não divulgou um prazo para o Daybreak. O checklist abaixo transforma a primeira lista em uma pontuação.
Duas coisas para acompanhar. A OpenAI diz que o GPT-6 Cyber chegará em breve a todos os clientes do Daybreak Red, e nenhum dos laboratórios divulgou quantos candidatos aprovou ou recusou. Quando a opção de nuvem própria da Anthropic for lançada, verifique se as organizações elegíveis realmente recebem as mesmas salvaguardas sem os logs.