

A Anthropic lançou nesta semana um scanner de segurança com IA gratuito e opcional para projetos open source, e o momento é bagunçado. A IA já consegue encontrar bugs reais em código que humanos auditam há anos. Também consegue soterrar um mantenedor voluntário com bugs falsos. As duas coisas são verdade ao mesmo tempo, e uma equipe pequena precisa decidir o que fazer com isso.
O novo serviço, chamado OSS Scanner, executa varreduras periódicas de vulnerabilidades nos projetos inscritos usando os modelos mais fortes da Anthropic. Cada relatório vem com um reproducer, uma explicação e, quando possível, uma sugestão de patch (Anthropic). Ele chega junto de vários esforços parecidos de Google, OpenAI, GitHub, Snyk e Semgrep, e de uma pilha crescente de relatórios de IA de baixa qualidade que fez alguns mantenedores fecharem as portas.
Este texto coloca ordem nisso. O que essas ferramentas fazem, quais não custam nada, como aderir sem se prejudicar e um fluxo de trabalho que uma equipe de duas pessoas consegue seguir. Resumindo: os scanners de IA já são bons o bastante para serem levados a sério, e ninguém deveria fazer merge do que eles produzem sem ler.
O que o OSS Scanner da Anthropic faz
Os mantenedores principais se inscrevem abrindo um pull request em um repositório do GitHub, seguindo um template. A Anthropic decide caso a caso, com critérios parecidos com os do OSS-Fuzz, do Google: o projeto precisa ter "impacto crítico na infraestrutura e na segurança dos usuários" (Anthropic). Ou seja, não é para qualquer repositório de hobby. Pense em curl e wolfSSL, o tipo de biblioteca à qual metade da internet está ligada.
É gratuito. Um fundo que a Anthropic chama de Defender Advantage Fund paga as varreduras (SiliconANGLE), e a empresa diz que a participação continua sem custo para os projetos inscritos.
O que mais importa é o que falta. Os relatórios são "totalmente gerados por modelo, sem revisão ou triagem humana", e a Anthropic diz abertamente que alguns estarão errados (Anthropic). Um dos exemplos que ela dá é uma classificação de severidade ruim. Projetos sem equipe para filtrar relatórios podem continuar usando o processo de divulgação já existente da Anthropic, em que humanos verificam antes (SiliconANGLE).
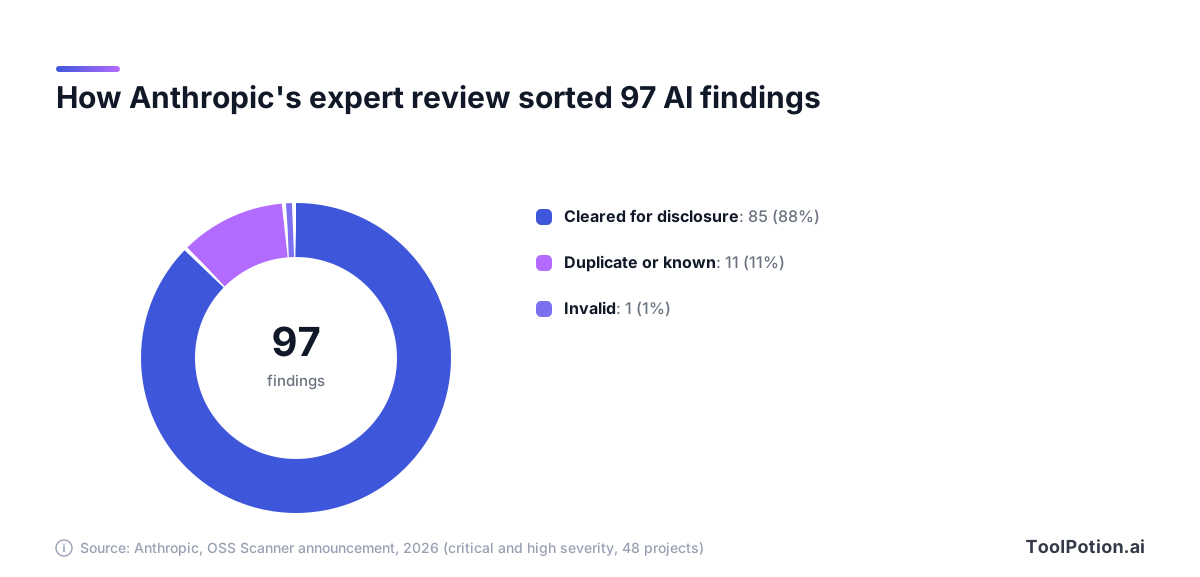
Os números da própria Anthropic mostram por que ela acha que vale a pena. Pentesters especialistas revisaram 97 achados de severidade crítica e alta em 48 projetos. Desses, 85 atingiram o nível para divulgação coordenada, 11 eram duplicados ou reais, mas já conhecidos, e um era inválido (Anthropic). Separadamente, a wolfSSL informou que 72 de 74 relatórios de um teste inicial eram válidos, e eles geraram cinco CVEs (SiliconANGLE).
Daniel Stenberg, que cuida do curl, disse que o scanner encontrou "uma das piores vulnerabilidades do curl reportadas nos últimos anos" (Anthropic). Lembre-se de que todos esses números vêm da Anthropic ou de parceiros dela. A empresa também diz esperar uma taxa de verdadeiros positivos acima de 90% (Anthropic), o que é uma previsão, não uma garantia para o seu repositório.
O que um scanner de IA realmente faz: encontra, prova, corrige
A análise estática tradicional compara o código com regras. É rápida e previsível, e te inunda de avisos. Os scanners agênticos mais novos funcionam mais como um pesquisador de segurança júnior. Eles leem o código, formam uma hipótese de onde ele quebra, tentam provocar a falha e só então escrevem o relatório.
Esse passo do meio é o que você deve procurar. Um achado que vem com um exploit funcionando é um bicho bem diferente de um achado que vem com um parágrafo de prosa confiante.
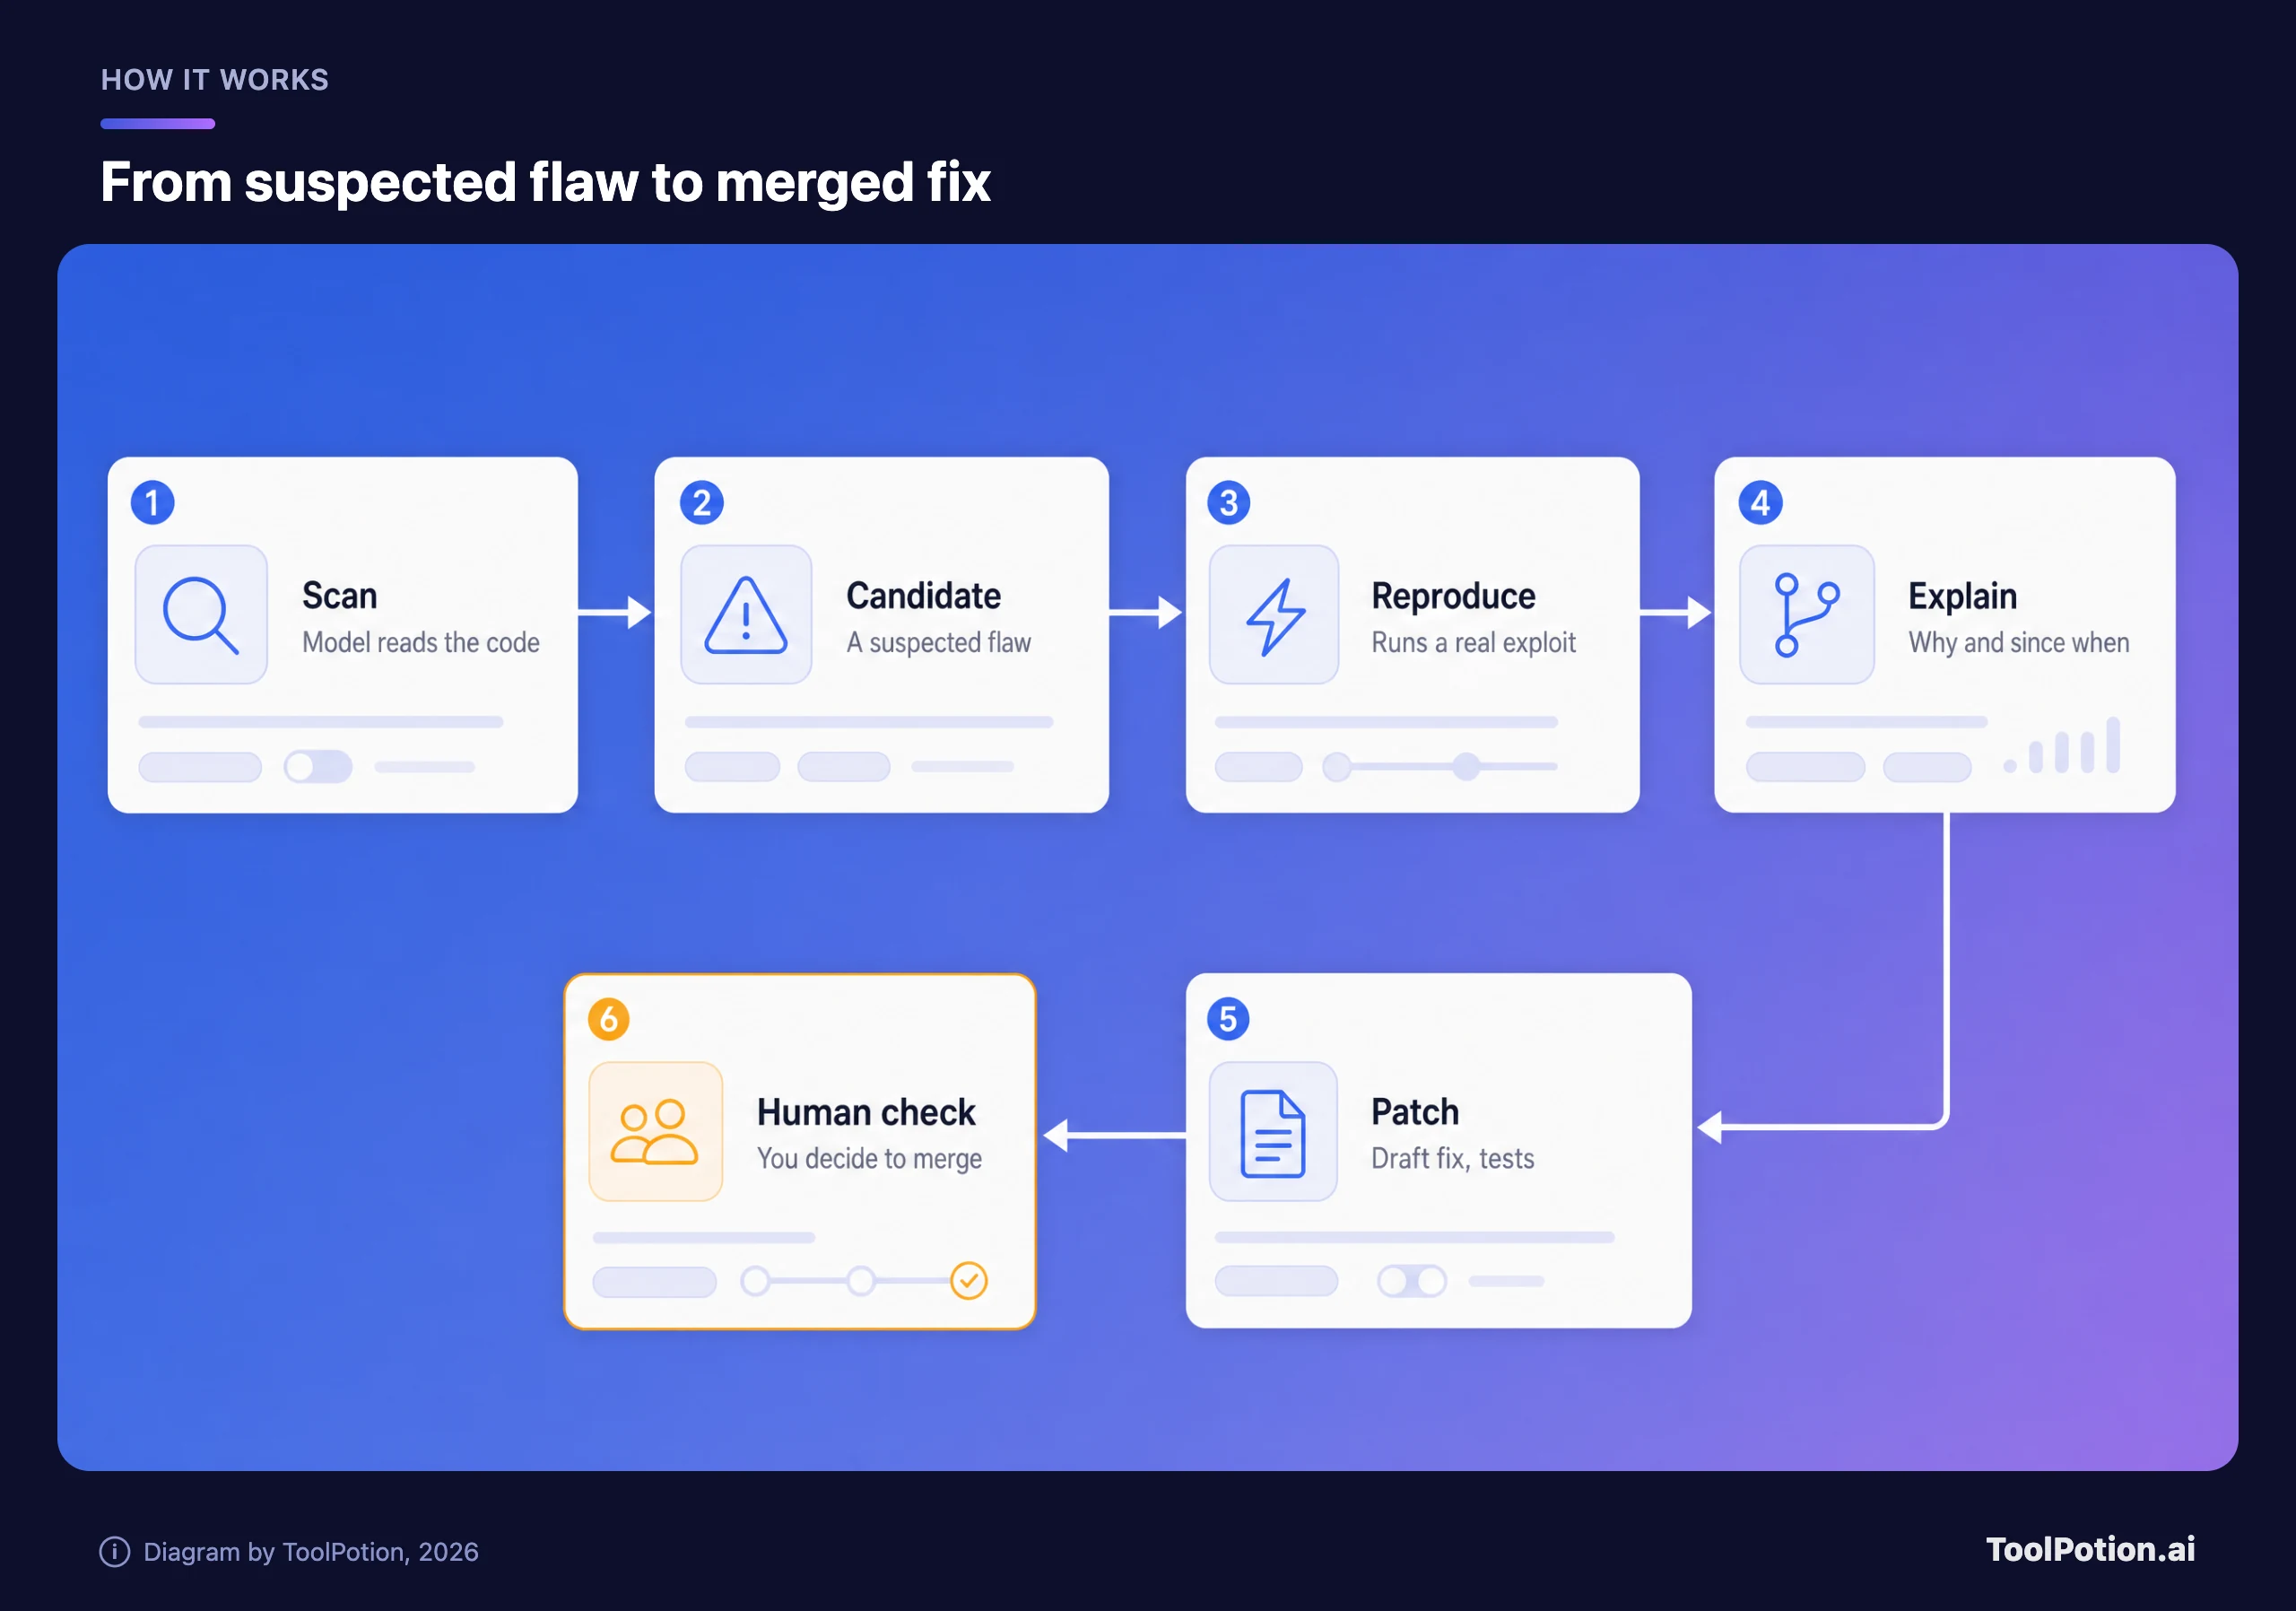
Leia o pipeline da esquerda para a direita. As três primeiras etapas são sobre acertar: um candidato passa por um teste real antes de qualquer pessoa vê-lo. As etapas quatro e cinco são sobre ser útil, com uma explicação do que quebrou e um rascunho de correção. A última caixa é sua, e é âmbar por um motivo. O Google diz que todo patch do CodeMender passa por revisão humana, e o Autofix do GitHub apenas sugere. O scanner da Anthropic é a exceção na triagem, e é por isso que essa última caixa fica com você.
O cenário em 2026
O OSS Scanner não está sozinho. O DeepMind, do Google, criou o Big Sleep, um agente que caça bugs, e o CodeMender, que escreve correções. O DeepMind disse que já tinha enviado upstream 72 correções de segurança para projetos open source, e que todos os patches foram revisados antes por pesquisadores humanos (Google DeepMind). Desde então, o CodeMender entrou em preview público para clientes corporativos do Google Cloud, onde cria exploits de prova de conceito em sandbox e devolve correções testadas na forma de diffs para revisão do desenvolvedor (Infosecurity Magazine).
A versão da OpenAI foi lançada como Aardvark, um agente baseado no GPT-5 que monta um modelo de ameaças do seu repositório, acompanha os novos commits, confirma problemas em sandbox e propõe patches. A OpenAI disse que ele chegou a 92% em vulnerabilidades conhecidas e sintéticas em repositórios de teste e encontrou problemas que renderam dez IDs de CVE (OpenAI). Desde então, a OpenAI incorporou o produto ao Codex com outro nome: a página do Aardvark agora diz "Aardvark is now Codex Security", disponível como research preview (OpenAI). A documentação descreve o Codex Security como um agente que ajuda equipes a "encontrar, confirmar e corrigir vulnerabilidades", com a versão em nuvem ainda em research preview (OpenAI docs).
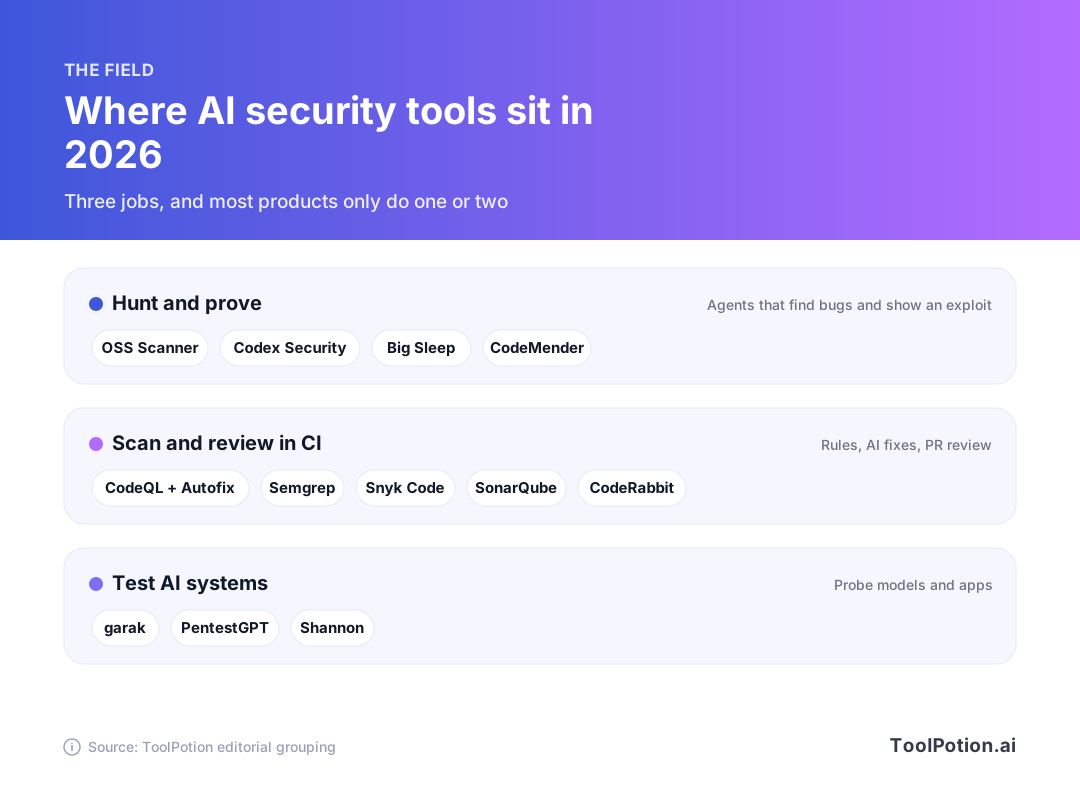
O mapa agrupa as ferramentas por função, e o agrupamento é nosso, não dos fornecedores. A linha de cima caça e prova. A do meio vive no seu pipeline e atua em cada commit. A de baixo aponta para o outro lado e testa os próprios sistemas de IA.
Na linha do meio, o Autofix do GitHub Copilot sugere correções para alertas levantados pelo CodeQL, o scanner do GitHub. Semgrep e Snyk Code fazem trabalho parecido com seus próprios motores, e o SonarQube cobre qualidade de código mais verificações de segurança. O CodeRabbit revisa pull requests. Na linha de baixo, o garak sonda modelos de linguagem em busca de fraquezas, e o PentestGPT conduz testes de intrusão com um modelo. Nosso ranking de cibersegurança com IA lista o conjunto mais amplo, e o ranking de revisão de código cobre as ferramentas de pull request.
| Ferramenta | Função principal | Quem pode usar |
|---|---|---|
| OSS Scanner (Anthropic) | Encontra e prova bugs, rascunha patches | Projetos open source inscritos, grátis |
| Codex Security (OpenAI) | Encontra, confirma e corrige | Research preview dentro do Codex |
| CodeMender (Google) | Varre, prova e corrige | Preview público, clientes do Google Cloud |
| Copilot Autofix (GitHub) | Sugere correções para alertas do CodeQL | Grátis em repositórios públicos |
| Semgrep | Varredura baseada em regras com recursos de IA | Grátis até 10 contribuidores |
| Snyk Code | Varredura de código e dependências | Plano gratuito, 100 testes do Code por mês |
Quase tudo que está nessa tabela vem de páginas dos próprios fornecedores, e fornecedor descreve o próprio produto com carinho. Trate os termos de acesso como a coluna útil. Eles mudam rápido.
O outro lado: mantenedores estão se afogando
Os mesmos modelos que encontram bugs reais também escrevem bugs falsos convincentes. O curl é o caso mais claro. O programa de recompensas dele funcionou de 2019 até o início de 2026, pagou mais de US$ 100.000 por 87 vulnerabilidades confirmadas e depois foi encerrado. Em 2025, menos de 5% dos relatórios eram confirmados, contra 15% ou mais nos anos anteriores (Daniel Stenberg).
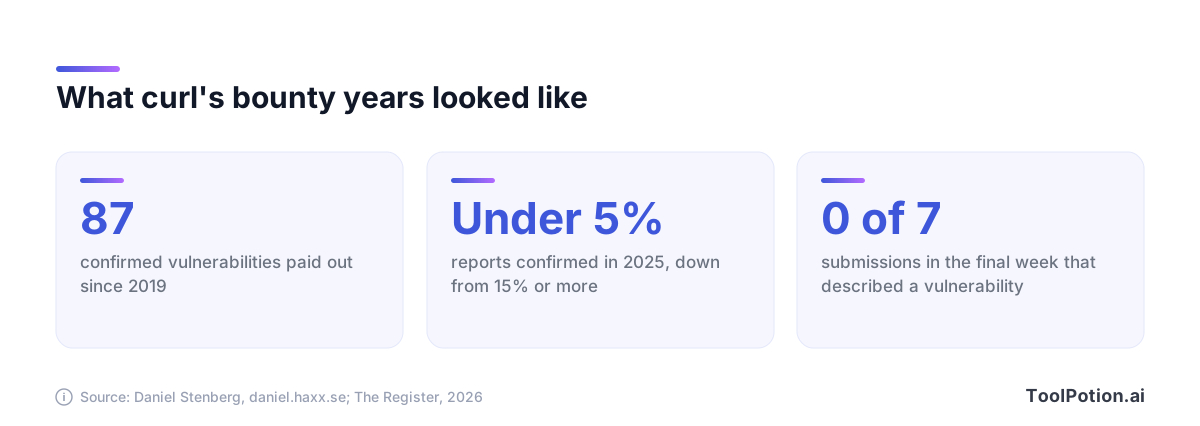
Na última semana antes do fim do programa de recompensas, o curl recebeu sete submissões e nenhuma descrevia uma vulnerabilidade (The Register). O raciocínio de Stenberg foi direto. O objetivo era "remover o incentivo para as pessoas nos enviarem porcaria e relatórios mal pesquisados. Sejam gerados por IA ou não." Piotr Karwasz, do Apache Log4j, descreveu o mesmo padrão, dizendo que muitos relatórios "ignoram os fundamentos do nosso modelo de segurança, acrescentando ruído em vez de valor" (Daniel Stenberg).
O curl foi além depois. Stenberg escreveu que o projeto pausou os relatórios de vulnerabilidade por um mês neste verão e chamou isso de "possivelmente a nossa melhor decisão de projeto em muito tempo" (Daniel Stenberg).
Repare que o mesmo projeto que encerrou o programa de recompensas para barrar o ruído de IA também elogiou um scanner de IA que achou um dos piores bugs dele. Não é contradição. A diferença está em ter um reproducer funcionando e um remetente que já fez a checagem. Um modelo que prova o que afirma custa minutos ao mantenedor. Uma pessoa que cola a saída de um modelo custa horas.
O scanner da Anthropic dispensa o intermediário humano, o que é ao mesmo tempo o atrativo e o risco. Ele acelera a entrega e também significa que um relatório pode chegar à sua porta sem que ninguém o tenha lido antes. Se você mantém um projeto, espere mais disso de todos os fornecedores da tabela.
Os atacantes têm os mesmos modelos
O próprio anúncio da Anthropic diz que "modelos de fronteira podem ser usados de forma indevida para explorar vulnerabilidades e conduzir operações cibernéticas" (Anthropic). A leitura prática é simples. Qualquer pessoa pode apontar um modelo forte para código público e perguntar onde ele quebra, e open source é público por definição.
Esse é o verdadeiro argumento para varrer o seu próprio código. Não é que os scanners de IA sejam mágicos. É que a janela entre um bug existir e outra pessoa encontrá-lo está encurtando, e você prefere chegar primeiro. Um projeto sem varredura não é seguro. Está só sem observação.
O que é grátis e o que não é
Boa parte da camada útil é gratuita se o seu código for público. O Copilot Autofix vem ativado por padrão em repositórios públicos que usam CodeQL, sem precisar de assinatura do Copilot (GitHub). O GitHub o tornou gratuito para todos os repositórios públicos já em 2024 (GitHub changelog).
A edição gratuita do Semgrep cobre até 10 contribuidores e 10 repositórios, com 60 créditos de IA incluídos (Semgrep). O plano gratuito do Snyk permite cinco projetos e 100 testes do Snyk Code por mês (Snyk), e a empresa também tem um programa em que mantenedores de open source podem pedir acesso gratuito.
As bordas pagas têm mais a ver com código privado e agentes. O autofix agêntico mais novo do GitHub, ainda em preview, usa créditos de IA, e o Copilot Autofix em repositórios privados exige uma licença do Code Security (GitHub). O Codex Security exige acesso ao research preview (OpenAI docs).
Como aderir com segurança
Grátis não quer dizer sem consequências. Um scanner que lê o seu código e te manda relatórios afeta o seu fluxo de trabalho, o seu processo de divulgação e, às vezes, a sua reputação. Alguns passos mantêm isso sob controle.
- Confira primeiro a elegibilidade. O OSS Scanner quer projetos com impacto crítico em infraestrutura ou segurança, então leia os critérios no repositório da Anthropic antes de gastar tempo com um pull request.
- Defina para onde vão os relatórios. Use um canal privado, como o relato privado de vulnerabilidades do GitHub ou um e-mail de segurança, para que um achado não fique público antes de existir uma correção.
- Escolha um responsável. Uma pessoa recebe todos os relatórios e decide o que acontece. Com duas pessoas, cada uma acha que a outra está cuidando.
- Leia os termos de dados de qualquer scanner hospedado. O Semgrep, por exemplo, diz que os recursos de IA ativados podem processar as partes dos arquivos que contêm achados (Semgrep). Saiba o que sai da sua máquina.
- Comece com acesso somente leitura e mantenha os patches como sugestões. Nenhuma ferramenta deve fazer push na sua branch principal.
- Escreva o seu prazo de divulgação antes de chegar o primeiro relatório. É muito mais fácil seguir uma regra que você escreveu com a cabeça fria.
Nada disso é exótico. É a mesma higiene que um bom mantenedor aplica a qualquer pesquisador externo, só que aplicada antes de o volume chegar.
Um fluxo de trabalho para equipes pequenas
Se você está numa equipe de duas a dez pessoas entregando um produto, não precisa de um scanner agêntico no primeiro dia. Precisa de uma fila que você consiga esvaziar. O ciclo abaixo tem seis etapas, e a âmbar é onde a maioria das equipes pula adiante.
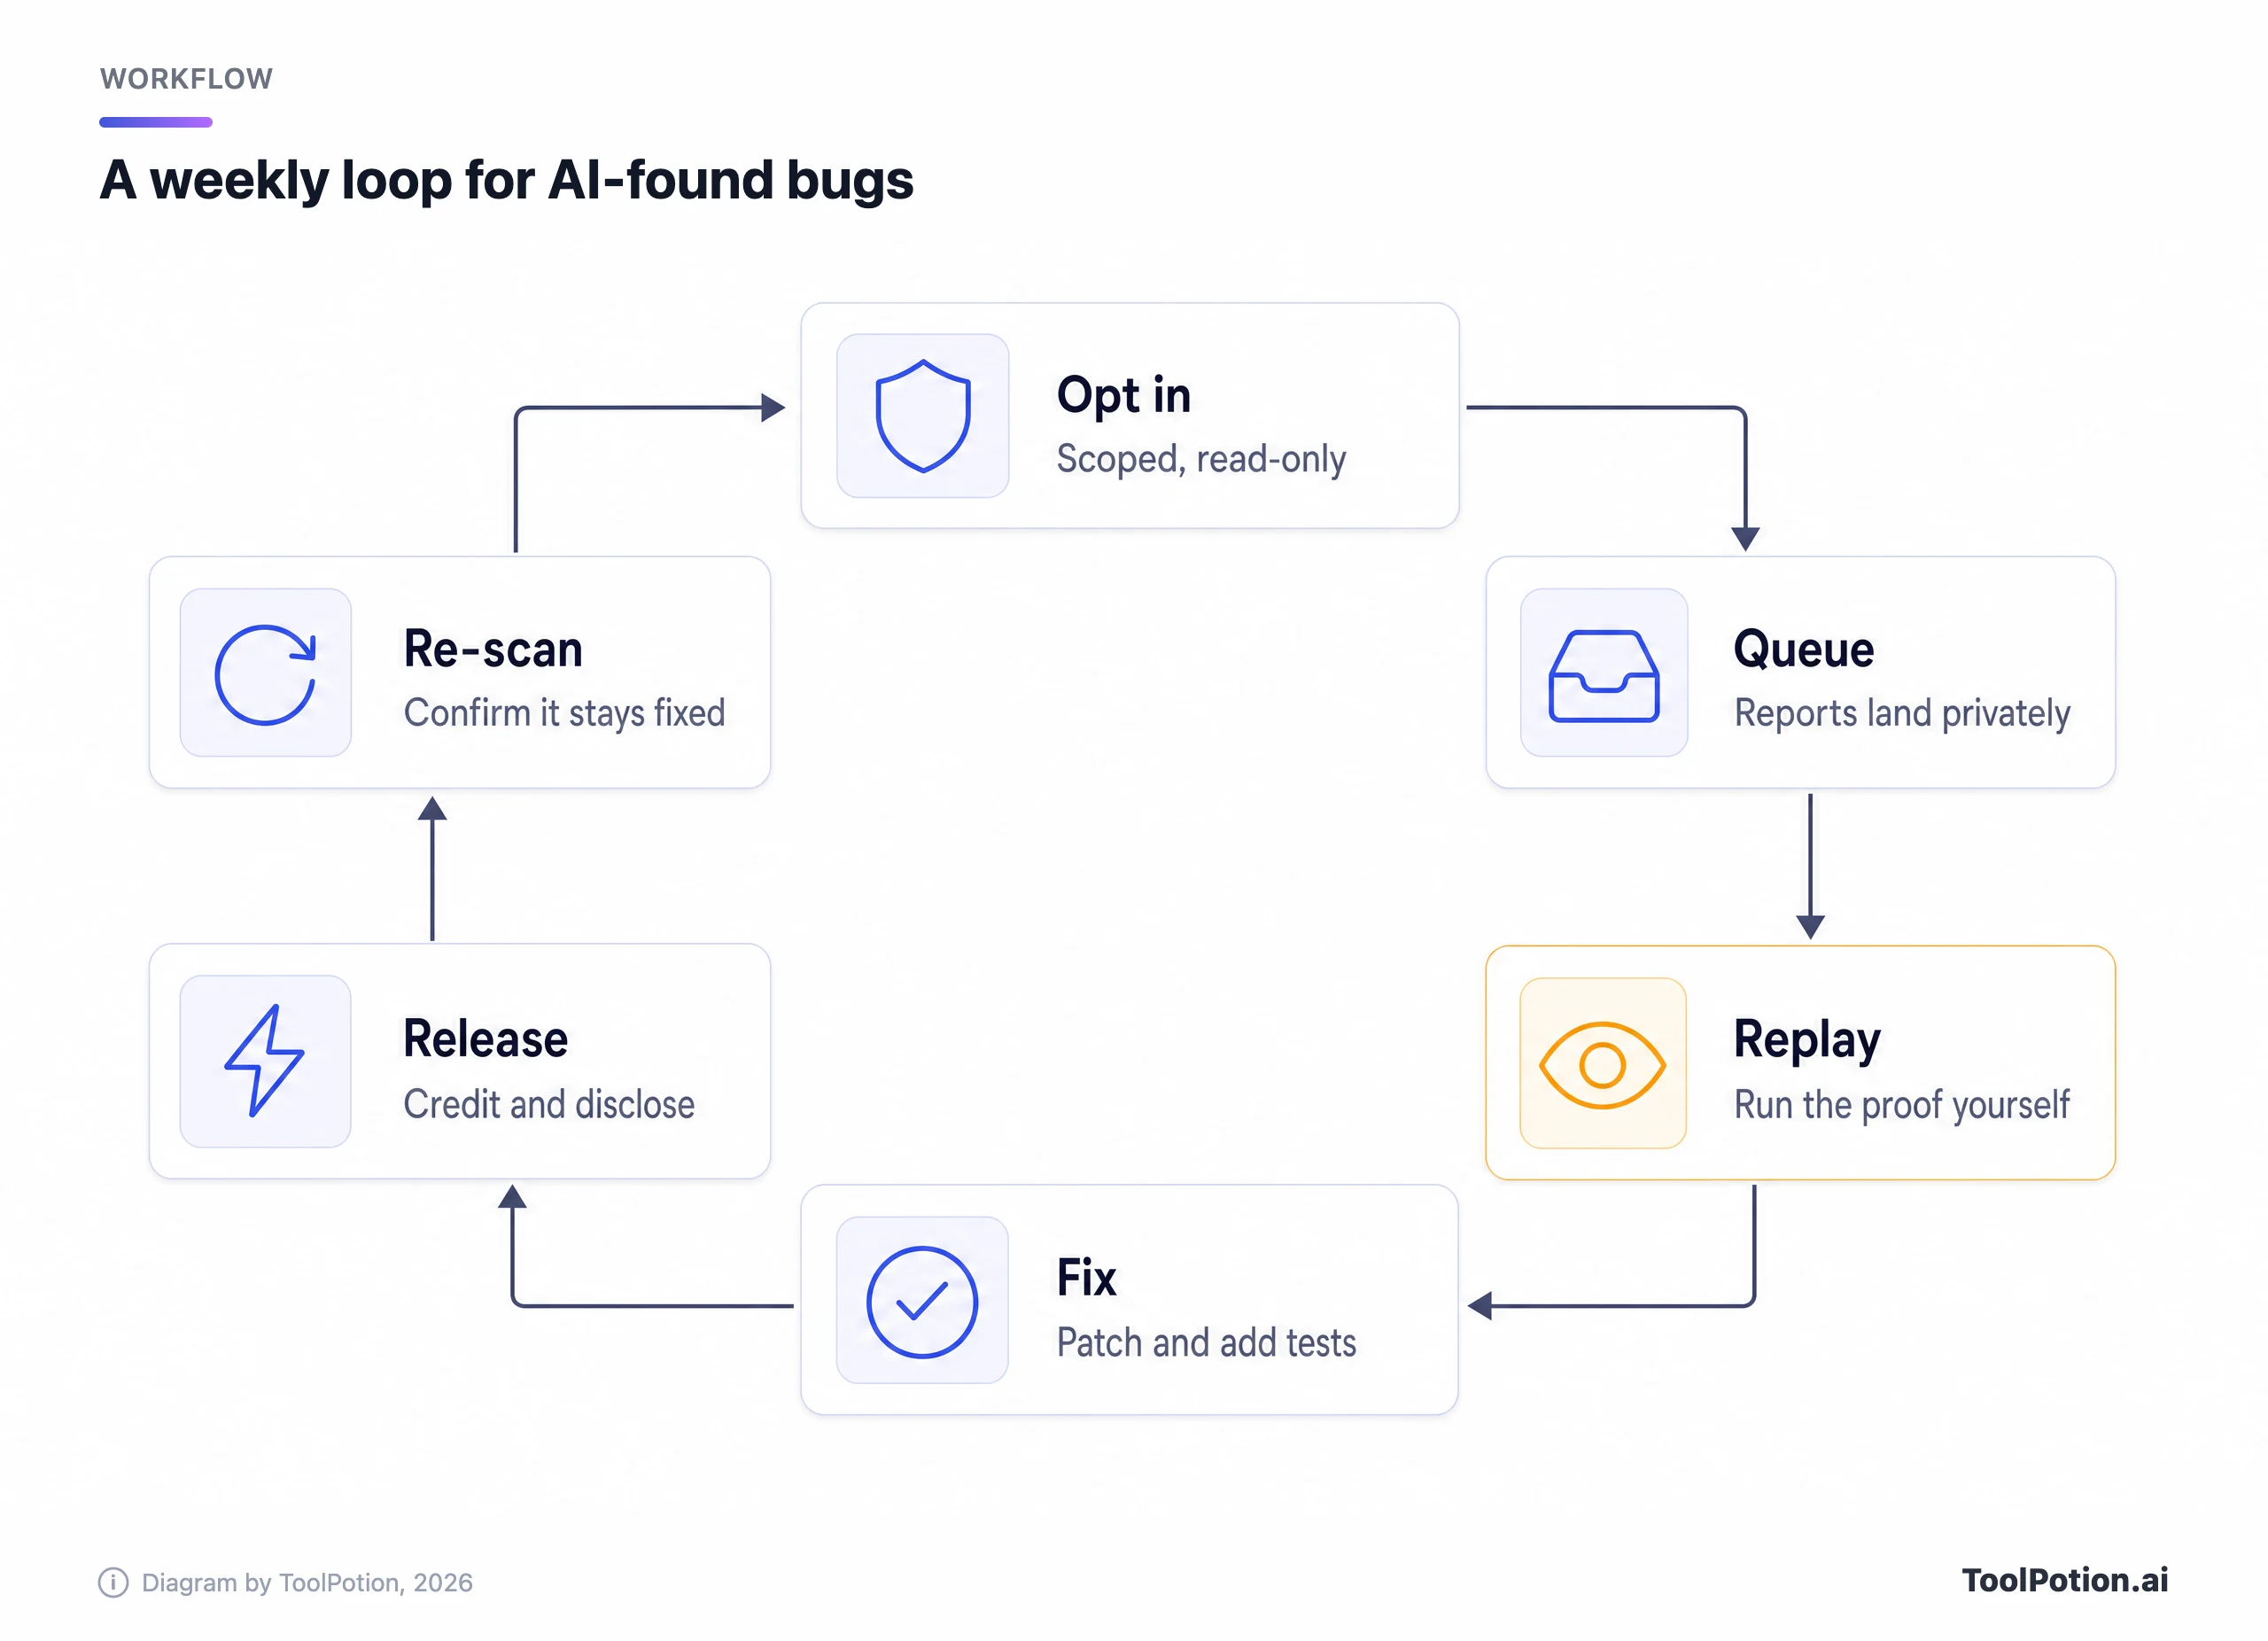
Reproduzir é a etapa que separa um scanner útil de um barulhento. Se o relatório tem um reproducer, rode você mesmo. Se não tem, peça um. Um modelo que não consegue mostrar sua afirmação funcionando te deu uma teoria, e teoria é barata.
Não sabe por onde começar? A árvore de decisão abaixo mapeia os casos mais comuns. É uma orientação editorial baseada nos termos dos fornecedores acima, então ajuste à sua situação.
Para a maioria das equipes pequenas, o melhor primeiro passo é um scanner gratuito de pull request mais uma pessoa responsável pelos resultados. Adicione uma ferramenta agêntica depois que essa fila ficar tranquila por algumas semanas. Um repositório de hobby se vira com os padrões gratuitos que a própria plataforma já oferece. Uma biblioteca em um caminho crítico é a que deveria se candidatar ao OSS Scanner.
Quanto custa a triagem
Ninguém põe o tempo de triagem na página de preços, e é esse custo que decide se um scanner ajuda ou atrapalha. Até uma boa ferramenta gera alguns duplicados. A revisão da própria Anthropic achou 11 em 97. A calculadora abaixo transforma o seu volume de relatórios em horas.
Experimente aumentar a parcela de inválidos e veja com que rapidez as horas se acumulam. Depois reduza os minutos por relatório para 15, como uma ideia aproximada do que uma prova funcionando poderia te poupar (o número é uma ilustração, não uma medição). Essa diferença é o argumento para exigir reproducers, tanto de ferramentas de IA quanto de humanos.
Alguns hábitos ajudam quando os relatórios começam a chegar. O gráfico abaixo resume.
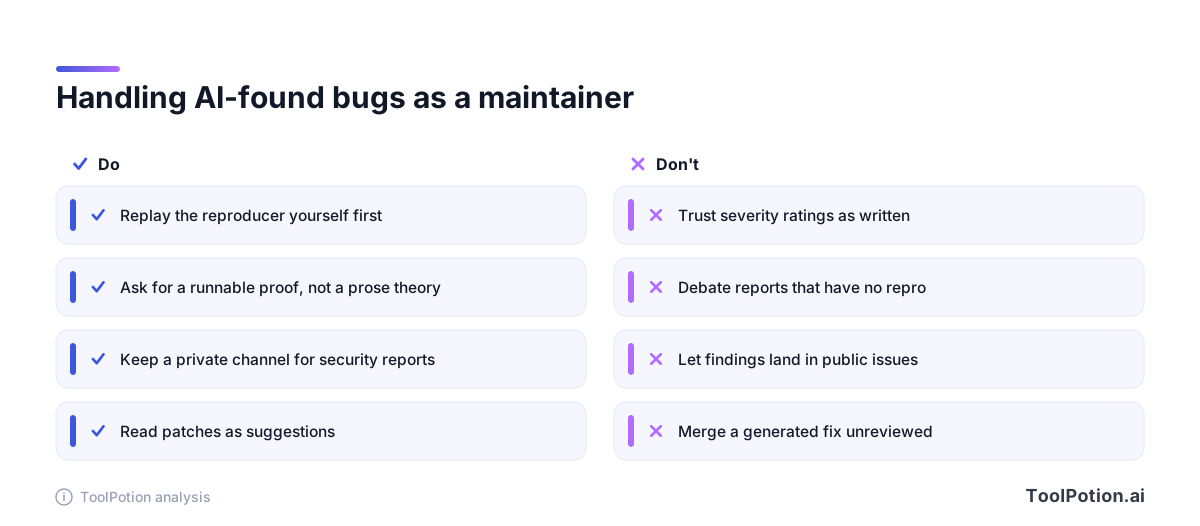
O primeiro par merece ser repetido. As classificações de severidade vêm de um modelo, e a própria Anthropic avisa que podem estar erradas (SiliconANGLE). Classifique você mesmo depois de reproduzir. Um assistente no estilo do Claude Code pode ajudar a escrever a correção e o teste de regressão depois que você decidir que o bug é real, mas a decisão continua sendo sua. Para mais contexto sobre esse tipo de ferramenta, veja nosso ranking de assistentes de código e o guia de ferramentas de revisão de código com IA.
Onde essas ferramentas ainda falham
Elas vão bem em classes de bugs que deixam rastro no código: erros de memória, injeção, verificações ausentes. São mais fracas em falhas que dependem de como o negócio realmente funciona, como quem deveria poder aprovar o quê. Um scanner não conhece a sua intenção.
Elas também não substituem o resto da segurança. O CodeMender, do Google, mantém humanos revisando os patches antes de irem para o upstream (Google DeepMind), e o GitHub diz que o Autofix funciona com o melhor esforço possível e não consegue confirmar que uma correção resolve alertas de queries personalizadas (GitHub). Os fornecedores com mais a ganhar ainda mandam você conferir a saída.
O limite honesto é o volume. Encontrar bugs está ficando mais barato mais rápido do que corrigi-los. Um scanner que entrega quarenta achados reais a um projeto de três pessoas criou um backlog, não um produto mais seguro. Escolha as ferramentas pelo quanto você consegue corrigir em um mês, não pelo quanto elas conseguem encontrar.
Perguntas frequentes
O OSS Scanner da Anthropic está aberto a qualquer repositório do GitHub?
Não. Ele é opcional e avaliado caso a caso, com critérios parecidos com os do OSS-Fuzz, então os projetos precisam ter impacto crítico na infraestrutura e na segurança dos usuários. Os mantenedores se candidatam por meio de um pull request no repositório da Anthropic no GitHub.
Scanners de IA substituem um teste de intrusão?
Não para algo que importe para os seus clientes. Eles cobrem bem bugs no nível do código e mal as falhas de lógica de negócio. Trate-os como uma camada extra que roda o tempo todo, junto com uma revisão humana de vez em quando.
Posso usar o Claude ou o Gemini diretamente para auditar meu código?
Você pode colar código no Claude ou no Google Gemini e pedir uma revisão de segurança. Ajuda para uma função isolada. Mas não terá o sandbox, o modelo de ameaças do repositório inteiro nem a verificação de exploit que os agentes dedicados acima acrescentam, então espere mais alarmes falsos.
O que fazer se eu receber um relatório escrito por IA que parece falso?
Peça um reproducer contra uma versão específica. Um achado real consegue responder a isso. Um fabricado muitas vezes não consegue. Se alguém continuar mandando, você pode fechar o relatório e seguir em frente.
É seguro rodar scanners gratuitos em código privado?
Leia os termos de cada um. Alguns rodam inteiramente na sua máquina, e outros enviam trechos de arquivos para um modelo hospedado. Confira o que o fornecedor armazena e por quanto tempo antes de conectar um repositório privado.