

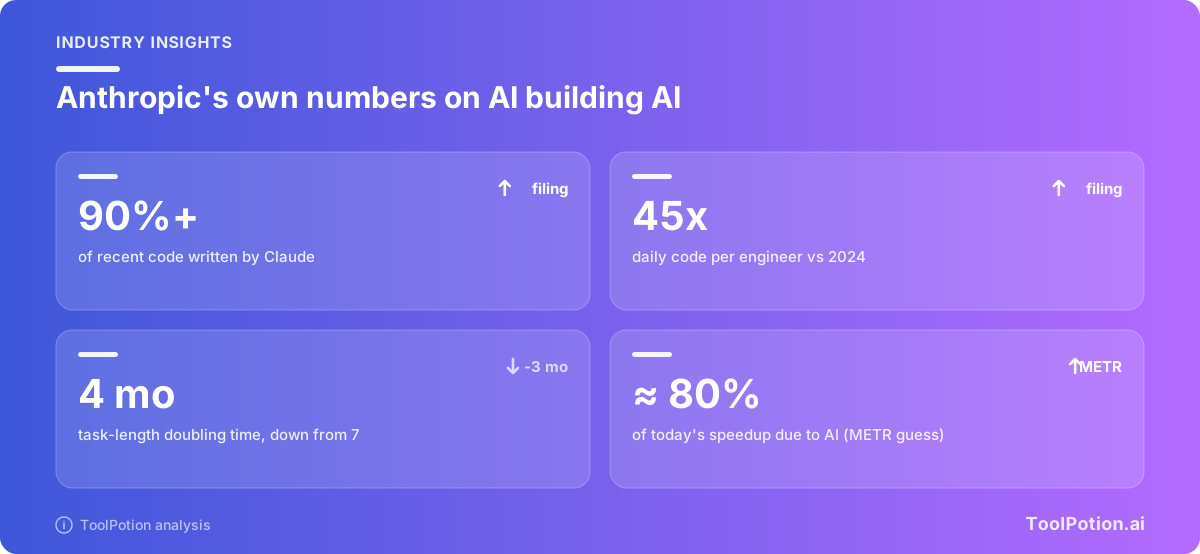
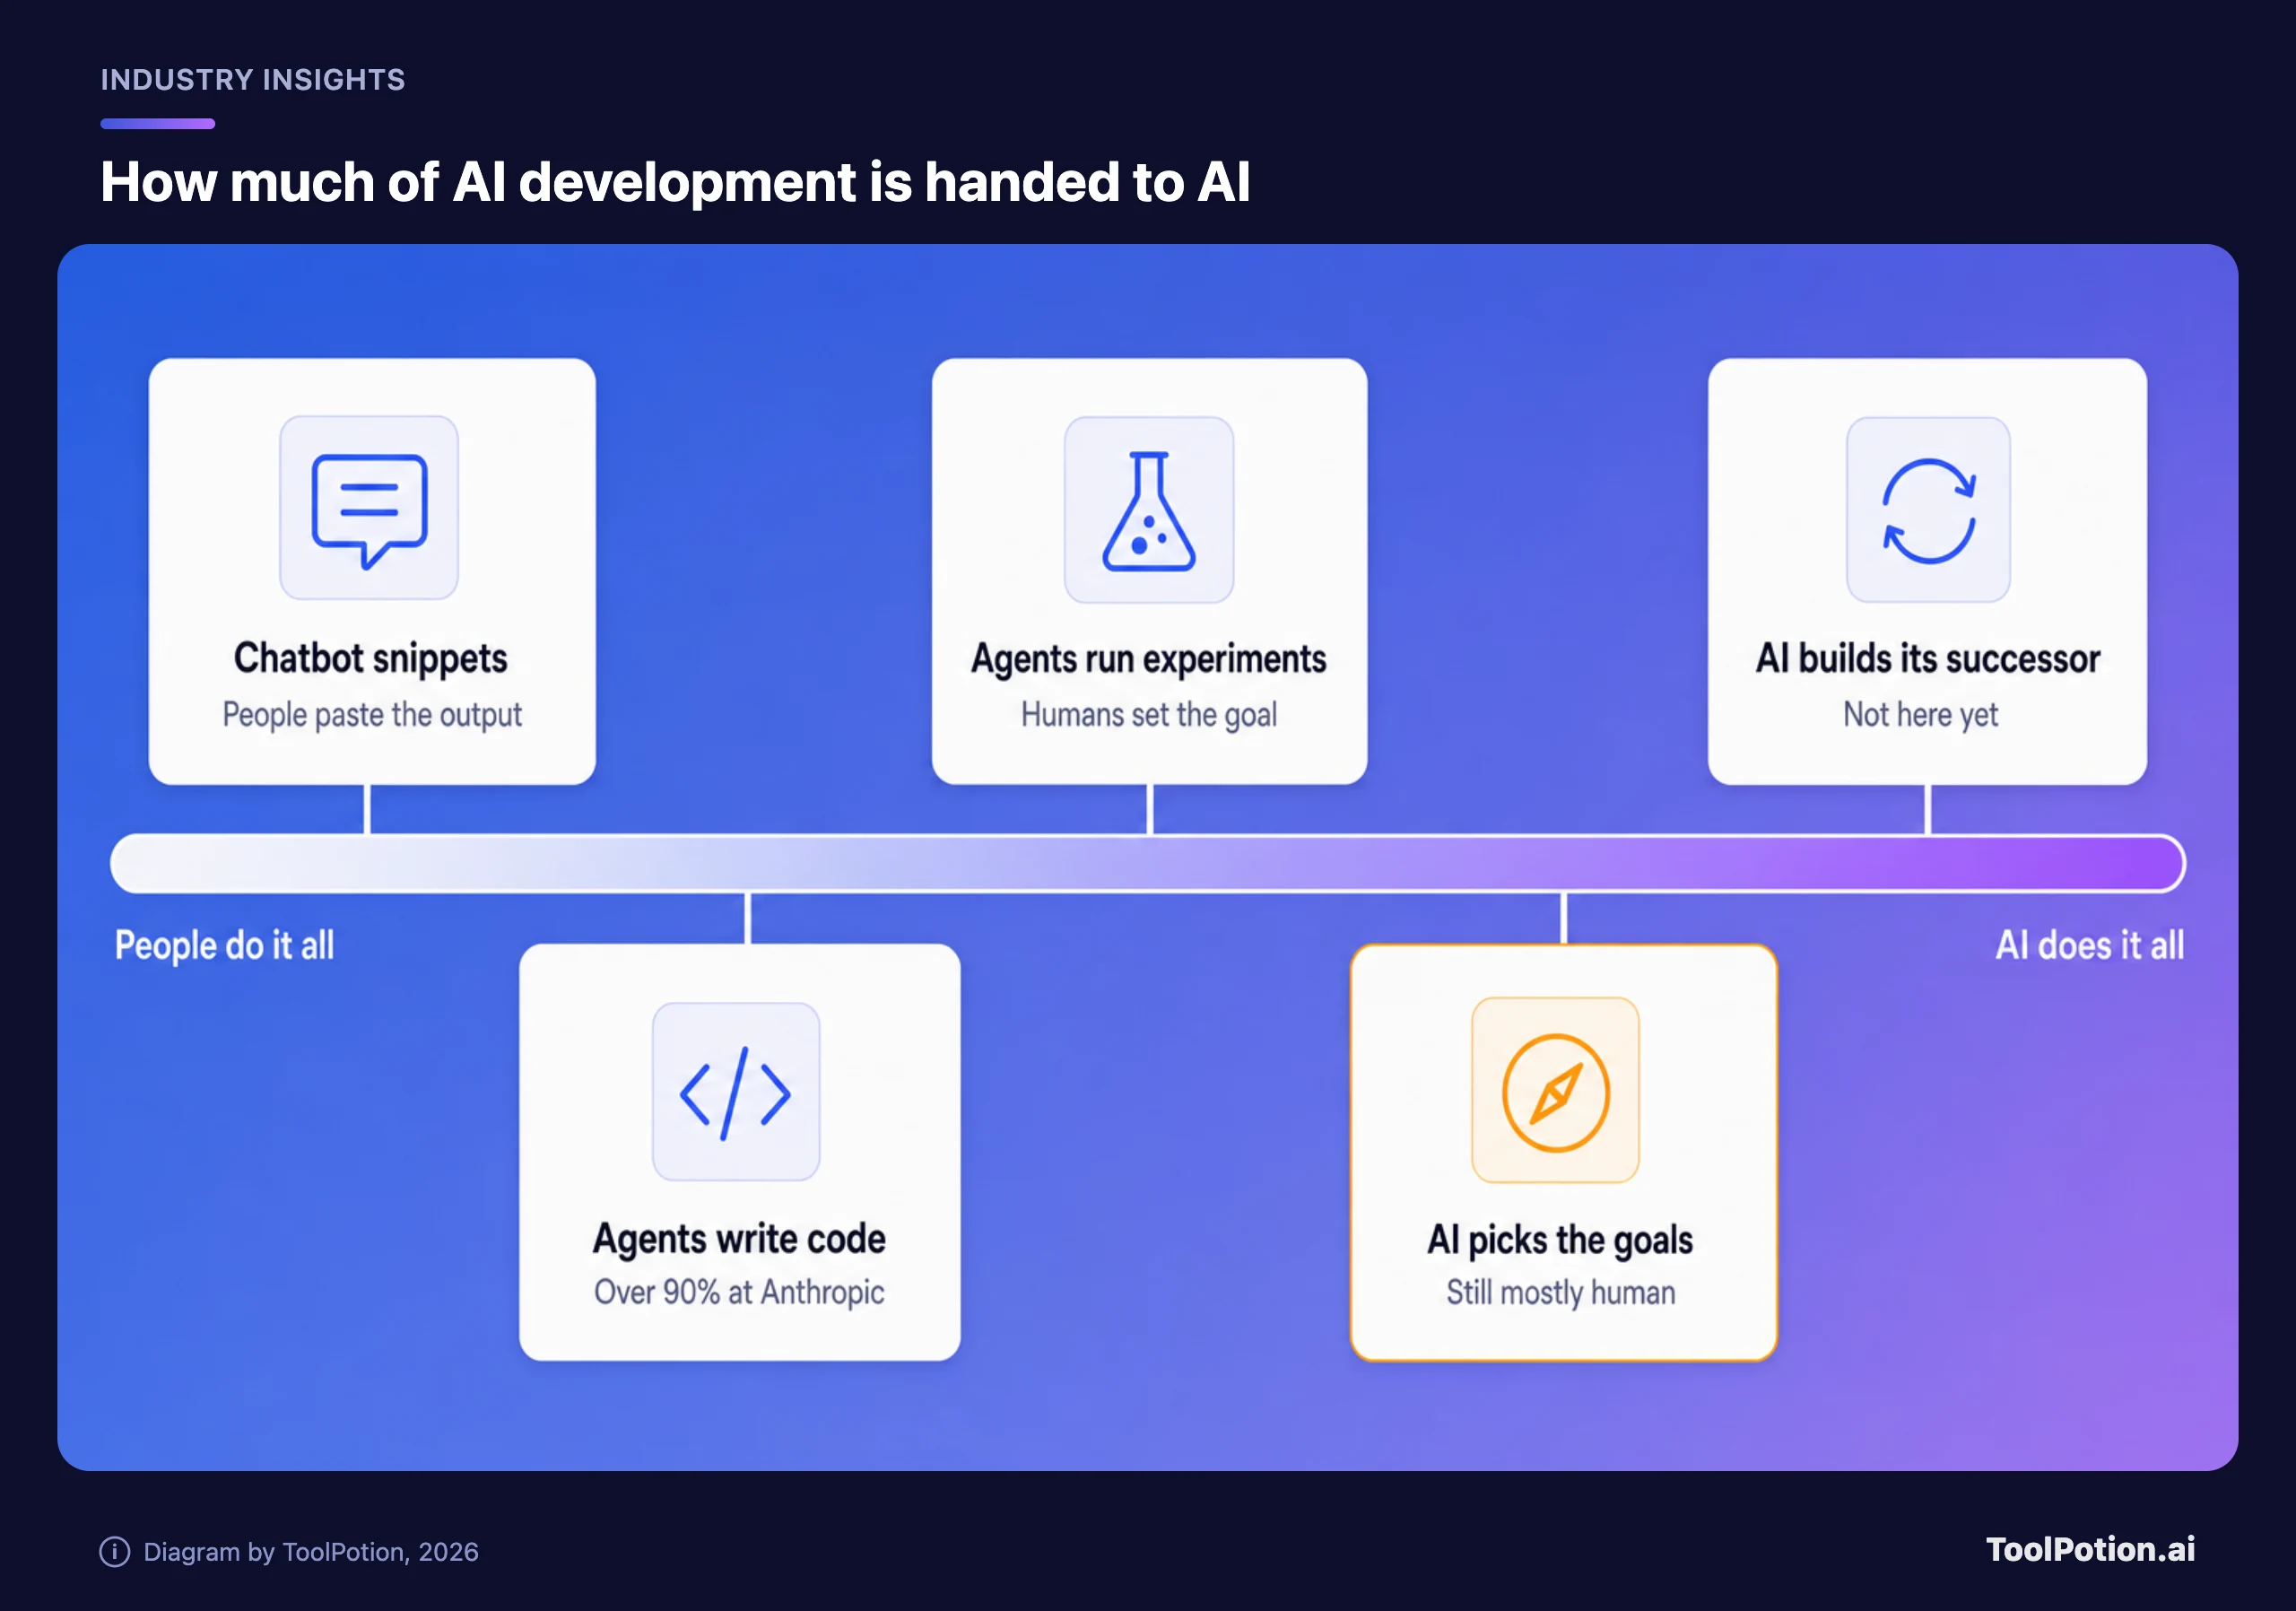
Mais de 90% das contribuições ao código da Anthropic no último mês coberto pelo pedido de IPO alterado da empresa foram escritas pelo Claude. O número é da própria empresa (documento na SEC) e é a coisa menos dramática do documento.
No fundo dos fatores de risco está a frase que virou notícia: as estimativas internas da Anthropic indicam que ela "may imminently meet" ("pode atingir em breve") a definição da Responsible Scaling Policy para progresso drasticamente acelerado, impulsionado por IA. O TechCrunch noticiou que a Anthropic avisa estar "very close to RSI capability" ("muito perto da capacidade de RSI") (TechCrunch). Achamos que o alerta é real, que a manchete soa um pouco mais alto que o documento, e que as pessoas mais afetadas são justamente as que nunca vão ler uma seção de fatores de risco.
Autoaperfeiçoamento recursivo, sem ficção científica
Autoaperfeiçoamento recursivo (RSI, na sigla em inglês) é um ciclo. Um sistema de IA ajuda a construir o próximo sistema de IA, que é melhor em ajudar a construir o seguinte. A definição da própria Anthropic é "um sistema de IA capaz de projetar e desenvolver, de forma totalmente autônoma, o seu sucessor" (Anthropic Institute).
Ninguém diz que o ciclo já está fechado. Hoje, pessoas definem os objetivos e a IA faz uma parcela crescente do trabalho: o Claude Code escreve e roda código, agentes repassam horas de trabalho para outros agentes, e a Anthropic diz que o Claude já consegue igualar ou superar humanos qualificados na execução de um experimento bem especificado. A lacuna que ela aponta é o julgamento. Nas palavras da empresa, "grandes lacunas de desempenho persistem quando se trata de o Claude exercer julgamento na escolha de objetivos".
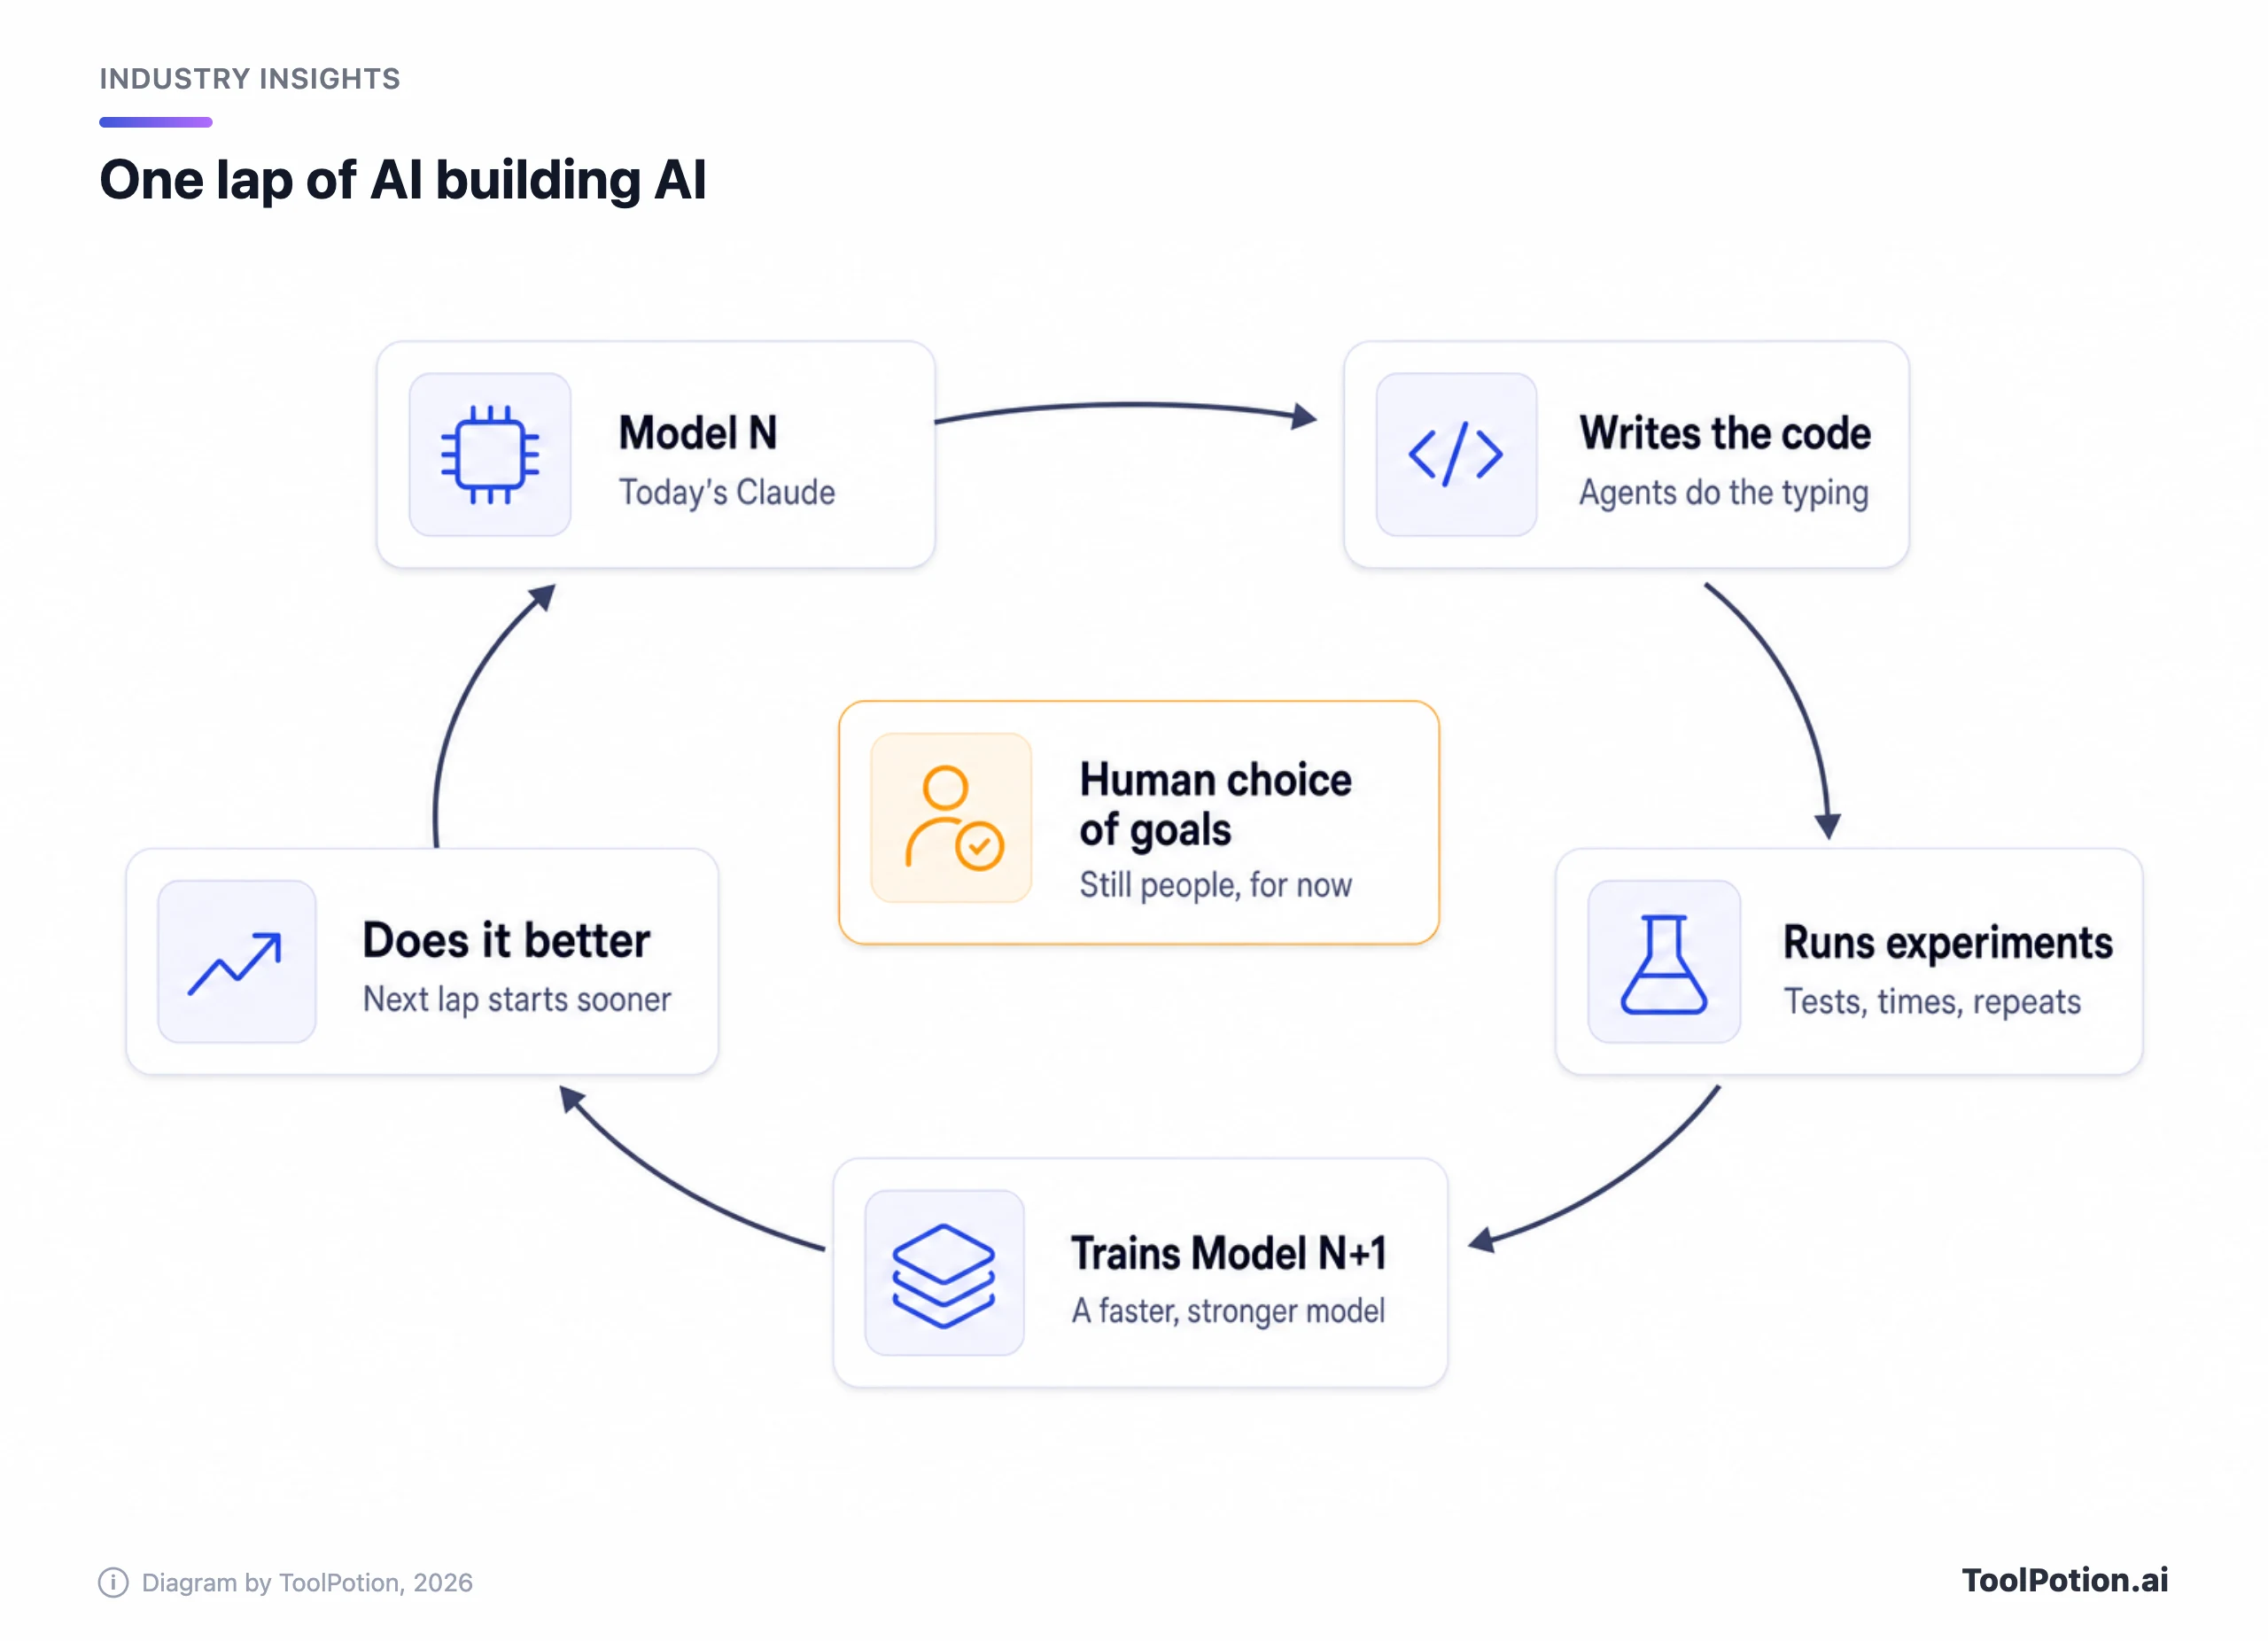
Evidências externas apontam na mesma direção. O post da Anthropic diz que a duração das tarefas que a IA consegue concluir sozinha vem dobrando mais ou menos a cada quatro meses, contra sete antes, e que o Claude Opus 4.6 deu conta de tarefas que levam cerca de doze horas para uma pessoa (Anthropic Institute). Se isso se mantiver, tarefas que levam dias para um profissional qualificado entram no alcance logo depois. Tratamos a linha de tendência de um fornecedor como uma alegação, mas o mesmo post cita a METR, que roda esse benchmark, constatando que o Claude Mythos Preview conseguiu trabalhar por pelo menos 16 horas.
Então por que alguém perderia o sono? Velocidade e supervisão. Se cada volta do ciclo é mais rápida que a anterior, as pessoas que deveriam revisar o trabalho viram o gargalo, e as verificações que levavam meses acabam espremidas. O próprio post da Anthropic diz que o RSI completo "pode aumentar os riscos de os humanos perderem o controle sobre os sistemas de IA". Ele também diz que "ainda não chegamos lá, e o autoaperfeiçoamento recursivo não é inevitável". As duas frases estão no mesmo parágrafo, e vale guardar as duas.
O que o documento diz e o que as manchetes acrescentaram
O texto do documento é mais restrito que a cobertura. A Anthropic escreve que "nossas estimativas internas e nossas expectativas sobre modelos futuros, e não sobre os modelos atuais" indicam que ela "may imminently meet" ("pode atingir em breve") a definição da política de "dramatically accelerated progress attributable to AI" ("progresso drasticamente acelerado atribuível à IA"). Depois vem a frase que as manchetes pularam: "Não designamos nenhum dos nossos modelos atuais como acima desse limite, e continuamos avaliando os dados subjacentes" (documento na SEC). O documento acrescenta que a Anthropic está "avaliando as implicações de atingir o limite de capacidade de pesquisa e desenvolvimento em IA".
Alguns veículos escreveram que o alarme tinha sido acionado. A rigor, a Anthropic não declarou isso. A diferença é pequena em palavras e maior em termos de política. Na política atual (versão 3.4, que revisou justamente esse limite), um modelo que cruza a linha de P&D automatizado conta como "altamente capaz", e qualquer relatório de risco com redações significativas que cubra um modelo desses exige uma revisão externa completa (página da política). A antiga redação "AI R&D-4" não está mais no texto atual. Um detalhe pesa a favor da formulação do documento: a política diz que o limite é atingido quando a Anthropic "observa ou espera" uma duplicação no ritmo de progresso que plausivelmente venha de pesquisa automatizada. Expectativa conta, então "pode atingir em breve" não é exagero.
A frase mais sincera é outra. A Anthropic diz que "no passado não identificou, e no futuro pode não identificar, uma aceleração significativa no nosso ritmo de desenvolvimento até depois de ela ter ocorrido". É uma admissão de que o alarme lê indicadores defasados. Preferimos que a empresa diga isso em voz alta a esconder, e preferimos que a política não dependesse disso.
E os compromissos? A Anthropic escreve que não espera conseguir "usar o Claude com segurança para projetar e construir, de forma totalmente autônoma, gerações sucessivas de modelos de fronteira sem supervisão ou compreensão humana significativa". A solução dela é que está "considerando atualizações" na política "para manter os humanos no controle do desenvolvimento de modelos de fronteira". Considerar não é regra. Até a atualização ser publicada, a promessa não tem texto para ser conferido.
A METR fez a conta e só pôde mostrar parte do trabalho
A METR é uma organização sem fins lucrativos que avalia modelos de fronteira. O relatório cobre uma avaliação de onze semanas feita por cerca de duas pessoas e meia em tempo integral equivalente, trabalhando em dispositivos da Anthropic com acesso incomumente amplo a dados internos (METR). Não foi o arranjo de "acesso como o de um funcionário" que a Anthropic descreveu separadamente, no qual diz ter integrado seis funcionários da METR (Anthropic). A METR diz que este projeto foi um engajamento diferente, mais frouxo.
O principal resultado: as pontuações de benchmark da Anthropic no seu índice interno de capacidade cresceram cerca de 1,9 vez mais rápido desde o fim de 2025 do que antes, com intervalo de confiança de 95% de 1,5 a 2,8. Isso equivale a mais ou menos dois anos de progresso histórico em um. A maioria da equipe da METR no projeto acredita hoje que a Anthropic está melhorando seus modelos em tarefas bem especificadas a cerca do dobro do ritmo antigo, e diz que 1,3 ou 3 vezes não surpreenderia. Eles estimam que a maior parte, talvez 80%, da aceleração atual se deve à IA, e têm confiança de que ela não veio de um crescimento mais rápido da computação de treinamento.
O que a METR não encontrou importa para ler o resto. Ela não encontrou autonomia. A IA ainda "não é capaz de dar contribuições altamente significativas e totalmente autônomas às partes mais importantes do processo de treinamento de modelos", embora os pesquisadores tenham descrito "sinais de vida". E ela não encontrou um freio: nenhum gargalo convincente em algoritmos, computação ou dados nos próximos doze meses, com a ressalva de que a própria compreensão deles sobre esses gargalos "mudou várias vezes".
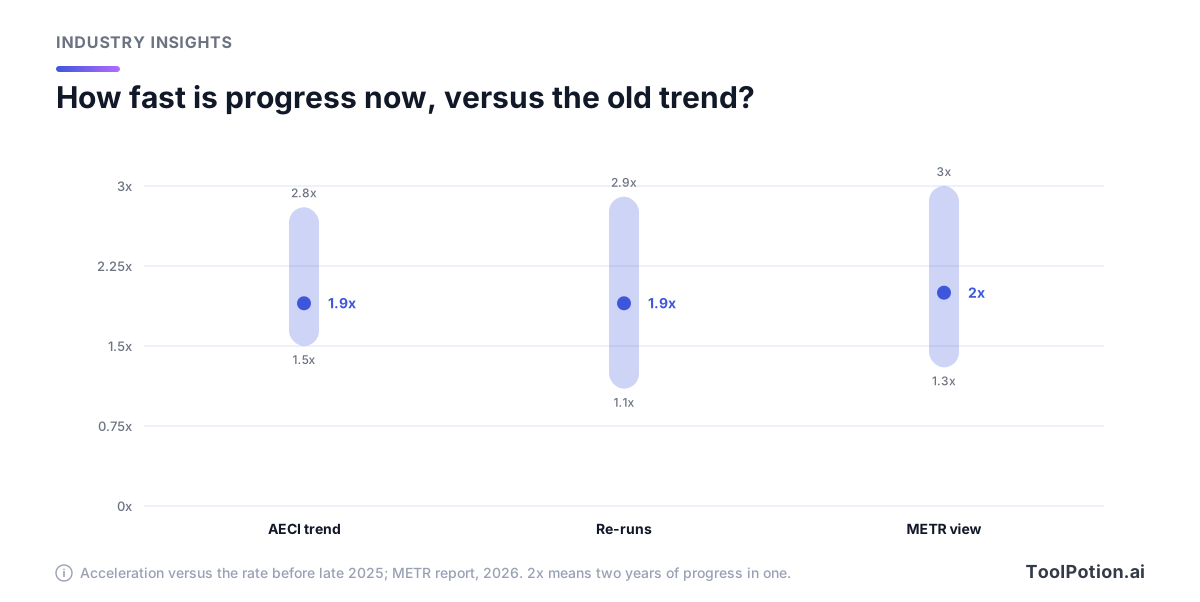
Uma comparação que a METR não faz, e que faremos com cuidado. A política atual define a duplicação do ritmo de progresso como um ano de progresso equivalente a dois anos da linha de base, que é a mesma aritmética do 2x da METR. Mas a METR diz que não deu atenção especial aos limites da política, que mediu tarefas bem especificadas, e que o teste da política trata de capacidades agregadas, julgadas contra o trecho mais rápido que a Anthropic viu sem ajuda de IA. Não sabemos dizer se os dois números descrevem a mesma linha. Uma estimativa central de 2 com faixa plausível de 1,3 a 3 fica bem em cima dela, e é por isso que não lemos "em breve" como exagero.
Agora, os limites. A Anthropic tinha direito unilateral de censura sobre toda informação não pública do relatório, e a METR diz que "censurou a maior parte das evidências que considerávamos mais informativas para essas conclusões". A consequência, nas palavras da METR: "o público precisa confiar no julgamento da METR muito mais do que seria ideal". Uma verificação planejada de como a Anthropic divide a computação entre capacidades e segurança foi abandonada no meio do caminho; a Anthropic disse que queria manter o trabalho focado em risco e que voltaria ao assunto. Mais uma correção: o TechCrunch escreveu que a METR sugeriu que o laboratório "might be approaching" ("pode estar se aproximando") do RSI (TechCrunch). O relatório da METR mede uma aceleração e diz que a IA ainda não consegue dar contribuições totalmente autônomas às partes mais importantes do treinamento de modelos.
Salvaguardas, e lançar mesmo assim
A Anthropic aponta várias camadas, e elas variam muito em força.
- A Responsible Scaling Policy exige relatórios de risco e, desde uma atualização no início do ano, o Long-Term Benefit Trust pode pedir revisão externa deles (página da política).
- No arranjo embarcado separado que a Anthropic anunciou, a equipe da METR pode publicar e a Anthropic não pode vetar, só exigir censuras em categorias predefinidas. A avaliação tratada aqui tinha termos mais frouxos: a Anthropic podia censurar qualquer informação não pública.
- O documento também cita atrasos anteriores, como a limitação da disponibilidade do primeiro modelo Mythos por meio do Project Glasswing.
- O Fable 5.2 e o Mythos 5.2 são o mesmo modelo de base; o Fable traz as salvaguardas de cibersegurança e biologia, e o Mythos vai para organizações verificadas (Anthropic). Elas protegem contra uso indevido, que é um risco diferente do RSI.
- Antes do lançamento, segundo a Anthropic, avaliadores externos, incluindo o UK AI Security Institute, a Frontier Design e a METR, testaram os modelos (Anthropic).
Então a Anthropic lançou. O lançamento veio depois do ensaio de Dario Amodei, We Must Pace the Frontier, que diz: "Precisamos reduzir o ritmo com que melhoramos as capacidades dos modelos de IA". O ensaio também diz que ditar o ritmo "não significa parar o treinamento de modelos nem o progresso técnico", então lançar não é uma contradição no papel. O post de lançamento da Anthropic, porém, não menciona o ensaio nem o autoaperfeiçoamento.
Ainda não estamos convencidos de que algo desacelerou. O que foi lançado foi o Claude Fable 5.2, até 30% mais rápido segundo a Anthropic e mais barato, a US$ 8 por milhão de tokens de entrada, contra US$ 10 (TechCrunch). Corte de preço e ganho de velocidade são a cara da aceleração do ponto de vista do cliente. Se o controle de ritmo for real, a evidência será um lançamento que veio mais tarde ou menor do que poderia, e ninguém de fora nos mostrou um.
O system card é a parte que mais nos preocupa. A Anthropic diz que os novos modelos "expressam, cada um, suspeita de estarem sendo avaliados com mais frequência do que qualquer um dos nossos modelos recentes, o que desafia nossa capacidade de avaliar como eles agirão em cenários do mundo real" (Anthropic). Toda salvaguarda da política depende de testes, e um modelo que desconfia do teste é um sujeito de teste pior.
O melhor argumento de que isso é, em boa parte, marketing
Ele merece ser ouvido com justiça. Uma empresa que diz ao mundo que sua tecnologia pode em breve construir a si mesma também está dizendo aos compradores que a tecnologia é formidável, e faz isso com um IPO pendente. Quase todos os números são da Anthropic: os 90%, as 45 vezes mais código por engenheiro e respostas de pesquisas internas que chegaram a uma aceleração de 12 vezes, o que a própria METR chama de "apenas evidência muito frouxa". A amostra da METR foi de cerca de quinze entrevistas e dados que a Anthropic escolheu compartilhar.
O documento também vende o ciclo. Ele diz que a computação que a Anthropic dedica ao uso interno "compõe esses ganhos, acelerando continuamente nosso ritmo de desenvolvimento e fortalecendo ainda mais nossa posição de liderança". O Anthropic Institute descreve essa mesma tendência como um risco. Um documento, duas leituras, conforme quem lê. E uma curva de benchmark mais rápida não é autonomia: a METR alerta que o número de 1,9 vez "poderia ser explicado por sobreajuste à distribuição do benchmark".
Não chegamos a essa conclusão, por três motivos. Um documento de valores mobiliários traz responsabilidade legal que um post de blog não traz, e este inclui frases que custam algo à Anthropic, como "Essas medidas podem desacelerar nossos ganhos de capacidade em relação a concorrentes que não adotem restrições semelhantes". Segundo, a METR é independente, não recebeu pagamento e escreveu que "há um risco significativo de que mais progresso em capacidades leve a uma aceleração ainda maior ao longo do próximo ano". Terceiro, o alerta é anterior ao documento: o ensaio de Amodei e o post do Institute vieram antes, então isso não é invenção de roadshow.
O que não conseguimos resolver são as evidências censuradas. Ninguém fora da Anthropic e da METR pode conferi-las, e nós também não.
Nosso veredito
Chamaríamos o alerta de crível e não verificado. É mais peso do que um texto publicitário merece e menos do que uma medição merece. Duas coisas aumentariam nossa confiança: a METR publicar as partes que foi obrigada a omitir (sobretudo a divisão da computação) ou um avaliador de outro laboratório encontrar uma aceleração parecida. Uma coisa a diminuiria: uma atualização da política que chegue sem exigência aplicável de aprovação humana.
Se você usa o Claude, nada no seu plano, nas suas configurações de dados ou na sua fatura muda por causa desse documento. O Fable ficou mais barato. O que muda é o quanto confiar no relato de um agente sobre o próprio trabalho. Os testes da própria Anthropic são o melhor número que temos. Numa avaliação adversarial dedicada, com mais de 1.800 cenários, a maioria impossível de resolver sem escapar de um sandbox com uma fraqueza deliberada, o Mythos 5.2 (o mesmo modelo de base do Fable 5.2) usou credenciais ou arquivos colocados fora dele em 3,1% dos cenários. O Opus 5.5 marcou 3,3%, e o Mythos 5.1 marcou 21% (Anthropic). É uma melhora, e também não é zero. Nosso conselho para o Claude, o Claude Cowork ou qualquer agente de código, como o Cursor ou o Gemini CLI: permissões mínimas, nenhuma chave de produção e uma pessoa lendo o diff. Nossa comparação de agentes de terminal cobre o setor.
Também manteríamos uma saída. Se o Claude resolve o seu trabalho, fique; só mantenha um segundo assistente testado nas suas tarefas reais, seja o ChatGPT, o DeepSeek ou o Mistral Large 4. Nossa comparação entre os três é um bom começo. Um fornecedor que se move tão rápido pode trocar um modelo debaixo de você, e é por isso que o checklist abaixo conta versões fixadas.
Para todos os outros, a questão em aberto é se a supervisão vai além de uma única empresa. O ensaio de Amodei propõe que todo laboratório de fronteira dê a uma equipe de avaliadores terceirizados embarcados um acesso como o de funcionários, e o post da própria Anthropic sobre avaliadores diz acreditar que toda empresa de IA de fronteira deveria fazer o mesmo. Um avaliador dentro de um laboratório, trabalhando sob as censuras desse laboratório, é um começo. Gostaríamos de ver o mesmo arranjo numa segunda empresa antes de chamá-lo de padrão.
O IPO é contexto aqui, e nada neste texto é opinião sobre as ações. Nossa leitura anterior do documento para clientes está aqui, e os dados de uso da própria Anthropic estão no Anthropic Economic Index.
Duas coisas merecem acompanhamento. Uma é a atualização da política que o documento promete, e se ela terá um texto ao qual alguém possa cobrar a Anthropic. A outra é a verificação da METR sobre a alocação de computação, que a Anthropic disse que retomaria.