Descrição
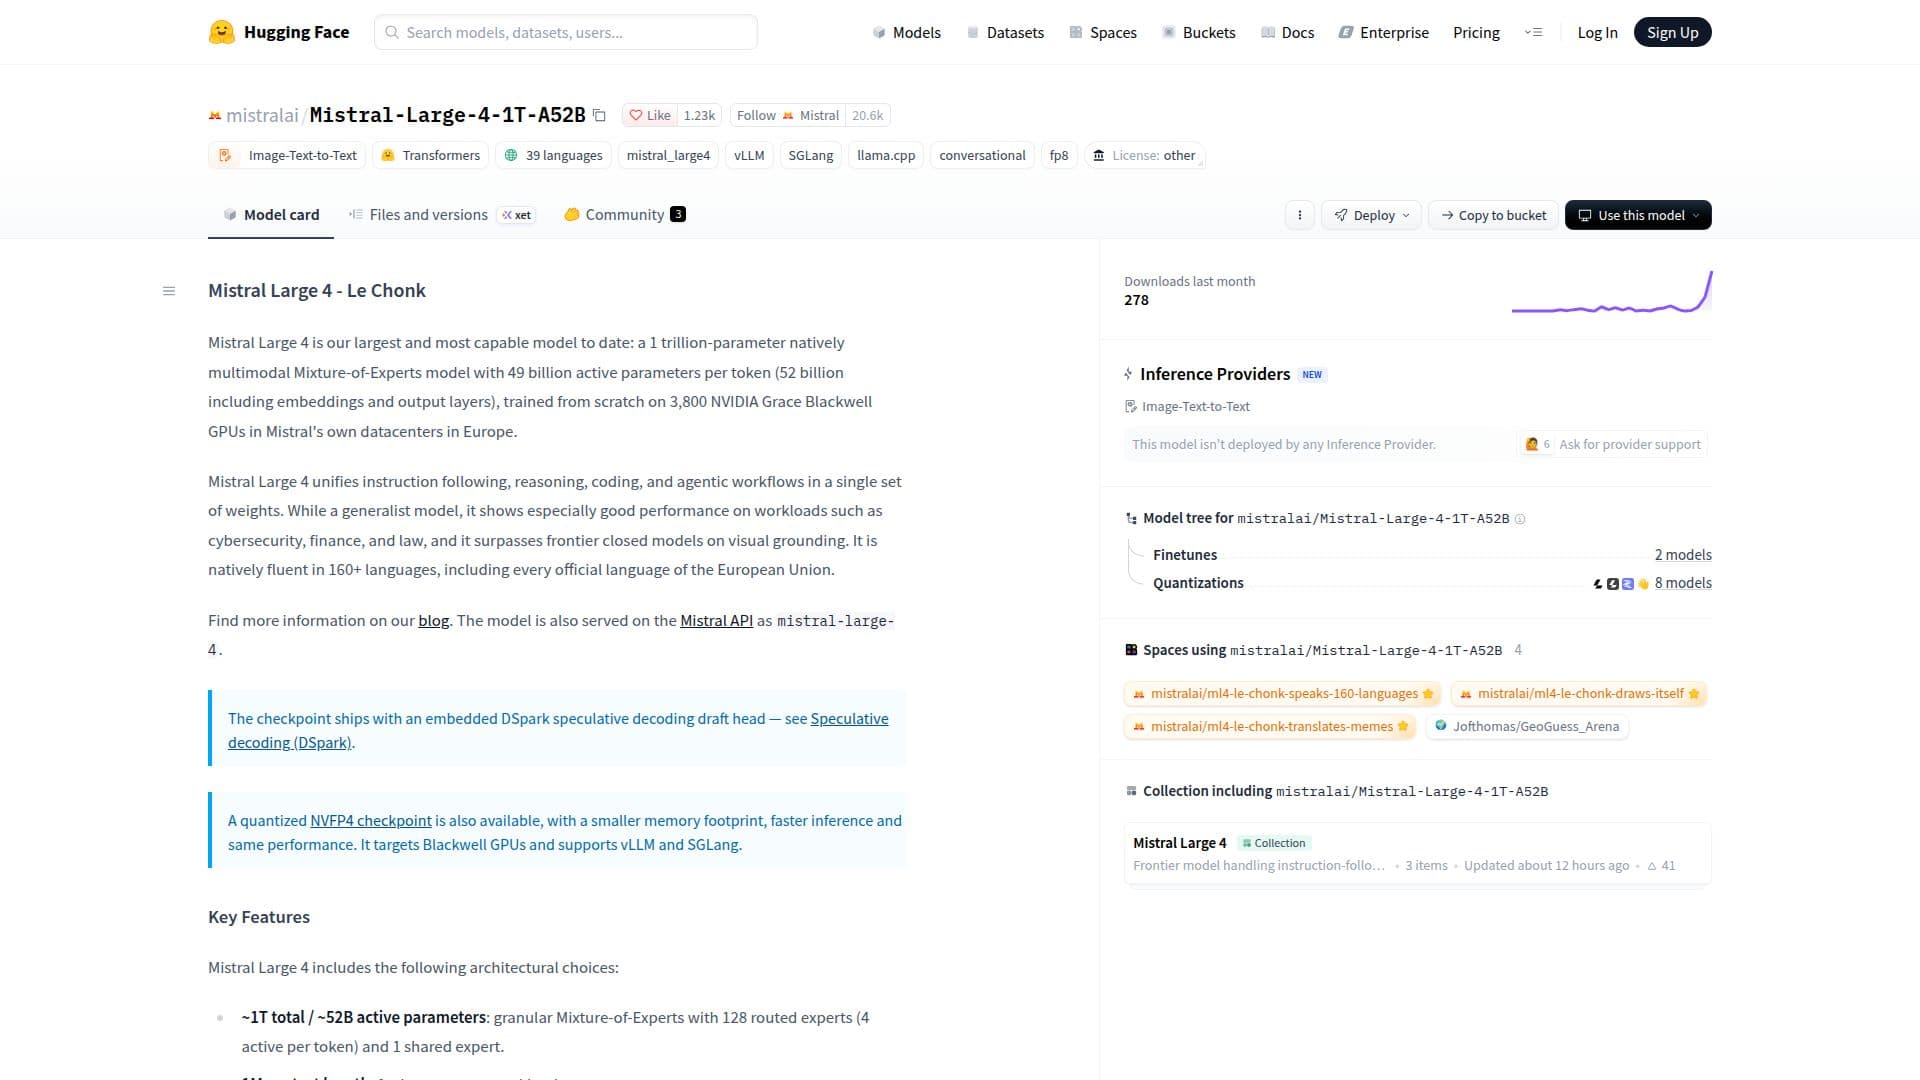
Mistral Large 4, também conhecido como "Le Chonk," representa o modelo mais avançado e capaz da Mistral até o momento. É um modelo Mixture-of-Experts nativamente multimodal com 1 trilhão de parâmetros, apresentando 49 bilhões de parâmetros ativos por token (52 bilhões incluindo embeddings e camadas de saída). O modelo foi treinado do zero em 3.800 GPUs NVIDIA Grace Blackwell nos datacenters europeus da Mistral, garantindo desempenho robusto e escalabilidade.
Ler mais
Este modelo generalista unifica seguir instruções, raciocínio, codificação e fluxos de trabalho agentes em um único conjunto de pesos. Embora seja versátil em muitos domínios, o Mistral Large 4 demonstra desempenho excepcional em áreas especializadas, como cibersegurança, finanças e direito. Ele também supera modelos fechados de fronteira em capacidades de ancoragem visual, tornando-o altamente eficaz para tarefas que envolvem análise de imagens.
Uma das principais forças do Mistral Large 4 é sua fluência nativa em mais de 160 idiomas, abrangendo todos os idiomas oficiais da União Europeia. Esse amplo suporte linguístico torna-o uma ferramenta poderosa para aplicações globais. O modelo possui um comprimento de contexto substancial de 1M, permitindo que ele lide com cargas de trabalho de longo contexto de forma eficiente. Sua capacidade de entrada multimodal permite que aceite tanto entradas de texto quanto de imagem, gerando saídas de texto.
Arquitetonicamente, o Mistral Large 4 utiliza um design granular de Mixture-of-Experts com 128 especialistas roteados, onde 4 especialistas estão ativos por token, além de 1 especialista compartilhado. Ele também inclui uma cabeça de rascunho de decodificação especulativa DSpark embutida, que pode acelerar significativamente a decodificação sem alterar as saídas do modelo alvo, oferecendo até 1,9x maior taxa de transferência em certos cenários. Um ponto de verificação NVFP4 quantizado também está disponível, proporcionando uma menor pegada de memória, inferência mais rápida e desempenho equivalente, especificamente direcionado para GPUs Blackwell e suportando vLLM e SGLang.
O Mistral Large 4 é lançado sob a Licença de Peso Aberto do Ecossistema Mistral, uma licença MIT modificada que permite uso comercial e não comercial. No entanto, operar um negócio de Modelo como Serviço com o Mistral Large 4 requer uma licença comercial separada da Mistral. O modelo está disponível na API Mistral como `mistral-large-4` e pode ser implantado e ajustado usando várias bibliotecas, como vLLM, SGLang, Transformers, llama.cpp, Axolotl, Unsloth e TRL.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de Mistral Large 4
1 Trilhão de Parâmetros Totais
52 Bilhões de Parâmetros Ativos por Token
Entrada Nativamente Multimodal (Texto e Imagem)
1 Milhão de Comprimento de Contexto
Suporte Multilíngue (mais de 160 idiomas)
Modo de Raciocínio Configurável (Baixo, Médio, Alto)
Capacidades Avançadas de Visão para Análise de Imagens
Forte Adesão a Prompts de Sistema
Chamada de Função Nativa e Saída JSON
Aplicação Estrita de Esquema JSON
Desempenho de Cibersegurança de Última Geração
Cabeça de Rascunho de Decodificação Especulativa DSpark Embutida
Ponto de Verificação NVFP4 Quantizado Disponível
Licença de Peso Aberto para Uso Comercial e Não Comercial
Primeiros passos com Mistral Large 4
Acessar o Modelo: Encontre o Mistral Large 4 no Hugging Face ou via a API Mistral.
Implantar com vLLM: Use a imagem Docker oficial do vLLM para inferência pronta para produção, configurando parâmetros como `--tool-call-parser mistral` e `--reasoning-parser mistral`.
Implantar com SGLang: Utilize a imagem Docker oficial do SGLang, habilitando decodificação especulativa com `--speculative-algorithm DSPARK`.
Implantar com Transformers: Instale o Transformers a partir do repositório principal e use o trecho de inferência em Python fornecido para implantação em várias GPUs.
Ajustar o Modelo: Use bibliotecas como Axolotl, Unsloth ou TRL para ajustar o Mistral Large 4.
Integrar com Mistral Vibe: Instale o Mistral Vibe e configure-o para usar o Mistral Large 4 via a API Mistral ou um servidor local vLLM.
Configurar Esforço de Raciocínio: Defina `reasoning_effort` como 'baixo', 'médio' ou 'alto' com base na complexidade do prompt.
Utilizar Prompts de Sistema: Defina ambientes e casos de uso claros com prompts de sistema para aproveitamento eficaz da ferramenta.
Casos de uso de Mistral Large 4
- Fluxos de Trabalho Agentes Complexos
- Análise de Cibersegurança
- Modelagem e Análise Financeira
- Processamento de Documentos Legais
- Comunicação Multilíngue
- Recuperação de Informação de Longo Contexto
- Análise de Imagens e Gráficos
- Geração e Depuração de Código
- Seguir Instruções e Automação
- Chatbot e IA Conversacional