Descrição
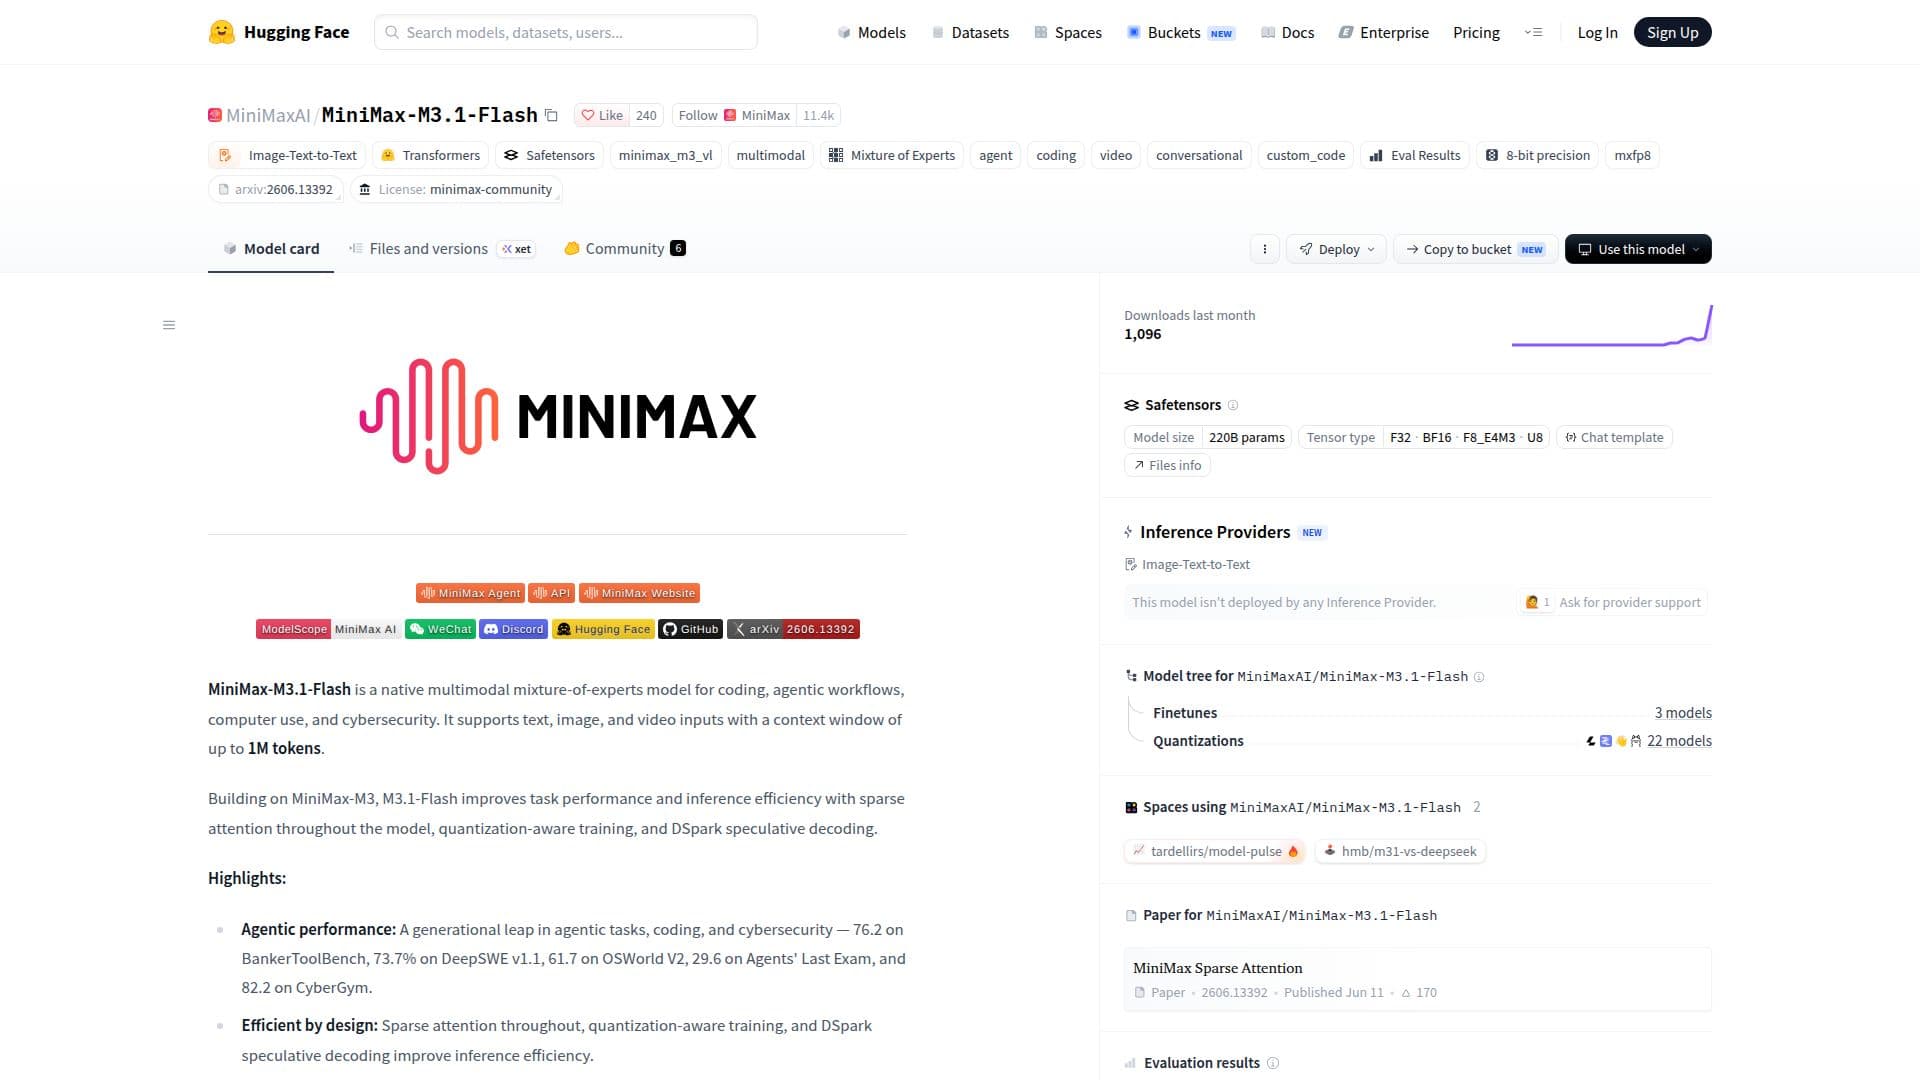
MiniMax-M3.1-Flash é um modelo avançado de mistura de especialistas multimodal desenvolvido para aprimorar a codificação, fluxos de trabalho agentes, uso de computadores e cibersegurança. Este modelo suporta entradas de texto, imagem e vídeo, fornecendo uma janela de contexto de até 1 milhão de tokens. Baseando-se na arquitetura MiniMax-M3, o M3.1-Flash introduz melhorias no desempenho das tarefas e na eficiência da inferência por meio do uso de atenção esparsa em todo o modelo, treinamento consciente de quantização e decodificação especulativa DSpark.
Ler mais
A arquitetura do modelo é projetada para lidar com uma ampla gama de entradas e saídas, com aproximadamente 428 bilhões de parâmetros, dos quais 23 bilhões são ativados por token. Isso permite um processamento eficiente e alto desempenho em vários benchmarks, incluindo uma pontuação de 76,2 no BankerToolBench e 82,2 no CyberGym.
O M3.1-Flash é particularmente notável por seu desempenho agente, oferecendo um salto geracional em tarefas relacionadas à codificação e cibersegurança. Ele alcança altas pontuações em vários benchmarks, como 73,7% no DeepSWE v1.1 e 61,7 no OSWorld V2. A eficiência do modelo é ainda aprimorada por recursos como atenção esparsa e treinamento consciente de quantização, que reduzem a pegada de memória e melhoram a eficiência de atendimento.
Para implantação, o MiniMax-M3.1-Flash suporta várias estruturas de inferência, incluindo SGLang, vLLM e TokenSpeed, com integrações adicionais em andamento. O modelo é projetado para implantação em múltiplos chips, oferecendo flexibilidade nas configurações de atendimento. Os usuários podem ajustar as configurações de inferência, como temperatura e top_p, para otimizar o desempenho em tarefas específicas.
No geral, o MiniMax-M3.1-Flash é uma ferramenta poderosa para desenvolvedores e pesquisadores que buscam aproveitar as capacidades avançadas de IA em contextos multimodais, fornecendo suporte robusto para fluxos de trabalho complexos e aplicações de cibersegurança.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de MiniMax-M3.1-Flash
Arquitetura de mistura de especialistas multimodal
Suporta entradas de texto, imagem e vídeo
Janela de contexto de até 1 milhão de tokens
Atenção esparsa em todo o modelo
Treinamento consciente de quantização
Decodificação especulativa DSpark
Aproximadamente 428 bilhões de parâmetros
Alto desempenho em múltiplos benchmarks
Primeiros passos com MiniMax-M3.1-Flash
Acesse a página do modelo: Visite a página oficial do Hugging Face para MiniMax-M3.1-Flash
Autentique-se: Certifique-se de ter as credenciais necessárias para acessar o modelo
Configure: Configure o modelo com sua estrutura de inferência preferida
Envie prompts: Insira dados de texto, imagem ou vídeo para processamento
Ajuste: Ajuste configurações como temperatura e top_p para resultados ideais
Casos de uso de MiniMax-M3.1-Flash
- Assistência em Codificação
- Cibersegurança
- Fluxos de Trabalho Agentes
- Processamento Multimodal
- Eficiência de Inferência