

Dizer que um modelo é "#1 no ranking" é verdade para um teste específico, executado de um jeito específico, em um dia específico. Isso diz bem menos sobre se esse modelo é o melhor para o seu trabalho. Antes de trocar de ferramenta ou pagar por um plano maior por causa de um ranking, descubra de qual ranking o número veio, quem o executou e o que ele mede.
Isso importa mais em 2026 porque os rankings viraram negócio. A Arena, site público de ranking antes conhecido como LMArena, levantou US$ 200 milhões com avaliação de US$ 3,1 bilhões este ano, quase o dobro dos US$ 1,7 bilhão de avaliação do início de 2026 (Phemex). A Arena diz que sua receita anualizada passou de US$ 100 milhões (Arena). Hoje todo lançamento de modelo abre com uma posição no ranking, e essa posição vende.
Nada disso significa que os rankings são falsos. A maioria foi criada por gente séria e mede algo real. O problema é que cada um mede uma coisa diferente, e o post de lançamento cita justamente aquele que favorece o modelo. Este guia explica como funcionam os principais rankings, onde cada um falha e como avaliar uma alegação em cerca de dois minutos.
Quatro tipos de ranking, quatro perguntas diferentes
A maioria dos rankings que você vai encontrar cai em um de quatro grupos. Os grupos importam mais do que qualquer ranking isolado, porque um número só tem significado quando você sabe de qual grupo ele veio.
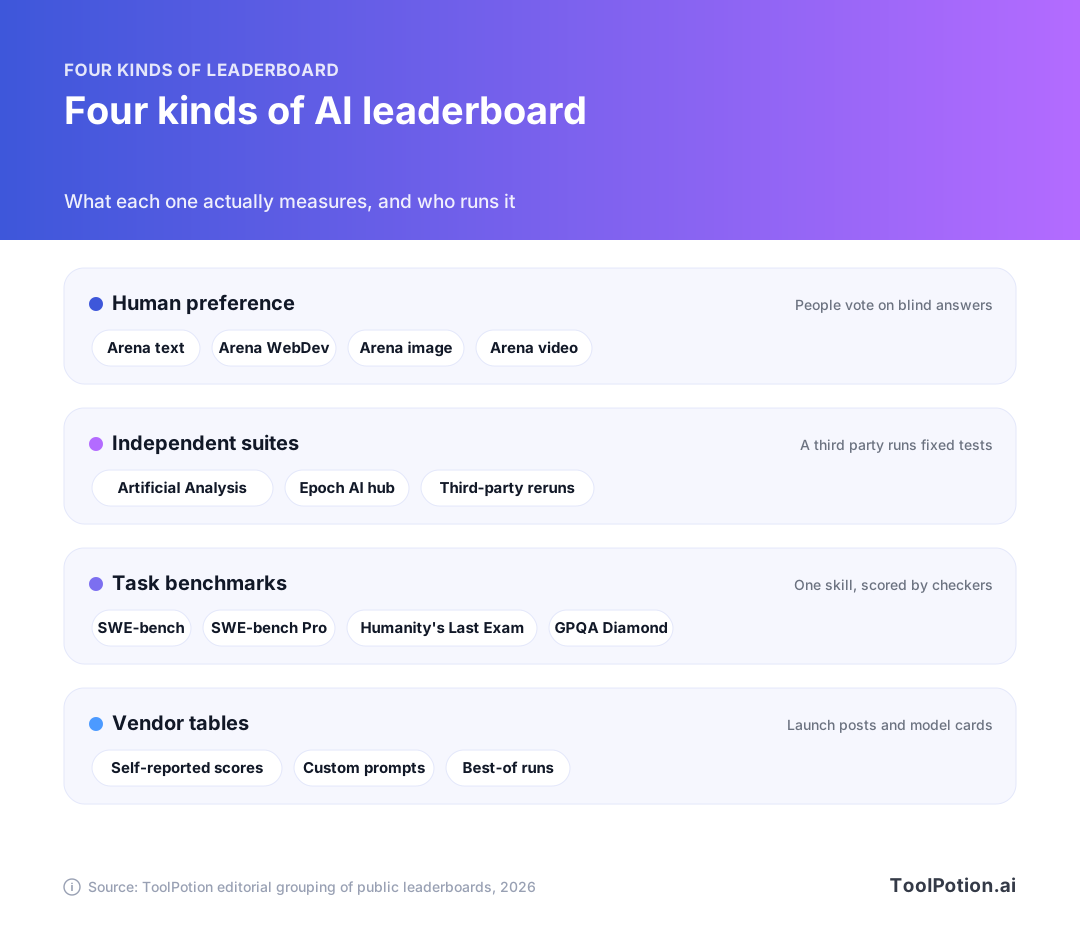
As arenas de preferência humana perguntam às pessoas qual resposta elas preferem. As suítes independentes executam um conjunto fixo de testes em todos os modelos, nas mesmas condições. Os benchmarks de tarefas verificam uma habilidade, como corrigir bugs reais de software, com um avaliador automático. As tabelas de fabricantes são as pontuações que um laboratório publica no próprio post de lançamento ou model card, em geral com configurações escolhidas por ele.
Os grupos não competem entre si; eles respondem a perguntas diferentes. A preferência mostra com qual modelo as pessoas gostam de conversar. Uma suíte mostra como os modelos se comparam quando um terceiro neutro marca o tempo. Um benchmark de tarefa mostra se o modelo consegue fazer um trabalho específico. Uma tabela de fabricante mostra o que o laboratório quer que você note.
| Tipo de ranking | Exemplo | O que mede | Principal ponto fraco |
|---|---|---|---|
| Preferência humana | Arena Text e WebDev | Qual resposta as pessoas votam | Premia estilo e tamanho, pode ser manipulado |
| Suíte independente | Artificial Analysis, hub da Epoch AI | Pontuação em um conjunto fixo de testes | Só vale o que valem os testes escolhidos |
| Benchmark de tarefa | SWE-bench, Humanity's Last Exam | Uma habilidade com correção automática | Contaminação, tarefas com falhas, saturação |
| Tabela de fabricante | Posts de lançamento, model cards | O que o laboratório decidiu divulgar | Configurações e prompts que você não consegue verificar |
Como um voto na arena vira uma nota
A Arena começou como Chatbot Arena, um projeto de pesquisa da UC Berkeley. A ideia é simples: você digita um prompt, dois modelos anônimos respondem e você escolhe a melhor resposta. O artigo original dos pesquisadores descreve uma plataforma que coletou mais de 240.000 votos nos primeiros meses e constatou que os votos do público concordavam bem com o julgamento de especialistas (arXiv).
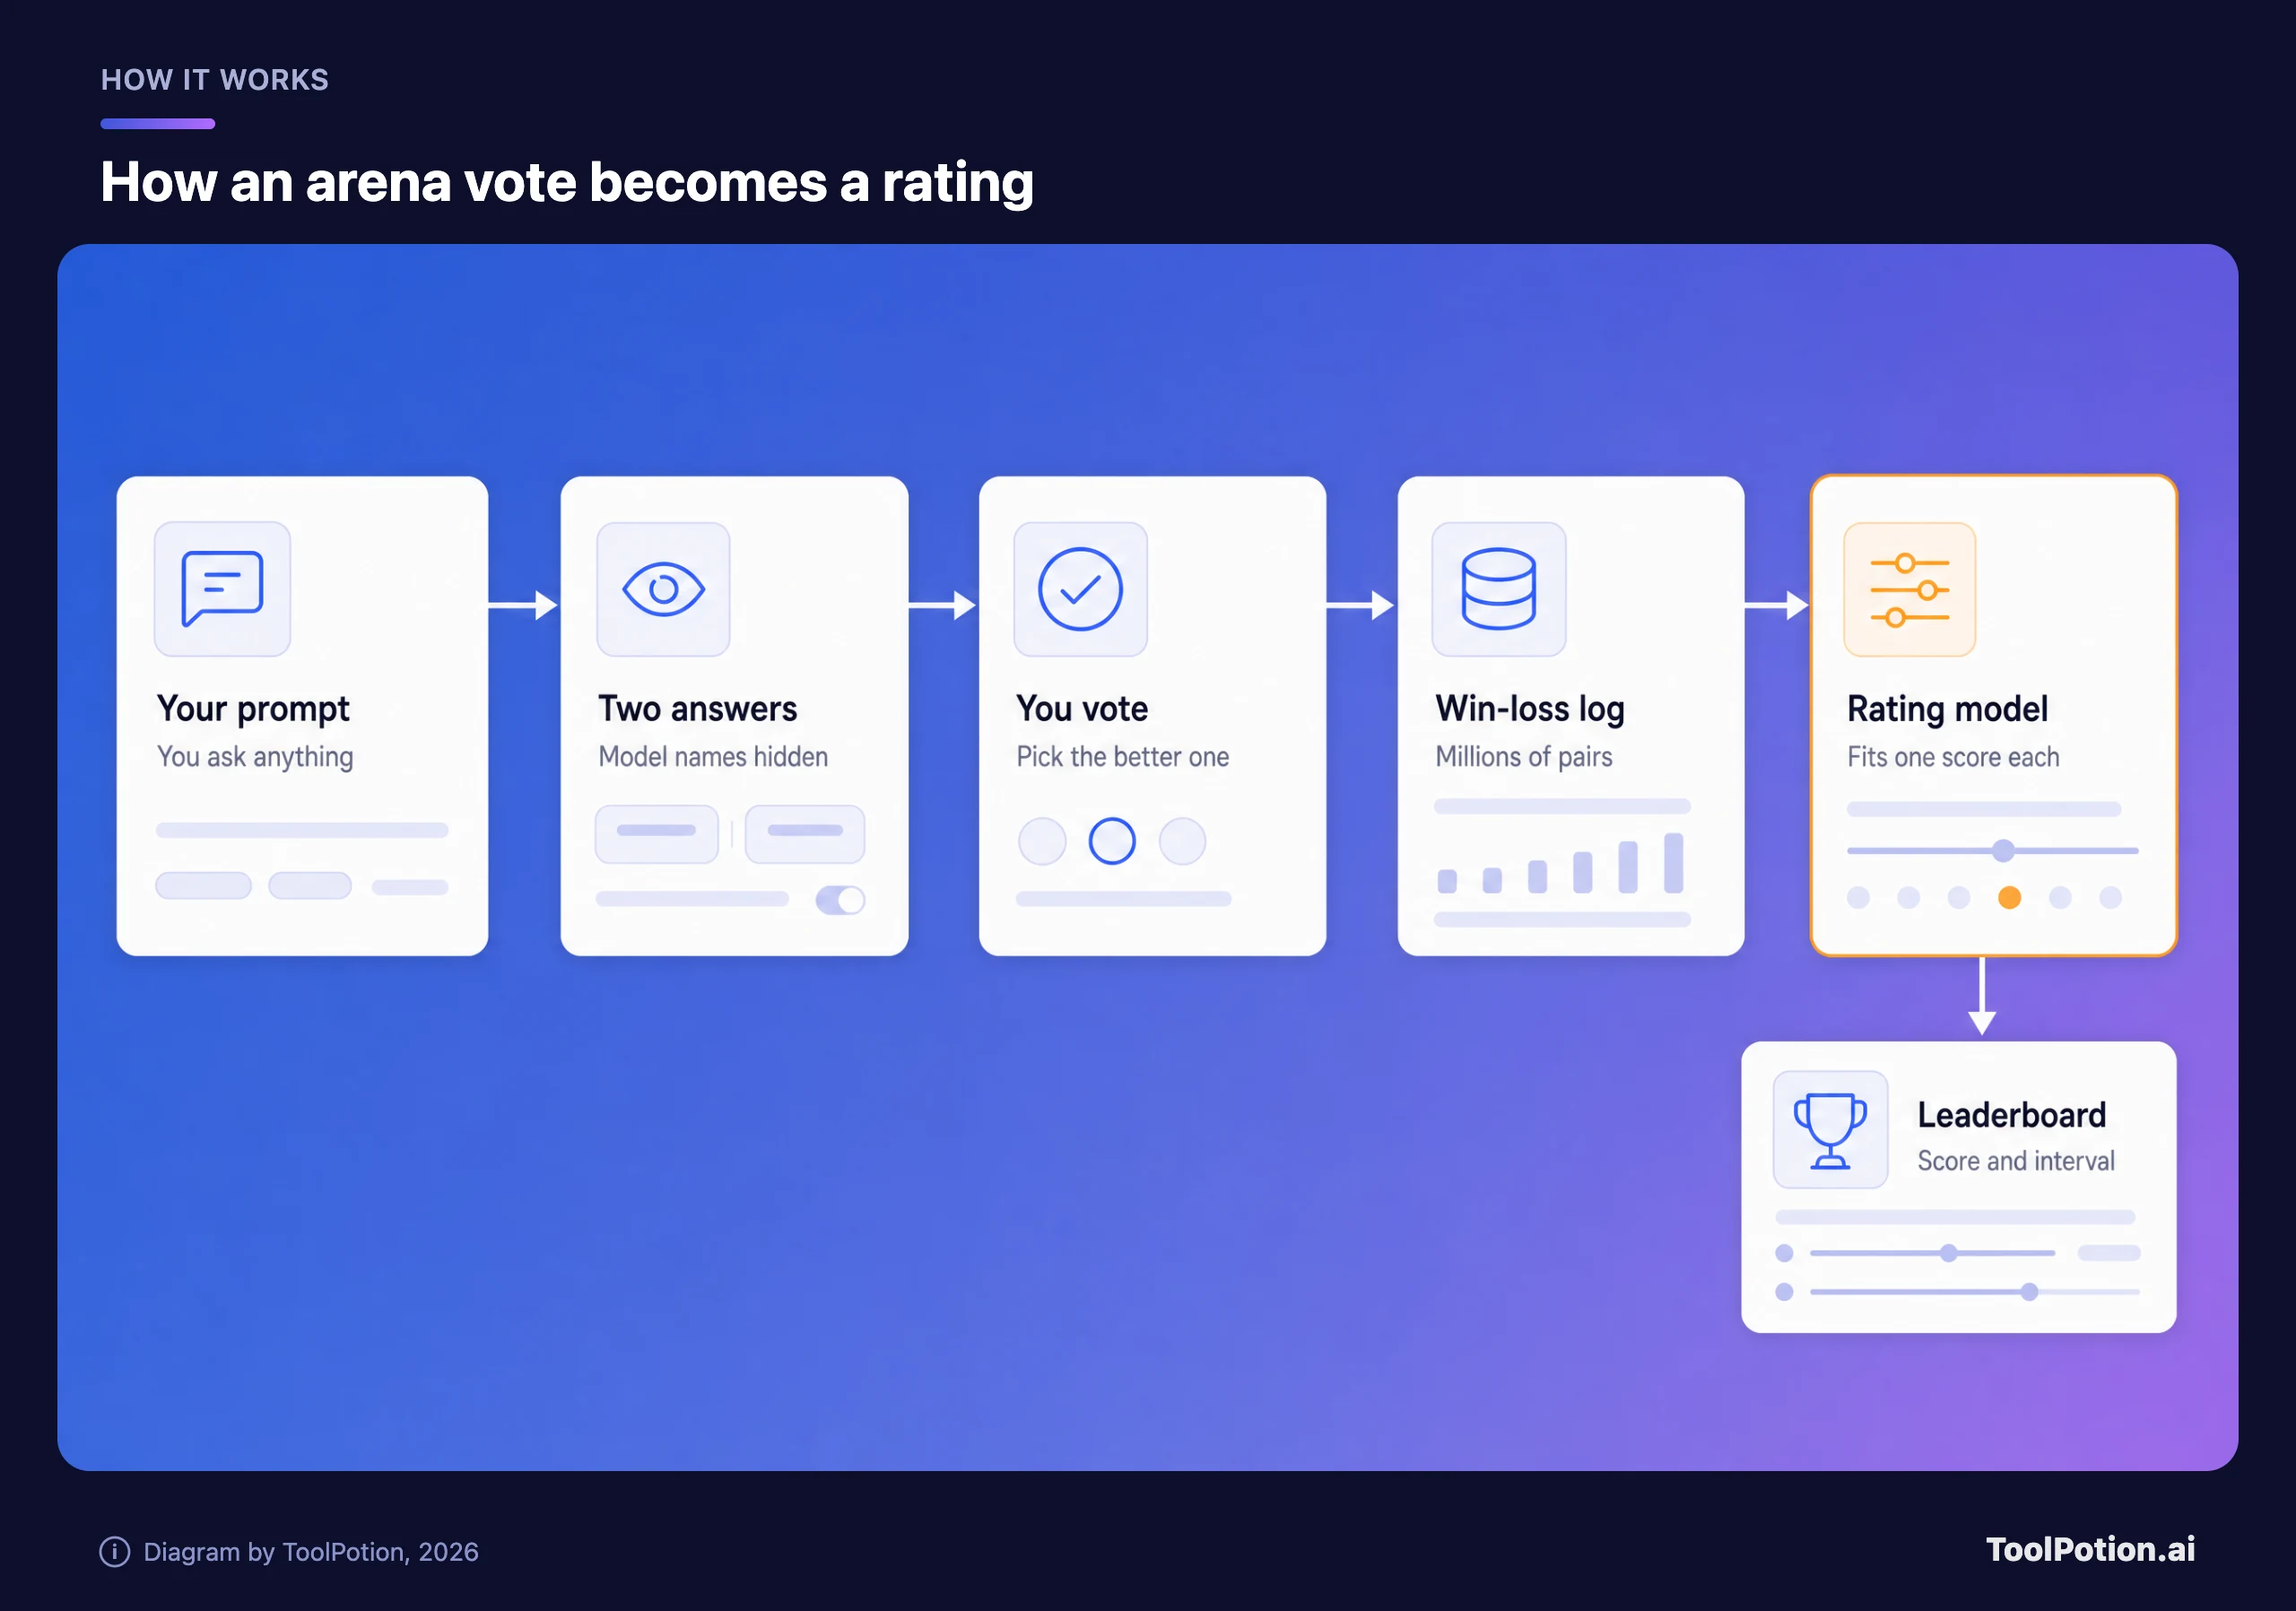
Cada voto é um registro minúsculo: o modelo A venceu o modelo B neste prompt. Milhões desses registros alimentam um modelo estatístico que atribui a cada modelo uma única nota. Os próprios textos da Arena descrevem o método como uma regressão Bradley-Terry, parente próxima do sistema Elo usado no xadrez (LMSYS). A nota de um modelo sobe quando ele vence oponentes fortes e cai quando perde para fracos, e o ranking de texto mostra um intervalo ao lado de cada nota (o valor "±"), não só a estimativa pontual.
Esse intervalo é a parte que os posts de lançamento ignoram. Se dois modelos estão a poucos pontos de distância e seus intervalos se sobrepõem, a leitura honesta é um empate. Um "#1" baseado numa diferença de dois ou três pontos costuma ser um cara ou coroa estatístico.
A Arena também cresceu muito além do chat. Seu ranking agora tem listas separadas para texto, WebDev, visão, busca, geração e edição de imagens e vídeo, além de um ranking mais recente para agentes que mostra o custo por tarefa ao lado da taxa de vitória (Arena). Vale ler a coluna de custo. Um modelo que fica uma posição acima por um preço várias vezes maior é outra recomendação.
O que uma arena não consegue dizer
A votação por preferência tem três problemas bem documentados. O primeiro é o estilo. As pessoas gostam de respostas longas e bem formatadas, então um modelo pode subir escrevendo mais e adicionando títulos. A análise da própria equipe da Arena concluiu que o tamanho da resposta era o efeito de estilo dominante e que corrigir tamanho e markdown mudava a posição dos modelos. Nessa análise de 2024, o GPT-4o-mini caiu do sexto para o décimo primeiro lugar, enquanto o Claude 3.5 Sonnet subiu do sexto para o quarto (LMSYS). A Arena agora oferece visões com controle de estilo, e vale usá-las.
O segundo problema é o acesso. Um artigo de 2025 chamado "The Leaderboard Illusion", com autores como Sayash Kapoor e Noah Smith, argumentou que os grandes laboratórios têm vantagens estruturais na Arena. Ele relatou que a Meta testou 27 variantes privadas de modelo antes do lançamento do Llama 4 e publicou apenas a melhor pontuação, e estimou que Google e OpenAI receberam cerca de 19,2% e 20,4% de todos os dados da Arena, enquanto 83 modelos open-weight juntos receberam cerca de 29,7% (arXiv).
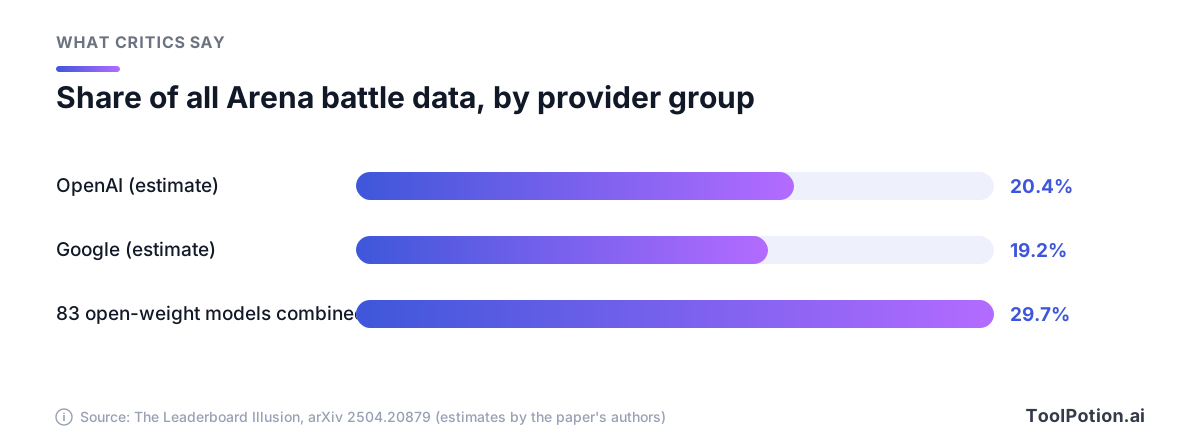
O artigo também relatou que treinar com dados no estilo da Arena pode elevar o desempenho na distribuição da Arena em até 112%, o que é um incentivo para ajustar o modelo ao ranking, e não à capacidade geral. Essas são estimativas e afirmações dos autores, e refletem um retrato do momento em que o artigo foi escrito. Ainda assim, continuam sendo a descrição externa mais clara de como um ranking de preferência pode ser manipulado sem que ninguém quebre uma regra.
O terceiro problema é que preferência não é correção. Uma resposta confiante e simpática pode ganhar o voto e ainda assim conter um fato errado. Para o "jeitão" da conversa e para escrita, a preferência é um guia razoável. Para código que precisa rodar ou um número que precisa estar certo, é um guia fraco.
A página de política atual da Arena trata de parte disso. Ela diz que modelos pré-lançamento são testados com nomes anônimos até as notas se estabilizarem (no mínimo 1.000 votos), que essas notas são compartilhadas em particular com o provedor, e que a nota de um modelo é marcada como "preliminary" após o lançamento público até chegarem votos novos. Diz também que toda batalha inclui ao menos um modelo disponível publicamente e que pelo menos 20% das batalhas envolvem apenas modelos públicos (Arena). A regra prática: a marca "preliminary" significa que o número ainda não se firmou.
Suítes independentes: Artificial Analysis e Epoch AI
Se os rankings de preferência perguntam do que as pessoas gostam, as suítes independentes perguntam o que um modelo consegue fazer quando todos recebem o mesmo teste. A Artificial Analysis é a mais conhecida. Seu Intelligence Index, hoje na versão 4.3.2, combina 10 avaliações em quatro grupos: agentes (30% do peso), conhecimento geral e raciocínio (30%), código (20%) e raciocínio científico (20%). Todos os modelos rodam nas mesmas condições com pontuação pass@1, ou seja, uma tentativa por pergunta, e o site diz manter cópias próprias dos datasets. Para a correção subjetiva, usa um painel de três modelos de fronteira de laboratórios diferentes. O índice é majoritariamente em inglês e texto, e o site avalia capacidade multilíngue e multimodal separadamente (Artificial Analysis).
Os pesos são uma escolha editorial. Uma ponderação diferente, com menos peso em agentes e mais em código, reordenaria alguns modelos. Isso não é um defeito, mas significa que o número "geral" é uma opinião sobre o que importa. Se você se importa principalmente com código, leia os resultados de código, não a manchete.
A Epoch AI mantém um hub de benchmarks que mistura testes que ela mesma aplica, como GPQA Diamond, FrontierMath e SWE-bench Verified, com resultados de fontes externas. A descoberta mais útil para quem lê é sobre os números dos fabricantes. O Claude 3.5 Sonnet foi divulgado com 65% no GPQA Diamond. A Epoch mediu 55%, com margem de mais ou menos 3, em 16 execuções, e observou que os laboratórios muitas vezes não publicam o prompt nem a temperatura que usaram (Epoch AI). Uma diferença de 10 pontos só por causa da configuração é um bom motivo para preferir reexecuções feitas por terceiros. O hub é financiado pelo UK AI Security Institute e seus dados são de reuso livre.
Independente não significa imparcial. Um terceiro ainda escolhe os testes, e qualquer índice que inclua LLMs como juízes herda os vícios deles. O estudo da própria Arena sobre juízes de IA constatou que os modelos favorecem as próprias respostas. Em 1.460 batalhas do Text Arena julgadas por 12 modelos, os juízes escolheram as próprias respostas cerca de 70% mais vezes do que os humanos (Arena).
Benchmarks se desgastam
Os benchmarks de tarefas têm o problema oposto. São objetivos, mas envelhecem rápido. Um benchmark nasce difícil, os laboratórios otimizam para ele, as notas sobem, o teste vaza para os dados de treinamento e logo todos os modelos de ponta ficam perto do teto e o ranking deixa de significar qualquer coisa.
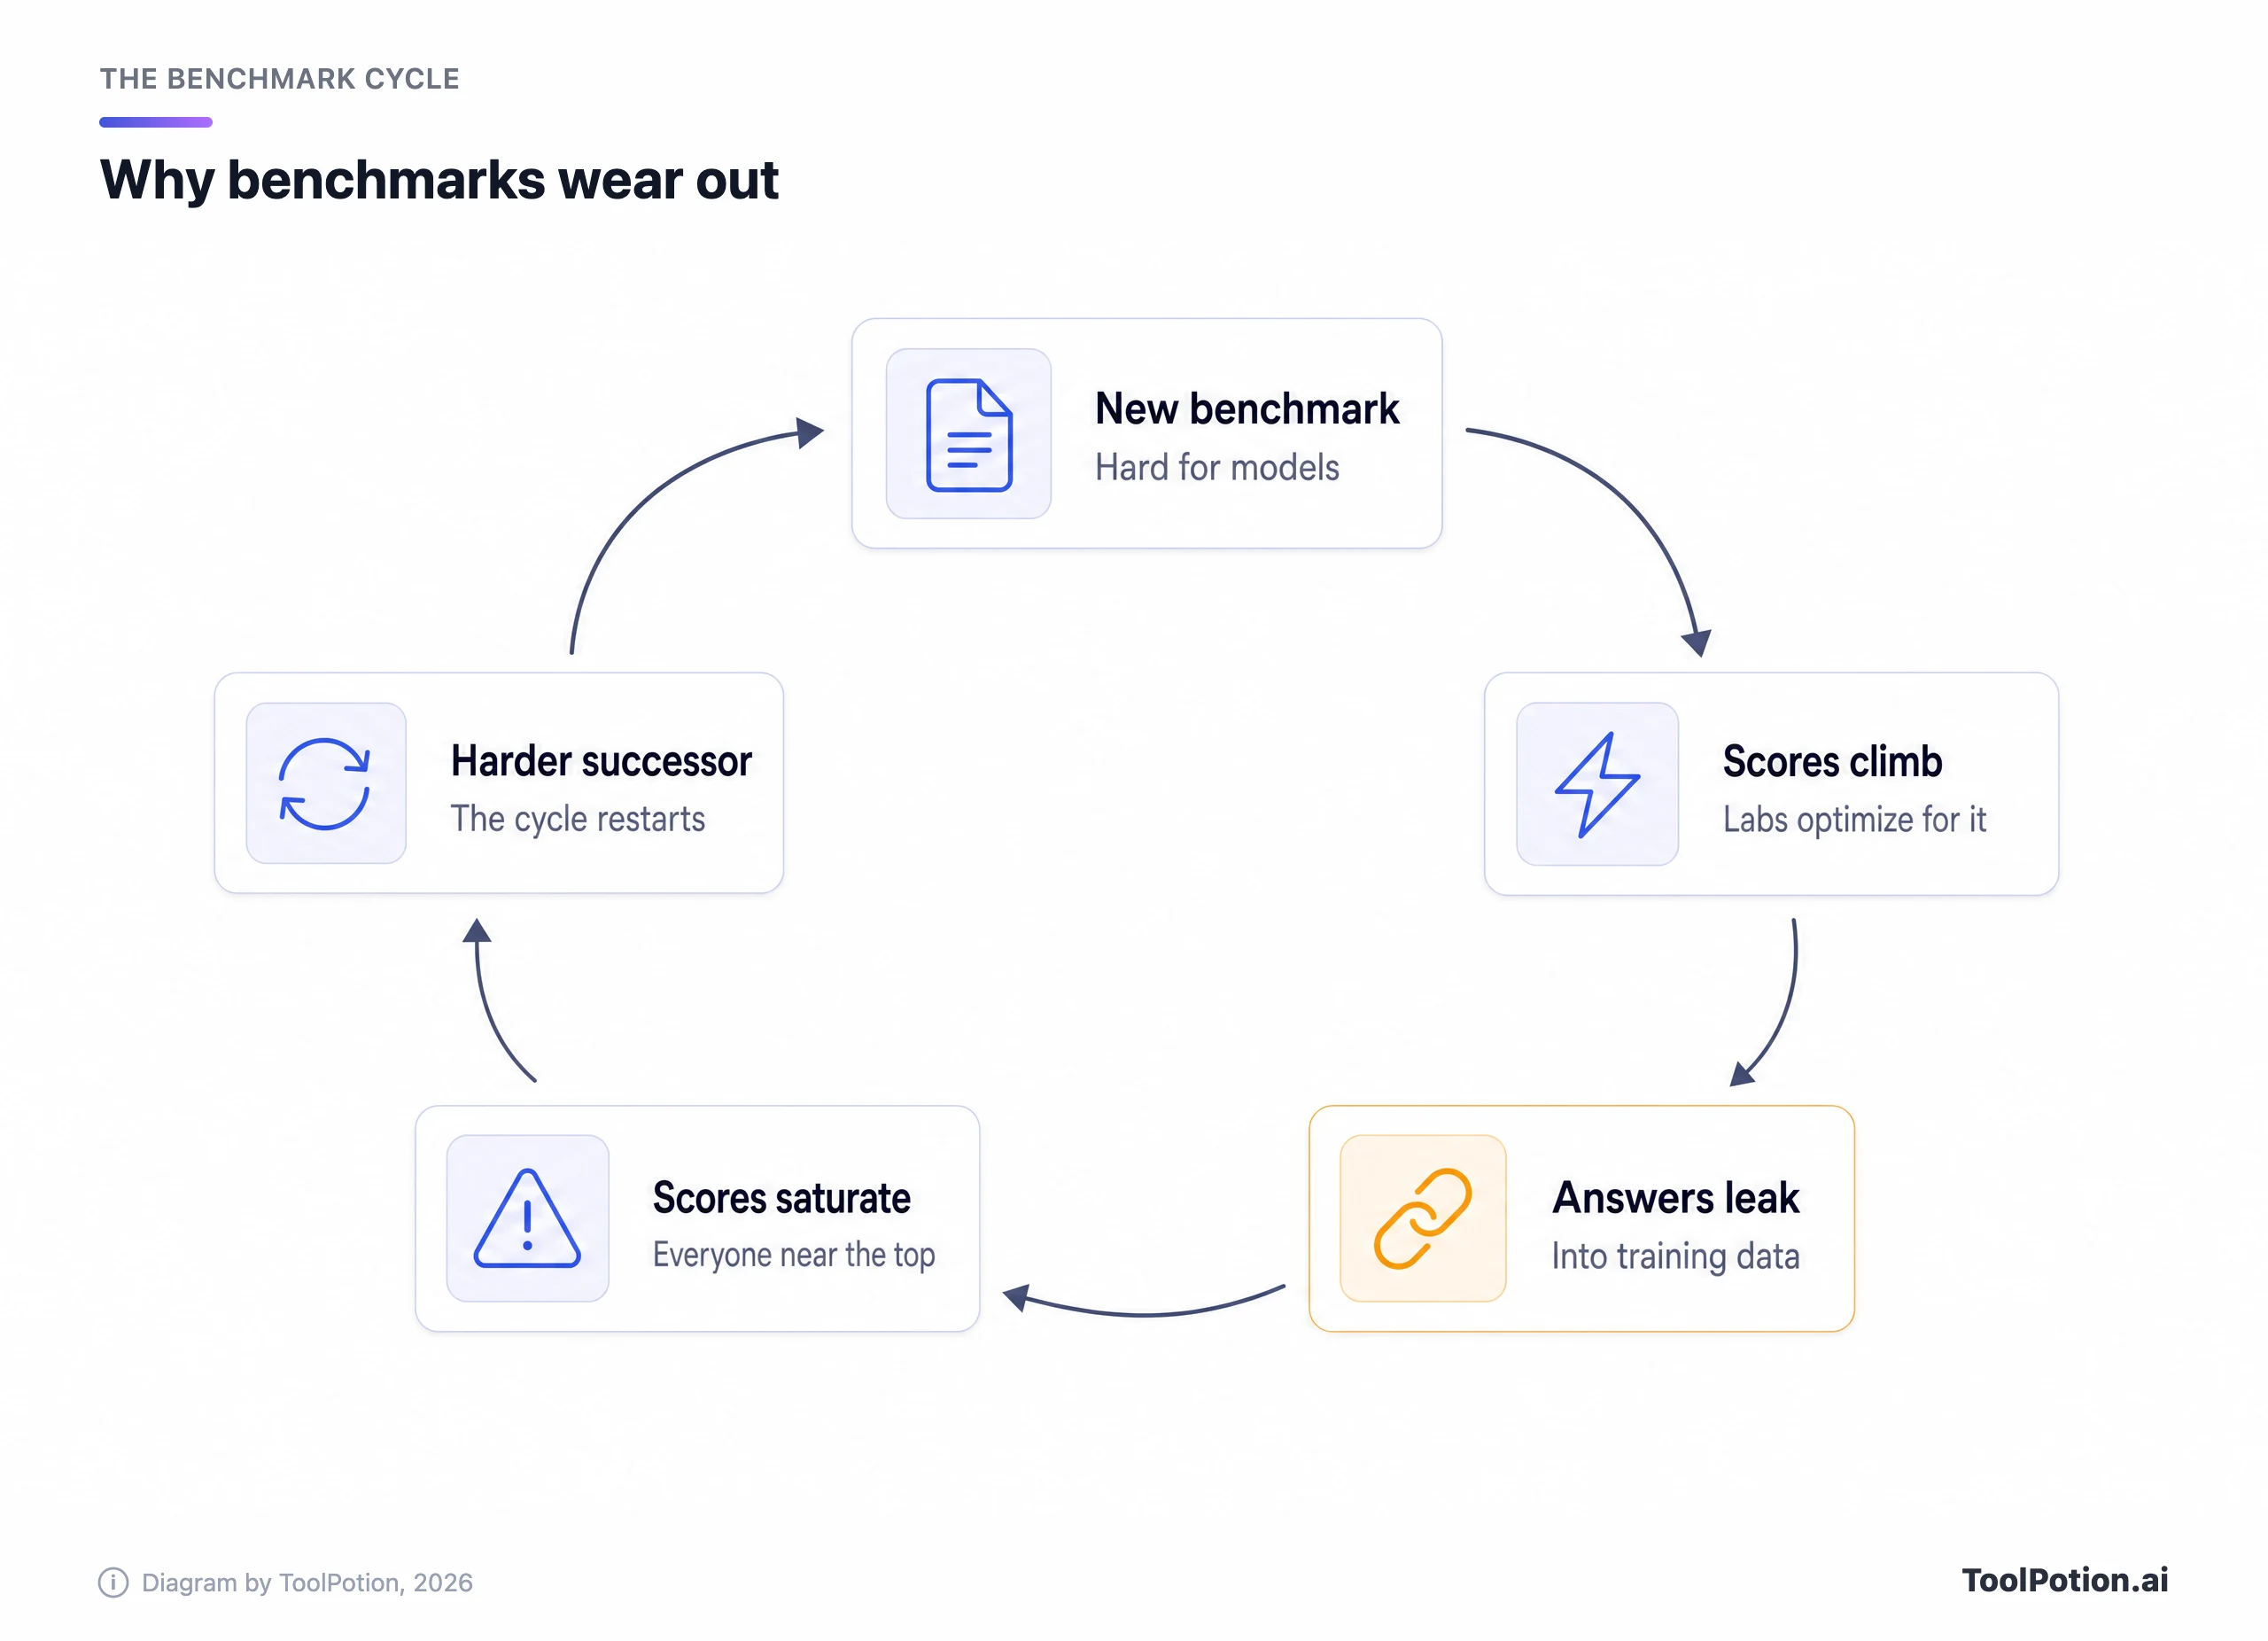
O Humanity's Last Exam é um bom exemplo dessa reação. Ele tem 2.500 perguntas em mais de cem áreas, escritas por quase 1.000 especialistas de mais de 500 instituições, e mantém um conjunto de teste privado para detectar overfitting. Os autores o criaram porque testes mais antigos, como o MMLU, já tinham sido levados acima de 90% pelos modelos de fronteira (arXiv). Ele foi publicado na Nature em 2026, e até seus criadores esperavam que as notas subissem rápido.
O SWE-bench mostra o ciclo completo. O benchmark original tinha 2.294 issues reais do GitHub de 12 projetos Python, e o melhor modelo da época, o Claude 2, resolveu 1,96% delas (segundo o artigo original). Um subconjunto limpo de 500 tarefas, chamado Verified, virou o número padrão nos lançamentos de modelos de código. Então veio a auditoria.
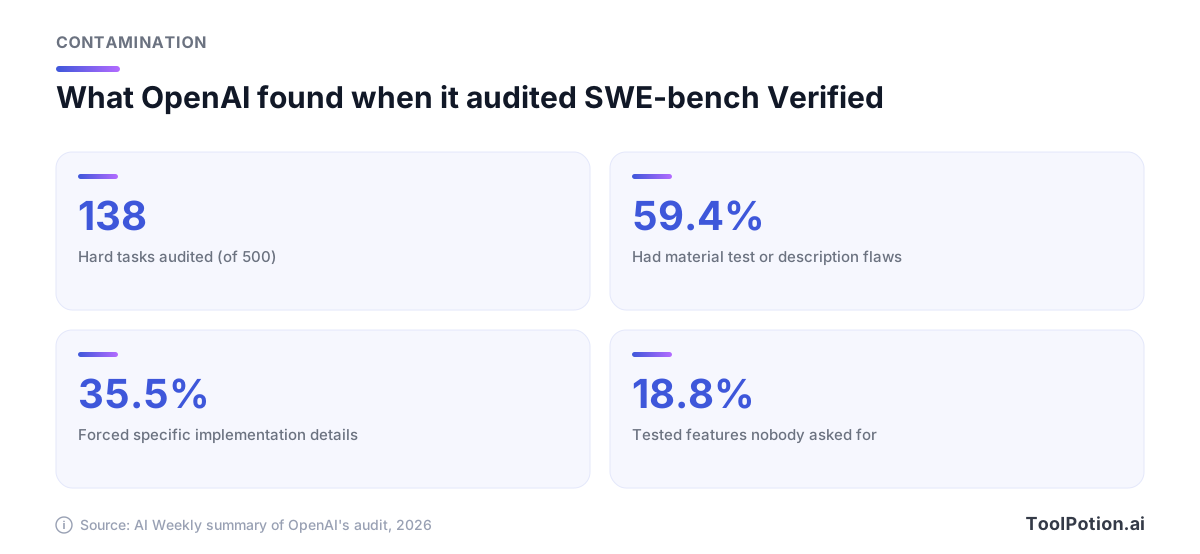
A OpenAI auditou 138 problemas do Verified que seu modelo o3 não resolvia de forma confiável, cada um revisado por pelo menos seis engenheiros. Ela constatou que 59,4% tinham problemas relevantes nos testes ou nas descrições. Em um teste de contaminação separado, GPT-5.2, Claude Opus 4.5 e Gemini 3 Flash Preview conseguiram reproduzir detalhes das correções originais, sinal de que as tarefas tinham vazado para os dados de treinamento. A OpenAI diz que parou de divulgar pontuações do Verified e recomenda o SWE-bench Pro (OpenAI). O resumo da AI Weekly acrescenta que os principais modelos ficavam em torno de 80% no Verified e cerca de 35 pontos abaixo no Pro, e que uma auditoria externa posterior também questionou os avaliadores do Pro (AI Weekly).
A lição não é que benchmarks de código são inúteis. É que uma nota de um teste aposentado ou vazado é um número velho. Quando um post de lançamento cita o SWE-bench, verifique a variante e qual estrutura de agente envolvia o modelo. O estudo "HarnessTax" da Arena, com 21 pares de modelo e estrutura, constatou que a escolha da estrutura teve pouco efeito no sucesso das tarefas, mas mudou o custo em até 5x para resultados parecidos, numa amostra pequena de 30 tarefas por benchmark (Arena).
Um checklist para qualquer alegação de #1
Esta é a versão de dois minutos. Passe por ela antes de acreditar em um ranking, principalmente antes de gastar dinheiro por causa de um.
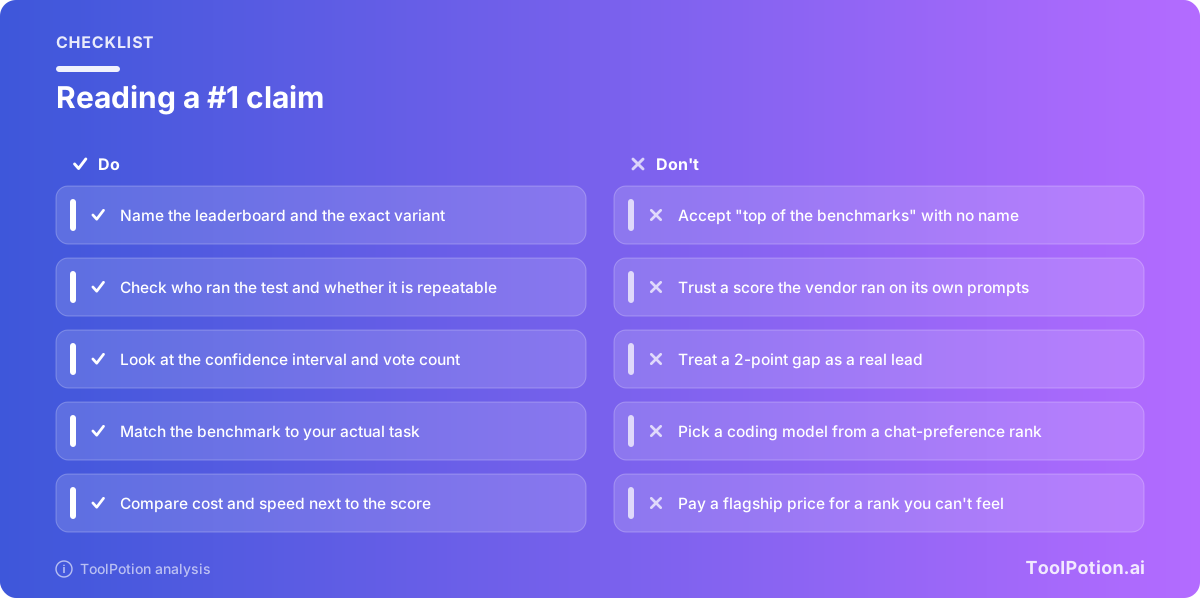
- Descubra o ranking e a versão exatos. "Lidera os benchmarks" não é uma alegação verificável. "Primeiro no Arena Text com controle de estilo" é.
- Descubra quem executou. A execução de um laboratório com os próprios prompts é número de marketing. Uma reexecução por terceiros pesa mais.
- Leia o intervalo e o número de votos. Se a vantagem é menor que o intervalo, é empate.
- Verifique se o modelo é público. Uma nota de algo que você não pode testar hoje não ajuda a escolher.
- Pergunte se o teste combina com a sua tarefa. Preferência em chat não prevê como um modelo lida com suas planilhas ou com a sua base de código.
- Procure um segundo ranking, diferente, que concorde. Um ranking pode estar errado ou manipulado. Dois independentes concordando é muito mais difícil de forjar.
- Coloque preço e velocidade ao lado da nota. O modelo mais barato que está duas posições abaixo costuma ser a melhor compra.
Você mesmo pode pontuar uma alegação com o checklist abaixo. Ele dá mais peso ao que é mais difícil de forjar, como execuções de terceiros e concordância entre rankings.
Escolha o ranking de acordo com a sua pergunta
Como os rankings respondem a perguntas diferentes, o caminho útil é partir da sua pergunta e escolher o ranking depois. Se você está escolhendo um assistente para escrita e conversa, uma arena de preferência é um bom primeiro filtro. Se quer uma comparação repetível de capacidade bruta, use uma suíte independente. Se está escolhendo uma ferramenta de código, olhe benchmarks de tarefas baseados em repositórios reais e depois teste no seu próprio código.
A árvore dá um ponto de partida, não um veredito. Qualquer que seja o ranking em que você parar, um teste curto no seu próprio trabalho vale mais do que qualquer posição pública. Pegue 10 tarefas reais que você faz toda semana, rode em dois ou três finalistas e compare os resultados lado a lado. Leva uma tarde e mede a única coisa que nenhum ranking mede: o seu trabalho.
Para pesquisar por categoria, o diretório de AI Models & LLMs e o ranking de modelos de IA do ToolPotion listam os modelos lado a lado, e o guia sobre como combinar níveis de modelo de IA com tarefas mostra quando vale pagar por um modelo topo de linha. Para um panorama mais amplo, veja Top 15 AI Models & LLMs in 2026, ou alternativas ao ChatGPT em 2026 se o seu ponto de partida for um único assistente.
Onde os números são menos confiáveis
Algumas situações pedem desconfiança extra. Modelos novos nos primeiros dias têm menos votos e intervalos maiores, e a Arena marca essas notas como preliminares por um motivo. Os modelos open-weight, que você pode baixar do Hugging Face, são o outro ponto cego: os autores do Leaderboard Illusion estimaram que eles recebem uma fatia menor dos dados da Arena, então suas notas podem ser mais ruidosas. Modelos hospedados também podem mudar de comportamento mantendo o mesmo nome, então uma nota da semana de lançamento pode não descrever o modelo que você usa meses depois.
O trabalho especializado é a maior lacuna. Redação jurídica, codificação médica, um idioma de nicho e a base de código interna de uma empresa são todos mal cobertos pelos rankings públicos. O Real-SWE Benchmark é uma resposta: avalia modelos de fronteira em bases de código corporativas privadas, que têm menos chance de ter vazado para os dados de treinamento do que repositórios públicos. Trate um ranking assim como uma segunda opinião útil, não como substituto do seu próprio teste.
E se você é um usuário casual, talvez nem precise de nada disso. Para escrita e perguntas do dia a dia, os melhores modelos da OpenAI, da Anthropic e do Google estão próximos o bastante para que a escolha dependa de preço, interface e hábito. Gastar uma hora com rankings para escolher entre empates técnicos é mau negócio.
Perguntas frequentes
Arena é o mesmo que LMArena?
Sim. A LMArena nasceu do projeto de pesquisa Chatbot Arena, da UC Berkeley, e hoje se chama Arena, em arena.ai. O nome antigo ainda aparece em artigos e em estudos mais antigos.
Qual ranking é o mais confiável?
Nenhum é confiável em todos os casos, e a resposta depende do que você quer saber. Para repetibilidade, uma suíte de terceiros que executa todos os modelos por conta própria é a mais forte. Para saber o que as pessoas preferem, a Arena tem mais dados. A evidência mais confiável é dois rankings independentes concordando, seguidos de um teste curto nas suas próprias tarefas.
O que é contaminação de benchmark?
É quando um modelo viu as perguntas ou respostas de um teste durante o treinamento, então uma nota alta reflete memória, não habilidade. A auditoria da OpenAI sobre o SWE-bench Verified constatou que modelos de fronteira conseguiam reproduzir as correções originais de algumas tarefas. Conjuntos de teste privados, como o que o Humanity's Last Exam mantém, são uma defesa.
Os fabricantes trapaceiam nos rankings?
As evidências sustentam uma afirmação mais restrita. Os laboratórios escolhem quais pontuações publicar, quais configurações usar e, segundo o artigo Leaderboard Illusion, quais variantes privadas revelar. Isso é relato seletivo dentro das regras, não necessariamente quebra de regras. É por isso que reexecuções independentes importam.
Devo trocar de modelo toda vez que um novo chega ao #1?
Não. A diferença de posição muitas vezes cabe dentro da margem de erro, e trocar tem custos reais em prompts, fluxos de trabalho e testes. Troque quando um modelo superar o atual nas suas próprias tarefas, ou quando igualar o desempenho por um preço claramente menor.