メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

ERNIE-5.5-Flash-Base

LLMAIモデルとLLMオープンソース · Web

ERNIE-5.5-Flash-Baseは、280Bの総パラメータを持つ効率的なスパースMixture-of-Experts (MoE)言語モデルで、テキスト生成のために設計されています。33.5Tトークンで事前学習されており、1Mトークンのコンテキストでファインチューニングと推論をサポートします。このモデルは、ドメイン適応、指示チューニング、強化学習研究のための堅牢な出発点として機能し、さまざまなベンチマークで強力なパフォーマンスを提供します。

URLを訪問
共有
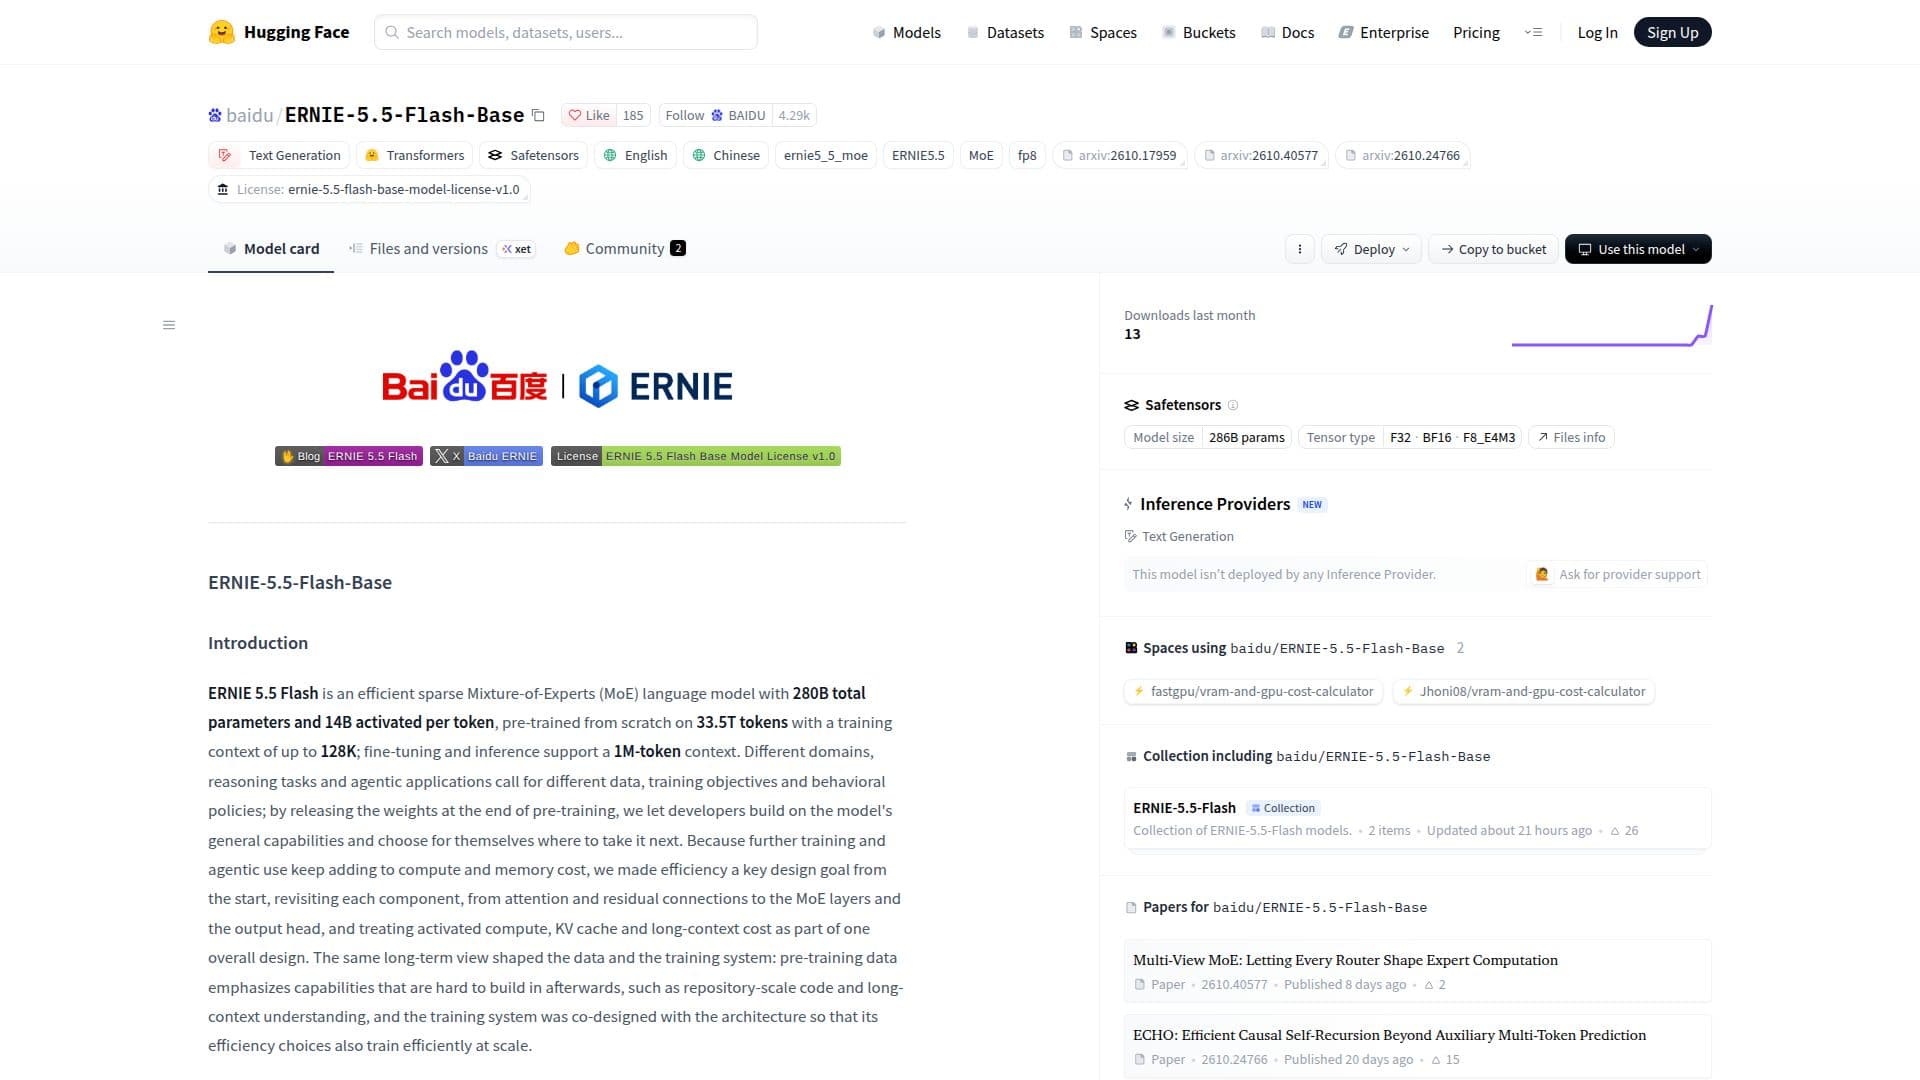
ERNIE-5.5-Flash-Base のスクリーンショット

ERNIE-5.5-Flash-Baseは、Baiduによって開発された高度なテキスト生成モデルで、Hugging Faceで利用可能です。これは、2800億の総パラメータを持つ効率的なスパースMixture-of-Experts (MoE)言語モデルで、トークンごとに140億がアクティブ化されています。このモデルは、33.5兆トークンの広範なデータセットでゼロから事前学習され、最大128Kのトレーニングコンテキストを利用しています。ファインチューニングと推論のために、印象的な1Mトークンのコンテキスト長をサポートします。

続きを読む

効率性を核心目標として設計されたERNIE 5.5 Flashは、注意メカニズムや残差接続からMoE層、出力ヘッドに至るまで、すべてのコンポーネントを見直しています。この包括的なアプローチは、アクティブ化された計算、KVキャッシュ、長コンテキストコストを統合設計の一部として考慮しています。事前学習データは、トレーニング後に構築するのが難しい能力、例えばリポジトリ規模のコード理解や長コンテキストの理解を強調しています。トレーニングシステムは、効率的なスケーリングを確保するためにアーキテクチャと共同設計されています。

ERNIE-5.5-Flash-Baseは、事前学習の終わりにおけるチェックポイントを表しており、開発者にとって理想的な基盤となります。これは、ドメイン適応、指示チューニング、強化学習研究を可能にします。このモデルは、知識、推論、数学、コード、多言語タスク、長コンテキストベンチマークをカバーする統一評価パイプライン全体で強力な結果を示しています。そのパフォーマンスは、DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Baseなどの他の大規模モデルと比較され、すべて一貫した条件下で評価されています。

アーキテクチャは、43層を持つ280B-A14Bハイブリッド注意MoEを組み込んでおり、1つの密なFFNと42のマルチルータ潜在MoE層を含んでいます。37の重圧縮注意(HCA)層と、スパース注意を持つ6つのマルチヘッド潜在注意層(MLA + DSA)を特徴としています。このモデルは、512のルーティングされた専門家(トップ10)と、各MoE層ごとに1つの共有専門家を利用します。主要な革新には、層特有のヘッド次元を持つハイブリッドMLA + HCA注意、低ランクゲート注意、仮想ヘッド注意(VHA)、マルチルータ潜在MoE、未来トークン予測のためのECHO、信号伝播のための多様体制約ハイパーコネクション(mHC)、およびマルチマックス出力ヘッドが含まれます。トークナイザーは、約200KエントリのBPEトークナイザーを使用し、最大3桁のグループで右から左に数字をトークン化します。

ERNIE-5.5-Flash-Baseの展開は、SGLangおよびvLLMでサポートされており、長コンテキスト推論のために最大1,048,576トークンのコンテキスト長でのプロダクションサービスを可能にします。このモデルは、Baiduが著作権を保有するERNIE 5.5 Flash Base Model License Agreement v1.0の下で提供されます。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • 280Bの総パラメータで、トークンごとに14Bがアクティブ化

  • 33.5Tトークンで事前学習

  • ファインチューニングと推論のために1Mトークンのコンテキストをサポート

  • 効率的なスパースMixture-of-Experts (MoE)アーキテクチャ

  • 層特有のヘッド次元を持つハイブリッドMLA + HCA注意

  • 低ランクゲート注意および仮想ヘッド注意(VHA)

  • 512のルーティングされた専門家と1つの共有専門家を持つマルチルータ潜在MoE

  • マルチホライズン損失と推測デコーディングのためのECHO

  • 信号伝播のための多様体制約ハイパーコネクション(mHC)

  • 語彙分布を鋭くするためのマルチマックス出力ヘッド

  • 右から左に数字をトークン化する約200KエントリのBPEトークナイザー

  • SGLangおよびvLLMでの展開をサポート

  • 知識、推論、数学、コード、多言語、長コンテキストベンチマーク全体での強力なパフォーマンス

  • FP8およびBF16精度の重みが利用可能

  1. モデルにアクセス: Hugging FaceのERNIE-5.5-Flash-Baseページに移動します。

  2. モデルをダウンロード: FP8 (safetensors)またはBF16 (safetensors)精度のいずれかを選択してダウンロードします。

  3. 展開ツールをインストール: vLLMおよびERNIE 5.5プラグインをインストールするか、公式のSGLangプリビルドDockerイメージを使用します。

  4. サーバーを起動: vLLMまたはSGLangサーバーを起動してモデルをホストします。

  5. リクエストを送信: curlや他のAPIクライアントを使用して、テキスト生成のための完了エンドポイントにリクエストを送信します。

  6. モデルをファインチューニング: 事前学習されたチェックポイントを利用して、ドメイン適応、指示チューニング、または強化学習研究を行います。

  • テキスト生成
  • ドメイン適応
  • 指示チューニング
  • 強化学習研究
  • コード生成と理解
  • 長コンテキスト理解
  • 多言語アプリケーション
  • 推論タスク

Baidu の製品

百度文心助手 のモデルです。

ERNIE-5.5-Flash-Base のレビュー

読み込み中...

ERNIE-5.5-Flash-Base に似た人気のAIツール

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

AIモデルとLLM
ツールを見る

効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

注目AIモデルとLLM
LLM トップ50を見る

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

AIモデルとLLM

LLMで第37位

ツールを見る

6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

注目AIモデルとLLM
LLMで第37位

AliceAI-Foundation-80B-A3B-Baseは、ハイブリッドアーキテクチャとMoEレイヤーを備えた基盤となる言語モデルで、80億のパラメータを持っています。事実に基づく知識タスクに優れ、特にロシア語において高い性能を発揮し、最大262,144トークンのコンテキスト長をサポートします。

AIモデルとLLM

LLMで第28位

ツールを見る

ハイブリッドアーキテクチャとMoEレイヤーを備えた基盤となる言語モデルで、80億のパラメータを持っています。事実に基づく知識タスクに優れ、特にロシア語において高い性能を発揮し、最大262,144トークンのコンテキスト長をサポートします。AliceAI-Foundation-80B-A3B-Baseは、ハイブリッドアーキテクチャとMoEレイヤーを備えた基盤となる言語モデルで、80億のパラメータを持っています。事実に基づく知識タスクに優れ、特にロシア語において高い性能を発揮し、最大262,144トークンのコンテキスト長をサポートします。

AIモデルとLLM
LLMで第28位

Ling-3.0-flashは、効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。

AIモデルとLLM
ツールを見る

効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。Ling-3.0-flashは、効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。

AIモデルとLLM
LLM トップ50を見る

Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第46位

ツールを見る

高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第46位

MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。

AIモデルとLLM
ツールを見る

コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。

AIモデルとLLM
LLM トップ50を見る

DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

AIモデルとLLM
ツールを見る

ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

AIモデルとLLM
LLM トップ50を見る

Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

AIモデルとLLM

LLMで第19位

ツールを見る

Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

AIモデルとLLM
LLMで第19位
1 / 8