メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

Solar Open 2

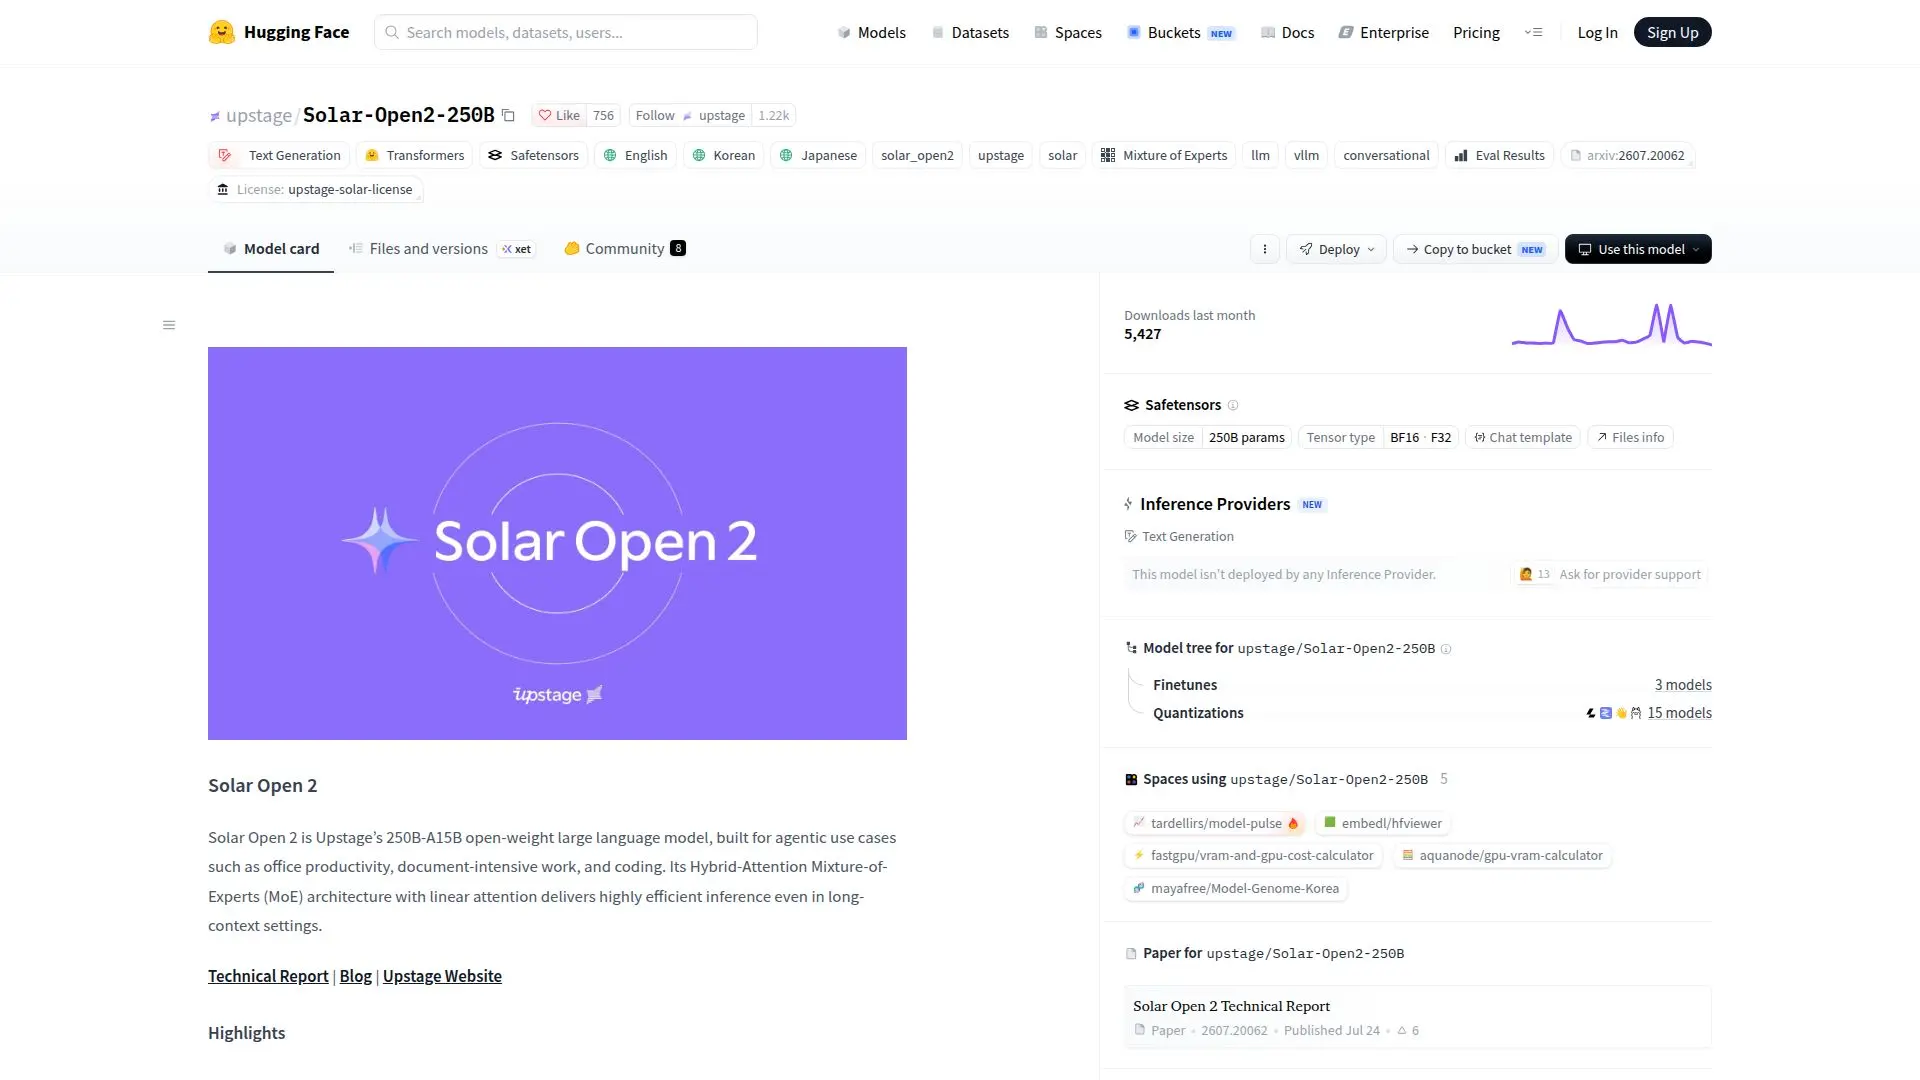
Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

URLを訪問
共有
Solar Open 2 のスクリーンショット

Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性、文書集約型の作業、コーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパート(MoE)アーキテクチャに基づいて構築されており、線形およびソフトマックスアテンションレイヤーを組み合わせて、長いコンテキスト設定でも効率的な推論を実現します。このモデルは、2500億のパラメータ容量を誇り、トークンごとに150億のパラメータのみがアクティブになり、最小限の推論コストを確保しています。

続きを読む

このモデルは、トークンの順序を本質的にエンコードする線形アテンションレイヤーのおかげで、100万トークンのコンテキスト長をサポートしています。これにより、Solar Open 2は長期的なコンテキストメモリを効率的に維持できます。このモデルは多言語対応で、英語、韓国語、日本語をサポートしており、さまざまなアプリケーションに対応可能です。

Solar Open 2は、NVIDIA B200 GPUを使用して効率的にトレーニングされ、合計200万GPU時間を要しました。前モデルであるSolar Open 1からの重みを選択的に転送することで初期化され、2500億スケールでの収束を加速しました。このモデルのパフォーマンスは、エージェントベンチマークにおける最強のオープンウェイトモデルと競争力があり、ツール呼び出し、マルチステップ推論、エンドツーエンドのタスク実行を必要とするタスクで優れた成果を上げています。

デプロイメントのために、Solar Open 2はvLLMを使用して提供でき、Dockerまたはソースからのインストールオプションがあります。OpenAIの関数呼び出しインターフェースを介してツール呼び出しをサポートし、AnthropicのClaude CodeやNous ResearchのHermes Agentなどのエージェントと統合できます。このモデルはUpstage Solar Licenseの下で配布されており、派生AIモデルに関する特定の要件があります。

  • カテゴリーAIモデルとLLM
  • デプロイクラウド, セルフホスト
  • プラットフォームWeb

  • 250B パラメータ

  • 15B アクティブパラメータ

  • ハイブリッドアテンション MoE アーキテクチャ

  • 1M トークンコンテキスト長

  • 多言語サポート

  • 効率的な推論

  • ツール呼び出しインターフェース

  • Upstage Solar License

  1. モデルページにアクセス: Hugging Faceのウェブサイトを訪問

  2. 認証: Hugging Faceアカウントにログイン

  3. 設定: 希望するパラメータでモデルを設定

  4. プロンプトを送信: テキスト生成のためにモデルを使用

  5. ファインチューニング: 特定のタスクに合わせてモデルを調整

  • オフィスの生産性
  • 文書処理
  • コーディング支援
  • 多言語アプリケーション
  • ツール統合

Upstage の製品

Solar Open 2 のレビュー

読み込み中...

Solar Open 2 に似た人気のAIツール

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

AIモデルとLLM
ツールを見る

効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

注目AIモデルとLLM
LLM トップ50を見る

MiMo-V2.5-Pro

AI モデル

MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
ツールを見る

AI モデル

複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
AI モデル トップ5を見る

MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM

LLMで第49位

ツールを見る

コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM
LLMで第49位

Spark-X2.5-4Bは、効率性とアクセス性を考慮して設計されたコンパクトな汎用言語モデルです。200以上の言語をサポートし、会話、執筆、コーディングなどのタスクに優れ、最大1Mトークンのコンテキストウィンドウを持っています。

AIモデルとLLM

LLMで第24位

ツールを見る

効率性とアクセス性を考慮して設計されたコンパクトな汎用言語モデルです。200以上の言語をサポートし、会話、執筆、コーディングなどのタスクに優れ、最大1Mトークンのコンテキストウィンドウを持っています。Spark-X2.5-4Bは、効率性とアクセス性を考慮して設計されたコンパクトな汎用言語モデルです。200以上の言語をサポートし、会話、執筆、コーディングなどのタスクに優れ、最大1Mトークンのコンテキストウィンドウを持っています。

AIモデルとLLM
LLMで第24位

Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第44位

ツールを見る

高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第44位

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

AIモデルとLLM

LLMで第31位

ツールを見る

6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

注目AIモデルとLLM
LLMで第31位

DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

AIモデルとLLM
ツールを見る

ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

AIモデルとLLM
LLM トップ50を見る

Laguna M.1は、エージェントコーディングと長期タスクのために設計された225BパラメータのMixture-of-Expertsモデルです。高容量の専門家ルーティングとグローバルアテンションアーキテクチャを特徴としており、さまざまなベンチマークで優れたパフォーマンスを発揮します。

AIモデルとLLM

LLMで第36位

ツールを見る

エージェントコーディングと長期タスクのために設計された225BパラメータのMixture-of-Expertsモデルです。高容量の専門家ルーティングとグローバルアテンションアーキテクチャを特徴としており、さまざまなベンチマークで優れたパフォーマンスを発揮します。Laguna M.1は、エージェントコーディングと長期タスクのために設計された225BパラメータのMixture-of-Expertsモデルです。高容量の専門家ルーティングとグローバルアテンションアーキテクチャを特徴としており、さまざまなベンチマークで優れたパフォーマンスを発揮します。

AIモデルとLLM
LLMで第36位
1 / 8