メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

DeepSeek-V4-Pro-DSpark

DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

URLを訪問
共有
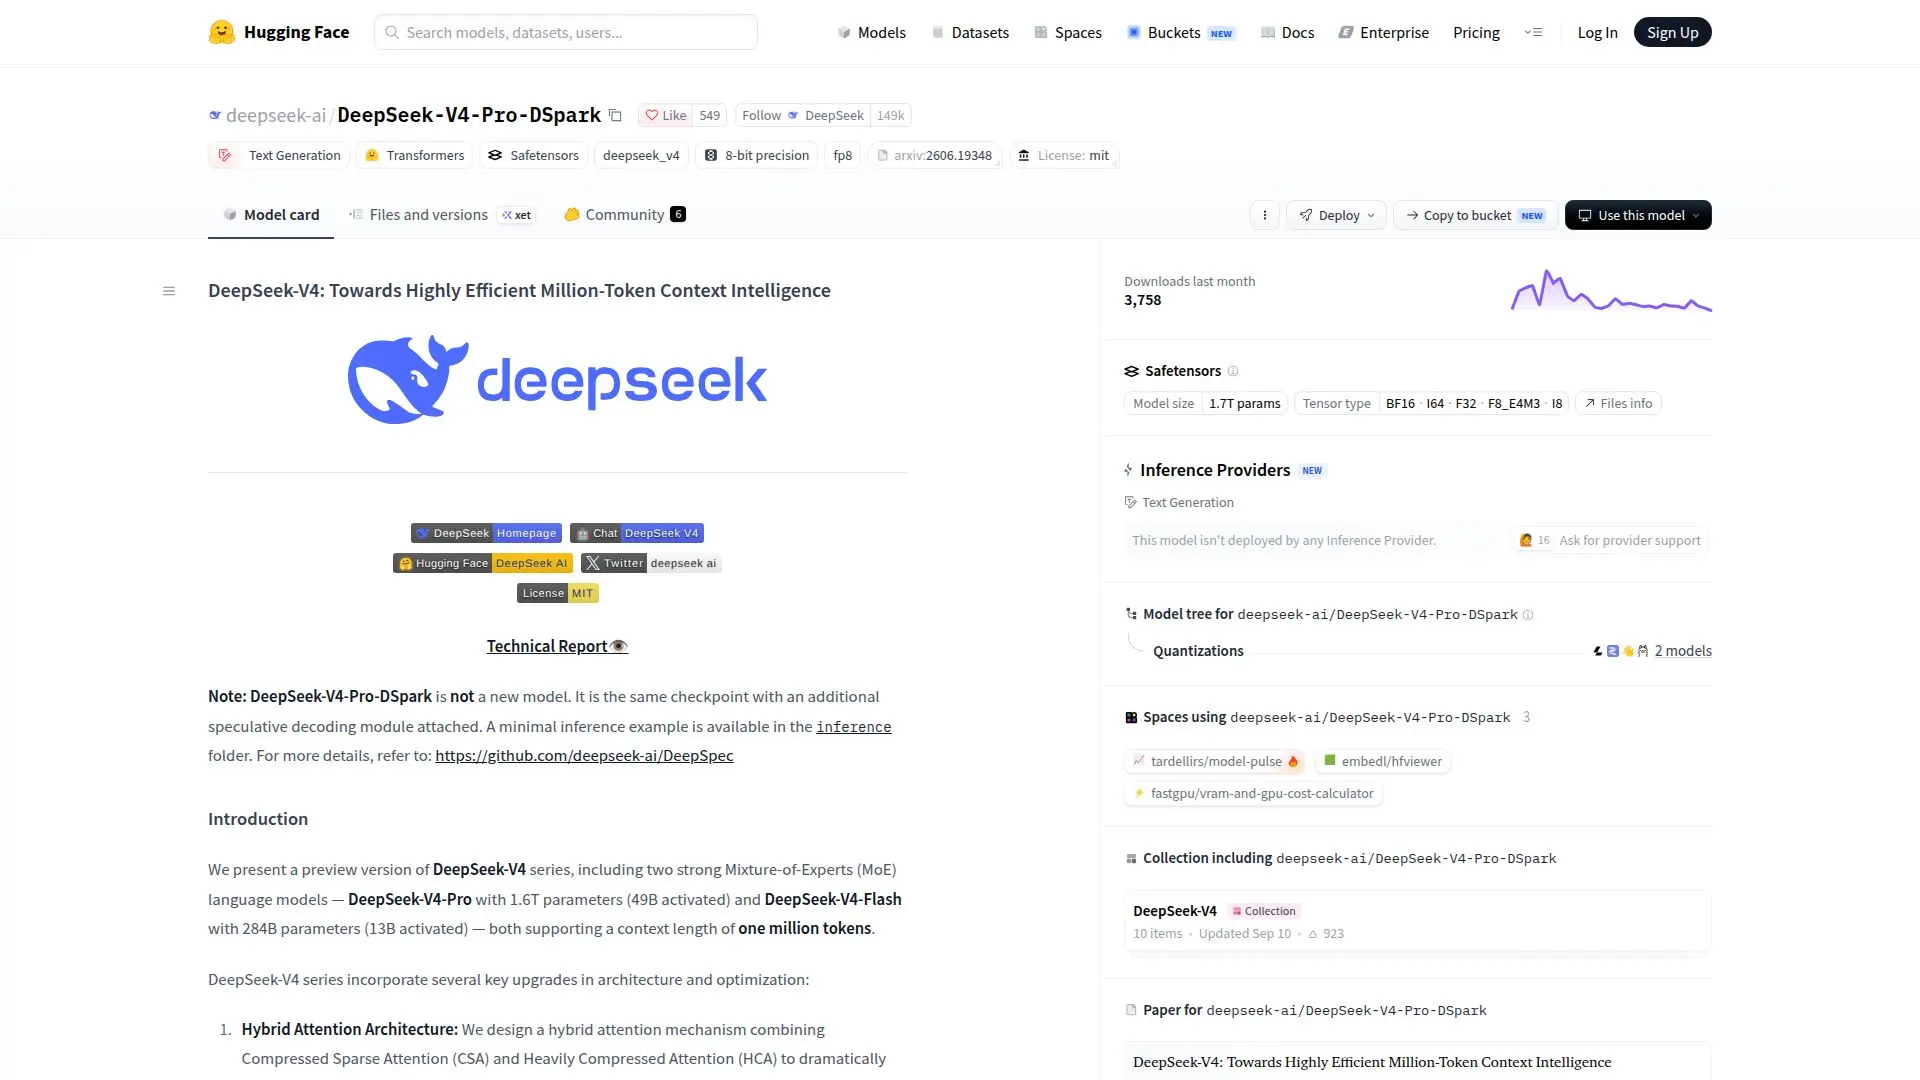
DeepSeek-V4-Pro-DSpark のスクリーンショット

DeepSeek-V4-Pro-DSparkは、非常に効率的なMixture-of-Experts(MoE)言語モデルを含むDeepSeek-V4シリーズの一部です。このモデルは、最大1百万トークンの広範なコンテキスト長を処理するように設計されており、複雑な言語タスクに適しています。ハイブリッドアテンションアーキテクチャは、圧縮スパースアテンション(CSA)と重圧縮アテンション(HCA)を組み合わせて、長コンテキストの効率を向上させます。さらに、このモデルは、層間の信号伝播の安定性を向上させるために、多様体制約ハイパーコネクション(mHC)を組み込んでいます。

続きを読む

DeepSeek-V4-Pro-DSparkモデルは、320兆以上の多様で高品質なトークンで事前トレーニングされ、その後包括的なポストトレーニングパイプラインを経ます。このパイプラインには、監視付きファインチューニング(SFT)とガイドポリシー最適化(GRPO)によるドメイン特化型エキスパートの独立した育成が含まれ、その後、オンポリシー蒸留を介して統一モデルの統合が行われます。

DeepSeek-V4-Pro-DSparkは、さまざまなベンチマークで優れた性能を発揮し、コーディングや推論タスクでトップクラスのパフォーマンスを達成しています。推論およびエージェントタスクにおいて、先行するクローズドソースモデルとのギャップを大幅に縮めています。このモデルは、日常的なタスクから複雑な問題解決まで、さまざまなユースケースに対応するために、非思考、思考高、思考最大の3つの推論努力モードをサポートしています。

このモデルは、Hugging FaceやModelScopeなどのプラットフォームでダウンロード可能で、MITライセンスの下でライセンスされています。ユーザーは、モデルウェイトの変換やインタラクティブチャットデモを含む推論フォルダに提供された詳細な指示に従って、ローカルでモデルを実行できます。

  • カテゴリーAIモデルとLLM
  • 料金モデル無料
  • デプロイクラウド, セルフホスト
  • プラットフォームWeb

  • ハイブリッドアテンションアーキテクチャ

  • 多様体制約ハイパーコネクション

  • ミューオンオプティマイザー

  • 百万トークンのコンテキスト長

  • Mixture-of-Expertsモデル

  • オープンソース

  • 3つの推論努力モード

  • 包括的なポストトレーニングパイプライン

  1. モデルページにアクセス: Hugging Faceのモデルページを訪問

  2. 認証: Hugging Faceアカウントにログイン

  3. 設定: 希望するパラメータでモデルを設定

  4. プロンプトを送信: 処理するためのテキストプロンプトを入力

  5. ファインチューニング: 特定のタスクに合わせてモデル設定を調整

  • 長コンテキスト処理
  • 複雑な問題解決
  • 日常的なタスク
  • コーディングベンチマーク
  • 推論タスク

DeepSeek-V4-Pro-DSpark のレビュー

読み込み中...

DeepSeek-V4-Pro-DSpark に似た人気のAIツール

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

AIモデルとLLM
ツールを見る

効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

注目AIモデルとLLM
LLM トップ50を見る

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

AIモデルとLLM

LLMで第31位

ツールを見る

6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

注目AIモデルとLLM
LLMで第31位

MiMo-V2.5-Pro

AI モデル

MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
ツールを見る

AI モデル

複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
AI モデル トップ5を見る

Hy4 Previewは、Tencent Hyチームによって開発された新世代のMixture-of-Expertsモデルです。7700億のパラメータを特徴とし、ソフトウェアエンジニアリング、ゲーム開発、科学研究など、さまざまな分野での生産性向上を目的としています。

AIモデルとLLM

LLMで第35位

ツールを見る

Tencent Hyチームによって開発された新世代のMixture-of-Expertsモデルです。7700億のパラメータを特徴とし、ソフトウェアエンジニアリング、ゲーム開発、科学研究など、さまざまな分野での生産性向上を目的としています。Hy4 Previewは、Tencent Hyチームによって開発された新世代のMixture-of-Expertsモデルです。7700億のパラメータを特徴とし、ソフトウェアエンジニアリング、ゲーム開発、科学研究など、さまざまな分野での生産性向上を目的としています。

AIモデルとLLM
LLMで第35位

Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

AIモデルとLLM

LLMで第18位

ツールを見る

Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。Solar Open 2は、Upstageによって開発された大規模言語モデルで、オフィスの生産性やコーディングなどのエージェント的なユースケースに特化しています。ハイブリッドアテンションミクスチャーオブエキスパートアーキテクチャを採用しており、効率的な推論と多言語サポートを提供します。

AIモデルとLLM
LLMで第18位

Laguna M.1は、エージェントコーディングと長期タスクのために設計された225BパラメータのMixture-of-Expertsモデルです。高容量の専門家ルーティングとグローバルアテンションアーキテクチャを特徴としており、さまざまなベンチマークで優れたパフォーマンスを発揮します。

AIモデルとLLM

LLMで第36位

ツールを見る

エージェントコーディングと長期タスクのために設計された225BパラメータのMixture-of-Expertsモデルです。高容量の専門家ルーティングとグローバルアテンションアーキテクチャを特徴としており、さまざまなベンチマークで優れたパフォーマンスを発揮します。Laguna M.1は、エージェントコーディングと長期タスクのために設計された225BパラメータのMixture-of-Expertsモデルです。高容量の専門家ルーティングとグローバルアテンションアーキテクチャを特徴としており、さまざまなベンチマークで優れたパフォーマンスを発揮します。

AIモデルとLLM
LLMで第36位

MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM

LLMで第49位

ツールを見る

コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM
LLMで第49位

Ling-3.0-tinyは、7.9Bパラメータを持つ軽量ハイブリッド推論モデルで、効率的なローカルデプロイメントのために設計されています。迅速な応答と多段階推論をサポートし、リソース制約のある環境に適しています。

AIモデルとLLM
ツールを見る

7.9Bパラメータを持つ軽量ハイブリッド推論モデルで、効率的なローカルデプロイメントのために設計されています。迅速な応答と多段階推論をサポートし、リソース制約のある環境に適しています。Ling-3.0-tinyは、7.9Bパラメータを持つ軽量ハイブリッド推論モデルで、効率的なローカルデプロイメントのために設計されています。迅速な応答と多段階推論をサポートし、リソース制約のある環境に適しています。

AIモデルとLLM
LLM トップ50を見る
1 / 8