説明
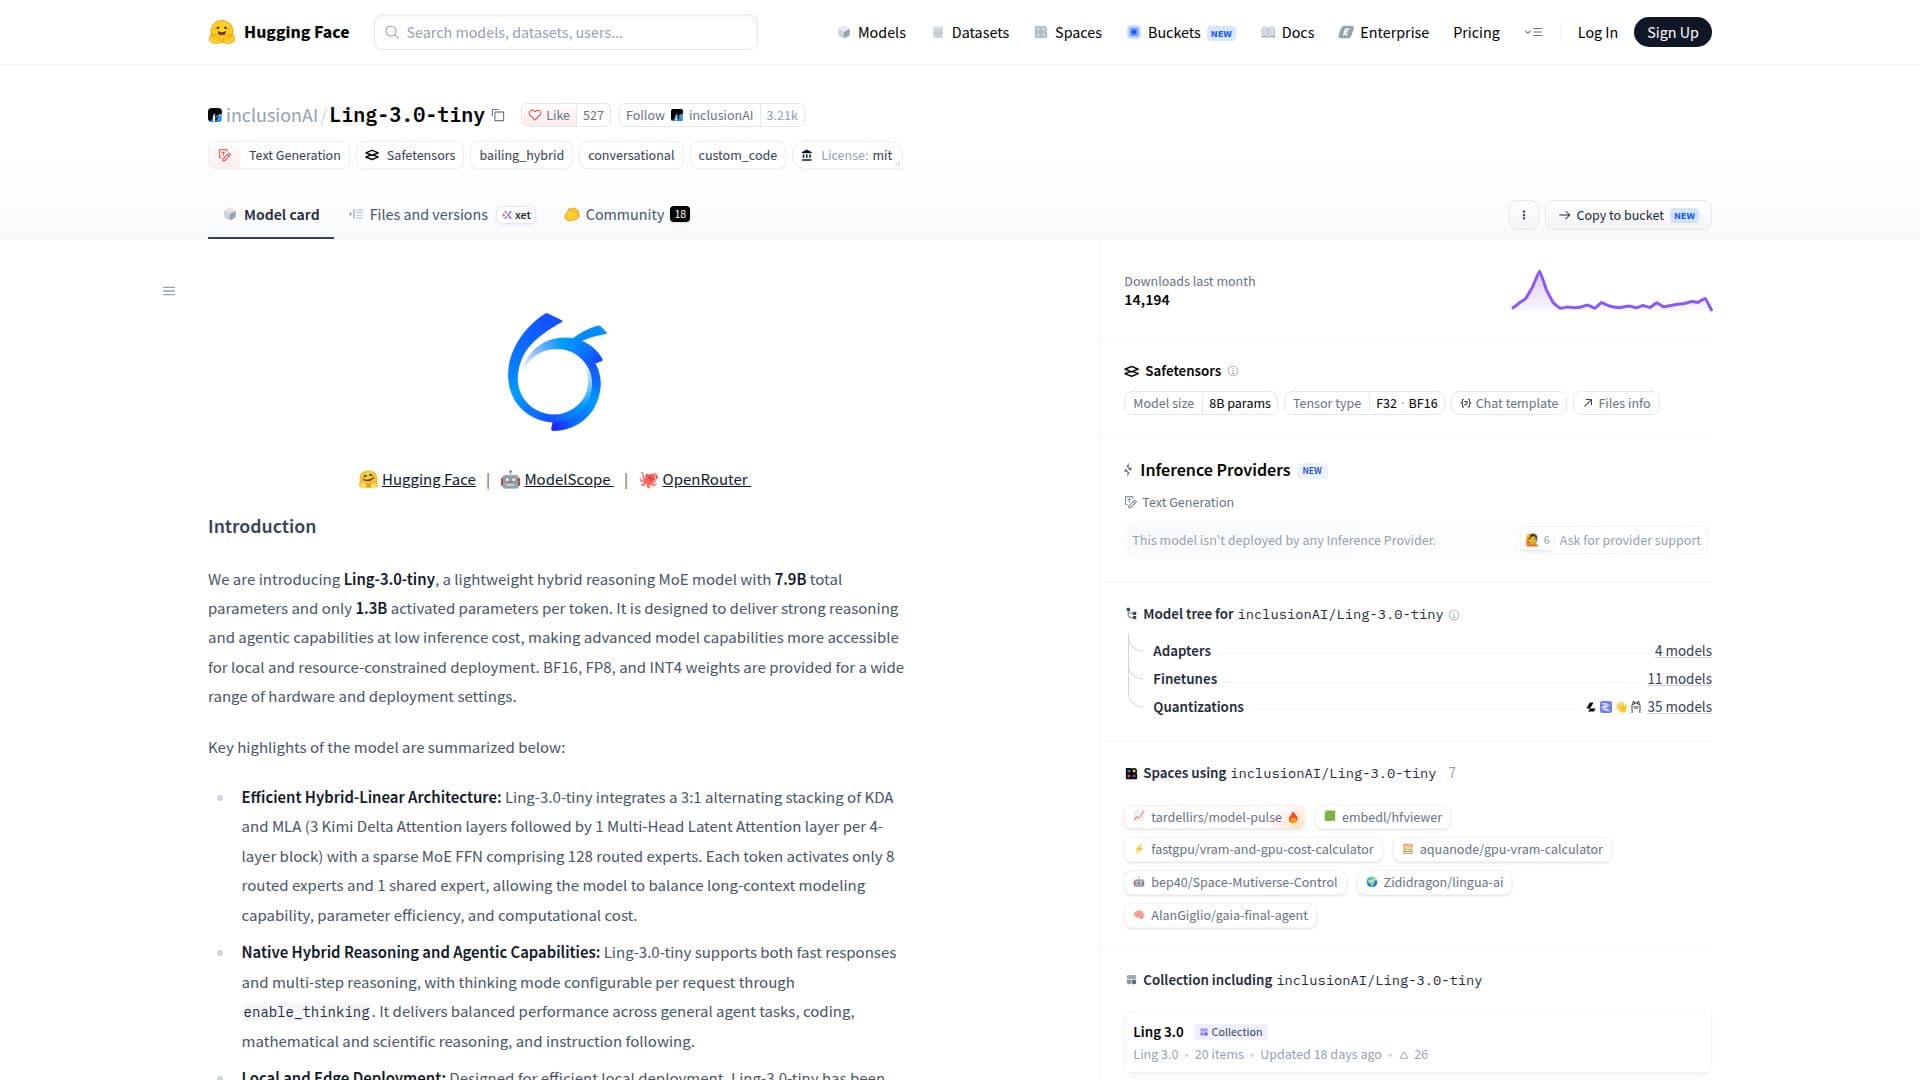
Ling-3.0-tinyは、inclusionAIによって開発され、Hugging Faceにホストされている軽量ハイブリッド推論モデルです。合計7.9億のパラメータを持ち、トークンごとに1.3億のみがアクティブ化されるため、ローカルおよびリソース制約のあるデプロイメントにおいて効率的です。このモデルは、Kimi Delta Attention (KDA)とMulti-Head Latent Attention (MLA)レイヤーの3:1交互スタッキングと、128のルーティングされたエキスパートを含むスパースMixture of Experts (MoE)フィードフォワードネットワーク(FFN)を統合しています。このアーキテクチャにより、モデルは長いコンテキストモデリング能力、パラメータ効率、計算コストのバランスを取ることができます。
続きを読む
Ling-3.0-tinyは、低い推論コストで強力な推論能力とエージェント能力を提供するように設計されています。迅速な応答と多段階推論をサポートし、設定可能な思考モードを備えています。このモデルは、NVIDIA DGX SparkやApple Silicon MacBookなどのさまざまなハードウェアで検証されており、データセンタークラスのGPUを必要とせずに、能力のある推論とエージェントワークロードを実現します。FP8を使用することで、DGX Sparkでは約100-105トークン/秒、M4 Pro MacBookでは86-90トークン/秒を達成し、8Kコンテキスト長で約8.34 GiBのピークメモリ使用量を示します。
このモデルの効率は、Artificial Analysis Intelligence Index v4.1.1でのスコア25やArtificial Analysis Agentic Indexでのスコア16により強調されています。500トークンの応答に対して、約18秒のエンドツーエンドのレイテンシで160トークン/秒以上の出力速度を達成します。Ling-3.0-tinyは、エージェントタスク、コーディング、長いコンテキスト理解、知識の信頼性、数学的および科学的推論、指示の実行など、幅広いタスクに適しています。
- カテゴリーAIモデルとLLM
- 料金モデルフリーミアム
- デプロイローカルで実行
- プラットフォームWeb
Ling-3.0-tinyのハイライト
合計7.9Bパラメータ
トークンごとに1.3Bのアクティブ化されたパラメータ
ハイブリッド推論能力
効率的なローカルデプロイメント
3:1 KDA-MLAアーキテクチャ
128のエキスパートを持つスパースMoE FFN
迅速な応答と多段階推論をサポート
NVIDIA DGX SparkおよびApple Siliconで検証済み
Ling-3.0-tinyをはじめる
モデルページにアクセス: Hugging Faceを訪問
認証: アカウントにログイン
設定: モデルパラメータを設定
プロンプトを送信: モデルを推論に使用
ファインチューニング: 特定のタスクに合わせて設定を調整
Ling-3.0-tinyの使用例
- エージェントタスク
- コーディング
- 科学的推論
- 指示の実行
- ローカルデプロイメント