メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

DeepSeek-V3

注目
LLM#30AIモデルとLLMオープンソース · Web

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

URLを訪問
共有
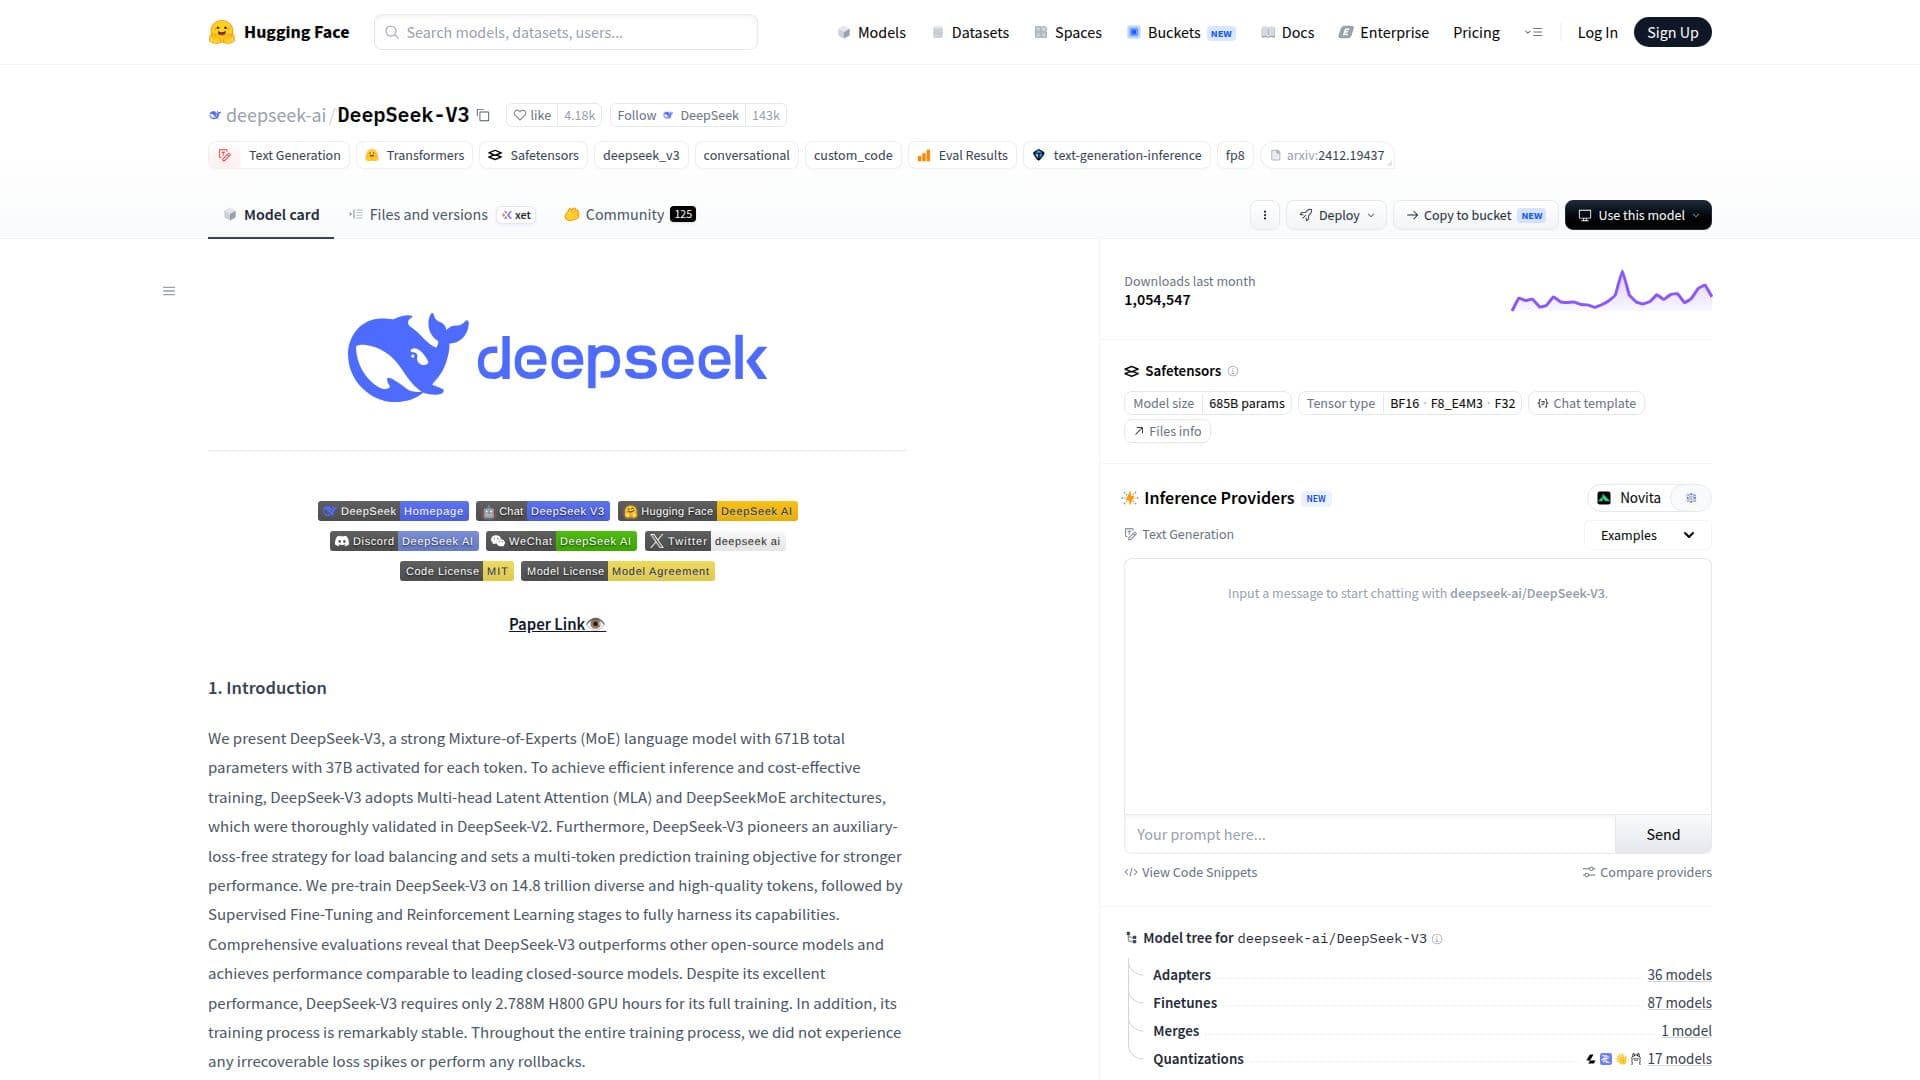
DeepSeek-V3 のスクリーンショット

DeepSeek-V3は、オープンソースの手法を通じて人工知能を進化させ、民主化するために開発された堅牢なMixture-of-Experts(MoE)言語モデルです。合計6710億のパラメータのうち、各トークンに対して370億がアクティブ化されており、DeepSeek-V3は効率的な推論とコスト効果の高いトレーニングのために設計されています。このモデルは、前モデルであるDeepSeek-V2で検証されたMulti-head Latent Attention(MLA)やDeepSeekMoEなどの革新的なアーキテクチャを組み込んでいます。

続きを読む

DeepSeek-V3の重要な進展の一つは、負荷バランスを促進しながらパフォーマンスの劣化を最小限に抑える補助損失なしの負荷バランス戦略です。さらに、全体的なパフォーマンスを向上させるマルチトークン予測トレーニング目標を導入しています。このモデルは、印象的な148兆の多様で高品質なトークンで事前トレーニングされ、その後、能力を最大限に活用するために監視付きファインチューニングと強化学習の段階を経ています。

包括的な評価により、DeepSeek-V3は他のオープンソースモデルを上回り、主要なクローズドソースモデルと同等のパフォーマンスレベルを達成しています。特に、完全なトレーニングにはわずか278.8万H800 GPU時間を必要とし、回復不可能な損失スパイクやロールバックを回避する非常に安定したトレーニングプロセスを持っています。

DeepSeek-V3は、自然言語理解、生成、推論タスクなど、さまざまなアプリケーションに対応するように設計されています。モデルをローカルで実行するための複数の方法をサポートしており、開発者や研究者に柔軟性を提供します。モデルはHugging Faceからダウンロード可能で、ローカルデプロイメントのための詳細なガイダンスが提供されています。数多くのベンチマークでの強力なパフォーマンスにより、DeepSeek-V3はAIの分野での主要なオープンソースモデルとして際立っています。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド, セルフホスト
  • プラットフォームWeb

  • 総パラメータ: 671B

  • アクティブパラメータ: 37B

  • コンテキスト長: 128K

  • トレーニング時間: 278.8万H800 GPU時間

  • オープンソース: はい

  • マルチトークン予測: はい

  • 負荷バランス戦略: 補助損失なし

  • ファインチューニングサポート: はい

  1. ページにアクセス: Hugging FaceのDeepSeek-V3ページを訪問します。

  2. モデルをロード: Hugging Faceからモデルの重みをダウンロードします。

  3. 環境を設定: 推論に必要なソフトウェアとハードウェアを設定します。

  4. 統合: 提供されたフレームワーク(SGLangやLMDeployなど)を使用して統合します。

  5. ファインチューニング: 必要に応じて、特定のデータセットでモデルをファインチューニングします。

  • 自然言語理解
  • テキスト生成
  • 推論タスク
  • チャットボット開発
  • コンテンツ作成

DeepSeek の製品

DeepSeek-V3 のレビュー

読み込み中...

DeepSeek-V3 に似た人気のAIツール

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

AIモデルとLLM
ツールを見る

効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

注目AIモデルとLLM
LLM トップ50を見る

DeepSeek-V3

AI GitHub リポジトリ

DeepSeek-V3は、DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…DeepSeek-V3は、DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
ツールを見る

高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
AI アプリ トップ250を見る

MiMo-V2.5-Pro

AI モデル

MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
ツールを見る

AI モデル

複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
AI モデル トップ5を見る

Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第44位

ツールを見る

高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第44位

DeepSeekは、一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。

AIモデルとLLM

LLMで第2位

ツールを見る

一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。DeepSeekは、一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。

注目AIモデルとLLM
LLMで第2位

Mixtral-8x7B-Instruct-v0.1は、高度なAIアプリケーション向けに設計された事前学習済みの生成的スパースエキスパートモデルです。さまざまなベンチマークでLlama 2 70Bを上回り、自然言語処理におけるファインチューニングと推論タスクのための堅牢なソリューションを提供します。

AIモデルとLLM
ツールを見る

高度なAIアプリケーション向けに設計された事前学習済みの生成的スパースエキスパートモデルです。さまざまなベンチマークでLlama 2 70Bを上回り、自然言語処理におけるファインチューニングと推論タスクのための堅牢なソリューションを提供します。Mixtral-8x7B-Instruct-v0.1は、高度なAIアプリケーション向けに設計された事前学習済みの生成的スパースエキスパートモデルです。さまざまなベンチマークでLlama 2 70Bを上回り、自然言語処理におけるファインチューニングと推論タスクのための堅牢なソリューションを提供します。

注目AIモデルとLLM
AI モデル トップ5を見る

SmolLM3は、3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。

AIモデルとLLM

LLMで第45位

ツールを見る

3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。SmolLM3は、3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。

AIモデルとLLM
LLMで第45位
1 / 8