メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

DeepSeek-V4-Pro

注目
LLMAIモデルとLLMオープンソース · Web

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

URLを訪問
共有
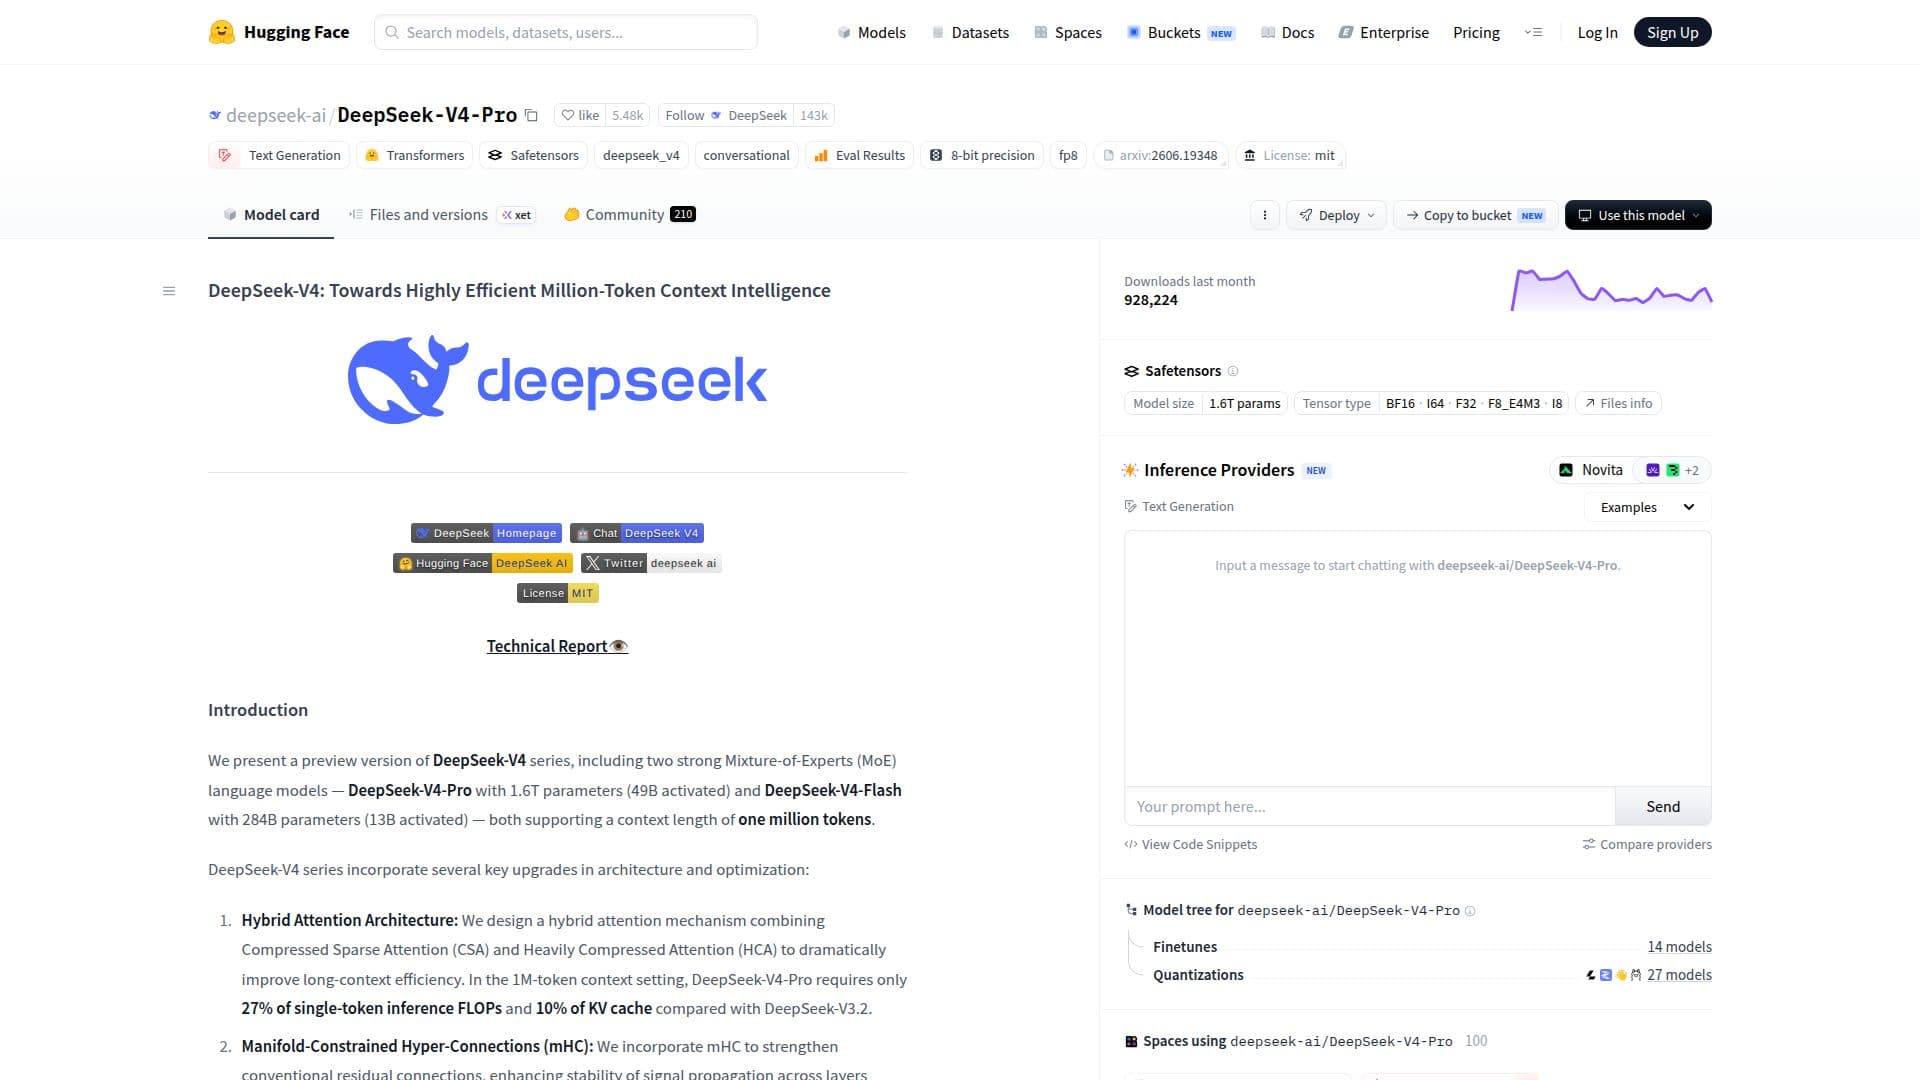
DeepSeek-V4-Pro のスクリーンショット

DeepSeek-V4-Proは、オープンソースとオープンサイエンスを通じて人工知能を進化させ、民主化することを目指すDeepSeek-V4シリーズの一部です。このモデルは、2つの強力なMixture-of-Experts (MoE)言語モデルを組み込んでおり、DeepSeek-V4-Proは1.6兆のパラメータを持ち、百万トークンのコンテキスト長をサポートしています。

続きを読む

DeepSeek-V4-Proのアーキテクチャには、Compressed Sparse Attention (CSA)とHeavily Compressed Attention (HCA)を組み合わせたハイブリッドアテンションメカニズムなど、いくつかの重要なアップグレードが含まれています。この設計は、長いコンテキストの効率を劇的に改善し、前モデルであるDeepSeek-V3.2と比較して、単一トークン推論のFLOPsの27%とKVキャッシュの10%のみを必要とします。さらに、このモデルは、層間の信号伝播の安定性を向上させつつ、モデルの表現力を維持するためにManifold-Constrained Hyper-Connections (mHC)を採用しています。

より迅速な収束と高いトレーニングの安定性を確保するために、Muonオプティマイザーが利用されています。このモデルは、32兆トークン以上の多様なデータセットで事前学習され、その後、ドメイン特化型の専門家の独立した育成と、オンポリシー蒸留を通じた統一モデルの統合を含む包括的なポストトレーニングパイプラインが実施されます。

DeepSeek-V4-Pro-Maxは、DeepSeek-V4-Proの最大推論努力モードであり、オープンソースモデルの知識能力を大幅に向上させます。コーディングベンチマークでトップクラスのパフォーマンスを達成し、推論およびエージェントタスクにおいて先進的なクローズドソースモデルとのギャップを効果的に埋めます。このモデルの能力は、複雑な問題解決や計画タスクを含む幅広いアプリケーションに適しており、AI分野の開発者や研究者にとって貴重なツールとなります。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • モデルタイプ: Mixture-of-Experts

  • 総パラメータ数: 1.6T

  • アクティブパラメータ数: 49B

  • コンテキスト長: 1Mトークン

  • ハイブリッドアテンションアーキテクチャ: はい

  • Muonオプティマイザー: はい

  • 事前学習データ: 32Tトークン

  • ライセンス: MIT

  1. モデルにアクセス: DeepSeek-V4-ProのHugging Faceページを訪問してください。

  2. 認証: 必要に応じてアカウントを作成してください。

  3. 環境を設定: 必要なライブラリと依存関係が揃っていることを確認してください。

  4. API経由で統合: 提供されたAPIドキュメントを使用してモデルに接続してください。

  5. 最適化: 最良のパフォーマンスのためにサンプリングパラメータを調整してください。

  • 複雑な問題解決
  • コーディングベンチマーク
  • 研究アプリケーション
  • 自然言語処理
  • エージェントタスク

DeepSeek の製品

DeepSeek のモデルです。

DeepSeek-V4-Pro のレビュー

読み込み中...

DeepSeek-V4-Pro に似た人気のAIツール

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

AIモデルとLLM

LLMで第31位

ツールを見る

6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

注目AIモデルとLLM
LLMで第31位

MiMo-V2.5-Pro

AI モデル

MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
ツールを見る

AI モデル

複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。MiMo-V2.5-Proは、複雑なタスク向けに設計された高度なオープンソースのMixture-of-Experts言語モデルです。ハイブリッドアテンションアーキテクチャを特徴とし、最大1Mトークンのコンテキスト長をサポートしているため、要求の厳しいソフトウェアエンジニアリングや長期的なタスクに最適です。

AIモデルとLLM
AI モデル トップ5を見る

DeepSeek-V3

AI GitHub リポジトリ

DeepSeek-V3は、DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…DeepSeek-V3は、DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第44位

ツールを見る

高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第44位

DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
ツールを見る

高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
AI アプリ トップ250を見る

DeepSeekは、一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。

AIモデルとLLM

LLMで第2位

ツールを見る

一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。DeepSeekは、一般的な人工知能の開発に専念するAI研究会社です。DeepSeek-V4、DeepSeek-R1、DeepSeek-Coderなどのオープンソースの最前線LLMを提供し、ユーザーはAIとチャットしたり、さまざまなアプリケーションのためにAPIを介して統合したりできます。

注目AIモデルとLLM
LLMで第2位

SmolLM3は、3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。

AIモデルとLLM

LLMで第45位

ツールを見る

3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。SmolLM3は、3Bパラメータの言語モデルであり、小型モデルの限界を押し広げることを目的としています。デュアルモード推論、6言語、長いコンテキスト処理をサポートし、3B–4Bスケールで強力なパフォーマンスを提供します。

AIモデルとLLM
LLMで第45位

DeepSeek-V3.2は、効率的な推論とエージェントタスクのために設計された高度なAIモデルです。DeepSeekスパースアテンション、スケーラブルな強化学習、そして大規模なエージェントタスク合成パイプラインを特徴としています。

AIモデルとLLM
ツールを見る

効率的な推論とエージェントタスクのために設計された高度なAIモデルです。DeepSeekスパースアテンション、スケーラブルな強化学習、そして大規模なエージェントタスク合成パイプラインを特徴としています。DeepSeek-V3.2は、効率的な推論とエージェントタスクのために設計された高度なAIモデルです。DeepSeekスパースアテンション、スケーラブルな強化学習、そして大規模なエージェントタスク合成パイプラインを特徴としています。

AIモデルとLLM
AI モデル トップ5を見る
1 / 8