

説明
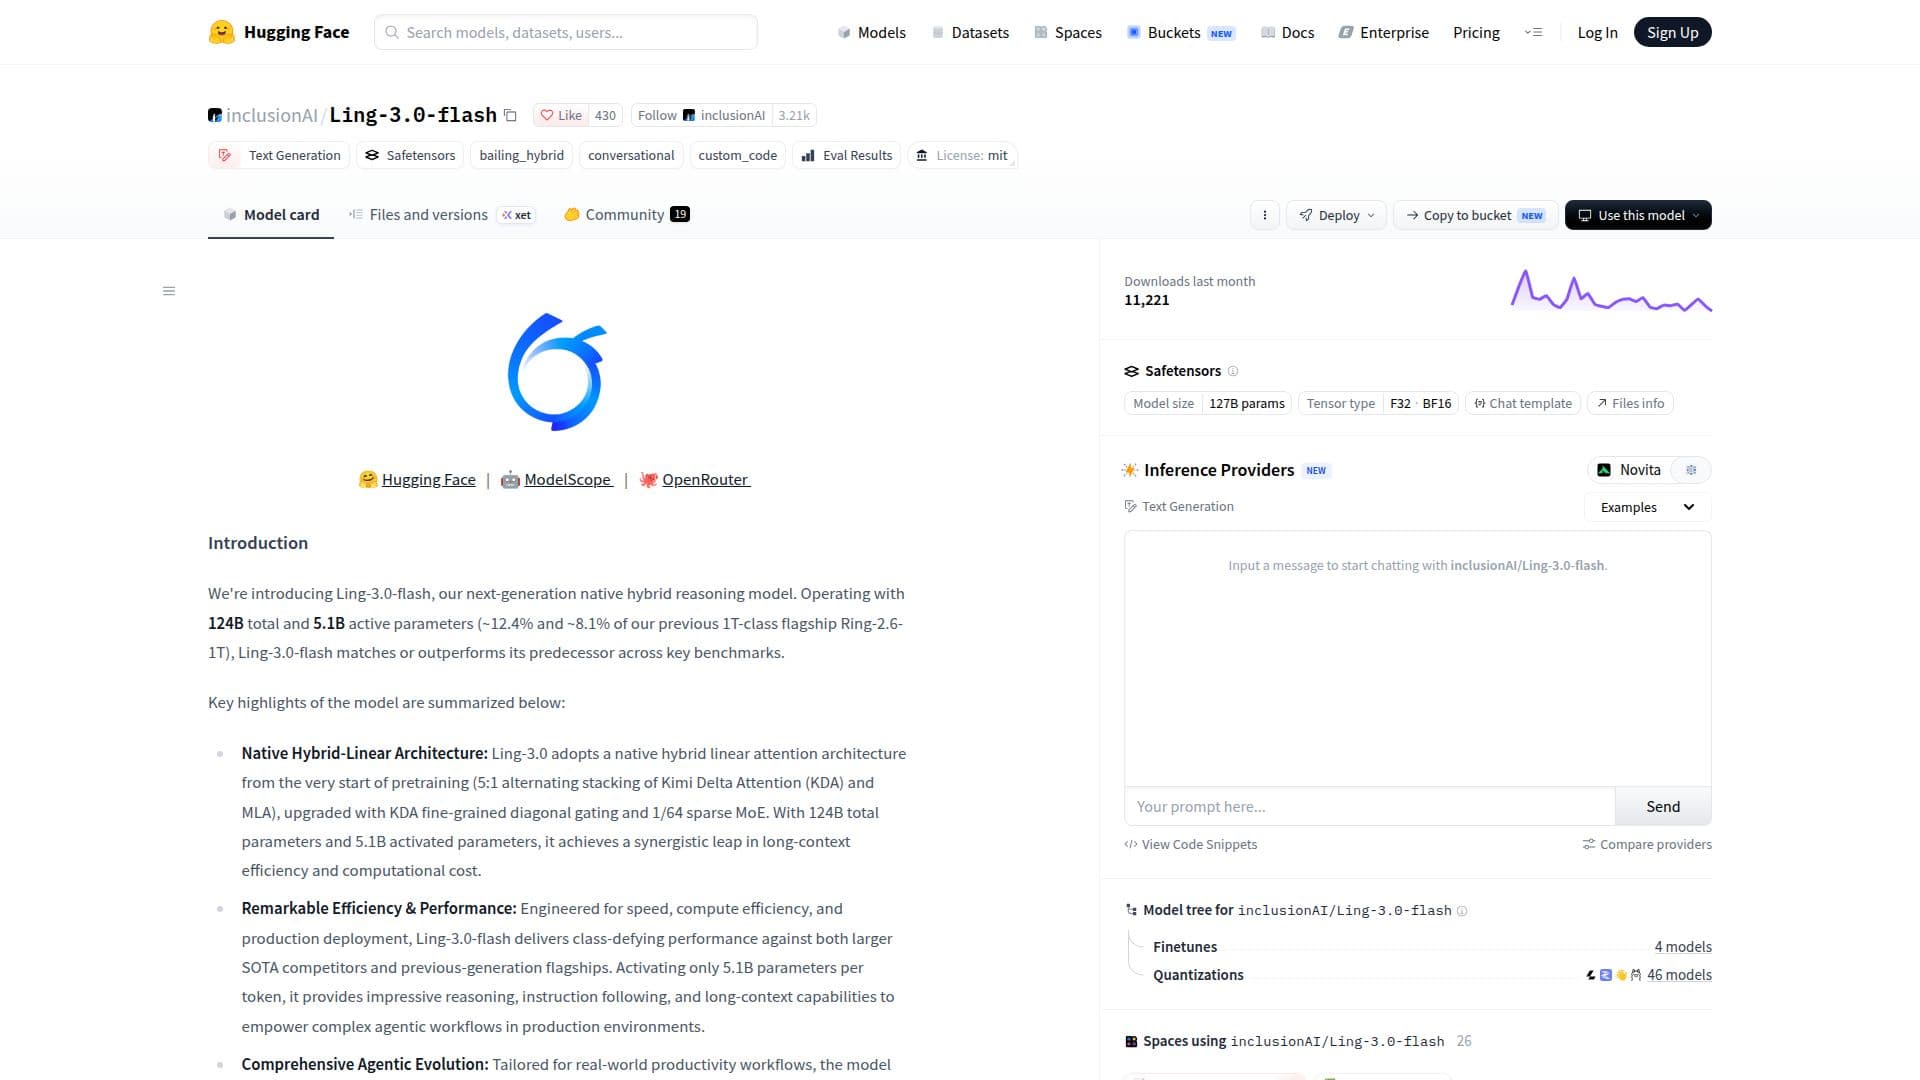
Ling-3.0-flashは、inclusionAIによって開発され、Hugging Faceにホストされている最先端のハイブリッド推論モデルです。合計1240億のパラメータを持ち、トークンごとに51億がアクティブ化され、驚異的な効率性とパフォーマンスを提供します。このモデルは、Kimi Delta Attention(KDA)とMLAを特徴とするネイティブハイブリッド線形注意アーキテクチャを採用しており、細かい対角ゲーティングとスパースMoEでアップグレードされています。このアーキテクチャにより、Ling-3.0-flashは長文コンテキストの効率性と計算コストにおいて相乗的な飛躍を達成します。
続きを読む
速度と計算効率を考慮して設計されたLing-3.0-flashは、より大きな最先端の競合他社や前世代のフラッグシップに対して、クラスを超えたパフォーマンスを提供します。生産環境における複雑なエージェントワークフローを強化し、トークンごとに51億のパラメータのみをアクティブ化します。このモデルは、コーディング、一般、深い研究エージェントタスクにわたるエンドツーエンドのクローズドループ実行を達成するために、10,000以上のインタラクティブなトレーニング環境を組み込んでいます。
Ling-3.0-flashは、物理的なデュアルプールとクラスタ共有のL3キャッシュを特徴とするSGLang HiCache + Mooncake階層キャッシングアーキテクチャを統合しています。このセットアップにより、長期的な相互作用中の冗長な再計算が排除され、長い入力シナリオにおける最初のトークンまでの時間(TTFT)が60%から80%以上短縮されます。このモデルは、SWE-Bench Pro、SWE-Bench Multilingual、Tau3-banking-AA、MCP-Atlas、SkillsBenchなど、複数の権威あるベンチマークで強力なパフォーマンスを発揮します。
このモデルは、実世界の生産性ワークフローに合わせて調整されており、一般知識、数学的推論、指示の遵守、長文コンテキストの理解において強力なパフォーマンスを提供します。Ling-3.0-flashは、生産展開のために設計されており、印象的な推論能力と長文コンテキストの効率性を提供し、複雑なエージェントワークフローに適しています。
- カテゴリーAIモデルとLLM
- 料金モデルフリーミアム
- デプロイクラウド
- プラットフォームWeb
Ling-3.0-flashのハイライト
ネイティブハイブリッド線形アーキテクチャ
驚異的な効率性とパフォーマンス
包括的なエージェント進化
SGLang HiCache + Mooncakeキャッシング
エンドツーエンドのクローズドループ実行
長文コンテキストの効率性
指示の遵守
数学的推論
Ling-3.0-flashをはじめる
モデルページにアクセス: Hugging Faceを訪問
認証: アカウントにログイン
設定: パラメータと好みを設定
プロンプトを送信: クエリを入力
ファインチューニング: モデル設定を調整
Ling-3.0-flashの使用例
- コーディングタスク
- 研究エージェント
- 指示の遵守
- 長文コンテキストの理解
- 数学的推論







