メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

ステップ 3.7 フラッシュ

ステップ 3.7 フラッシュは、高頻度の生産ワークロード向けに設計されたスパースなMixture-of-Expertsビジョン・ランゲージモデルです。言語バックボーンとビジョンエンコーダーを組み合わせて、財務報告の解析やマルチステップ検索ループの実行などの集中的なタスクをサポートします。

  • 12,226 フォロワー — X (Twitter)
  • 1,737 フォロワー — GitHub
URLを訪問
共有
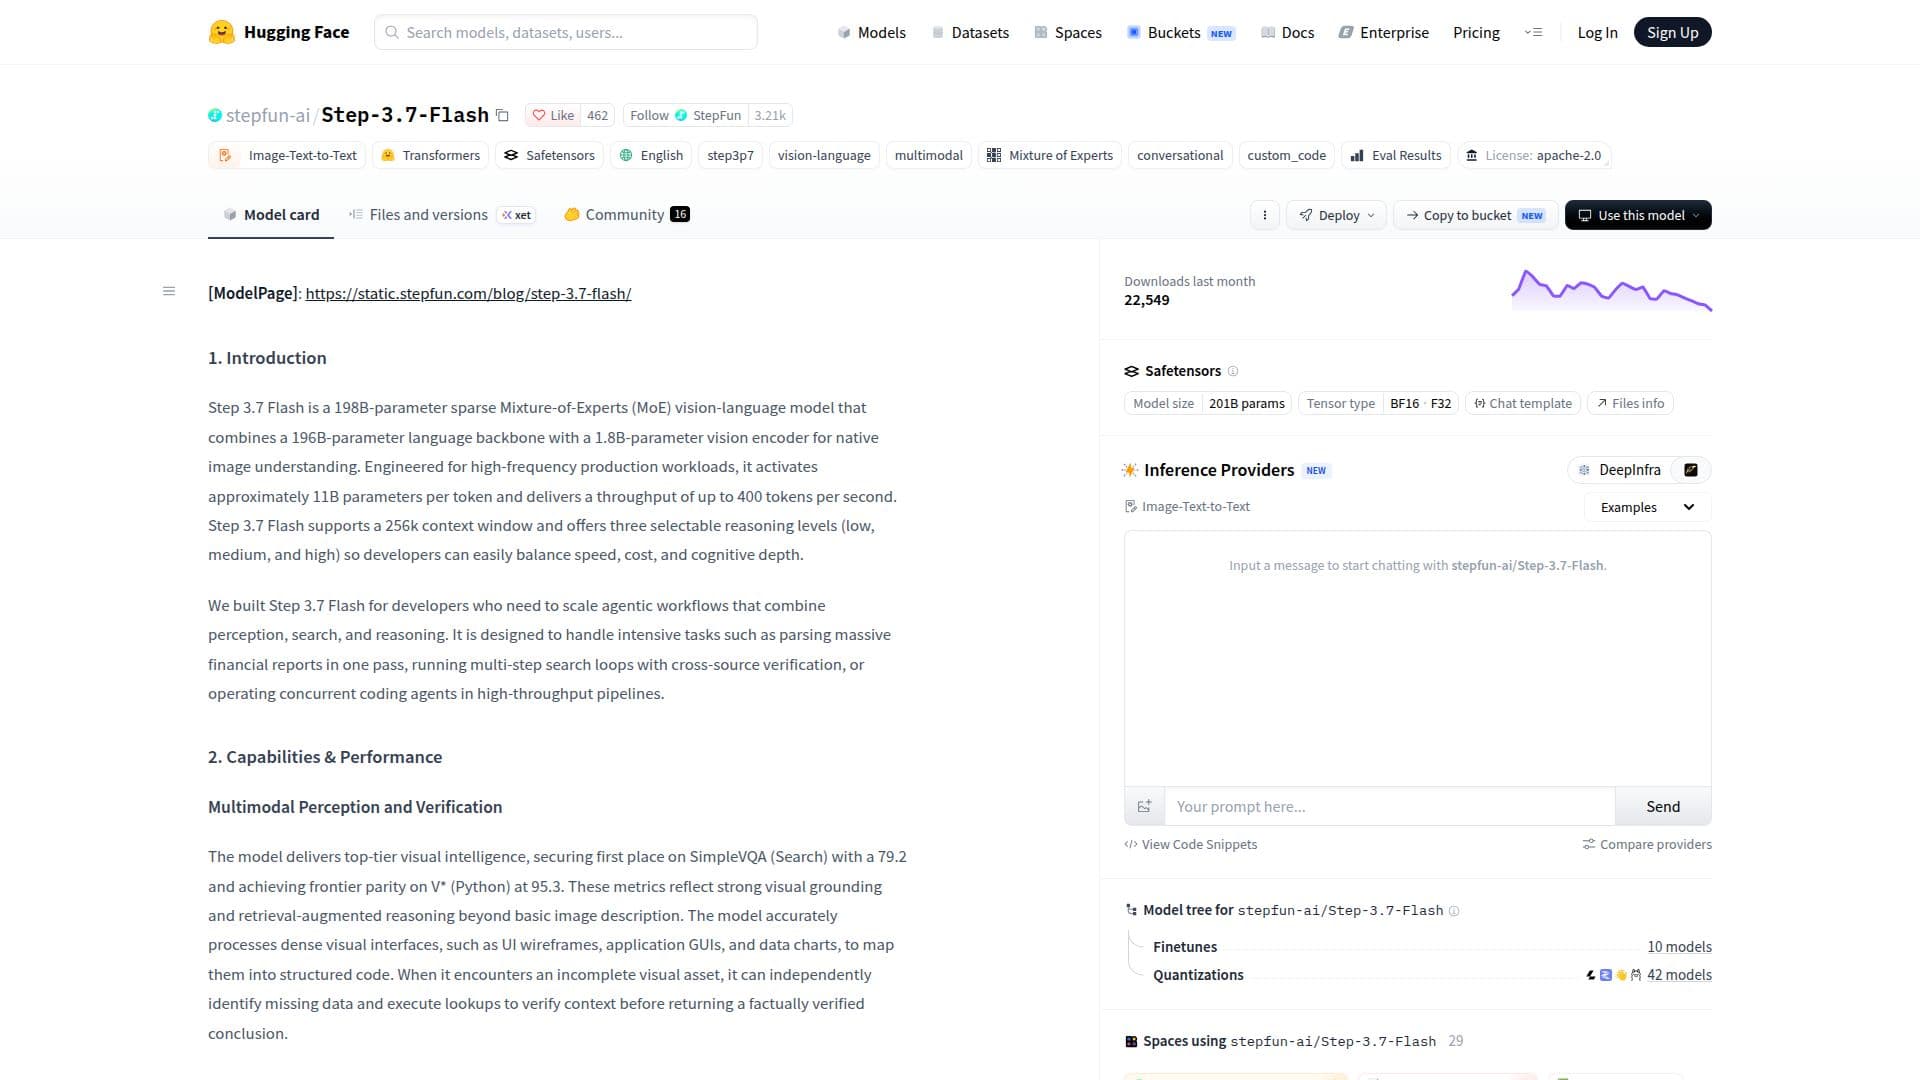
ステップ 3.7 フラッシュ のスクリーンショット

ステップ 3.7 フラッシュは、198BパラメータのスパースなMixture-of-Experts (MoE) ビジョン・ランゲージモデルであり、高頻度の生産ワークロードを処理するように設計されています。196Bパラメータの言語バックボーンと1.8Bパラメータのビジョンエンコーダーを組み合わせて、ネイティブな画像理解を可能にし、UIワイヤーフレームやデータチャートなどの密な視覚インターフェースを処理します。

続きを読む

このモデルは、トークンごとに約11Bのパラメータをアクティブにし、最大400トークン/秒のスループットを提供し、256kのコンテキストウィンドウをサポートします。開発者は、スピード、コスト、認知の深さをバランスさせるために、低、中、高の3つの選択可能な推論レベルを提供します。

ステップ 3.7 フラッシュは、知覚、検索、推論を組み合わせたエージェントワークフローをスケールさせる必要がある開発者向けに設計されています。1回のパスで膨大な財務報告を解析したり、クロスソース検証を伴うマルチステップ検索ループを実行したり、高スループットパイプラインで同時コーディングエージェントを操作するタスクに優れています。

このモデルは、トップクラスの視覚知能を提供し、SimpleVQA (検索) で79.2のスコアを獲得し、V* (Python) で95.3のフロンティアパリティを達成しています。密な視覚インターフェースを正確に処理し、欠落データを独立して特定し、事実確認された結論を返す前にコンテキストを検証するためのルックアップを実行できます。

ステップ 3.7 フラッシュは、ClawEval-1.1ベンチマークで67.1のスコアを記録し、敵対的トラップに対する高い耐性を示し、マルチターンオーケストレーション中にシステムポリシーを厳守します。外部APIと信頼性のあるインタラクションを行い、指示から逸脱することなく、システム制約を違反することなく長期的なワークフローを実行します。

ステップ 3.7 フラッシュの価格は、入力キャッシュミスに対して100万トークンあたり0.20ドル、入力キャッシュヒットに対して100万トークンあたり0.04ドル、出力に対して100万トークンあたり1.15ドルです。このモデルは、StepFunオープンプラットフォーム、OpenRouter、およびNVIDIA NIMで利用可能であり、DeepInfra、Fireworks AI、Modalとのパートナーシップを通じて利用可能性を拡大する計画があります。

ステップ 3.7 フラッシュは、クラウド、データセンター、ローカル環境での柔軟なデプロイメントをサポートし、vLLM、SGLang、Hugging Face Transformers、llama.cppなどの業界標準のバックエンドを使用してローカル推論に最適化されています。NVIDIA Nemoエコシステムを含む、推論およびモデル開発のための人気のオープンソースインフラストラクチャでサポートされています。

  • カテゴリーAIモデルとLLM
  • 料金モデル有料
  • デプロイクラウド, ローカルで実行
  • プラットフォームWeb

  • 198BパラメータのスパースMoEモデル

  • 196B言語バックボーン

  • 1.8Bビジョンエンコーダー

  • トークンごとに11Bのパラメータがアクティブ

  • 400トークン/秒のスループット

  • 256kコンテキストウィンドウ

  • 3つの推論レベル

  • トップクラスの視覚知能

  1. モデルページにアクセス: Hugging Faceモデルページを訪問

  2. 認証: APIキーを使用して認証

  3. 設定: モデルパラメータを設定

  4. プロンプトを送信: 処理のためにクエリを入力

  5. ファインチューニング: 特定のタスクに合わせてモデルを調整

  • 財務報告の解析
  • マルチステップ検索ループ
  • コーディングエージェントの操作
  • 密な視覚インターフェースの処理
  • 自律的APIインタラクション

ステップ 3.7 フラッシュ のレビュー

読み込み中...

ステップ 3.7 フラッシュ に似た人気のAIツール

Ling-3.0-flashは、効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。

AIモデルとLLM
ツールを見る

効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。Ling-3.0-flashは、効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。

AIモデルとLLM
LLM トップ50を見る

DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
ツールを見る

視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
LLM トップ50を見る

Kolibri 1は、Aleph Alphaによって開発された多言語大規模言語モデルです。多段階の推論、検索強化生成、コーディングタスクに優れ、ドイツ語と英語の両方をサポートしています。このモデルは、大きなコンテキストウィンドウを持つ複雑なタスクのために設計されており、Apache 2.0ライセンスの下で利用可能です。

AIモデルとLLM

LLMで第20位

ツールを見る

Aleph Alphaによって開発された多言語大規模言語モデルです。多段階の推論、検索強化生成、コーディングタスクに優れ、ドイツ語と英語の両方をサポートしています。このモデルは、大きなコンテキストウィンドウを持つ複雑なタスクのために設計されており、Apache 2.0ライセンスの下で利用可能です。Kolibri 1は、Aleph Alphaによって開発された多言語大規模言語モデルです。多段階の推論、検索強化生成、コーディングタスクに優れ、ドイツ語と英語の両方をサポートしています。このモデルは、大きなコンテキストウィンドウを持つ複雑なタスクのために設計されており、Apache 2.0ライセンスの下で利用可能です。

AIモデルとLLM
LLMで第20位

Ling-3.0-tinyは、7.9Bパラメータを持つ軽量ハイブリッド推論モデルで、効率的なローカルデプロイメントのために設計されています。迅速な応答と多段階推論をサポートし、リソース制約のある環境に適しています。

AIモデルとLLM
ツールを見る

7.9Bパラメータを持つ軽量ハイブリッド推論モデルで、効率的なローカルデプロイメントのために設計されています。迅速な応答と多段階推論をサポートし、リソース制約のある環境に適しています。Ling-3.0-tinyは、7.9Bパラメータを持つ軽量ハイブリッド推論モデルで、効率的なローカルデプロイメントのために設計されています。迅速な応答と多段階推論をサポートし、リソース制約のある環境に適しています。

AIモデルとLLM
LLM トップ50を見る

Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第47位

ツールを見る

高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第47位

DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
ツールを見る

高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
AI アプリ トップ250を見る

Laguna S 2.1は、エージェントコーディングと長期タスクのために設計されたMixture-of-Expertsモデルです。1180億のパラメータを特徴とし、高度な推論能力を提供し、複雑なソフトウェアエンジニアリングアプリケーションに適しています。

AIモデルとLLM

LLMで第37位

ツールを見る

エージェントコーディングと長期タスクのために設計されたMixture-of-Expertsモデルです。1180億のパラメータを特徴とし、高度な推論能力を提供し、複雑なソフトウェアエンジニアリングアプリケーションに適しています。Laguna S 2.1は、エージェントコーディングと長期タスクのために設計されたMixture-of-Expertsモデルです。1180億のパラメータを特徴とし、高度な推論能力を提供し、複雑なソフトウェアエンジニアリングアプリケーションに適しています。

AIモデルとLLM
LLMで第37位

Command A+ は、複雑な推論、視覚、48 言語にわたる多言語タスクのために設計された、25B のアクティブパラメータと 218B の総パラメータを持つ専門家の混合モデルです。企業向けに効率的で正確なソリューションを提供します。

AIモデルとLLM
ツールを見る

複雑な推論、視覚、48 言語にわたる多言語タスクのために設計された、25B のアクティブパラメータと 218B の総パラメータを持つ専門家の混合モデルです。企業向けに効率的で正確なソリューションを提供します。Command A+ は、複雑な推論、視覚、48 言語にわたる多言語タスクのために設計された、25B のアクティブパラメータと 218B の総パラメータを持つ専門家の混合モデルです。企業向けに効率的で正確なソリューションを提供します。

注目AIモデルとLLM
AI モデル トップ5を見る
1 / 8