説明
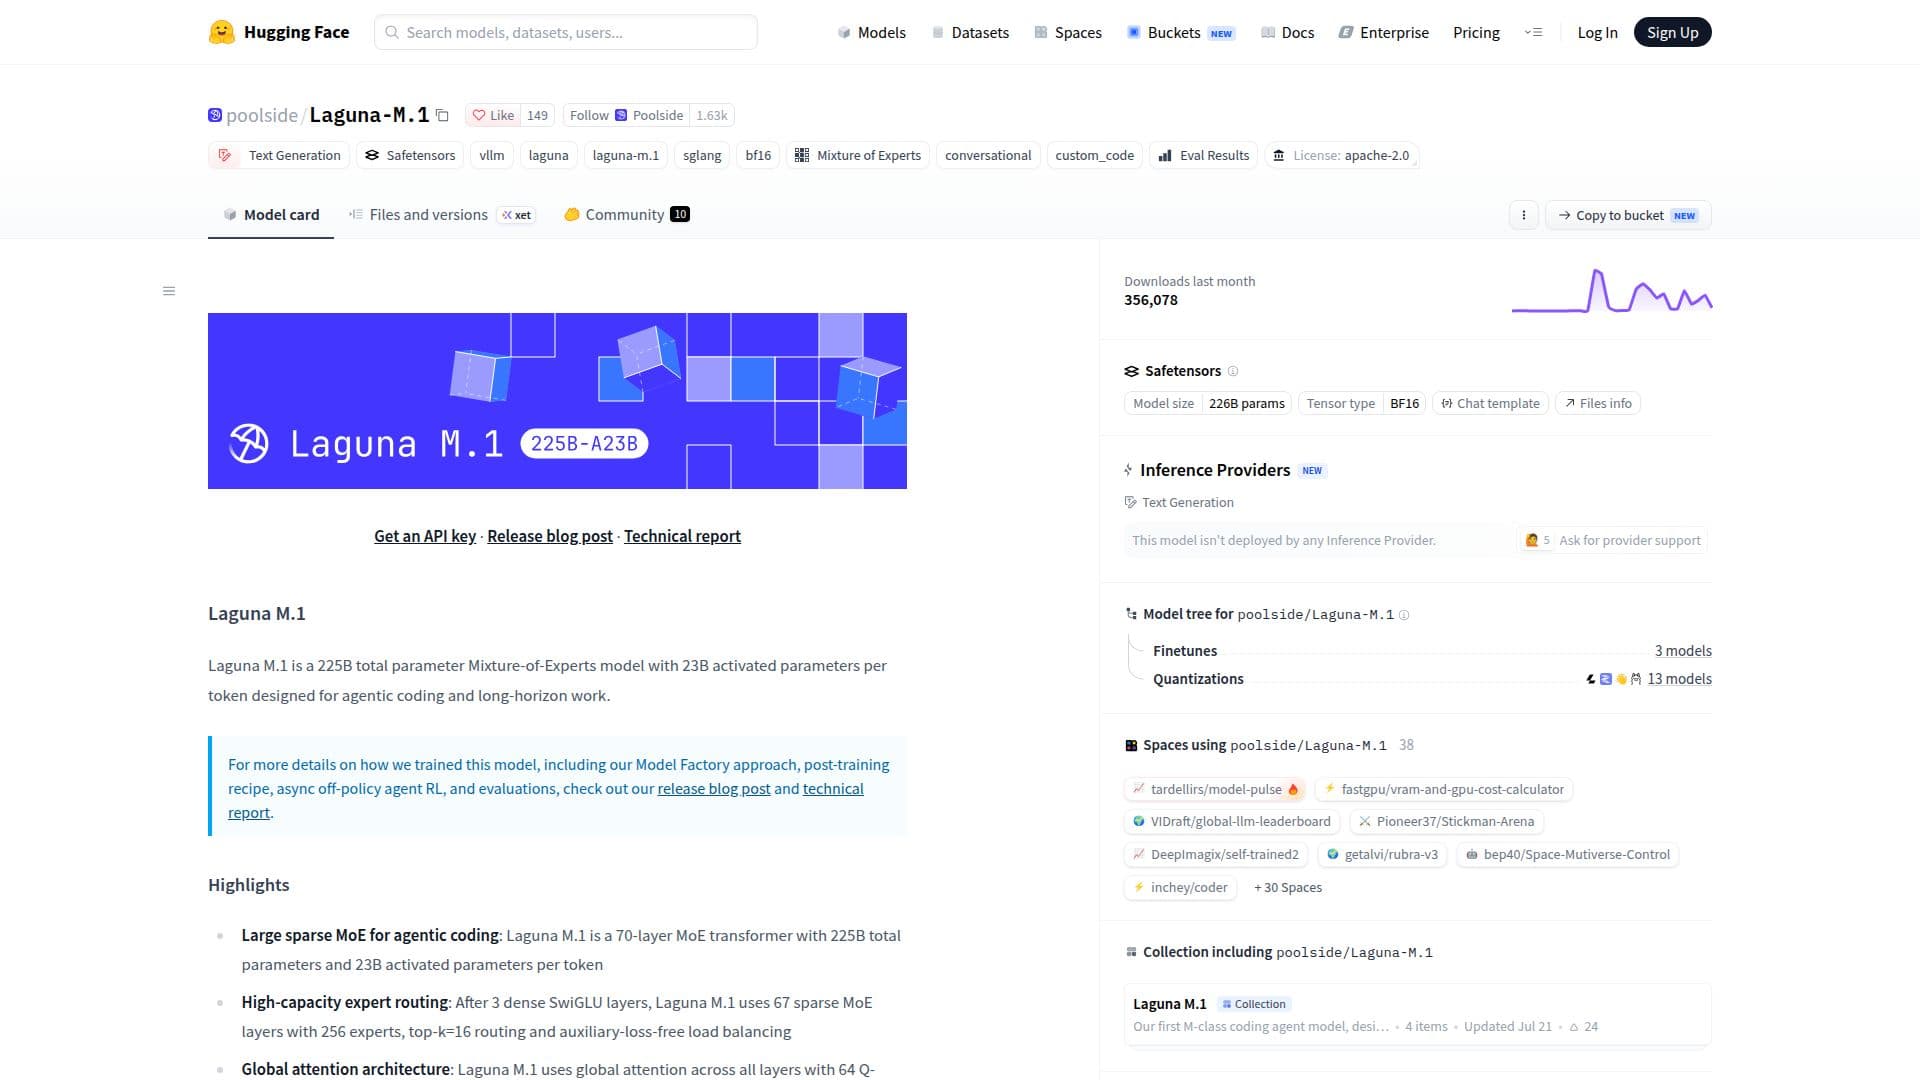
Laguna M.1は、エージェントコーディングと長期タスクのために開発された高度なMixture-of-Experts(MoE)モデルです。合計2250億パラメータとトークンごとに230億のアクティブパラメータを持ち、複雑な計算タスクを効率的に処理するように設計されています。このモデルは、256の専門家を持つ67のスパースMoEレイヤーを含む70のレイヤーで構成されており、高容量の専門家ルーティングメカニズムを利用しています。この設計により、top-k=16のルーティングと補助損失なしの負荷分散が可能になり、計算効率が向上します。
続きを読む
モデルは、すべてのレイヤーにわたってグローバルアテンションアーキテクチャを採用しており、64のQヘッドと8のKVヘッドを特徴とし、ソフトプラスアテンション出力ゲーティングを使用しています。このセットアップは、ツール呼び出し間のインタリーブ思考を可能にするネイティブ推論機能をサポートしており、リクエストごとに有効または無効にできます。Laguna M.1は、SWE-bench Verified、SWE-bench Multilingual、SWE-Bench Pro、Terminal-Bench 2.0などのいくつかのベンチマークで優れたパフォーマンスを示しており、最先端のモデルと競争力があります。
Laguna M.1はApache 2.0ライセンスの下でライセンスされており、商業目的および非商業目的の両方で自由に使用および変更できます。NVIDIAとのコラボレーションにより、vLLM、SGLang、Transformers、TRT-LLMなどのさまざまなプラットフォームでサポートされています。このモデルは、ソフトウェアエンジニアリングとエージェントコーディングのユースケースに設計されており、パフォーマンスを最適化するためにメッセージ履歴内の推論を保持することに重点を置いています。
ユーザーは、vLLMまたはSGLangを使用してLaguna M.1をローカルにデプロイでき、ツール呼び出し、ストリーミング応答、推論解析をサポートしています。モデルは、FP8やNVFP4などの量子化フォーマットでも利用可能で、さまざまなデプロイメントニーズに対応しています。その機能を探求したい方は、vLLMやSGLangなどのプラットフォームを通じてLaguna M.1にアクセスでき、それぞれのドキュメントに詳細なデプロイメントガイダンスが用意されています。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド, セルフホスト
- プラットフォームWeb, macOS, Linux
Laguna M.1のハイライト
合計パラメータ225B
トークンごとに230Bのアクティブパラメータ
70層のMoEトランスフォーマー
top-k=16ルーティングの256の専門家
グローバルアテンションアーキテクチャ
ネイティブ推論サポート
Apache 2.0ライセンス
強力なベンチマークパフォーマンス
Laguna M.1をはじめる
モデルページにアクセス: Laguna M.1のHugging Faceページを訪問
認証: アクセスのためのAPIキーを取得
設定: 希望のパラメータでモデルを設定
プロンプトを送信: テキストからテキストへのタスクにモデルを使用
ファインチューニング: 特定のユースケースにモデルを調整
Laguna M.1の使用例
- エージェントコーディング
- 長期タスク
- ベンチマークテスト
- ツール統合
- 研究開発