説明
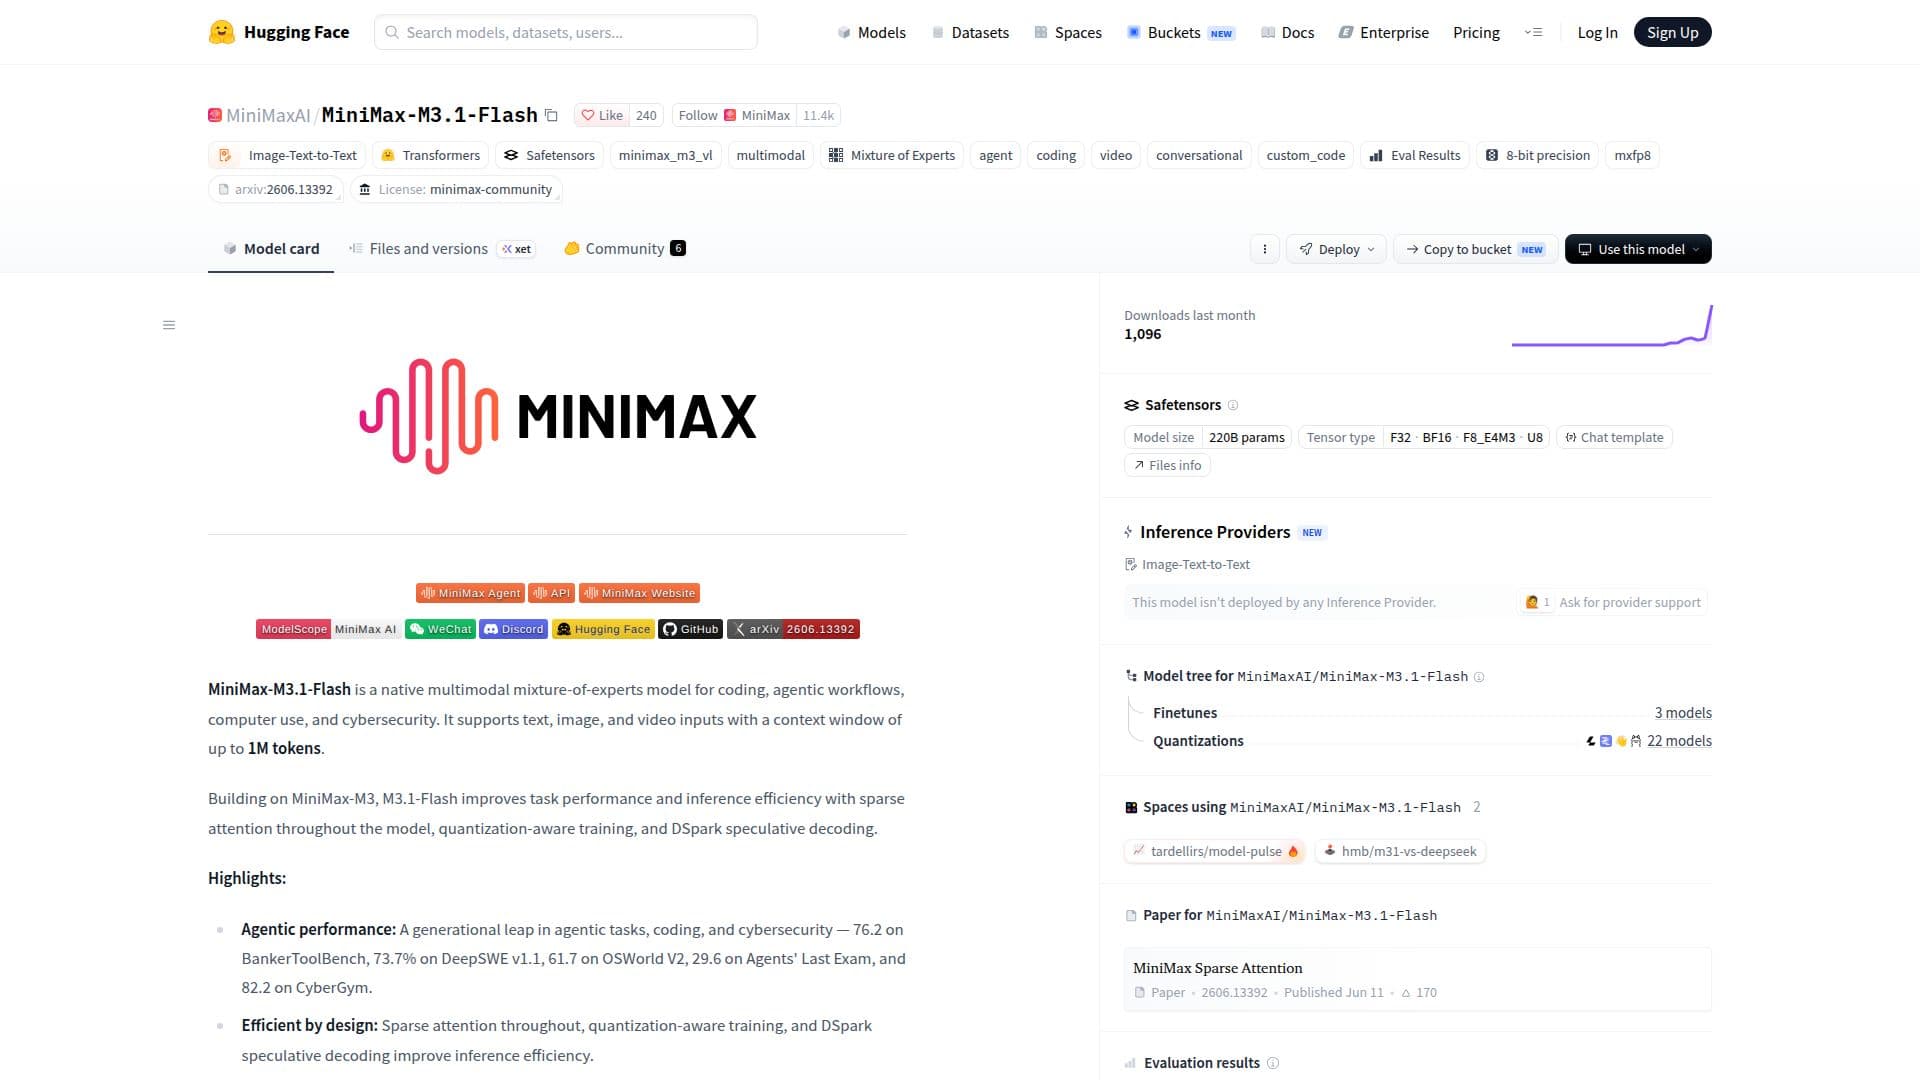
MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、コンピュータ利用、サイバーセキュリティを強化するために開発された先進的なマルチモーダルエキスパート混合モデルです。このモデルは、テキスト、画像、動画の入力をサポートし、最大1百万トークンのコンテキストウィンドウを提供します。MiniMax-M3アーキテクチャを基に、M3.1-Flashはモデル全体でスパースアテンションを使用し、量子化対応トレーニングとDSpark推測デコーディングを通じてタスクのパフォーマンスと推論効率を向上させています。
続きを読む
このモデルのアーキテクチャは、約4280億のパラメータを持ち、トークンごとに230億がアクティブ化されるように設計されています。これにより、さまざまなベンチマークで効率的な処理と高いパフォーマンスを実現しており、BankerToolBenchで76.2、CyberGymで82.2のスコアを達成しています。
M3.1-Flashは特にエージェントパフォーマンスに優れており、コーディングやサイバーセキュリティに関連するタスクにおいて飛躍的な進歩を提供します。DeepSWE v1.1で73.7%、OSWorld V2で61.7の高スコアを達成しています。モデルの効率は、メモリフットプリントを削減し、サービス効率を向上させるスパースアテンションや量子化対応トレーニングなどの機能によってさらに強化されています。
デプロイメントにおいて、MiniMax-M3.1-FlashはSGLang、vLLM、TokenSpeedなどのさまざまな推論フレームワークをサポートし、追加の統合も進行中です。このモデルはマルチチップデプロイメント用に設計されており、サービス構成の柔軟性を提供します。ユーザーは、特定のタスクに最適化するために、温度やtop_pなどの推論設定を調整できます。
全体として、MiniMax-M3.1-Flashは、マルチモーダルなコンテキストで高度なAI機能を活用し、複雑なワークフローやサイバーセキュリティアプリケーションをサポートするために開発者や研究者にとって強力なツールです。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド
- プラットフォームWeb
MiniMax-M3.1-Flashのハイライト
マルチモーダルエキスパート混合アーキテクチャ
テキスト、画像、動画の入力をサポート
最大1百万トークンのコンテキストウィンドウ
モデル全体でのスパースアテンション
量子化対応トレーニング
DSpark推測デコーディング
約4280億のパラメータ
複数のベンチマークでの高パフォーマンス
MiniMax-M3.1-Flashをはじめる
モデルページにアクセス: MiniMax-M3.1-Flashの公式Hugging Faceページを訪問
認証: モデルにアクセスするために必要な資格情報を確認
設定: お好みの推論フレームワークでモデルを設定
プロンプトを送信: 処理のためにテキスト、画像、または動画データを入力
ファインチューニング: 最適な結果のために温度やtop_pなどの設定を調整
MiniMax-M3.1-Flashの使用例
- コーディング支援
- サイバーセキュリティ
- エージェントワークフロー
- マルチモーダル処理
- 推論効率