

«Todavía no pretendemos entender del todo la demostración». Esa frase viene del comité que OpenAI nombró para examinar su supuesto resultado sobre Yang-Mills, citada por Scientific American. El grupo, dirigido por el físico David Gross, acababa de confirmar que la demostración de una de las dos mitades del problema se verifica en Lean, un lenguaje de programación que comprueba trabajo matemático. Aun así, no sabía explicar cómo funciona la demostración.
Leímos el material más reciente sobre IA para la ciencia: ese artículo, cinco publicaciones de Anthropic, un benchmark de laboratorio húmedo de OpenAI, TechCrunch sobre una startup llamada PSI, y la entrada de un bloguero cuyos agentes de IA detectaron un sitio maya que faltaba en el registro oficial de México. Los titulares van muy por delante de todo eso. Así que tomamos seis afirmaciones populares y comprobamos cada una contra lo que dicen realmente las fuentes.
Afirmación 1: la IA ya descubre ciencia nueva por sí sola
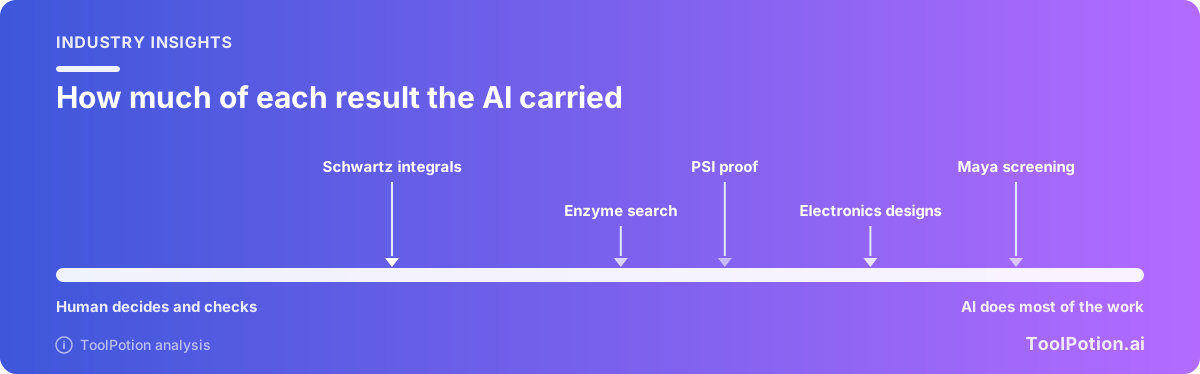
Veredicto: por sí sola, no. Los mejores casos son reales, y en todos una persona eligió la pregunta, hizo las comprobaciones, o ambas cosas.
Empecemos por la biología. Anthropic afirma que agentes de Claude encontraron un sistema enzimático con repeticiones tipo CRISPR, usando unos 950 agentes, 210 millones de tokens y 21 horas (Anthropic). Un agente detectó el patrón de repetición. Los científicos de Anthropic aportaron el prompt inicial e hicieron todo el trabajo de laboratorio, la mayoría de los candidatos de Claude se descartaron en la revisión, y el artículo es un preprint. El trabajo sobre la función principal del sistema sigue en curso. La publicación dice que Claude «parece ser el primero en notar» las características definitorias del sistema, y que Claude «puede detectar anomalías de forma autónoma»: razonable para la etapa de búsqueda, no para el resto. Feng Zhang, del MIT y el Broad Institute, citado en la misma publicación tras leer el preprint, lo calificó de «un ejemplo emocionante de cómo los agentes de IA pueden contribuir al descubrimiento biológico» y dijo que el hallazgo «merece más investigación».
El físico Matthew Schwartz, investigador visitante en Anthropic, es más franco que la mayoría. En una publicación como invitado para Anthropic cuenta que ejecutó de principio a fin 30 integrales con Claude: 15 reprodujeron resultados conocidos y 15 no se habían calculado nunca (Anthropic). Llama «a la medida de Claude» a los buenos objetivos, y añade que «puede hacer falta mucho acompañamiento para que produzcan algo de valor científico». Después de recurrir a expertos externos, descubrió que «en casi todos los casos, Claude tenía razón técnicamente, pero el resultado no era demasiado interesante hasta que el experto ayudó a orientarnos». Claude, dice, «parece preferir viejos debates, muy citados pero olvidados hace tiempo». El criterio sobre qué merece la pena resolver se quedó en manos humanas.
Luego está PSI. TechCrunch cuenta que David Turturean, miembro del equipo técnico del laboratorio emergente Physical Superintelligence (PSI), usó acceso anticipado al modelo Fable 5.2 de Anthropic para resolver un problema de computación cuántica de hace 18 años, la conjetura de Aaronson-Ambainis (TechCrunch). Scott Aaronson, quien planteó el problema, escribe que no entiende del todo la demostración pero cree que es correcta porque fue autoformalizada en Lean y explicada por un equipo de investigadores de primer nivel con quienes PSI la compartió. La descripción del propio Turturean es modesta: «Es un resultado negativo que permite a la gente saber: vale, ya no hay que buscar ahí». La solución parece cerrar un camino hacia las aceleraciones cuánticas, no todos.
Lo describiríamos como un colaborador rápido e incansable que necesita que otro elija el problema. Eso ya es mucho. No es autonomía, y las propias publicaciones de las empresas lo dicen si lees hasta las salvedades.
Afirmación 2: los resultados están verificados
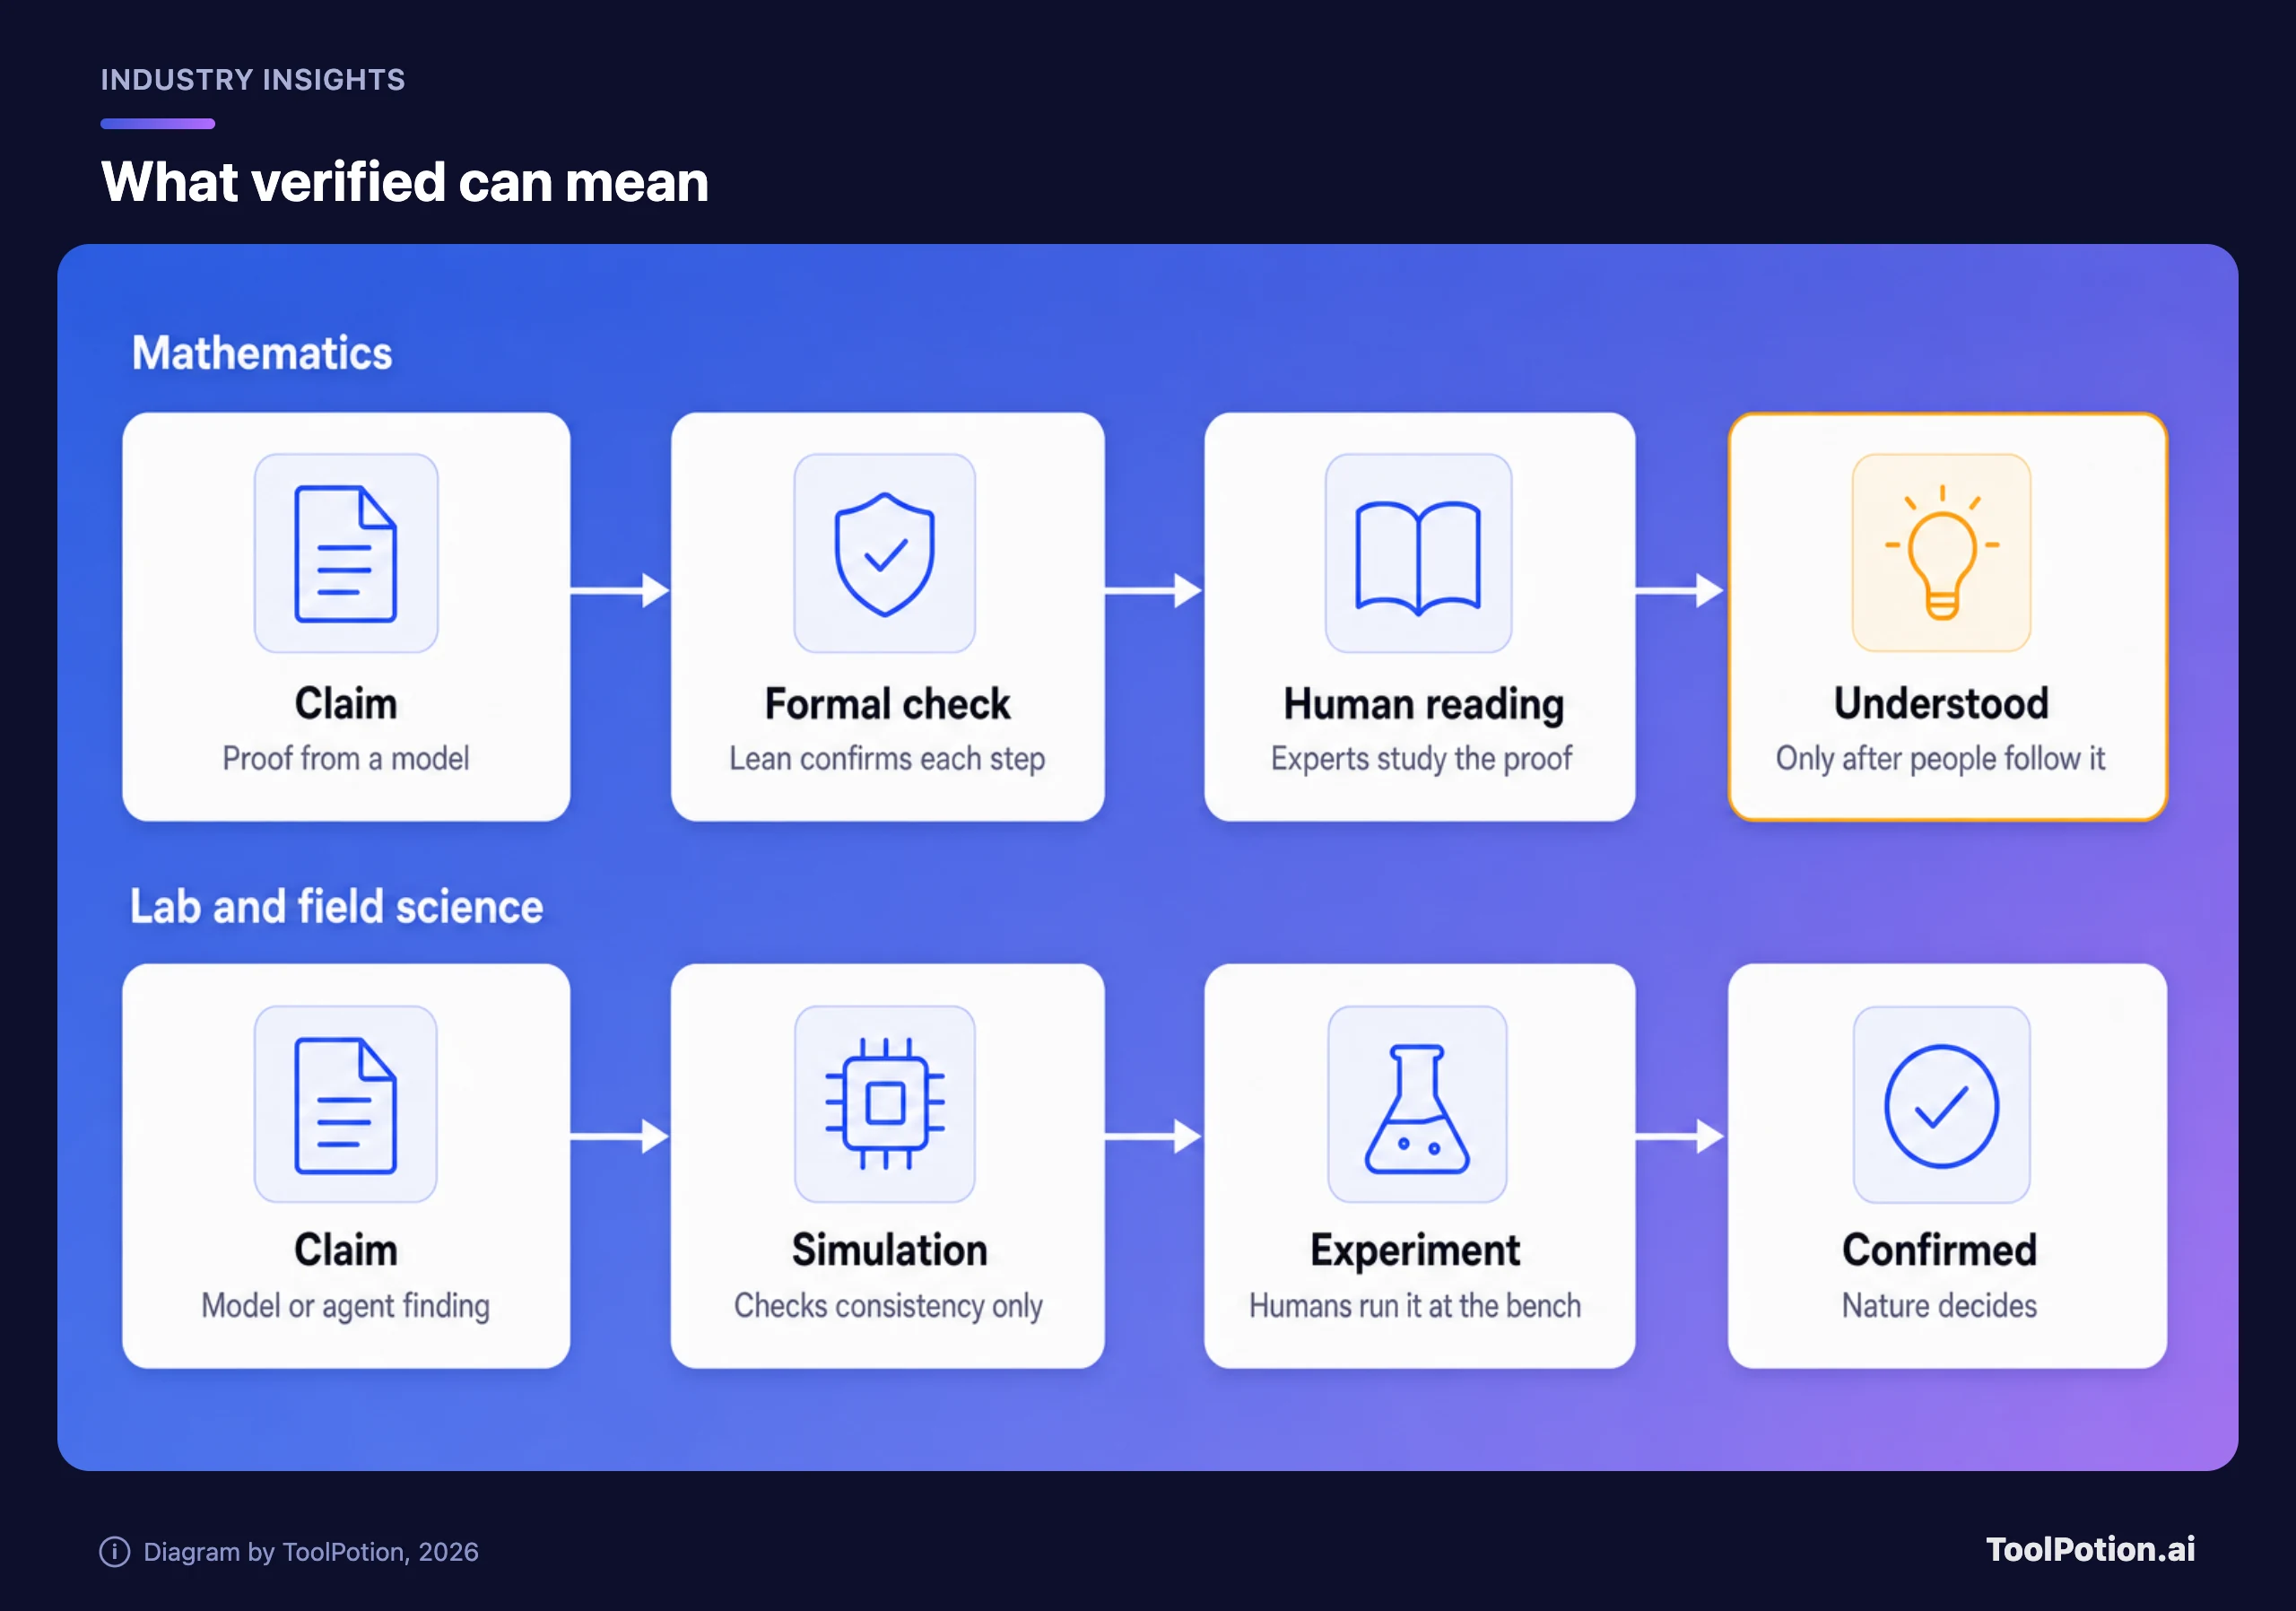
Veredicto: en parte. Un verificador formal es una prueba sólida en matemáticas. En otros campos, «verificado» puede significar desde una simulación hasta una consulta a un registro.
En matemáticas, Lean puede confirmar de forma mecánica que una demostración se sigue del enunciado dado. Es una comprobación sólida, y es la razón por la que los resultados de PSI y OpenAI se toman en serio. Pero lo que cuenta Scientific American muestra los límites. La afirmación de OpenAI cubre la mitad de existencia del problema de Yang-Mills; la otra mitad, la del salto de masa (mass gap), sigue sin resolverse. El comité usó el propio modelo Astra de OpenAI para ayudarse a digerir el código de Lean, y dice sin rodeos que todavía no pretende entender la demostración.
Luego está la apertura. Scientific American señala que el enfoque de «tutela» contradice las recomendaciones de transparencia de un grupo asesor afiliado a OpenAI y ha irritado a algunos matemáticos, que lo ven como un control de acceso. La demostración en Lean ya es pública. Scott Armstrong, de NYU, dijo que se alegraba de que por fin saliera a la luz y añadió: «Esta revisión se puede hacer de forma más eficiente y rápida en abierto» (Scientific American). Estamos de acuerdo con él. Una demostración que solo había visto el comité designado por OpenAI era una afirmación pendiente de revisión, y esa revisión por fin puede empezar.
Fuera de las matemáticas no hay Lean. Matt Pines, CEO de PSI, dijo a TechCrunch que la física se diferencia de las matemáticas porque «la naturaleza tiene voto en tus modelos de la realidad», y que la física teórica impulsada por máquinas «todavía no está ahí, pero va en camino». Schwartz comprobó que «no se puede confiar todavía en las comprobaciones automáticas». Y la publicación sobre los mayas, a la que volveremos, recibió una respuesta oficial: el instituto mexicano no encontró ningún sitio registrado en la ubicación indicada. Eso confirma la ausencia en un registro. No confirma que exista un sitio.
Afirmación 3: los agentes pueden dirigir un laboratorio
Veredicto: todavía no. Pueden planificar, diseñar y analizar. Las personas siguen pipeteando y soldando.
El artículo de Anthropic sobre electrónica es el ejemplo reciente más sólido, y merece leerse entero. En colaboración con el fabricante de placas Diode (Anthropic dice que mantiene una relación comercial con la empresa), Claude (el modelo Fable 5.2) diseñó un altavoz con micrófono USB-C, un hub de asistente de voz y una mascota virtual de mano, del esquema al diseño de la placa y al firmware (Anthropic). Los ingenieros de Diode fabricaron las placas a partir de los archivos de diseño de Claude y construyeron y probaron los prototipos a mano, porque Claude no estaba conectado a equipos de prueba ni a las máquinas que fabrican placas de circuito. Los dispositivos no han pasado validación eléctrica, ajuste de antena, pruebas térmicas ni certificación. La publicación también cita mejoras en benchmarks (69 % en la prueba interna de layout PCB Gym de Diode, frente al 25 % del modelo anterior), que son cifras de Anthropic en una prueba realizada a petición suya, y muestra el coste solo en el eje de un gráfico, no en el texto.
En el lado de la biología, OpenAI ha publicado BioBasicsBench, un benchmark de 100 tareas que, según la compañía, mide lo bien que los agentes de IA interpretan datos experimentales en bruto y manejan la ciencia cotidiana de laboratorio húmedo (OpenAI). Es una prueba creada por el proveedor, y un benchmark es solo una afirmación hasta que lo ejecutan personas ajenas a él.
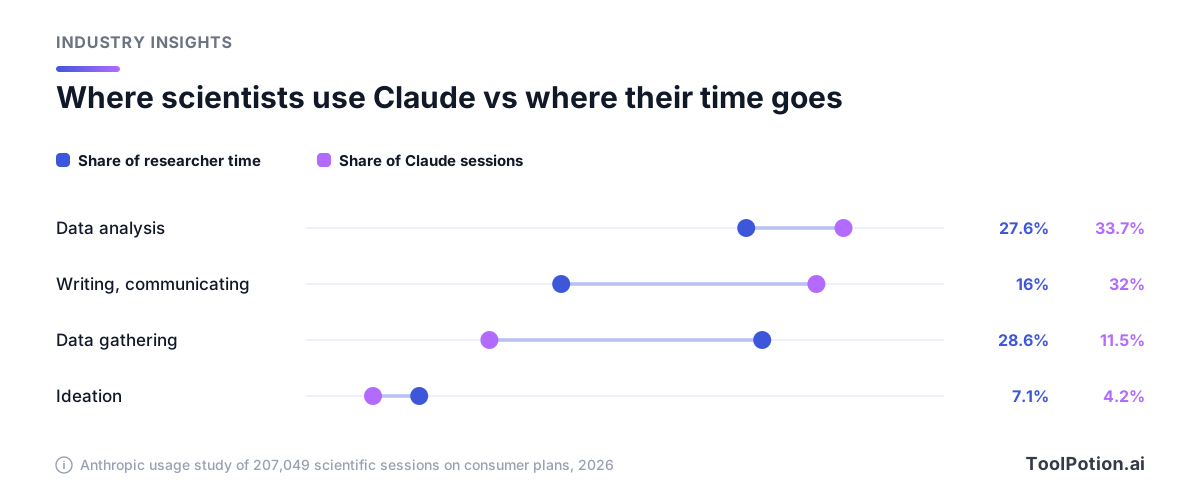
El estudio de uso de Anthropic, con 207.049 sesiones científicas en planes de consumo, muestra la misma forma en el mundo real. La recopilación de datos supone el 28,6 % del tiempo de los investigadores, pero solo el 11,5 % de las sesiones con Claude, y la brecha es mayor donde hay barreras físicas, como recoger datos clínicos o bioquímicos (Anthropic). Según el propio estudio: «los cuellos de botella físicos siguen siendo poderosos».
Afirmación 4: ahora cualquiera puede hacerlo
Veredicto: cualquiera puede empezar. Conseguir algo que resista requiere a alguien que conozca el campo.
La historia maya es la prueba más limpia. Pietro Miotti, que dice no ser arqueólogo, puso a 48 agentes a revisar unos 1.200 kilómetros cuadrados de lidar público de la NASA y obtuvo un sitio en una colina con una plaza y una pirámide, y después una respuesta oficial, en menos de 72 horas (su publicación). Su descripción del método es admirablemente sencilla: «No se usó ningún modelo especial ni clasificador: los agentes literalmente miraron las imágenes».
Luego viene la corrección, que ahora está al principio de la página. «Los agentes lo pasaron por alto al revisar la literatura, así que lo redescubrieron en lugar de descubrirlo». El sitio ya estaba cartografiado en un artículo de 2025 de Estrada-Belli y colaboradores; simplemente aún no figuraba en el registro mexicano. Mérito de Miotti por ponerlo en primer lugar. También dice que no habla español y que confió en la traducción de su informe hecha por los agentes, que la historia del período Clásico es «especulación, fruto de una larga conversación con los agentes», y que la imagen de la reconstrucción está generada por IA. No se describe ninguna prospección sobre el terreno.
Nuestra lectura: es una buena demostración de cribado barato y una mala demostración de descubrimiento. Mirar ahora es casi gratis. Saber si alguien ya miró antes sigue requiriendo a un especialista, o al menos una búsqueda bibliográfica que los agentes no hicieron bien. La vía de PSI fue distinta e instructiva: retuvo el resultado hasta que el modelo de Anthropic estuvo casi listo para su lanzamiento, y aprovechó ese tiempo para mostrárselo a investigadores capaces de explicarlo. Jim Halverson, profesor de Northeastern que asesora a PSI, dijo a TechCrunch que «las mejores prácticas todavía están surgiendo».
Afirmación 5: los científicos están a punto de ser automatizados
Veredicto: sin probar, y las afirmaciones más estridentes vienen de quienes tienen intereses en ellas.
Turturean dijo a TechCrunch: «Acepto totalmente la idea de que este podría ser el último artículo que publique». Pines contó que hace seis o nueve meses, al hablar con inversores, «tenía que estirar un poco» la idea de que la física teórica sería pronto casi un terreno de las máquinas, y que «todavía no está ahí». La encuesta de Anthropic dice que alrededor del 40 % de 528 investigadores espera que la IA lleve a cabo proyectos de investigación completos por sí sola de aquí a 2030, pero fueron reclutados entre solicitantes de los programas de becas AI for Science de la propia Anthropic, así que probablemente usan la IA más que la mayoría (Anthropic).
Las cifras modeladas son menores. El modelo de Anthropic dice que las capacidades actuales, ampliamente adoptadas, podrían asumir entre el 27 y el 52 % del tiempo de investigador necesario para un estudio nuevo, lo que implica un aumento de la producción de 1,35x en las artes hasta 2,02x en estadística. El escenario hipotético del informe en el que la IA automatiza todo el trabajo no físico llega a alrededor de 15x en estadística e informática, pero solo a 3-4x en ciencias de laboratorio como la biología y la química, donde los pasos físicos siguen siendo el cuello de botella. Eso es un escenario, no una medición. Incluso el caso modesto es un gran cambio para un campo. No es sustitución, y el informe señala que hoy el trabajo con IA es sobre todo de asistencia o compartido. Sobre a quién corresponde el mérito, Schwartz lo dice mejor que nosotros: «no se resolverá fingiendo que la aportación humana era teclear».
Afirmación 6: si el modelo de la IA se ajusta a los datos, entendemos el sistema
Veredicto: falso, y los autores que construyen estos sistemas lo reconocen.
Una publicación de invitados de un grupo de Tubinga (Jakob Macke, Daniel Gedon y Stefan Wahl, todos becarios de AI for Science de Anthropic) sobre cómo enseñar a la IA a construir modelos científicos defiende el argumento con cuidado. Muchos modelos se ajustan a los mismos datos, así que el resultado útil es un abanico de modelos plausibles y una lista de en qué coinciden (Anthropic). Admiten que estos sistemas «se han probado sobre todo en redescubrir modelos que los científicos ya conocen», con poca evidencia en problemas sin respuesta conocida. Y escriben: «Un sistema de IA que se limita a darte el modelo puede darte una respuesta, pero no te da comprensión».
Creemos que esa última frase debería estar pegada encima de cada mesa de laboratorio y de cada escritorio de estudiante. Un ajuste es un número. Una explicación es algo que una persona puede usar para predecir lo que pasará después.
Una rutina para investigadores y estudiantes
Nada de lo anterior dice que no uses estas herramientas. Los datos de uso de Anthropic sugieren que los científicos ya las usan donde mejor funcionan, sobre todo en análisis y escritura. Esta es la rutina que seguiríamos, construida a partir de lo que salió mal en los casos anteriores.
- Dale a los agentes trabajo cuyo resultado puedas comprobar tú mismo: análisis de datos, portar código entre lenguajes, cribar artículos o imágenes. Claude Code y Claude Cowork están hechos para ese tipo de tareas, y nuestra comparativa de agentes de programación en terminal repasa el panorama.
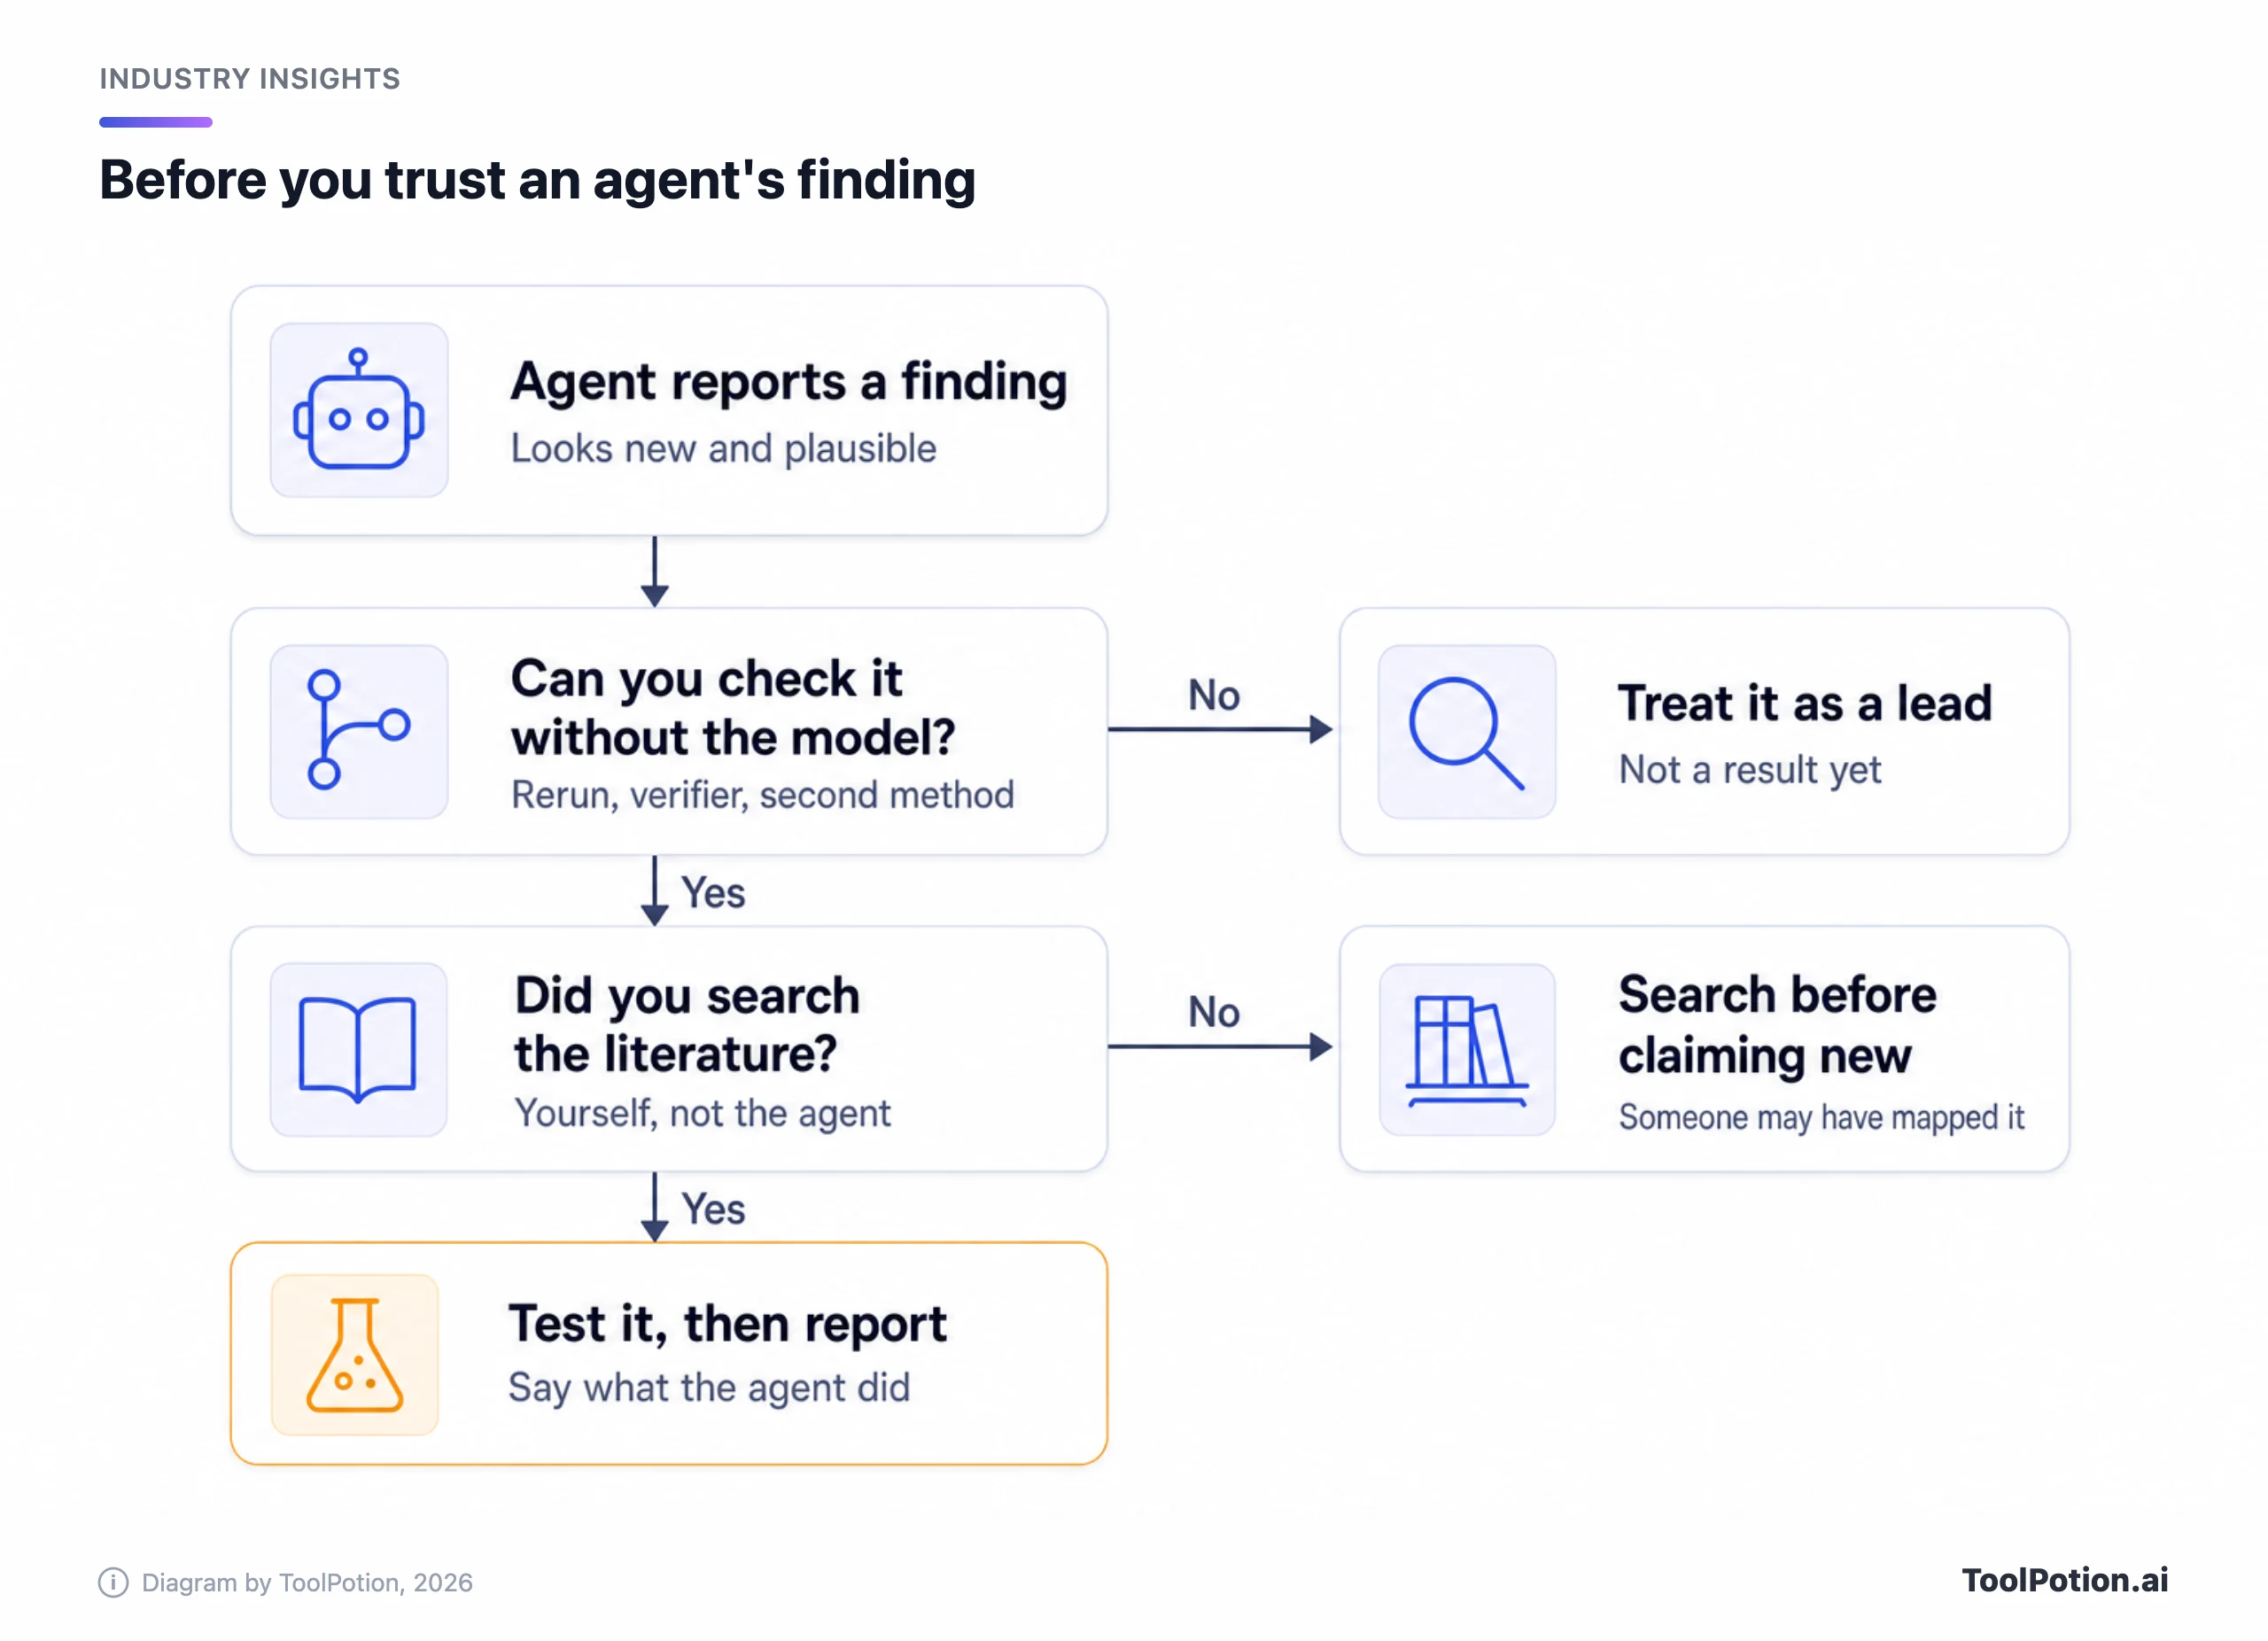
- Decide antes de empezar qué cuenta como comprobación y quién la hace. No el mismo modelo. Un verificador formal, un segundo análisis, un experimento de laboratorio o un colega.
- Cuando un agente diga que algo es nuevo, busca tú mismo en la literatura. Una herramienta específica como Elicit, Consensus, SciSpace o ResearchRabbit lleva minutos, y el caso maya muestra el coste de saltárselo. Nuestro ranking de asistentes de investigación con IA tiene la lista más larga.
- Mantén el paso físico en manos humanas y documentado. Si un resultado depende de una medición, una muestra o una visita al sitio, ahí es donde se pone a prueba.
- Cuando lo escribas, di qué hizo el agente y qué comprobaste tú. Schwartz es tajante: la aportación humana no era teclear.
- Estudiantes: construid vosotros mismos vuestros primeros modelos. Los autores de Tubinga escriben que «es el proceso de construirlo lo que aporta la comprensión». Usa un agente para criticar tu modelo, no para que te lo entregue hecho.
Si quieres el ejemplo más antiguo y mejor probado de IA haciendo biología, sigue siendo AlphaFold, que predice estructuras que luego los laboratorios ponen a prueba. Para trabajo con literatura e investigación al estilo agente también están Edison Scientific, Scientific Agent Skills para equipar a tus propios agentes, y el ranking Top 250 AI Tools for Researchers. Para los asistentes de propósito general, ChatGPT vs Claude vs Gemini enfrenta a ChatGPT con sus dos principales rivales, mientras que los rankings de asistentes de investigación con IA y de agentes de IA clasifican las herramientas especializadas.
Dónde nos situamos y qué nos haría cambiar de opinión
Lo real: los agentes ya son analistas e ingenieros útiles e incansables. Los prototipos de electrónica funcionan, la pista de la enzima es interesante, y una demostración de un modelo verificada en Lean es un resultado real, sea quien sea el primero en entenderla. Las 15 integrales nuevas de Schwartz son resultados reales en un campo acotado.
El humo: la autonomía, el «verificado» usado a la ligera y una próxima oleada de científicos automatizados. Casi todos los resultados impresionantes de arriba tienen a un humano en el circuito haciendo la parte que decide si es cierto, y los humanos lo dicen. También nos gustaría que los laboratorios publicaran el coste en dólares junto a la puntuación del benchmark. Los créditos y los recuentos de tokens ocultan lo que cuesta un descubrimiento, y 210 millones de tokens para una búsqueda de enzimas es una cifra que le importa al presupuesto de un laboratorio.
Dos cosas nos harían cambiar de postura. Una es que matemáticos ajenos al comité de OpenAI lean el código de Lean de Yang-Mills y digan que lo entienden. La otra es una versión revisada por pares del trabajo sobre la enzima que explique qué hace el sistema. Hasta entonces, tratamos ambos casos como prometedores e inacabados.