

Los ingenieros de Anthropic dejaron una vez que un agente principal repartiera instrucciones cortas como "investiga la escasez de semiconductores". Los subagentes la interpretaron mal: uno exploró la crisis de chips del sector automotriz de 2021, mientras otros dos duplicaban trabajo sobre las cadenas de suministro de 2025 (Anthropic Engineering). Nada falló. Cada agente hizo algo razonable con una petición lo bastante vaga como para leerse de varias maneras.
La mayoría repetimos ese error cada vez que le pasamos trabajo a ChatGPT, Claude, Gemini CLI o alguno de los agentes de programación para terminal. Escribimos una tarea y la llamamos brief. A continuación: las seis partes que necesita un brief, tres reescrituras que puedes copiar, una plantilla y una tabla con las formas en que fallan los briefs. Nuestras posturas, que iremos argumentando: escribe primero la línea de "terminado cuando", sustituye el "pregúntame si tienes dudas" por una lista concreta de acciones y recorta los muros de mayúsculas. La documentación de los proveedores que citamos respalda una parte de esto y no cubre el resto; te decimos cuál es cuál.
Una tarea no es un brief
Una tarea nombra una actividad. Un brief le da a quien la hace todo lo que de otro modo tendría que adivinar. La guía de prompts de Anthropic lo plantea como un empleado nuevo: "Piensa en Claude como un empleado brillante pero nuevo que no conoce el contexto de tus normas y flujos de trabajo". (Anthropic docs) OpenAI traza una línea parecida entre tipos de modelo. Un modelo de razonamiento es "como un compañero sénior" que puede tomar un objetivo y resolver los detalles, mientras que un modelo GPT es "como un compañero junior" que rinde mejor "con instrucciones explícitas para crear un resultado concreto" (OpenAI docs).
OpenAI dice que los modelos de razonamiento funcionan bien con orientación de alto nivel, y nosotros no llegaríamos a fiarnos de eso cuando el trabajo dura decenas de pasos con efectos secundarios. El compañero sénior tampoco puede saber qué significa "terminado" para ti, y la suposición equivocada de un junior cuesta un correo. Un agente actúa sobre su primera mala lectura en cada paso siguiente, como demostró el agente principal de Anthropic.
Anthropic propone una prueba que nos gusta porque lleva dos minutos: "Muestra tu prompt a un colega con un contexto mínimo sobre la tarea y pídele que lo siga. Si a él le confunde, a Claude también". (Anthropic docs) Si un contratista no pudiera empezar con tu mensaje sin mandarte cinco preguntas, el agente responderá esas cinco preguntas por su cuenta, en silencio, y te enterarás por el resultado.
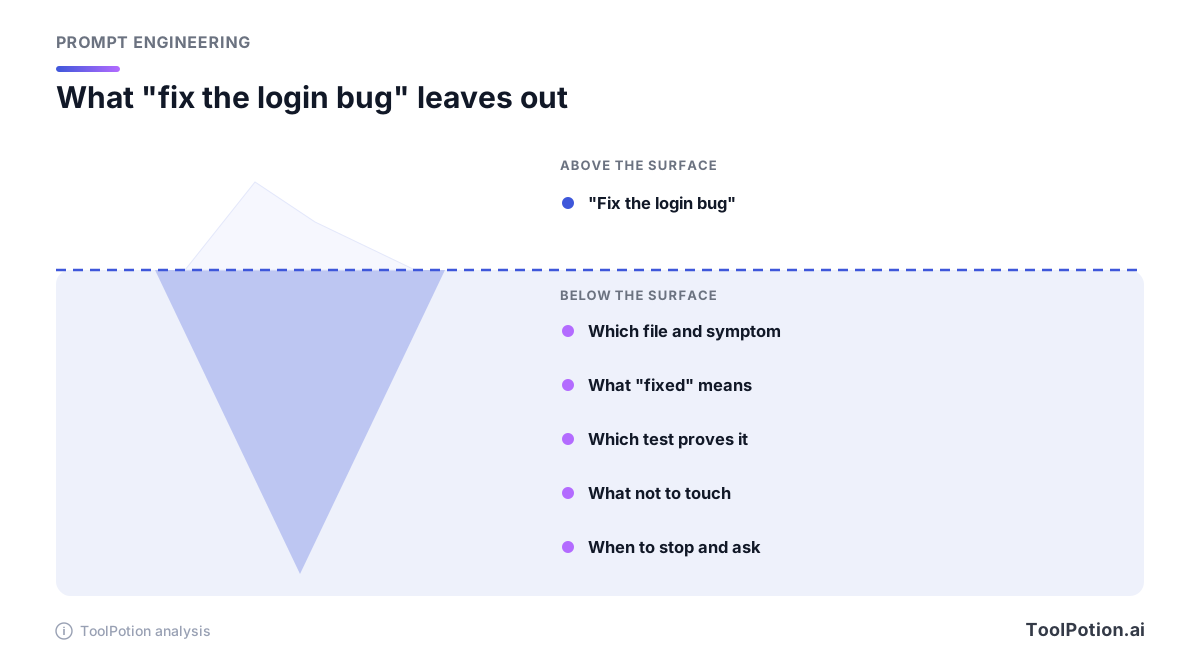
Escribe la línea de "terminado cuando" antes que nada
La propia página de buenas prácticas de Claude Code lo dice sin rodeos: "Claude se detiene cuando el trabajo parece terminado". Sin algo que ejecutar que indique si el trabajo está hecho, continúa la página, "en la práctica tú te conviertes en la suite de tests, y cada error se queda ahí hasta que te das cuenta por casualidad". (Claude Code docs)
La guía de Codex de OpenAI llega a la misma idea desde el otro lado. Sugiere cuatro cosas en un prompt: un objetivo, contexto, restricciones y "Terminado cuando", que formula como una pregunta sobre qué debería ser cierto antes de dar la tarea por completada, "como que los tests pasen, que cambie un comportamiento o que un bug deje de reproducirse" (OpenAI Codex docs). Dos proveedores, dos productos, un mismo esqueleto. Nosotros añadimos dos partes propias (parar y preguntar, e informe), y escribiríamos primero la línea de "terminado cuando" aunque en el brief final quede en cuarto lugar, porque escribirla te obliga a descubrir qué quieres.
Fuera del código, la misma línea funciona con otro tipo de comprobación. "Una tabla de doce proveedores, un enlace a la fuente junto a cada precio y una marca en cualquier precio que no sea público" es algo que un agente puede contar. "Una comparación exhaustiva" es algo que solo puede intuir.
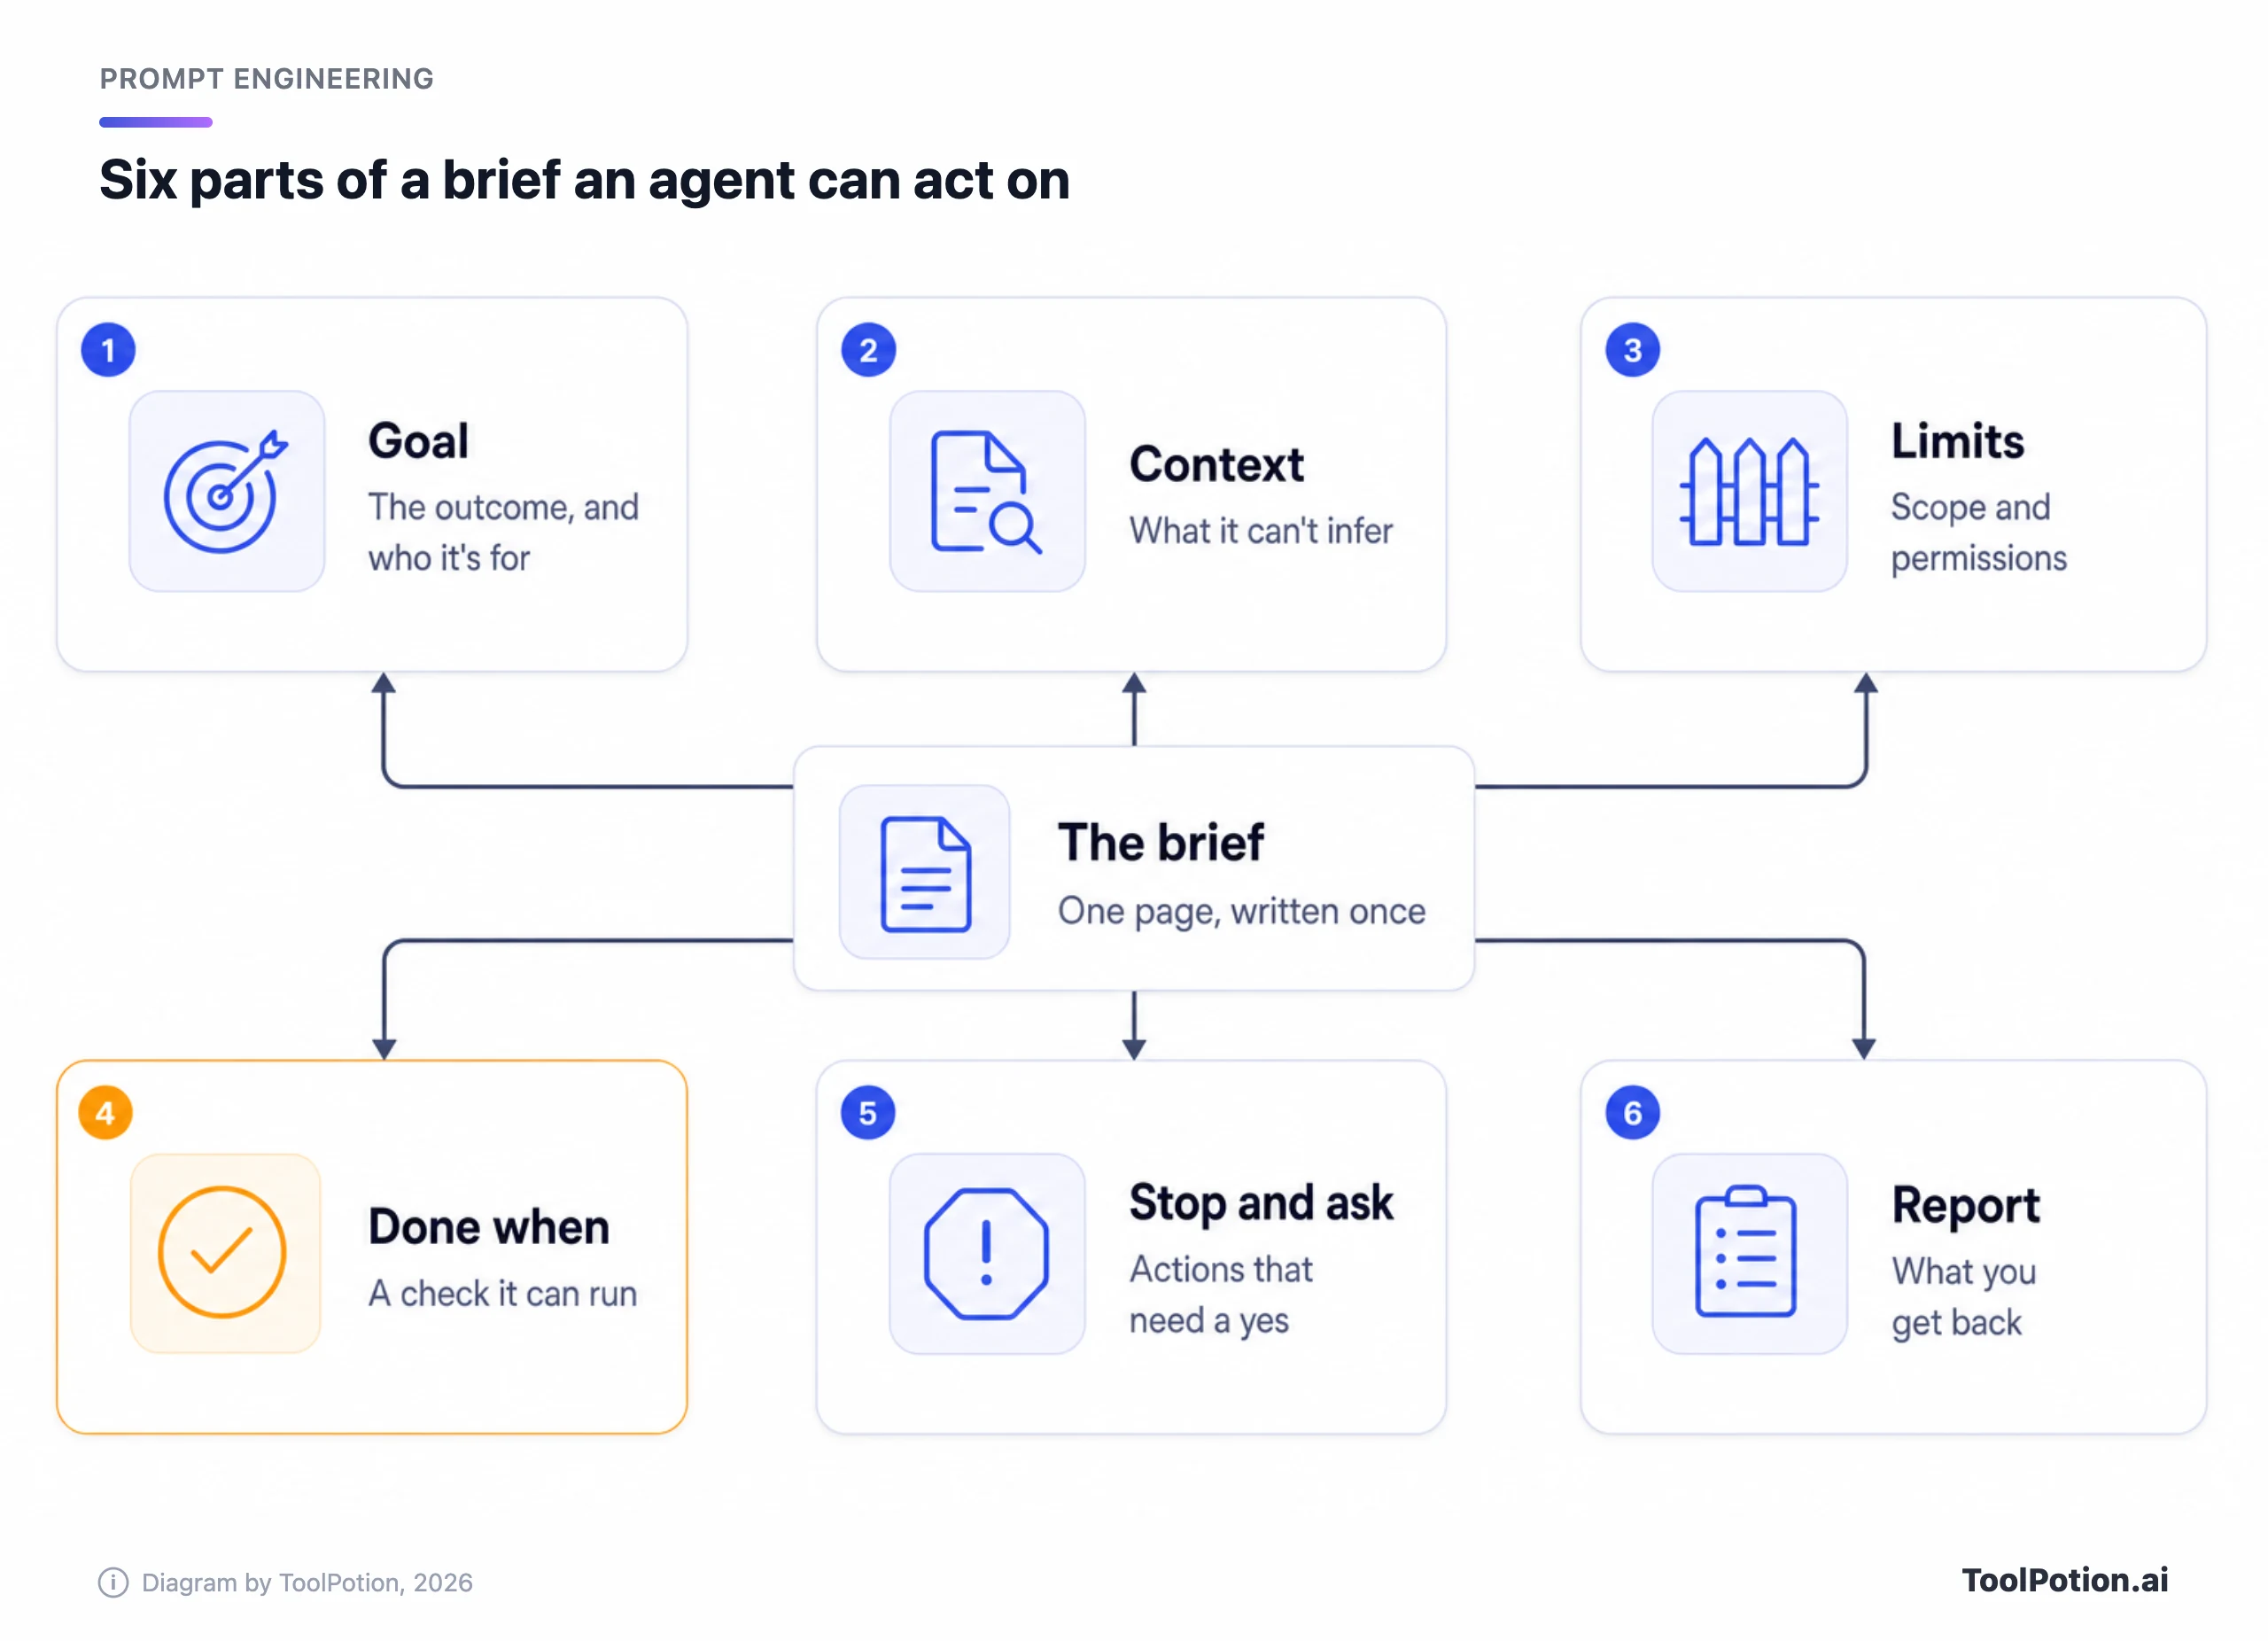
Las seis partes de un brief, de arriba abajo
El objetivo nombra el resultado y quién lo usa
Una o dos frases. Di qué quieres al final y a qué alimenta: una recomendación que dos socios leerán en cinco minutos, un arreglo que sale el viernes, una preselección para una compra. El destino cambia lo que el agente incluye y lo que recorta. "Investiga precios" produce volumen. "Recomienda una herramienta por menos de 15 $ por usuario" produce una decisión.
El contexto es todo lo que no puede encontrar por sí mismo
La documentación de Claude Code ofrece un filtro útil: "¿Podría encontrar esto leyendo el código? ¿Iría realmente a mirarlo? Si ambas respuestas son sí, déjalo fuera". (Claude Code docs) Lo que sí entra es la decisión de la reunión que nunca llegó al repositorio, la cuenta que debe usar el agente, la herramienta que ya probaste y descartaste, el nivel del lector.
Da también la razón detrás de cada regla. La guía de Anthropic dice que el contexto o la motivación detrás de una instrucción "pueden darle a Claude más información sobre tus objetivos y ayudarle a dar respuestas más precisas", y su propio ejemplo de la versión más débil es un simple "NUNCA uses puntos suspensivos" (Anthropic docs).
Los límites dicen qué entra en el alcance y qué está prohibido
Los agentes tienden a hacer más de lo que les pides. La guía de Anthropic dice que Claude Opus 4.5 y 4.6 tienen tendencia a "crear archivos extra, añadir abstracciones innecesarias o construir flexibilidad que nadie pidió", y ofrece una instrucción de ejemplo que incluye "No añadas funcionalidades, no refactorices código ni hagas \"mejoras\" más allá de lo que se pidió". (Anthropic docs) La guía vincula ese hábito a esos dos modelos, así que compruébalo con el que uses tú. Nosotros tomaríamos prestada la frase de todos modos. Luego añade tu propia lista: carpetas que puede tocar, fuentes que puede usar, cuentas en las que no puede iniciar sesión.
La guía de Gemini de Google incluye la evaluación de riesgos entre los ajustes que controla un prompt de agente, y dice que puede distinguir explícitamente entre acciones exploratorias de bajo riesgo (lecturas) y cambios de estado de alto riesgo (escrituras) (Google AI docs). Esa división es la parte útil. Leer y ejecutar tests no requiere permiso; borrar, enviar y pagar, sí.
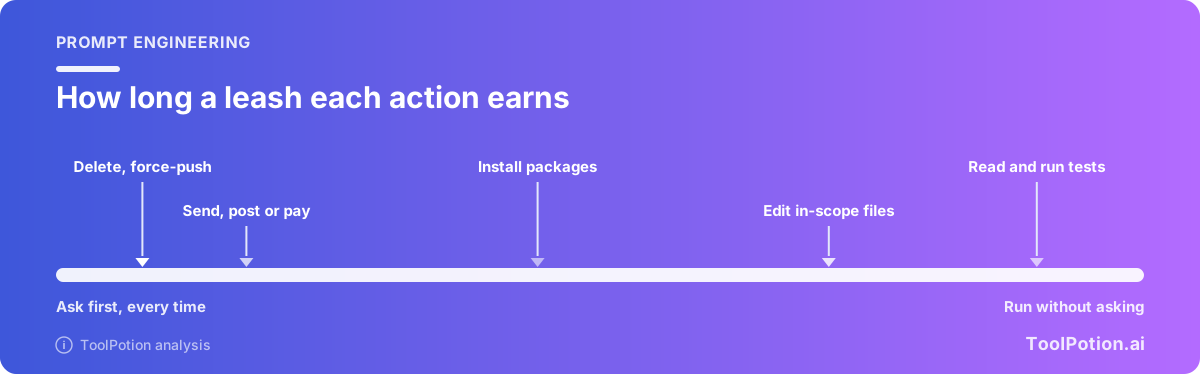
Una advertencia antes de que te apoyes en todo esto. Las palabras de un brief son peticiones. Un sandbox, un token de solo lectura o una regla de permisos son controles que se imponen, y una cosa no sustituye a la otra. Nuestra guía para contener agentes de IA cubre la parte de control; este artículo se limita a lo que escribes.
Terminado cuando es una comprobación que puede ejecutar
Nombra el comando, el número o el archivo. "Los tests pasan" es un comienzo. "pnpm test pasa y un test nuevo demuestra que la petición 101 en un minuto recibe un 429" es una comprobación. En investigación, indica cuántos elementos, qué campos y qué escribir cuando no se pueda encontrar un campo. Si la comprobación puede fallar, dile al agente qué hacer después, y ponle un tope. La guía de Google señala que "Una persistencia alta aumenta las tasas de éxito, pero arriesga mayores costes de tokens o bucles", así que "reintenta un test fallido dos veces, luego para e infórmame" es mejor línea que el silencio (Google AI docs).
Parar y preguntar es una lista de acciones, no un estado de ánimo
"Pregúntame si tienes dudas" le da al agente un juicio que emitir, y un agente entusiasta rara vez duda. Mejor enumera las acciones. La guía de Anthropic tiene un prompt de ejemplo justo para esto, escrito para Claude Opus 4.6: para acciones "difíciles de revertir, que afecten a sistemas compartidos o que puedan ser destructivas, pregunta al usuario antes de continuar", con borrar archivos o ramas, git push --force y enviar mensajes entre los ejemplos (Anthropic docs). La lista es lo que copiaríamos, uses el modelo que uses.
El ensayo de Anthropic sobre diseño de agentes describe el patrón: los agentes "pueden entonces pausar para pedir feedback humano en puntos de control o cuando se topan con bloqueos" (Anthropic Engineering). Haz que el primer punto de control sea un plan. Pide los pasos antes de cualquier cambio, léelos y luego di adelante. Cuesta una ida y vuelta, y creemos que es el punto de control más barato que existe.
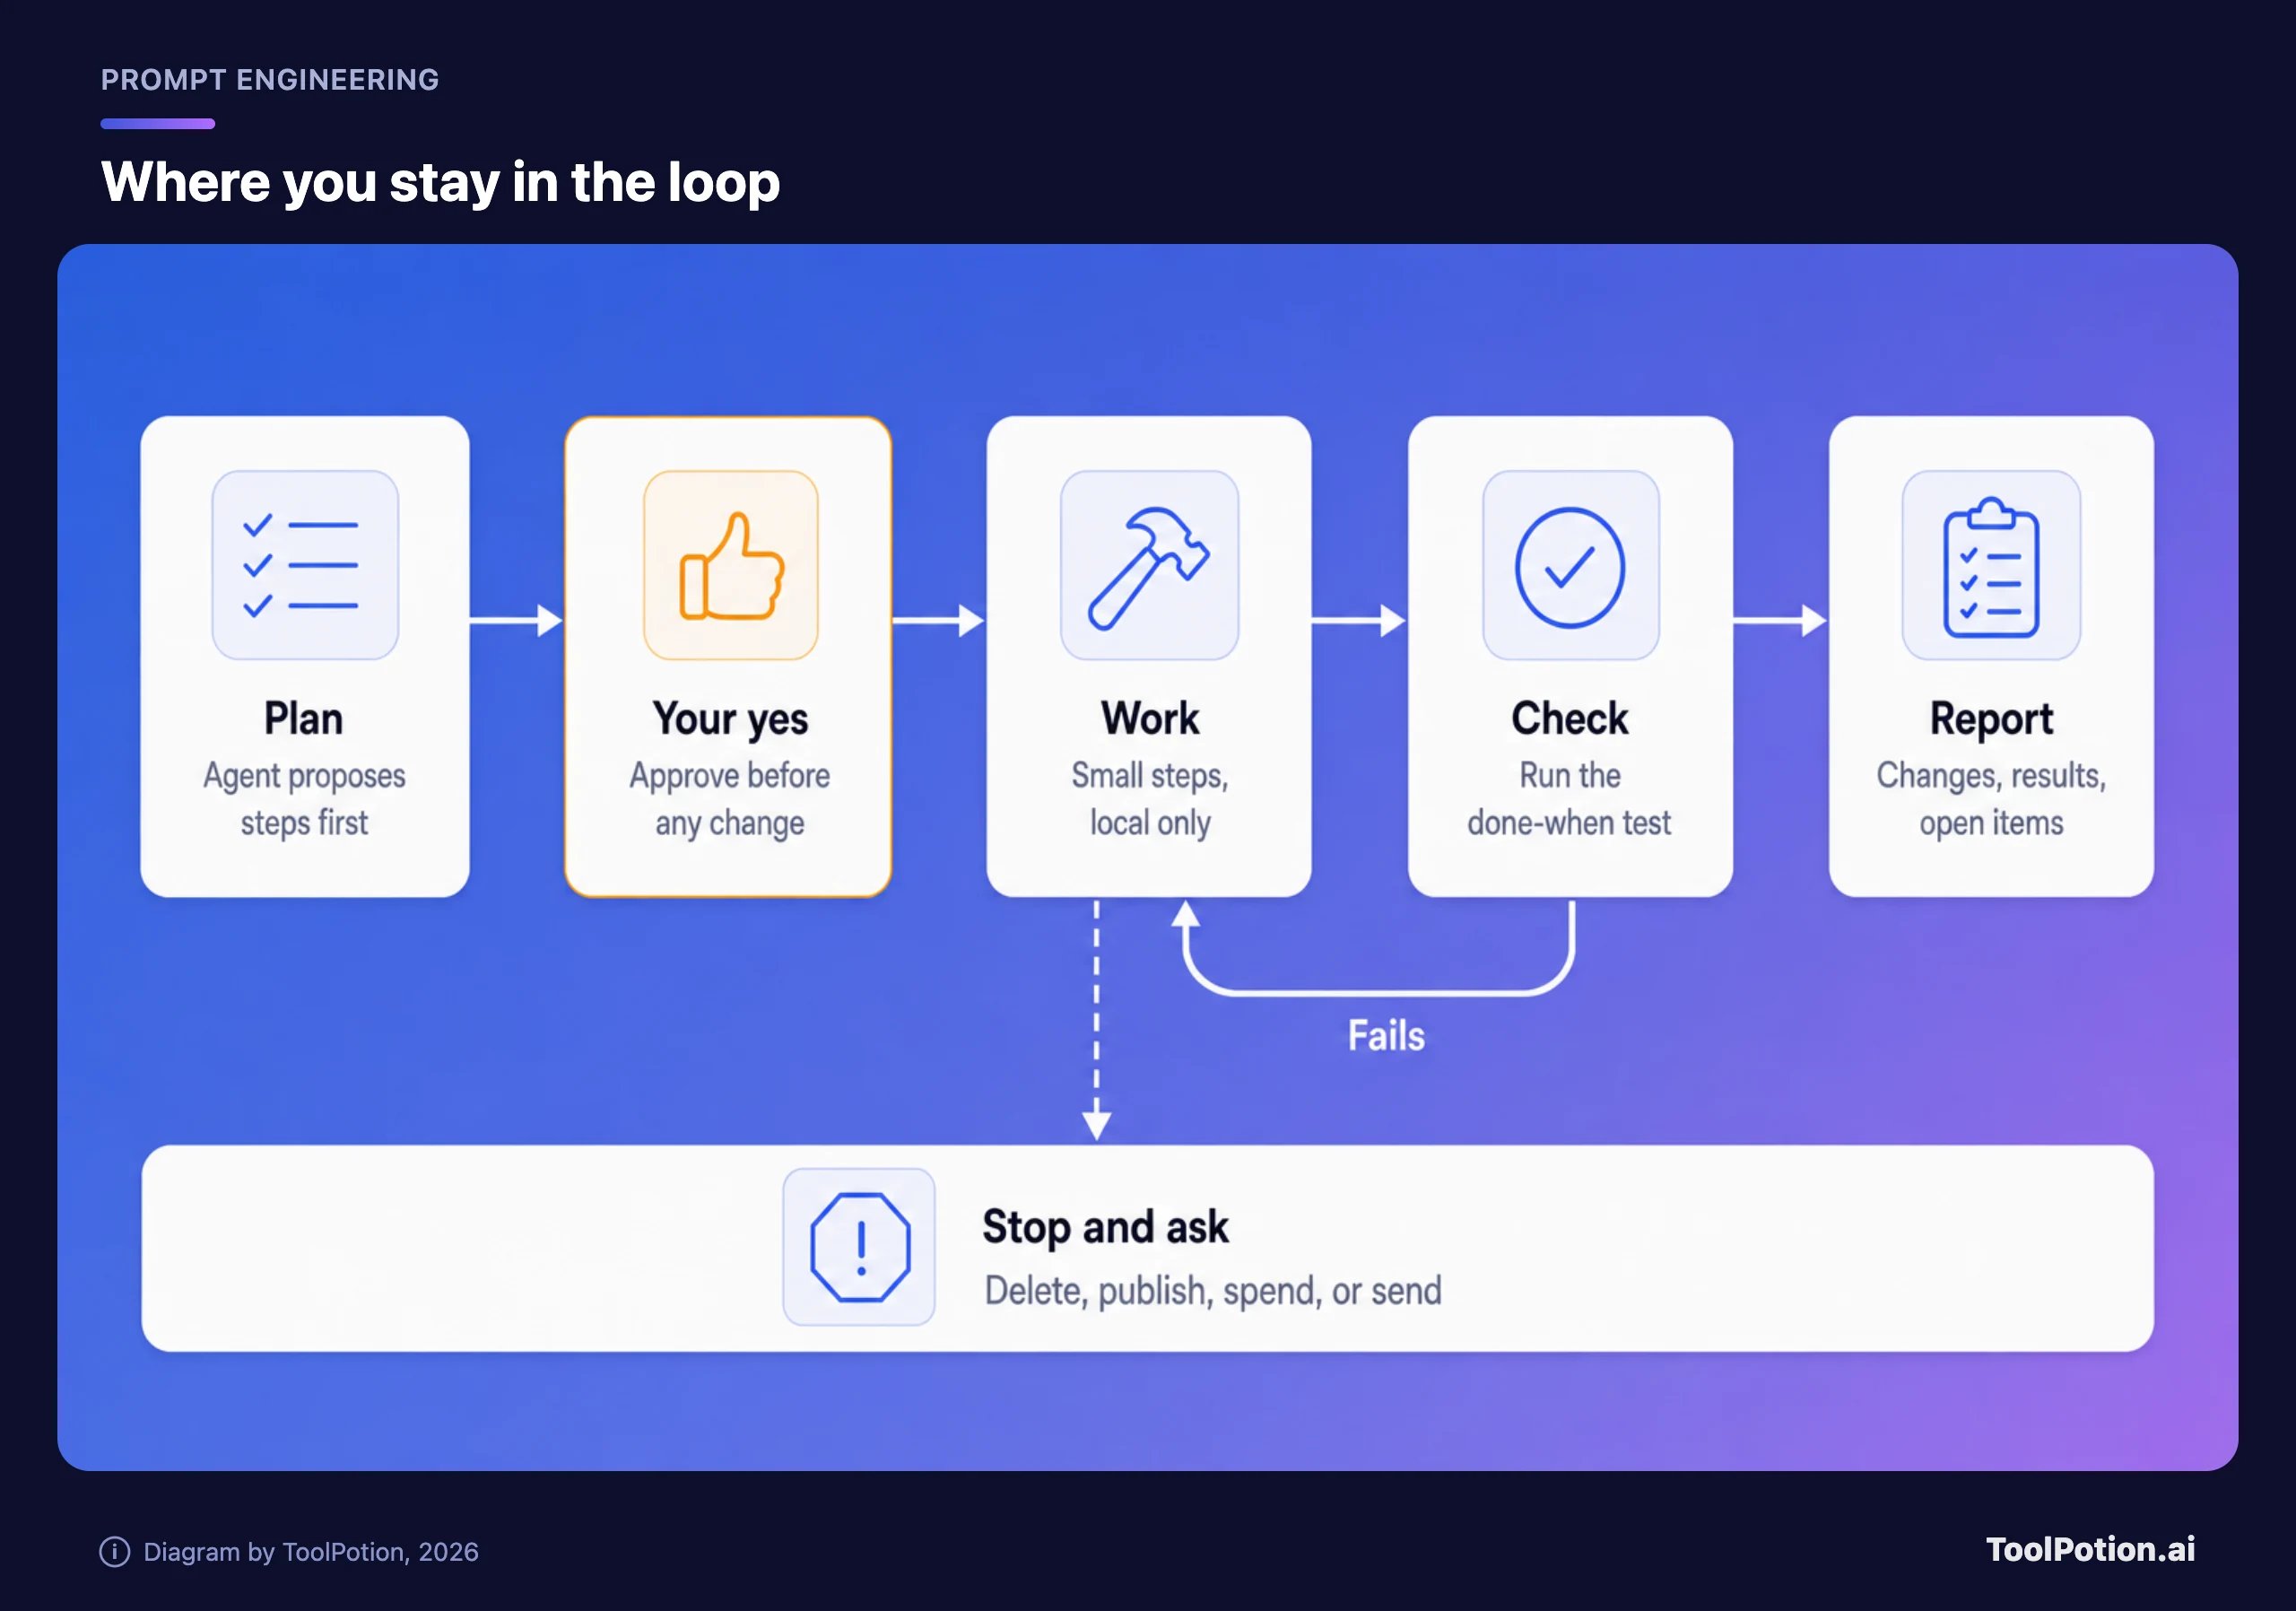
El informe es donde dices qué te tiene que devolver
Pide los cambios realizados, las comprobaciones ejecutadas con sus resultados, todo lo que asumió y todo lo que decidió no hacer. Ese último punto es el que la gente olvida. Es donde el agente te dice que se saltó la migración porque le dijiste que no tocara el esquema.
Tres briefs, antes y después
Cada reescritura de abajo ronda las 120 a 150 palabras. Es más largo que el prompt medio y más corto de lo que la gente teme. Los tres briefs son ejemplos inventados por nosotros: las tareas, las herramientas y los números son ficticios, puestos para ilustrar, y ninguno viene de un proveedor ni de un proyecto real.
Un agente de investigación (ejemplo inventado)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.Un agente de programación (ejemplo inventado)
La documentación de Claude Code trae su propio antes y después: "añade un widget de calendario" se convierte en una petición de seguir el patrón de un archivo de widget existente, con "sin librerías nuevas" (Claude Code docs). Aquí va el mismo movimiento en un trabajo más grande, escrito para Claude Code o Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.Un agente de bandeja de entrada (ejemplo inventado)
Este sirve para cualquier asistente al que dejes acercarse a tu correo, el tipo de trabajo para el que se venden productos de agentes como Manus y Claude Cowork. El correo es donde "limpiar" puede convertirse sin ruido en "borrado".
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.La línea de Objetivo apenas cambia entre el antes y el después. El peso está en las cuatro últimas líneas: una comprobación, una parada, un informe y un límite que dice qué no puede hacer el agente jamás.
Una plantilla para pegar
Borra cualquier línea que no aplique, pero bórrala a propósito.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
Puntúa tu propio borrador con ella. Ocho preguntas de sí o no, treinta segundos.
Cómo fallan los briefs y qué cambiaríamos
| Fallo | Qué ves | Cambio |
|---|---|---|
| El objetivo es una actividad | Páginas de resultado, ninguna decisión | Indica a qué alimenta el resultado |
| Sin "terminado cuando" | Se para en "parece terminado" o no se para nunca | Añade una comprobación ejecutable y un tope de reintentos |
| Alcance sin definir | Archivos extra, refactorizaciones, mejoras no pedidas | Enumera lo que está prohibido |
| Advertencias sin razones | Un muro de líneas con NUNCA, ignoradas o aplicadas en exceso | Añade la razón en una cláusula |
| Aprobación solo implícita | Borra, hace push o envía según su propio criterio | Nombra las acciones y pide un plan primero |
| Correcciones acumuladas | Las instrucciones se contradicen entre sí | Reescribe el brief y empieza de cero |
Dos de estos merecen unas palabras más. El primero es la pila de mayúsculas. Dudamos que más énfasis haya arreglado jamás la falta de una razón, y la guía de Anthropic apunta en la misma dirección: un simple "NUNCA uses puntos suspensivos" es su ejemplo débil. La documentación de Claude Code añade que "Frases como piensa paso a paso o sé exhaustivo son texto de prompt normal, no palabras clave" (Claude Code docs). Por eso recortaríamos el relleno de "sé exhaustivo". La guía de Anthropic sí recomienda darle un rol a Claude, aunque sea de una frase, así que no lo prohibiríamos; lo que nos saltaríamos es el personaje de "experto de talla mundial", porque las seis partes ya le dicen al agente más que un título.
El segundo es el problema opuesto. El prompt de agente de ejemplo de la guía de OpenAI (mostrado para su modelo gpt-6-astra, como muestra y no como regla) le dice al modelo que "siga hasta que la consulta del usuario esté completamente resuelta" y que "No te detengas tras completar solo parte de la petición" (OpenAI docs). Es razonable para un trabajo con una línea de meta clara, y una trampa para uno sin ella. Un agente persistente con un objetivo vago puede seguir gastando tokens en un bucle; la guía de Google dice algo parecido sobre la persistencia alta. El ensayo de Anthropic dice que es habitual incluir "condiciones de parada (como un número máximo de iteraciones)" para mantener el control (Anthropic Engineering).
Otro hábito que dejaríamos: pegar el brief en un hilo que ya acumula diez correcciones. Ahora el agente tiene once juegos de instrucciones y ninguna forma de priorizarlos.
Mira el primer minuto y luego reescribe
La documentación de Claude Code aconseja: "Mira el primer minuto, pulsa Esc en cuanto Claude se desvíe y, tras dos correcciones fallidas, ejecuta /clear y escribe un prompt mejor en lugar de una tercera corrección" (Claude Code docs). Lo aplicaríamos a cualquier agente: el primer plan y las primeras acciones muestran si tu brief se leyó como querías.
Cuando todavía no puedes escribir el brief, deja que el agente te entreviste. La documentación de Claude Code sugiere un prompt del estilo "Entrevístame hasta que puedas escribir la especificación y luego escríbela en SPEC.md", y la guía de Codex dice que le pidas que te pregunte primero y "cuestione tus suposiciones" (Claude Code docs, y OpenAI Codex docs). Después, empieza una sesión nueva a partir de la especificación escrita.
Los briefs que funcionan dos veces merecen un hogar. Las reglas permanentes (cómo ejecutar los tests, qué no tocar nunca) van en un archivo AGENTS.md o CLAUDE.md; OpenAI dice que "Un AGENTS.md corto y preciso es más útil que un archivo largo lleno de reglas vagas" (OpenAI Codex docs). Un procedimiento que repites puede convertirse en una skill, tema que tratamos en From Prompts to Skills. Qué cargar en la sesión desde el principio es el tema de nuestro artículo sobre context engineering, y los hábitos que mantienen los prompts funcionando entre versiones de modelos están en Prompt Patterns That Survive Model Updates. Para herramientas pensadas para este tipo de delegación, mira nuestros rankings de agentes de IA, tareas de creación de agentes y herramientas de prompt engineering.
Preguntas frecuentes
¿Qué extensión debe tener un brief?
La suficiente para contener las seis partes, que en la mayoría de los trabajos son de 100 a 200 palabras. Las preferencias permanentes van en un archivo de reglas para que cada brief cubra solo esta tarea. Si el brief pasa de una página, probablemente el trabajo pide dividirse en dos.
¿Necesitan ChatGPT, Claude y Gemini briefs distintos?
El esqueleto es el mismo. Las cuatro partes de la guía de Codex de OpenAI, el consejo de Anthropic de aportar contexto y preguntar antes de acciones de riesgo, y las dimensiones de agente de Google (manejo de la ambigüedad, evaluación de riesgos, persistencia) describen un mismo conjunto de necesidades con otras palabras. El formato cambia un poco: la guía de Google recomienda etiquetas estilo XML o encabezados Markdown y dice que "Elijas un formato y lo uses de forma consistente" (Google AI docs). Qué asistente encaja con qué trabajo es otra cuestión que abordamos en ChatGPT vs Claude vs Gemini in 2026.
¿Qué debo decirle al agente que haga cuando tenga dudas?
Dale una regla que pueda aplicar. "Asume todo lo que sea reversible y anótalo en el informe; pregunta antes de todo lo que no lo sea" funciona mejor que "pregunta si dudas". La guía de Google plantea la misma elección como cuándo puede el modelo hacer suposiciones y cuándo debe parar a pedir aclaración o permiso.
¿Basta un buen brief para que un agente sea seguro?
No. Un brief reduce errores y no previene ninguno. Anthropic recomienda "pruebas exhaustivas en entornos sandbox, junto con las barreras de seguridad adecuadas" (Anthropic Engineering), y nuestra guía de contención cubre los permisos y las pistas de auditoría.
El agente se equivocó de todos modos. ¿Y ahora qué?
Encuentra el primer paso en el que se desvió y pregúntate qué decía el brief sobre ese paso. Añade la única línea que lo habría evitado y vuelve a ejecutar desde una sesión nueva.