

Para verificar lo que genera la IA sin ahogarte en el intento, deja de querer comprobar cada frase. Extrae las afirmaciones, ordénalas según lo que se rompe si están mal y contrasta con la fuente original las que sostienen tu texto, porque ni una cita bien armada ni el "sí, estoy seguro" del propio modelo prueban nada.
El coste de saltarse este paso no deja de subir. Una base de datos pública de resoluciones judiciales con material alucinado por IA había registrado 2.125 al momento de escribir esto, y 1.193 de ellas son de este mismo año (AI Hallucination Cases database). A principios de este año KPMG retiró un informe publicado por aparentes alucinaciones de la IA, después de que las organizaciones que mencionaba calificaran sus afirmaciones sobre el uso que hacían de la IA como "falsas o engañosas" (TechCrunch).
Las alucinaciones no han desaparecido. Se han vuelto más difíciles de detectar, porque la prosa que las rodea es fluida y las referencias falsas parecen reales. A continuación verás qué tipos de afirmaciones fallan más, por qué la autoverificación se queda corta, un flujo de trabajo por niveles de riesgo con prompts listos para copiar y una mirada honesta a herramientas de grounding como Gemini Notebook (antes NotebookLM), Perplexity y Consensus.
Las citas falsas ya son un género judicial
Los abogados fueron los primeros en aprenderlo, y en público. La base de datos de Damien Charlotin recoge resoluciones en las que un juzgado o tribunal determinó, o dio a entender, que una parte se apoyó en contenido alucinado, normalmente jurisprudencia inventada. No pretende contar todas las citas falsas presentadas alguna vez, solo las que un juzgado o tribunal abordó por escrito. Incluso con ese filtro tan estrecho, la curva es empinada.
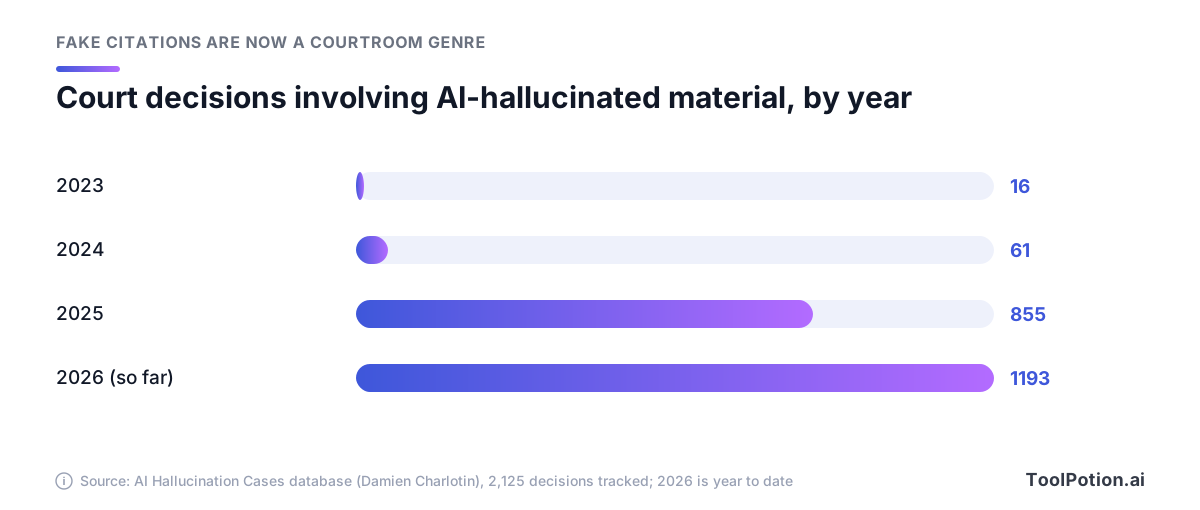
La barra de 2026 cubre solo parte del año y ya supera a la de 2025. Las personas que se representan a sí mismas suponen 1.227 de las resoluciones registradas, pero los abogados suponen 840, y la lista incluye 33 en las que el material alucinado provenía de un juez. Estados Unidos domina con 1.459 resoluciones, seguido de Canadá con 223 y Australia con 112.
El caso que lo empezó todo sigue siendo la mejor lección. En Mata v. Avianca, en 2023, un abogado de un caso federal en Nueva York le preguntó a ChatGPT si uno de los casos que le había dado era real. Dijo que sí. Presionado de nuevo, respondió que el caso "existe y se puede encontrar en bases de datos de investigación jurídica como Westlaw y LexisNexis" (CNN). El caso no existía, y el tribunal multó a los abogados y a su bufete con 5.000 $. El abogado declaró bajo juramento que "no sabía que su contenido pudiera ser falso".
Las facturas han crecido desde entonces. En Couvrette v. Wisnovsky, un tribunal federal de Oregón encontró quince citas inventadas y siete citas textuales falseadas en los escritos de los demandantes. Los eliminó del expediente, desestimó las demandas con carácter definitivo e impuso 110.204 $ en sanciones y costas, el total más alto de un caso estadounidense en la base de datos. Si usas IA en trabajo jurídico, nuestra guía de IA para trabajo legal cubre las configuraciones más seguras.
Los tribunales son solo el escenario más visible. Deloitte aceptó un reembolso parcial de una revisión de 440.000 $ para el gobierno australiano que citaba informes inexistentes de profesores universitarios e incluía una referencia inventada a una sentencia real. Más tarde la firma reveló que había usado una cadena de herramientas basada en GPT-4o de Azure OpenAI (The Guardian). EY retiró este año un informe sobre programas de fidelización que parecía incluir notas al pie falsas, según la misma noticia de TechCrunch que cubrió lo de KPMG. Y en 2025 el Chicago Sun-Times publicó una lista de lecturas de verano sindicada en la que 10 de los 15 libros eran inventados, según informó NPR.
Dónde falla lo que genera la IA
Los modelos ya casi no cometen faltas de ortografía, y los investigadores de OpenAI explican por qué los errores se han desplazado. La ortografía sigue patrones que un modelo grande aprende, pero "los datos arbitrarios y poco frecuentes, como el cumpleaños de una mascota, no se pueden predecir solo a partir de patrones y por eso producen alucinaciones" (OpenAI). Cuando le pidieron a un chatbot muy usado el título de la tesis doctoral de uno de los autores del propio artículo, dio tres respuestas distintas. Ninguna era correcta.
Eso te da un mapa. Los errores se concentran en unos pocos tipos de afirmaciones, y los más arriesgados son los que se disfrazan de prueba.
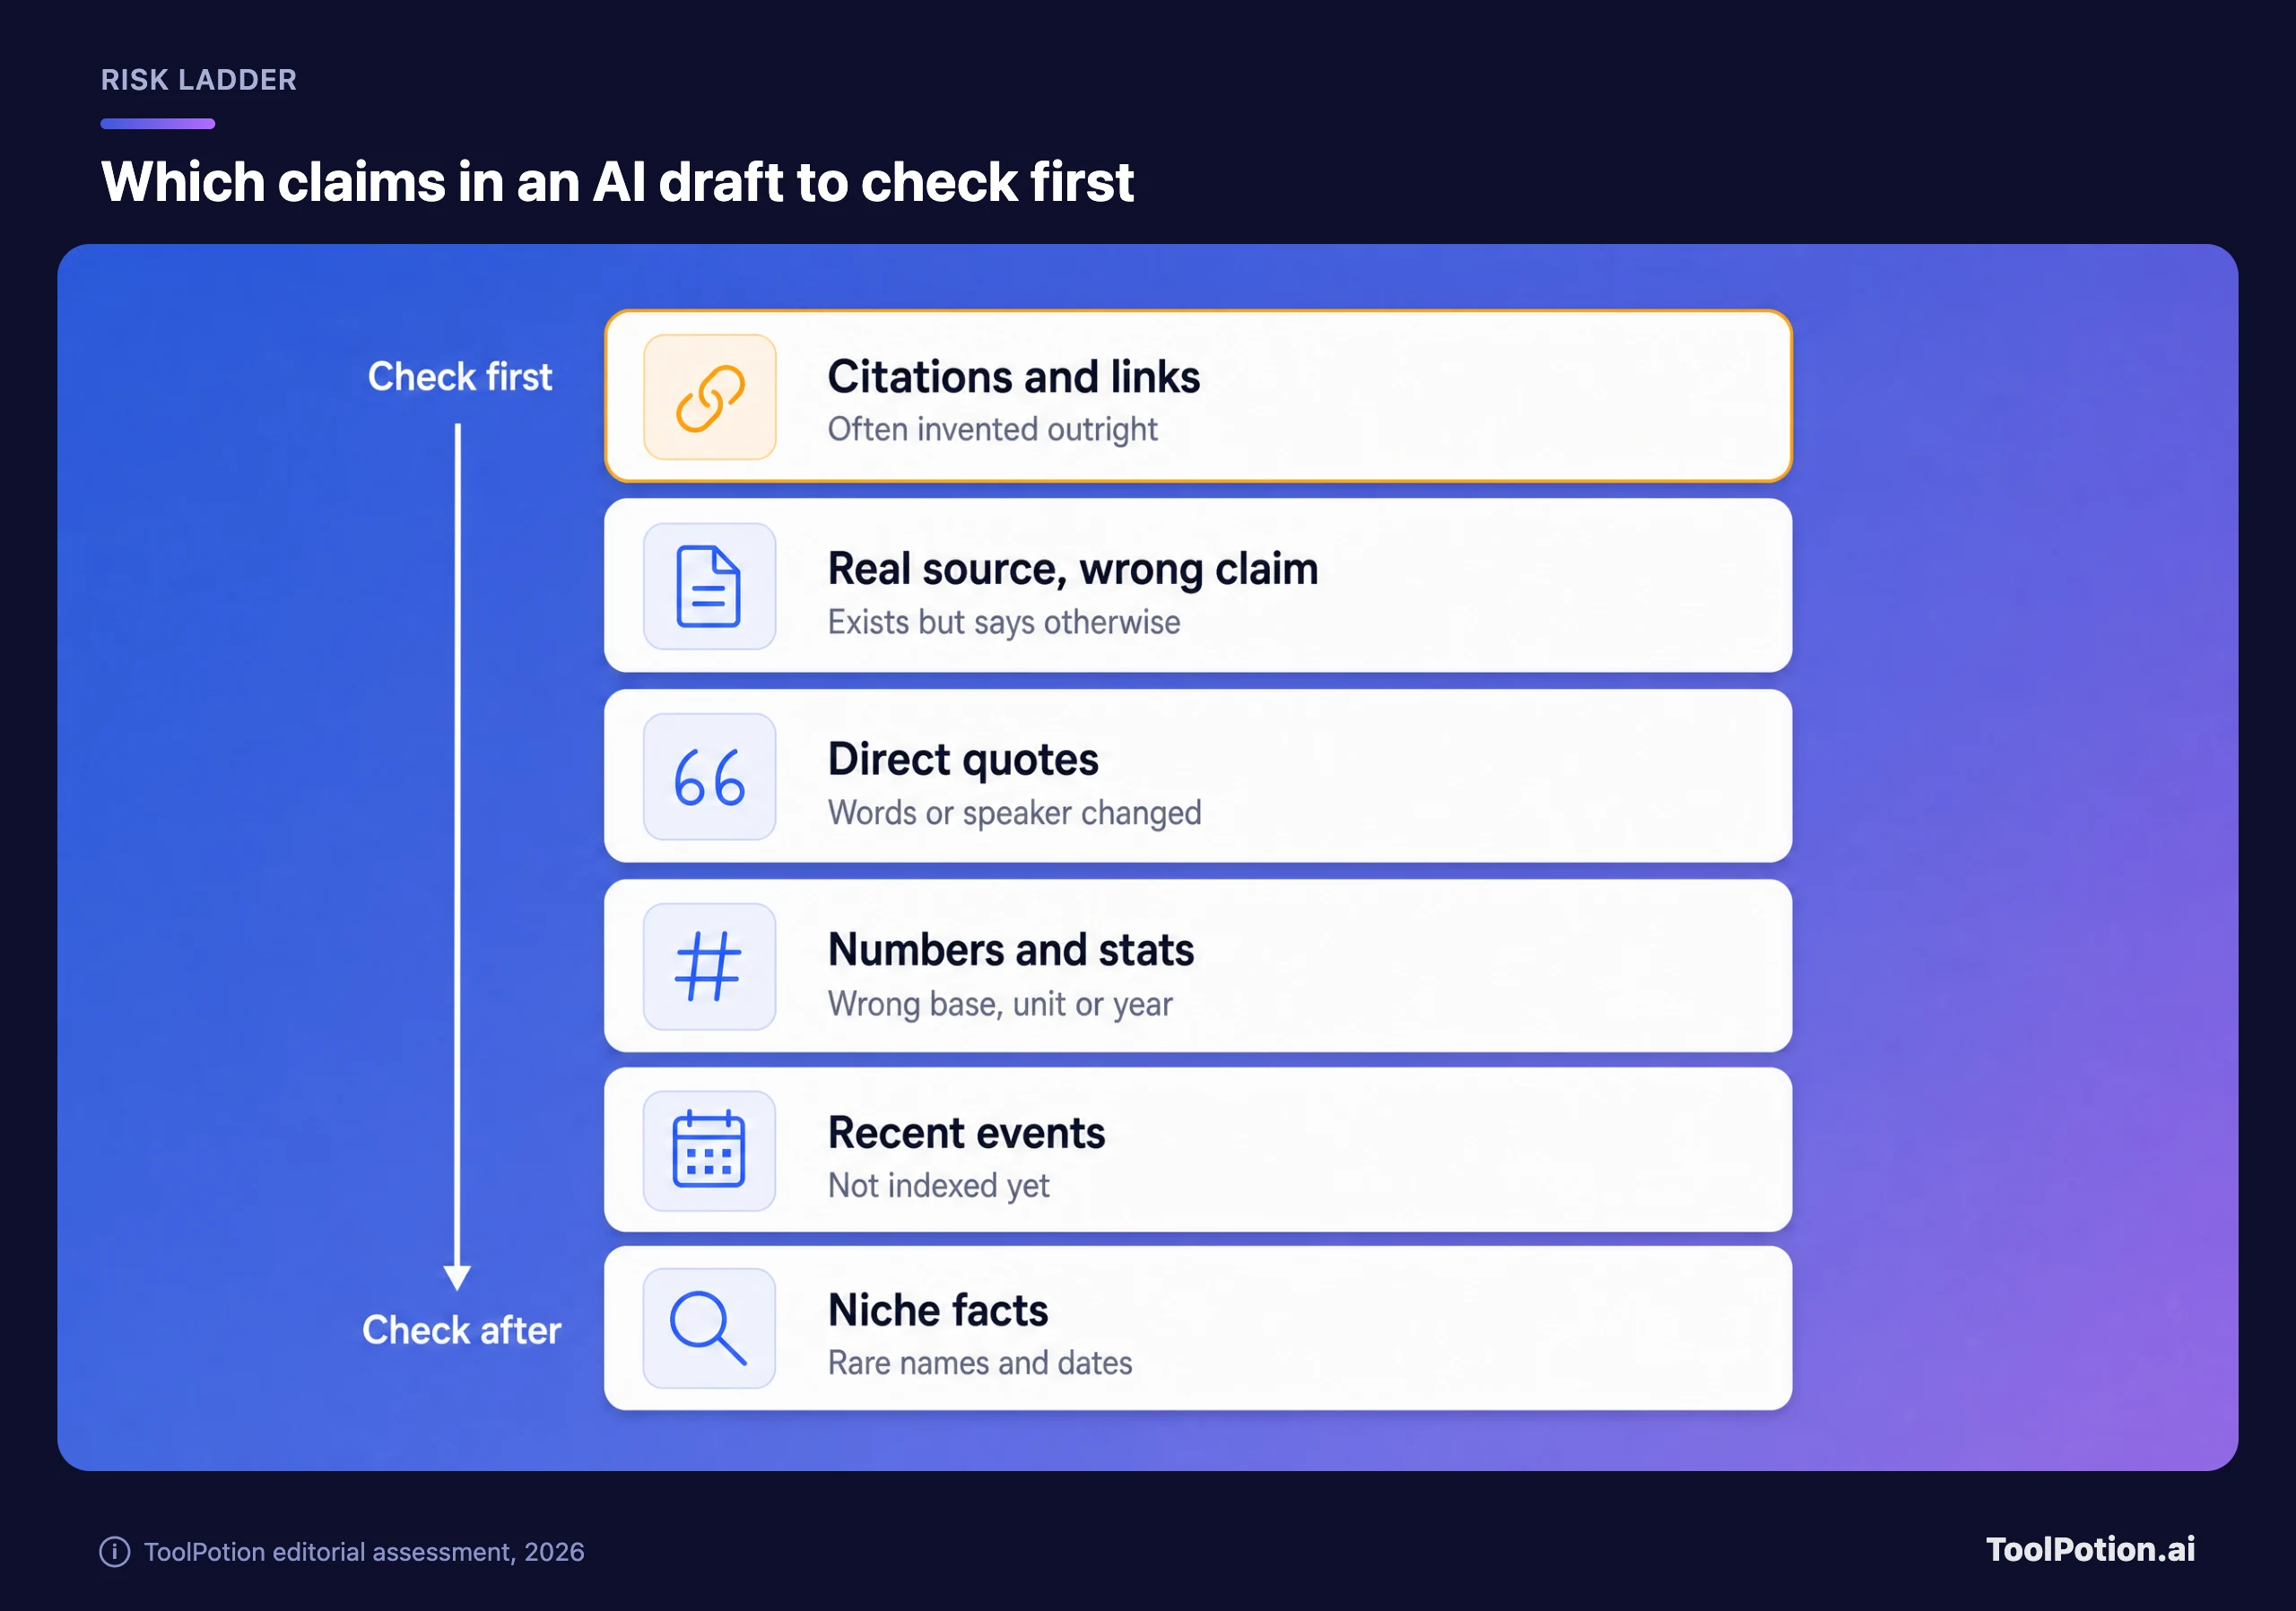
Las citas bibliográficas están arriba porque fallan de dos maneras. Algunas son inventadas por completo: cuando el Tow Center de Columbia lanzó 1.600 consultas a ocho buscadores con IA en 2025, pidiéndole a cada uno que identificara la fuente de un fragmento de noticia, las herramientas fallaron en conjunto en más del 60%, y Grok 3 mandó 154 de sus 200 citas a páginas de error (Tow Center). Otras son reales, pero se citan para algo que no dicen. La base de Charlotin cuenta 894 resoluciones con material tergiversado, frente a 1.752 con material inventado. Un enlace que funciona no atrapa ese segundo tipo.
Las frases textuales vienen después. La base de datos recoge 572 resoluciones con citas falsas, y el propio centro de ayuda de OpenAI menciona entre los fallos conocidos de ChatGPT las "citas, estudios, referencias o fuentes inexistentes inventados" (OpenAI Help). Las cifras fallan de forma más silenciosa: un dato real del año equivocado, un porcentaje presentado como puntos porcentuales, un precio regional hecho pasar por global.
Lo reciente es una trampa aparte. La documentación para desarrolladores de Perplexity dice que la alucinación es más probable cuando la información está tras un login o un muro de pago, cuando las búsquedas devuelven "resultados relacionados pero que no coinciden", o "cuando la información muy reciente aún no está indexada" (Perplexity docs). Un estudio de 2025 liderado por la BBC con más de 3.000 respuestas de noticias de ChatGPT, Microsoft Copilot, Google Gemini y Perplexity encontró problemas graves de precisión, incluida información desactualizada, en el 20% de ellas.
Luego está el tono. En esa prueba del Tow Center, ChatGPT identificó mal 134 artículos, pero solo señaló incertidumbre 15 veces en 200 respuestas, y los niveles de pago de algunas herramientas respondieron correctamente más preguntas, pero también dieron más respuestas erróneas con total seguridad. La página de ayuda de OpenAI lo dice sin rodeos: "El modelo puede expresar mucha confianza incluso en respuestas incorrectas". En lo que genera la IA, un tono seguro casi no dice nada sobre la exactitud.
Por qué pedirle al modelo que lo revise no basta
El atajo obvio es volver a pegar el borrador y preguntar si es exacto. Mata v. Avianca ya mostró cómo acaba eso, y la investigación lo respalda. Un artículo presentado en ICLR 2024 encontró que los modelos "tienen dificultades para autocorregir sus respuestas sin retroalimentación externa y, a veces, su rendimiento incluso empeora tras la autocorrección" (Huang et al.).
La causa está en el entrenamiento. Los investigadores de OpenAI sostienen que "los procedimientos estándar de entrenamiento y evaluación premian adivinar frente a reconocer la incertidumbre", igual que un examen tipo test premia una respuesta al azar frente a dejarla en blanco. También admiten que la precisión "nunca llegará al 100%" porque algunas preguntas reales no tienen respuesta. Un modelo que revisa su propio borrador recurre al mismo conocimiento que produjo el error, así que la revisión tiende a repetirlo.
La autorrevisión aun así sirve para algo. Un artículo de 2023 sobre Chain-of-Verification mostró que una versión estructurada ayuda: el modelo redacta una respuesta, escribe preguntas de verificación, las responde con independencia del borrador y luego revisa. Eso redujo las alucinaciones en varias tareas. Úsala para encontrar sospechosos, nunca para absolverlos.
Con fuente no es lo mismo que correcto
Darle al modelo una fuente de la que partir reduce la tasa de error. No la deja en cero. El ranking público de Vectara pide a los modelos que resuman más de 7.700 artículos usando solo los hechos de cada uno, y luego puntúa los resúmenes con el modelo de detección de la propia Vectara. Incluso en ese escenario fácil, todos los modelos de la lista añaden contenido sin respaldo en una parte de sus resúmenes (Vectara).
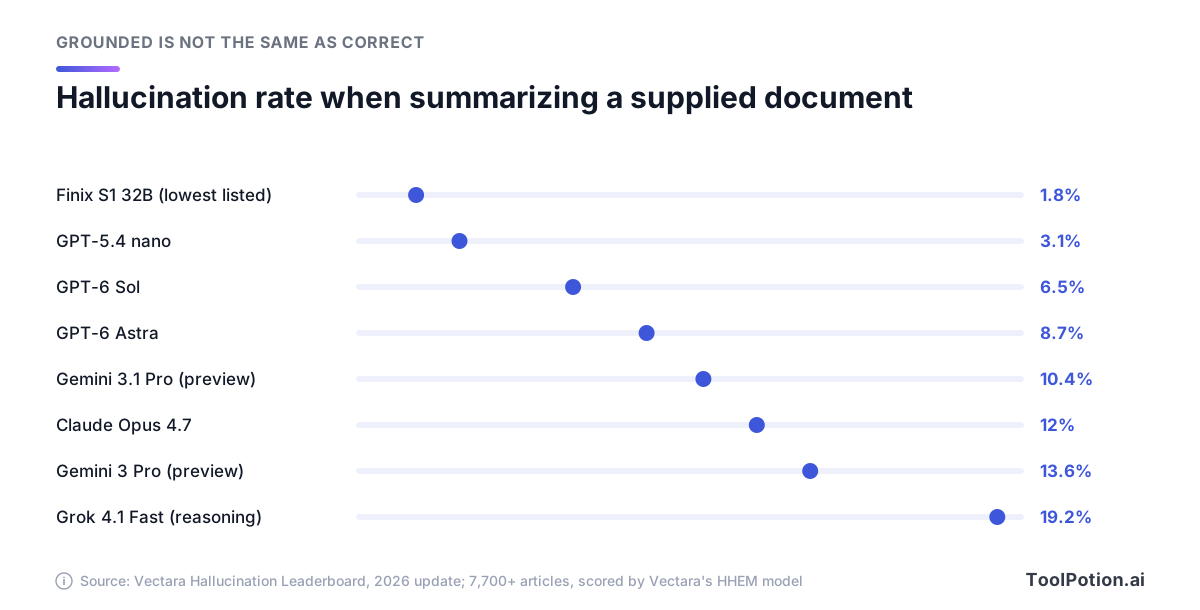
En la última actualización, GPT-6 Sol añadió material sin respaldo en el 6,5% de los resúmenes y Claude Opus 4.7 en el 12%. Que un modelo califique a otro no es perfecto, Vectara admite abiertamente que la prueba no recoge todos los tipos de alucinación, y la tabla aún no incluye todos los lanzamientos actuales. Aun así, la tendencia es clara. Un estudio de 2024 sobre herramientas de investigación jurídica que recuperan jurisprudencia real, entre ellas Lexis+ AI y AI-Assisted Research de Westlaw, encontró que aun así alucinaban entre el 17% y el 33% de las veces. El grounding reduce el problema a una sola pregunta: ¿lo dice la fuente? Sigues teniendo que hacerla.
Un flujo de verificación ordenado por riesgo
La solución es la priorización. Gran parte de un borrador es tejido conectivo: encuadre, transiciones y opiniones que defenderías de todos modos. Un puñado de afirmaciones sostiene el texto, y ahí es donde un error hace daño. Primero clasifica y luego dedica tu tiempo de verificación donde rinde.
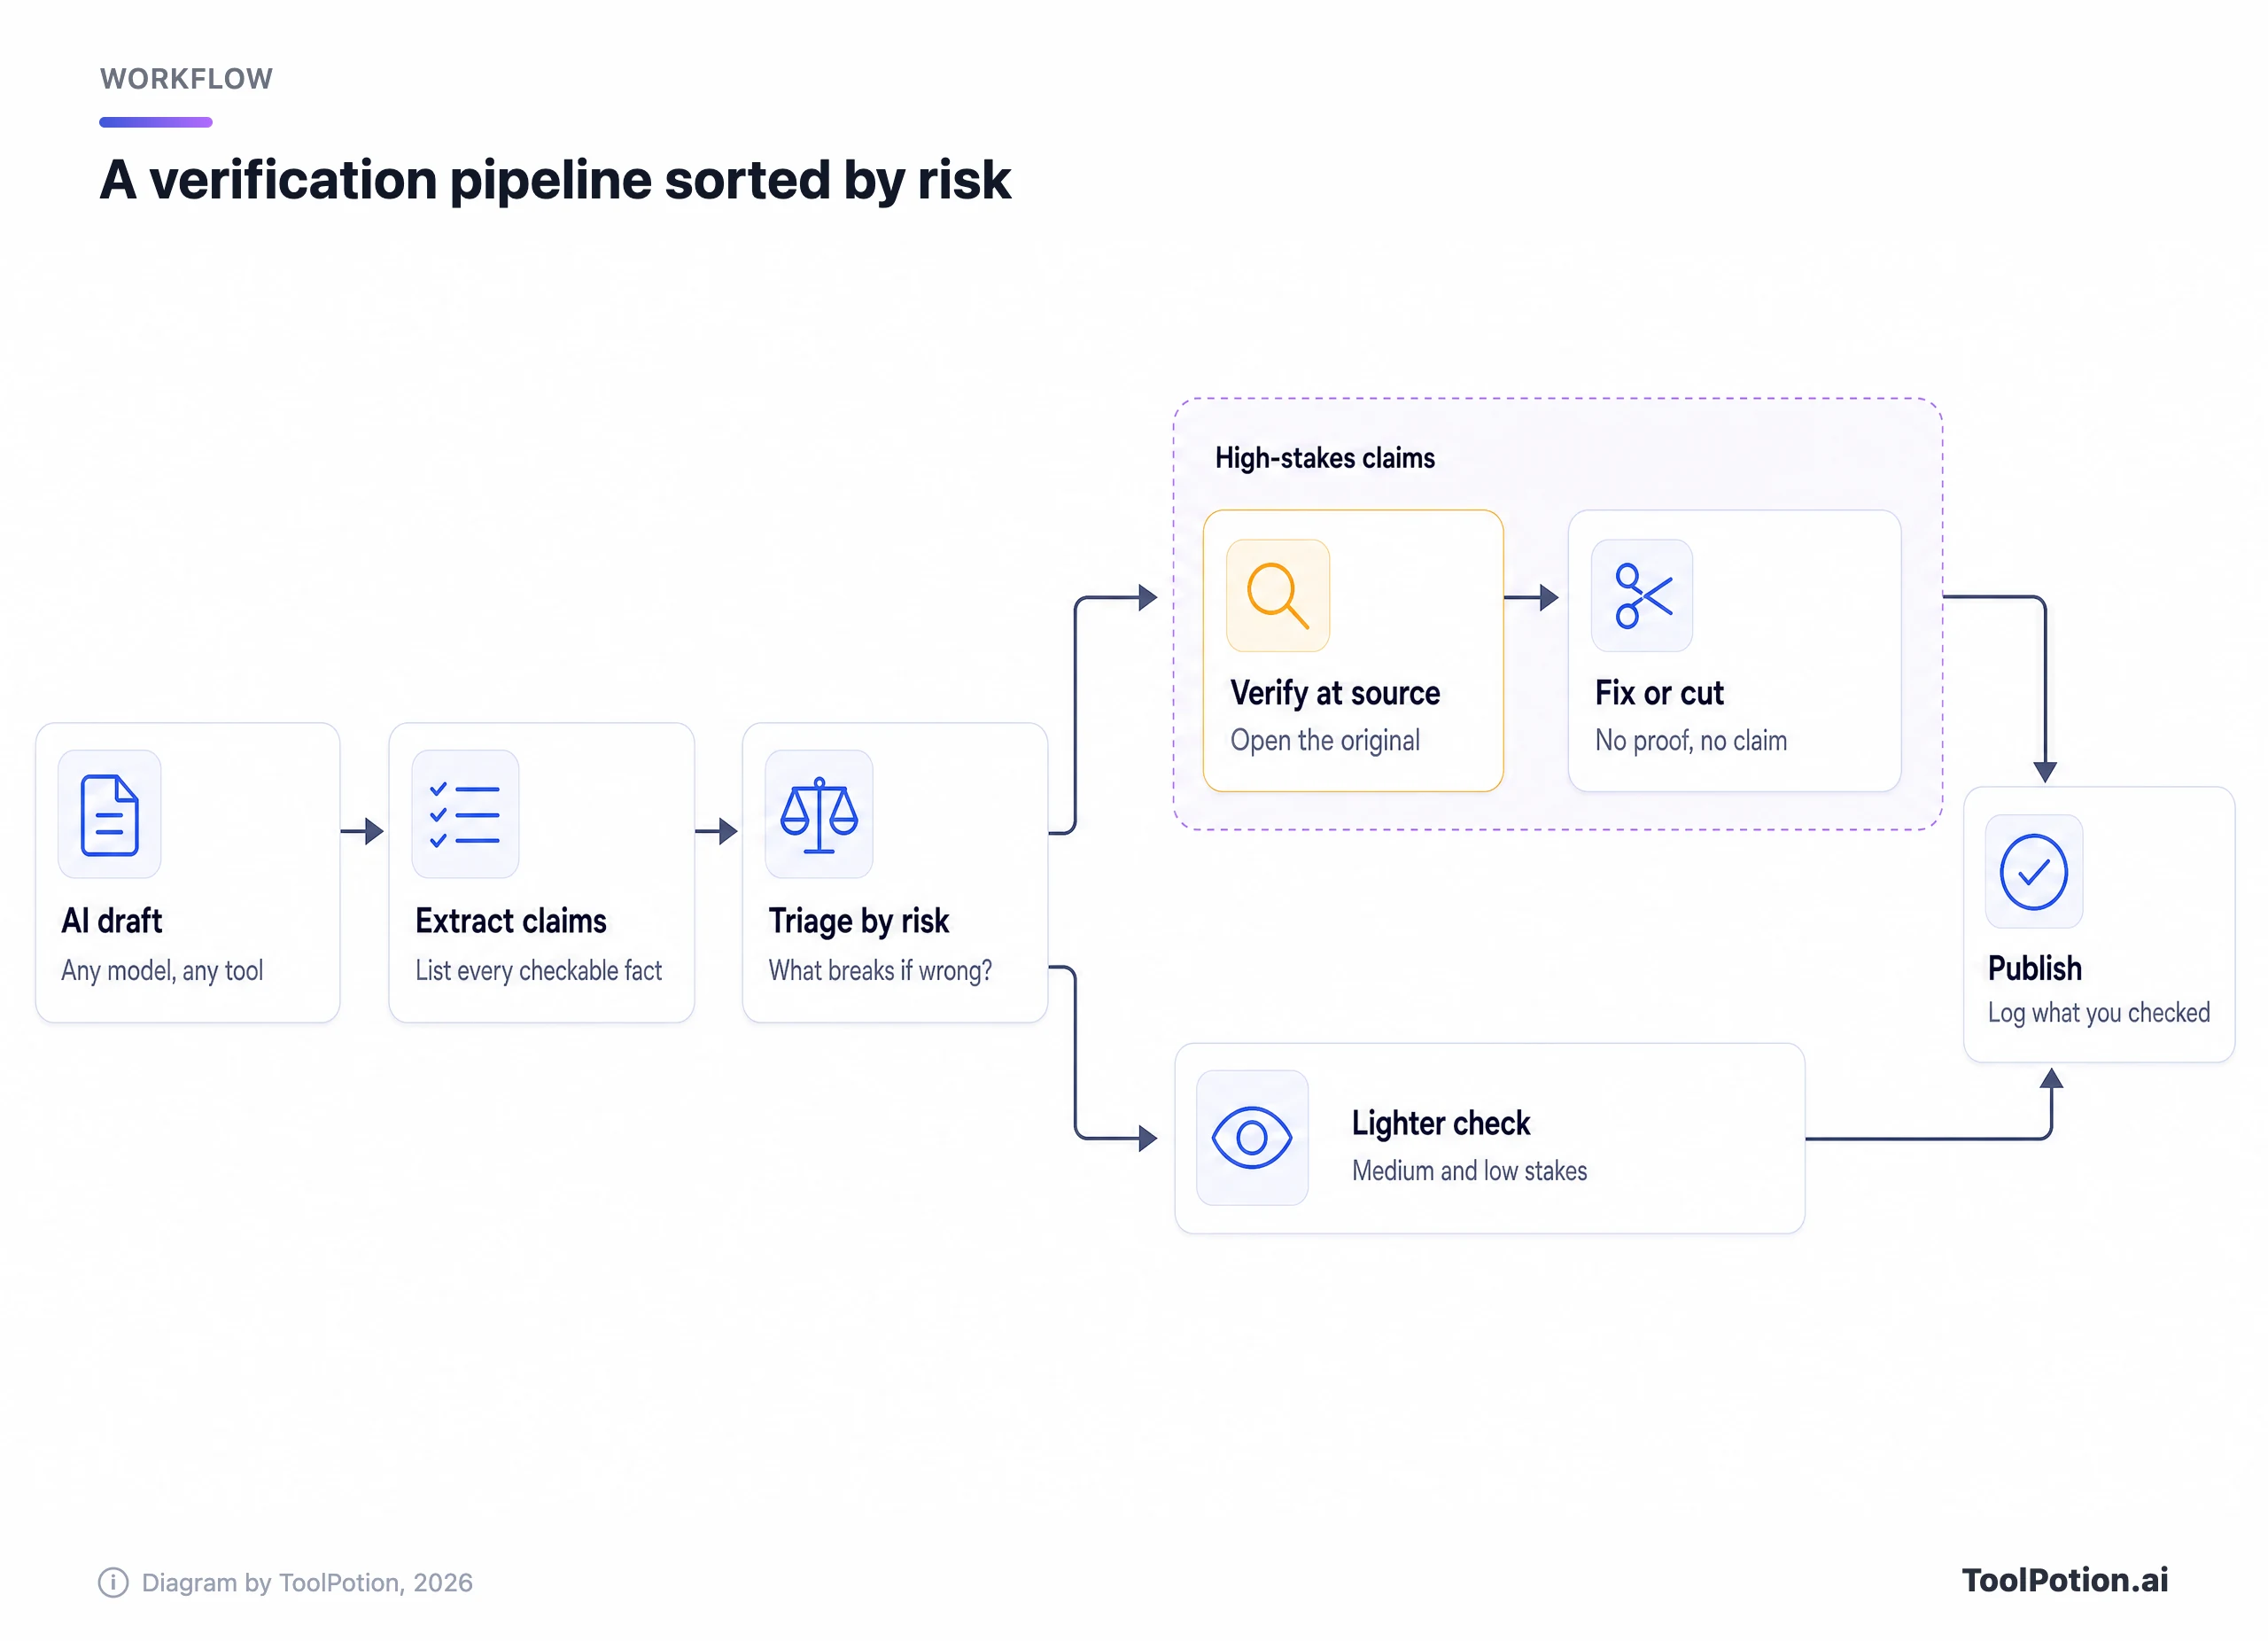
- Extrae las afirmaciones. Pide a un modelo que liste cada enunciado verificable del borrador: nombres, cifras, fechas, citas textuales, referencias y relaciones de causa y efecto. Encontrarás afirmaciones que no te habías dado cuenta de que estabas haciendo.
- Prioriza según lo que está en juego. Pregúntate qué pasa si cada afirmación está mal. Todo lo legal, médico o financiero es de alto riesgo, igual que cada referencia, cada cita textual, cualquier estadística en un titular o resumen y cualquier afirmación sobre una persona o empresa concreta. El contexto de apoyo que un lector podría repetir es de riesgo medio. El encuadre que podrías defender de memoria es de riesgo bajo.
- Verifica el nivel alto en la fuente primaria: la sentencia, el expediente, el conjunto de datos, la página de la propia empresa, el artículo científico en sí. Una noticia sobre un estudio no es el estudio.
- Haz una comprobación por muestreo del nivel medio con lectura lateral, que veremos más abajo, y dale al nivel bajo una lectura de editor.
- Corrige, suaviza o elimina. Si no puedes confirmar una afirmación en el tiempo que merece, quítala o atribúyela claramente ("según el proveedor"). Nunca conserves una afirmación solo porque suena bien.
- Lleva un registro. Una línea por cada afirmación de nivel alto, con la afirmación, la fuente y el punto exacto donde está el respaldo, te lleva minutos y responde a la pregunta que tarde o temprano hará un editor, un cliente o un juez.
Ajusta el esfuerzo a lo lejos que llegará el contenido. Una lluvia de ideas pide una lectura atenta. Un entregable para un cliente exige abrir en su fuente cada afirmación de nivel alto. Si la factura de verificación parece demasiado grande, probablemente el borrador tiene demasiadas afirmaciones, y recortar suele ser más rápido que verificar.
¿No sabes en qué nivel cae un contenido? Responde hasta tres preguntas a continuación.
Fíjate en lo que pregunta el árbol: adónde va el contenido y qué contiene, nunca qué modelo lo escribió. Un modelo más potente cambia las probabilidades. No cambia quién responde por el error.
Cómo comprobar citas, frases textuales y cifras
Cada tipo de afirmación tiene su prueba rápida. Ninguna requiere software especial, solo la disciplina de salir del chatbot y abrir el original.
Referencias y citas bibliográficas
Comprueba primero que existen. Busca el título, el DOI, el número de caso o la URL en una base de datos o buscador que controles tú, nunca en el chatbot que la generó. Después comprueba el respaldo: abre la fuente y localiza el pasaje que sostiene la frase. Si no lo encuentras en unos minutos, la referencia no pasa. Cuidado también con la versión. El Tow Center encontró que los buscadores con IA a menudo apuntaban a copias sindicadas en lugar de al editor original, y un preprint puede diferir del artículo publicado.
Citas textuales
Busca entre comillas una frase distintiva de cinco o seis palabras. Si no aparece en ningún sitio, o solo en páginas que parecen escritas por máquina, trata la cita como inventada. Si es real, lee el párrafo que la rodea y confirma quién habla, la fecha y el sentido. Una cita auténtica sacada de contexto engaña tanto como una falsa.
Cifras
Recalcula todo lo que puedas. Confirma la unidad (porcentaje o puntos porcentuales, mensual o anual, qué moneda), el año y el denominador. Si el borrador dice que una cifra se duplicó, encuentra los dos números. Una estadística sin fuente identificada no entra, por plausible que parezca.
Hechos recientes y afirmaciones virales
Revisa la fecha de cada fuente y prefiere reportajes publicados después del hecho. Para una afirmación que ya circula por internet, Fact Check Explorer de Google busca verificaciones publicadas y muestra qué organización valoró la afirmación y cómo. También puedes subir una imagen para ver si ya ha sido verificada.
Antes de publicar, pasa el borrador por esta checklist. Los cuatro primeros puntos cuentan doble.
La ponderación sigue los datos judiciales: las citas inventadas, las fuentes tergiversadas y las frases falsas llenan la mayor parte de esa base de datos. Si esas cuatro casillas siguen vacías, nada más de la lista hace que el borrador sea seguro para enviar.
Lectura lateral para afirmaciones sin rastro documental
Algunas afirmaciones llegan sin ninguna referencia que abrir. Para esas, toma prestado el hábito de los verificadores profesionales. El grupo Civic Online Reasoning de Stanford, tras observar a verificadores trabajando, concluyó que "la mejor forma de conocer un sitio web es la lectura lateral": salir de la página y ver qué dicen otras fuentes sobre ella, en lugar de estudiar la página misma.
Mike Caulfield convirtió ese hábito en una rutina de cuatro pasos llamada SIFT (Caulfield). Encaja bien con las respuestas de IA, con un ajuste: la fuente que investigas es el chatbot más el enlace que haya elegido.
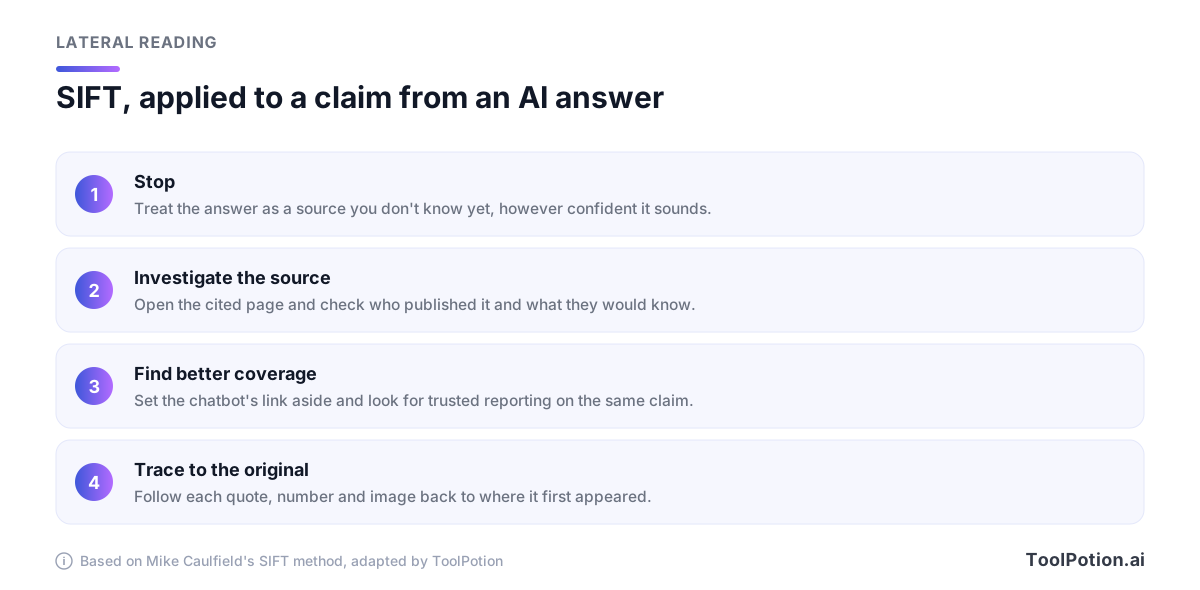
El tercer paso es el que más rinde con los chatbots. Cuando la afirmación importa más que el artículo que la trajo, el consejo de Caulfield es "ignorar la fuente que te llegó y buscar reportajes o análisis fiables sobre la afirmación". Así que busca la afirmación desde cero, con tus propias palabras. Si algo que debería tener amplia cobertura no tiene ninguna independiente, ya tienes tu respuesta.
La lectura lateral también sirve para juzgar las fuentes que un modelo encuentra por su cuenta. Una URL real en un sitio que nunca has oído nombrar es una fuente débil, por muy bien formateada que esté la referencia.
Prompts que facilitan la verificación
No puedes eliminar las alucinaciones con un prompt, pero sí puedes dar forma a la salida para que los errores sean más fáciles de detectar. La mejor guía es la documentación de los propios proveedores. Anthropic dice que sus técnicas recomendadas "reducen significativamente las alucinaciones" pero "no las eliminan por completo" (Anthropic docs). Para hábitos de prompting más amplios, consulta nuestra guía práctica de prompt engineering.
Dale permiso para decir que no lo sabe
Tanto Anthropic como Perplexity recomiendan a los desarrolladores permitir de forma explícita que el modelo admita incertidumbre o informe de que no encontró nada. La investigación de OpenAI muestra por qué importa. En su comparación con el benchmark SimpleQA, un modelo que se abstuvo en el 52% de las preguntas se equivocó en el 26%, mientras que otro que se abstuvo en el 1% se equivocó en el 75%, con una precisión casi idéntica. Úsalo como instrucción permanente:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
Pide las citas antes que las conclusiones
La documentación de Anthropic recomienda extraer citas literales de documentos largos antes de hacer la tarea, y después hacer que el modelo busque una cita de apoyo para cada afirmación y retire las que no pueda respaldar. En la práctica se ve así:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
Haz que señale lo que casi coincide, y no fuerces la brevedad
La guía de Perplexity añade una regla que vale la pena copiar: "Si encuentras resultados relacionados pero que no coinciden (por ejemplo, otro año, una empresa matriz o una filial), indica el desajuste de forma explícita antes de responder". Eso atrapa el dato correcto sobre la entidad equivocada, uno de los errores más difíciles de ver a simple vista. Sus reglas de ejemplo también le indican al modelo que cite las fuentes por dominio y que "no escriba URL completas".
La longitud también importa. Giskard, una empresa parisina de pruebas de IA, descubrió que pedirles respuestas concisas a GPT-4o, Mistral Large y Claude 3.7 Sonnet las hacía menos precisas, porque "cuando se les obliga a ser breves, los modelos eligen sistemáticamente la brevedad sobre la precisión". El mismo estudio encontró que los modelos tenían menos probabilidad de rebatir una afirmación polémica que el usuario planteaba con seguridad. Formula las preguntas con neutralidad, "¿Es cierto que X?", en lugar de dar la afirmación por hecha, como en "Explica por qué X".
Extrae las afirmaciones y ejecútalo dos veces
Este prompt alimenta el primer paso del flujo de trabajo. Úsalo con cualquier borrador, incluido uno que hayas escrito tú.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic también sugiere la verificación best-of-N: ejecutar el mismo prompt varias veces y comparar, ya que las respuestas incoherentes apuntan a probables alucinaciones. Es el mismo síntoma que vio OpenAI con los tres títulos de tesis. El desacuerdo entre ejecuciones te dice dónde mirar. El acuerdo no prueba nada.
Las herramientas con fuentes ayudan, hasta cierto punto
Otra clase de herramientas acota aquello de lo que el modelo puede tirar. Eso convierte "¿es cierto?" en "¿lo dice la fuente?", que es una comprobación más rápida. No elimina la comprobación.
Google rebautizó NotebookLM como Gemini Notebook a principios de este año y lo mantuvo como herramienta de investigación independiente, que según Google usan más de 30 millones de personas (Google). En el chat responde a partir de las fuentes que añades y "usa citas directas, texto e imágenes de tus fuentes como referencias". Pasa el cursor sobre una cita para ver el texto citado, o haz clic para saltar a él en su contexto (Gemini Notebook Help). Eso agiliza comprobar el respaldo. Conoce también sus límites: las páginas de ayuda de Google indican que no se admiten páginas web con muro de pago y que no se importan las notas al pie ni los comentarios de los archivos de Google. Las nuevas funciones de chat con agentes, que pueden buscar en la web y ejecutar código, están marcadas como experimentales, con la indicación "Asegúrate de verificarlo".
Los motores de respuesta como Perplexity adjuntan enlaces a cada respuesta, un avance real frente a un chatbot sin fuentes. Los enlaces siguen necesitando que los abras. Perplexity se equivocó en el 37% de las consultas en la prueba de 2025 del Tow Center (las herramientas han cambiado desde entonces), y la propia ayuda de Gemini de Google señala que "no todas las respuestas incluyen enlaces o fuentes relacionados".
Para afirmaciones de investigación, las herramientas de búsqueda académica basan sus respuestas en artículos científicos y no en la web abierta. Consensus busca en literatura revisada por pares y dice que si "no encuentra evidencia relevante suficiente, te lo dirá" en lugar de rellenar huecos. Elicit afirma respaldar cada afirmación generada por IA con citas a nivel de frase. Scite muestra si investigaciones posteriores apoyaron o contradijeron los hallazgos de un artículo, lo que atrapa un fallo que las demás pasan por alto: un estudio real que desde entonces ha sido cuestionado.
Si montas tu propio pipeline, la Citations API de Anthropic devuelve el pasaje exacto detrás de cada afirmación, y la documentación de Anthropic dice que esas citas "tienen garantizado contener punteros válidos a los documentos proporcionados". Eso descarta las fuentes inventadas. No confirma que el pasaje respalde la frase a la que está asociado. Los verificadores de referencias están al final de la cadena. GPTZero ofrece un detector de alucinaciones que escanea bibliografías, y su equipo señaló el informe de KPMG y, a principios de este año, encontró 100 citas alucinadas en 51 artículos aceptados en NeurIPS, una de las principales conferencias de IA, según informó TechCrunch.
| Tipo de herramienta | Basa las respuestas en | Lo que aún debes comprobar |
|---|---|---|
| Herramientas de cuadernos (Gemini Notebook) | Fuentes que subes tú | Que cada pasaje citado respalde la afirmación y que tus fuentes sean correctas |
| Motores de respuesta (Perplexity, ChatGPT con búsqueda) | Resultados web en vivo | Abrir cada enlace, revisar su fecha y encontrar al editor original |
| Búsqueda de investigación (Consensus, Elicit, Scite) | Artículos académicos | Los hallazgos reales del artículo, sus límites y cualquier trabajo posterior que lo contradiga |
| APIs de citas (Claude Citations) | Documentos que aportas | Que la afirmación esté respaldada, más allá de un puntero válido |
| Verificadores de referencias (GPTZero) | Registros bibliográficos | Si una referencia real dice lo que afirma el borrador |
Para comparar opciones, explora el ranking de asistentes de investigación con IA, el ranking de buscadores con IA y el ranking para buscar literatura académica. Nuestros análisis de asistentes de investigación con IA y buscadores con IA profundizan en funciones y precios.
Preguntas frecuentes
¿Puedo usar un modelo de IA para verificar a otro?
Como primera pasada, sí. Un segundo modelo, sobre todo uno con búsqueda, señalará algunos errores que el primero pasó por alto, y los desacuerdos te muestran dónde mirar. No puede confirmar nada, porque ambos pueden compartir los mismos huecos. Trata sus avisos como una lista de tareas y resuelve cada uno en la fuente. Si estás eligiendo un segundo asistente, nuestra guía de alternativas a ChatGPT compara las opciones principales.
¿Los detectores de IA verifican datos?
No. Herramientas como el detector de Originality.ai estiman si un texto fue escrito por una máquina. Eso no dice nada sobre si una afirmación es cierta, y un borrador escrito por una persona puede estar igual de equivocado. Verificar datos requiere la fuente original.
¿Cuánto debería tardar la verificación de un borrador de IA?
Depende de cuántas afirmaciones de alto riesgo contenga el borrador, no de su extensión. Cuéntalas tras la priorización. Un explicativo de 2.000 palabras con cuatro estadísticas y dos citas es un trabajo corto, mientras que un memo de una página lleno de referencias no lo es.
¿Puedo citar a ChatGPT u otro chatbot como fuente?
No para hechos. El propio consejo de OpenAI es "usar ChatGPT como primer borrador, no como fuente final". Cita el documento de origen que verificaste. Si la salida de la IA es en sí misma el tema, como en una prueba de un modelo, indica qué modelo usaste y cuándo.
¿Los agentes de deep research hacen innecesaria la verificación?
No. Agentes como deep research de OpenAI compilan informes de investigación con citas a partir de muchas fuentes web, lo que te da más referencias que abrir, no menos afirmaciones que comprobar. El problema de las fuentes tergiversadas se aplica a cada frase citada, así que la priorización importa más cuanto más largos son los informes.