描述
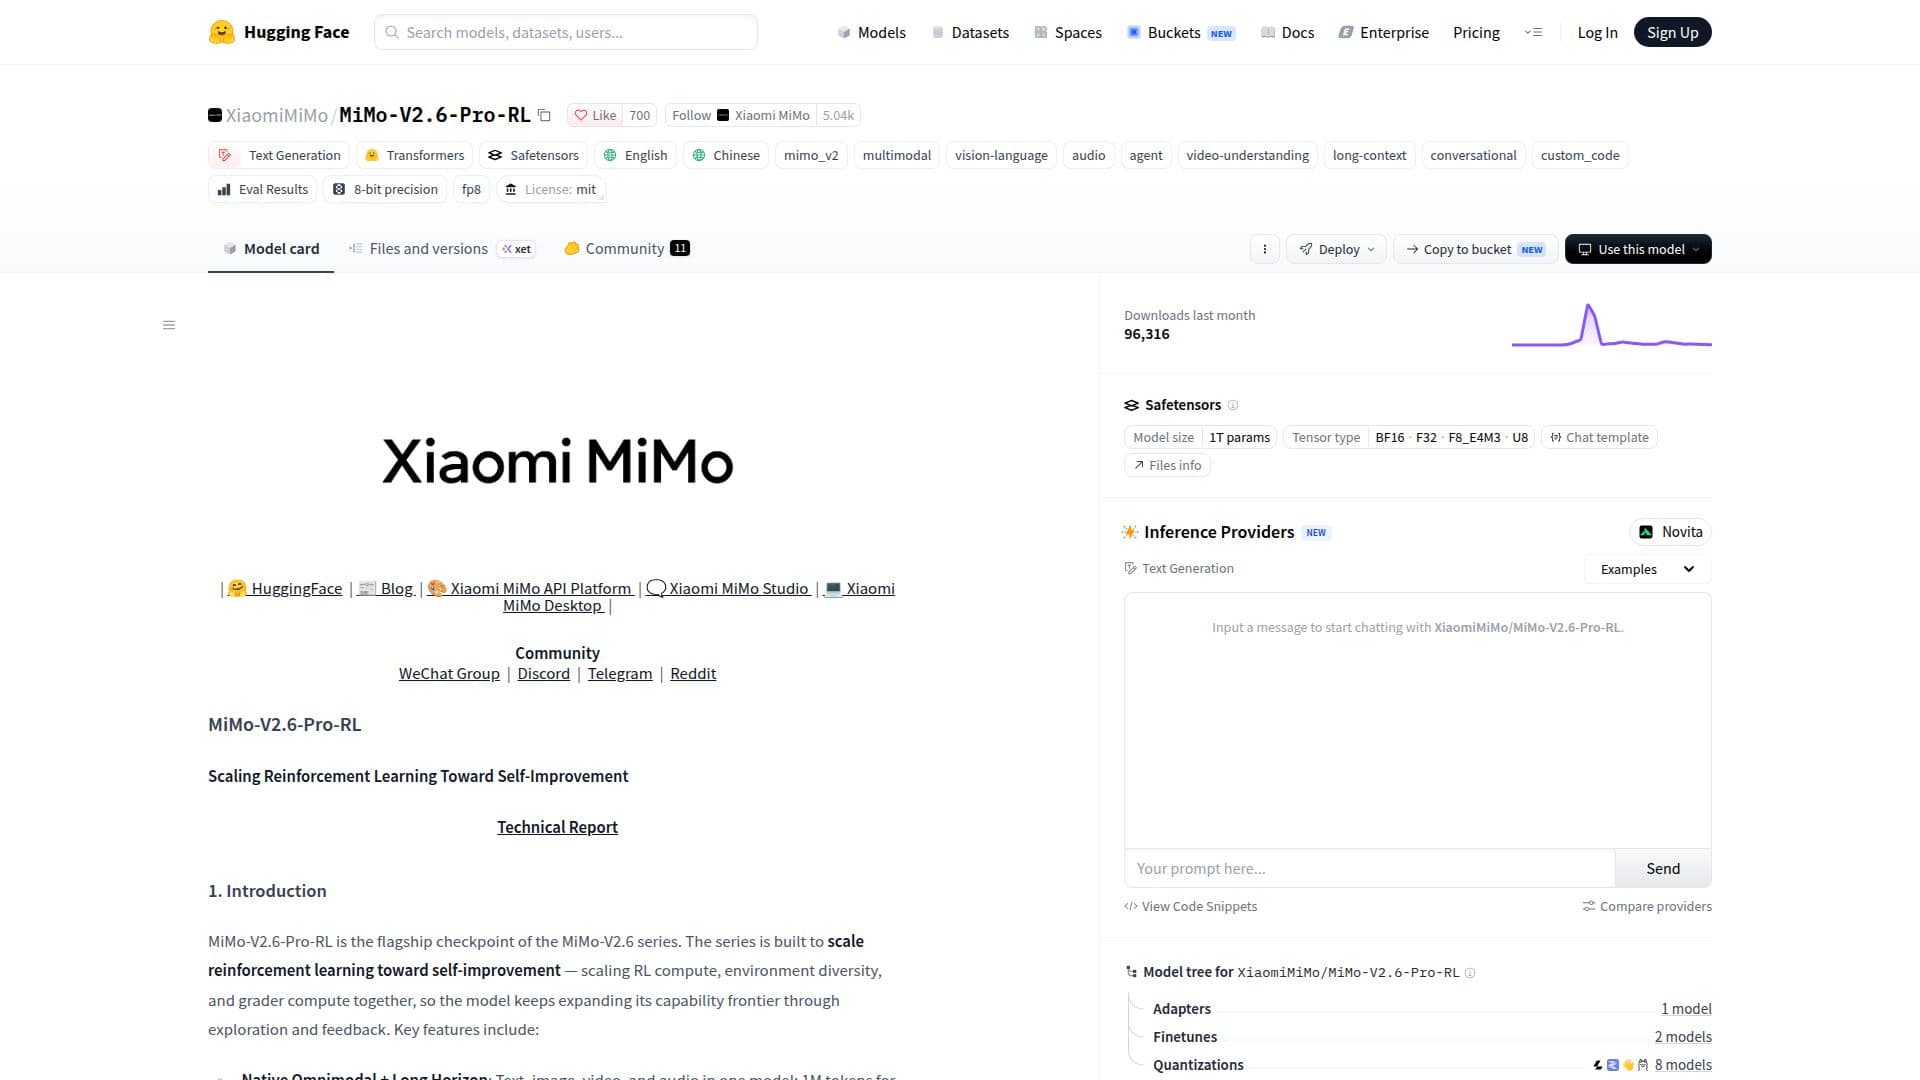
MiMo-V2.6-Pro-RL 是 MiMo 系列的领先模型,旨在推动强化学习朝向自我改进发展。该模型旨在同时扩展 RL 计算、环境多样性和评分计算,使其能够通过探索和反馈扩展其能力。主要特点包括原生的全模态方法,将文本、图像、视频和音频集成到一个模型中,以及长达 100 万个标记的上下文长度,以处理大量存储库和多会话代理运行。
阅读更多
该模型采用独特的“你只需 RL 一次”策略,将任务混合并在单个批次中利用,以增强能力并在不同领域之间转移策略。它在大批量上利用完全异步的群体相对策略优化(GRPO),每次更新处理数十亿个标记。群体代理评分系统通过对解决方案进行排名并引导高效路径,增强了自我改进循环。
MiMo-V2.6-Pro-RL 还具有多前缀多教师在线蒸馏(MOPD2),将自主学生回滚与前缀条件回滚相结合,将能力扩展到复杂任务。该模型的架构包括 1.02 万亿个总参数的稀疏专家混合和 681 百万个参数的视觉编码器。
该模型可通过多个平台进行部署,包括 AI Studio、MiMo Code 和小米 MiMo 桌面。它支持 Docker 部署以实现最佳性能,并可通过小米 MiMo 开放平台 API 和 OpenRouter 访问。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端
- 平台网页版
MiMo-V2.6-Pro-RL亮点
原生全模态集成
100 万标记上下文长度
你只需 RL 一次策略
群体相对策略优化
群体代理评分
多前缀多教师蒸馏
稀疏专家混合架构
可在多个平台上使用
MiMo-V2.6-Pro-RL入门
访问模型页面:访问 MiMo-V2.6-Pro-RL 的官方 Hugging Face 页面。
身份验证:确保您拥有访问模型所需的凭据。
配置:根据您的要求设置模型参数。
发送提示:输入您的数据以与模型交互并接收输出。
MiMo-V2.6-Pro-RL的使用案例
- 多模态处理
- 强化学习
- 大规模数据处理
- 跨领域策略转移
- 先进的评分系统