描述
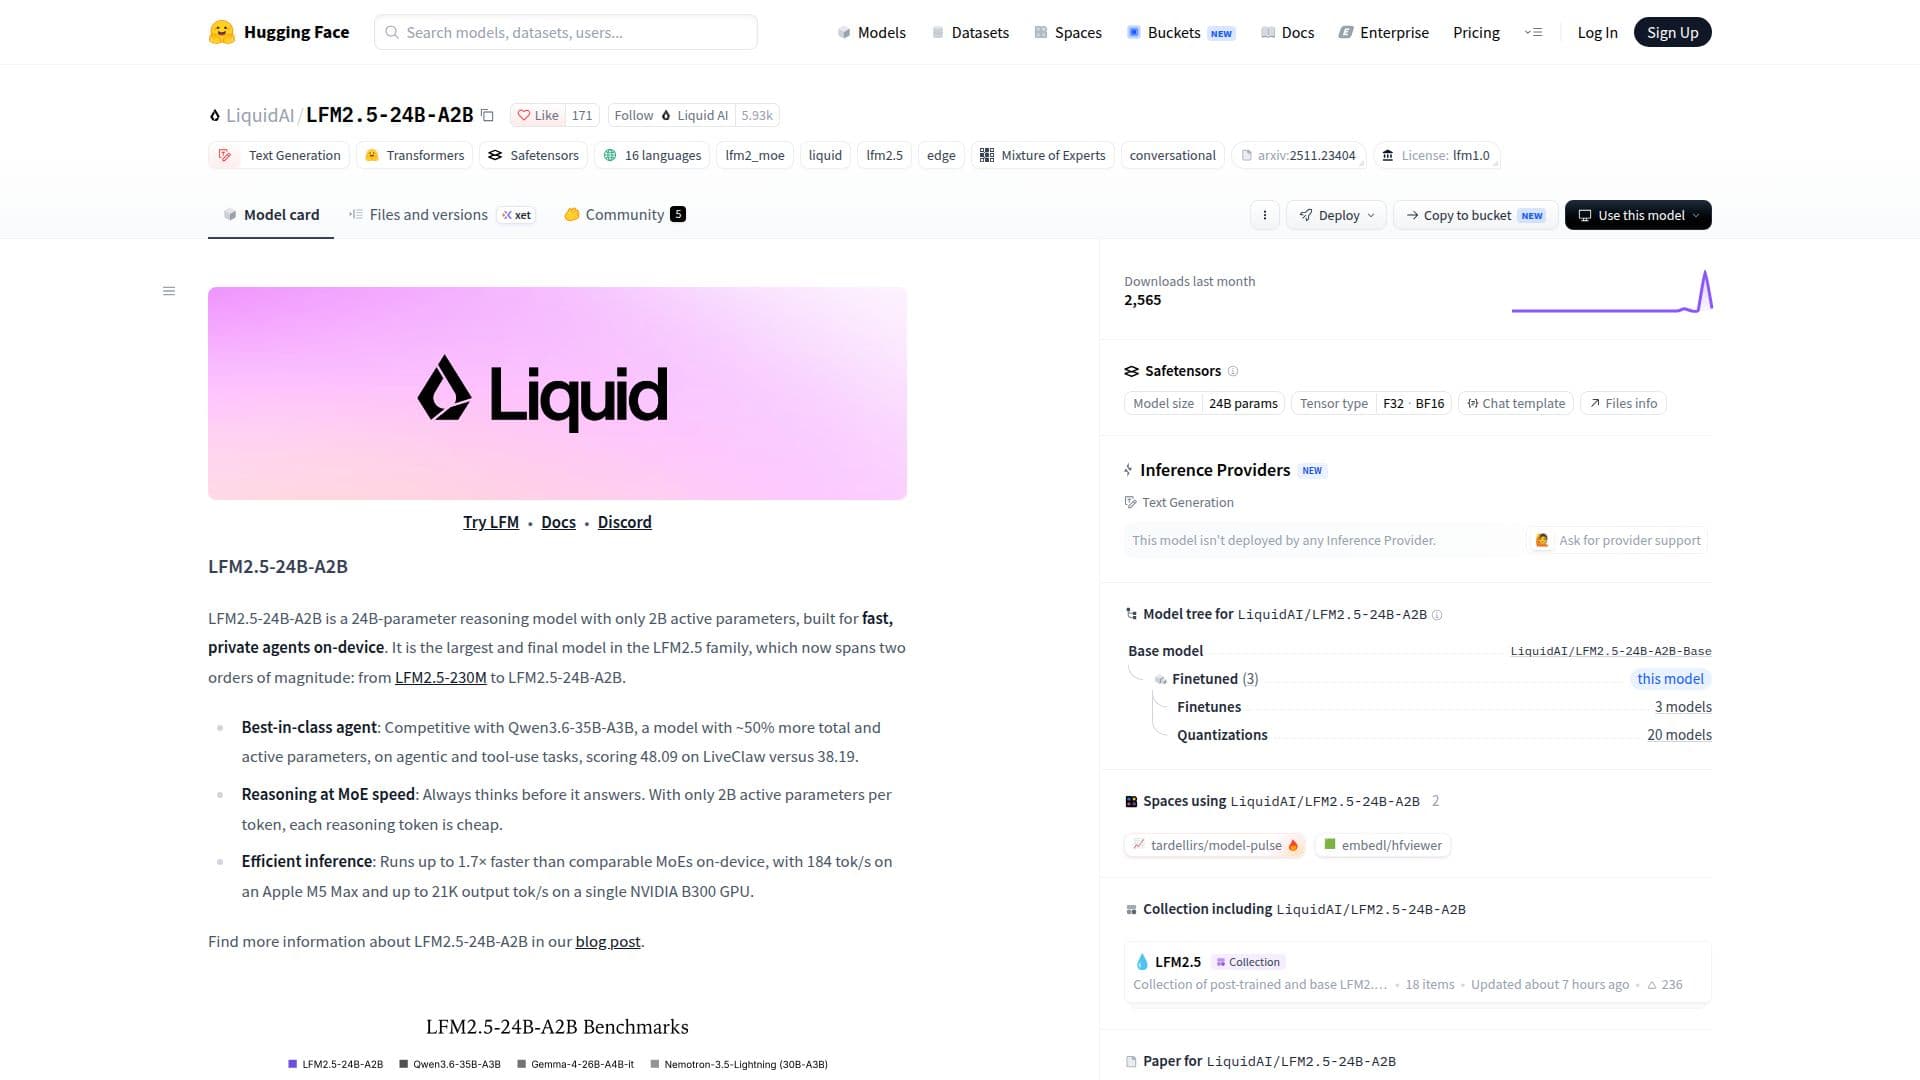
LiquidAI LFM2.5-24B-A2B 是一个最先进的推理模型,设计为仅使用 24B 中的 2B 活动参数高效运行。该模型属于 LFM2.5 系列,专为快速、私密的设备端应用而定制。它在代理和工具使用任务中表现出色,与 Qwen3.6-35B-A3B 等更大模型相比,展现出竞争力的性能。
阅读更多
该模型经过工程设计,具有高效的推理能力,在 Apple M5 Max 和 NVIDIA B300 GPU 等设备上运行速度比可比模型快 1.7 倍。它支持多种语言,包括英语、阿拉伯语、中文等,使其在多语言应用中具有广泛的适用性。
LFM2.5-24B-A2B 提供多种格式,包括用于高吞吐量 GPU 服务的 FP8、用于 CPU 推理的 GGUF 和用于跨平台部署的 ONNX。这种灵活性使其能够集成到从云到边缘再到移动的多种环境中。
该模型特别适合需要推理和工具调用能力的应用。它支持结构化的四步过程进行函数调用,增强了其在代理工作流中的实用性。然而,不建议在没有补充检索或网络搜索能力的情况下用于知识密集型任务。
对于开发者,LFM2.5-24B-A2B 提供广泛的微调选项,包括使用 Unsloth 和 TRL 等框架进行监督微调和直接偏好优化。该模型在各种任务中的性能经过基准测试,始终显示出高效性和速度。
总体而言,LiquidAI LFM2.5-24B-A2B 是开发者寻求强大、高效的设备端推理模型的可靠选择。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端, 本地部署
- 平台网页版, Windows, macOS
LiquidAI LFM2.5-24B-A2B亮点
24B 总参数
2B 活动参数
高效的设备端推理
支持多种语言
工具调用能力
提供多种格式
支持微调
高速 GPU 推理
LiquidAI LFM2.5-24B-A2B入门
访问模型页面:访问 Hugging Face 模型页面
身份验证:登录到您的 Hugging Face 账户
配置:为您的特定用例设置模型
发送提示:使用模型进行推理任务
微调:使用您的数据自定义模型
LiquidAI LFM2.5-24B-A2B的使用案例
- 多语言支持
- 设备端代理
- 工具调用工作流
- 跨平台部署
- 微调应用