描述
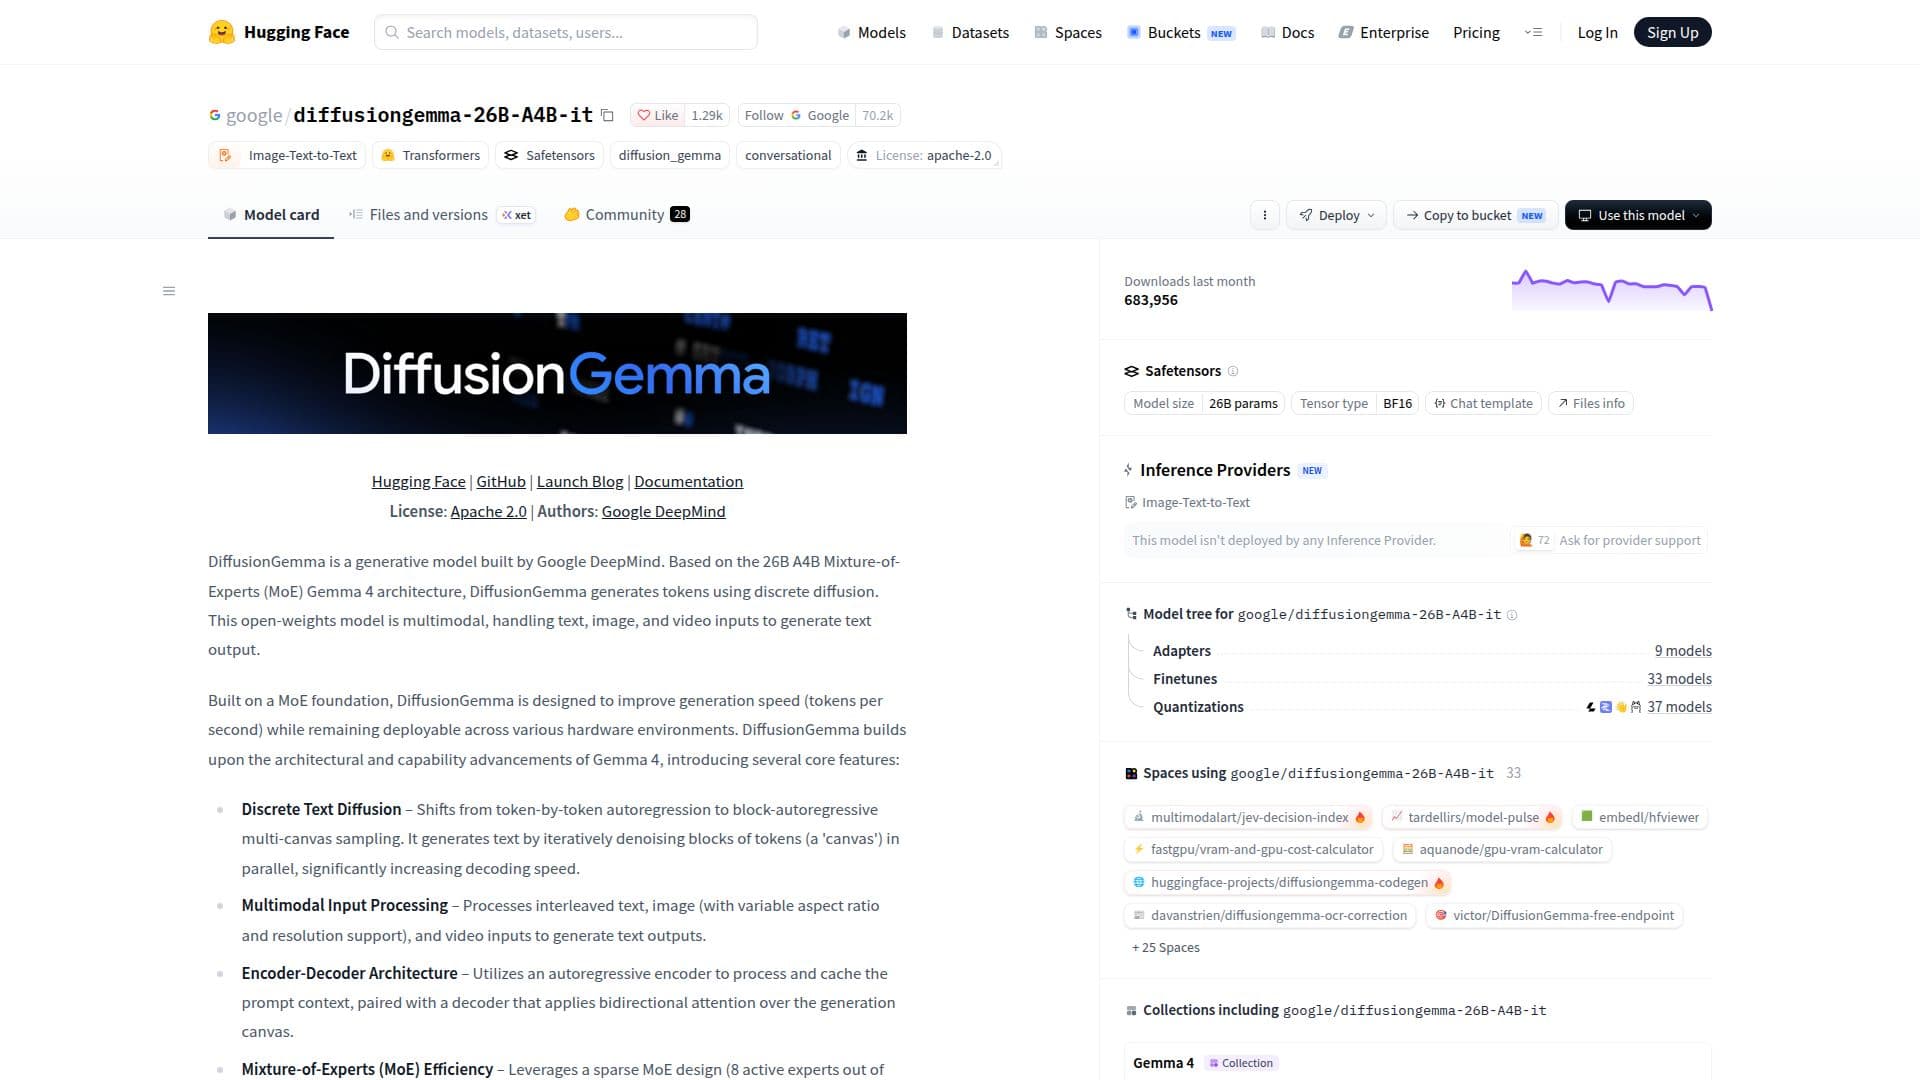
DiffusionGemma 是 Google DeepMind 开发的生成模型,利用 26B A4B 专家混合 (MoE) Gemma 4 架构。它旨在从多模态输入(包括文本、图像和视频)生成文本输出。该模型采用离散扩散技术来提高标记生成速度,使其适合在多种硬件环境中部署。
阅读更多
该模型的架构采用块自回归多画布采样方法,通过并行去噪标记块显著提高解码速度。这种方法使 DiffusionGemma 的文本生成速度高于传统自回归模型。编码器-解码器架构利用自回归编码器处理和缓存提示上下文,而解码器则在生成画布上应用双向注意力。
DiffusionGemma 的稀疏 MoE 设计,具有 128 个专家中的 8 个活跃专家,提供强大的推理能力,同时保持低内存占用。这种高效性使其适合本地执行,并优化了小批量推理,在单个能力强大的加速器上实现高速生成。
该模型支持本地系统提示更新,能够进行结构化和可控的对话。它还包括可配置的思维模式,以增强推理能力。DiffusionGemma 的上下文窗口可达到 256K 个标记,能够有效处理长上下文任务。
DiffusionGemma 已在各种基准测试中进行评估,显示出在文本生成和推理任务中的竞争性能。它支持多语言能力,预训练于超过 140 种语言,并提供强大的图像和视频理解功能,包括物体检测、文档解析和视频内容分析。
总体而言,DiffusionGemma 是一个多功能模型,旨在实现高速的多模态文本生成,适用于内容创作、研究和教育等广泛应用。
- 类别AI 模型与大语言模型
- 定价模式Open Weights
- 部署云端
- 平台网页版
DiffusionGemma亮点
离散文本扩散
多模态输入处理
编码器-解码器架构
专家混合效率
思维模式
优化的小批量推理
本地系统提示支持
长上下文处理
DiffusionGemma入门
访问模型页面:访问 Hugging Face 模型页面
身份验证:登录或创建账户
配置:设置模型参数
发送提示:输入文本、图像或视频提示
微调:调整特定任务的设置
DiffusionGemma的使用案例
- 文本生成
- 图像数据提取
- 视频理解
- 多语言支持
- 研究与教育