描述
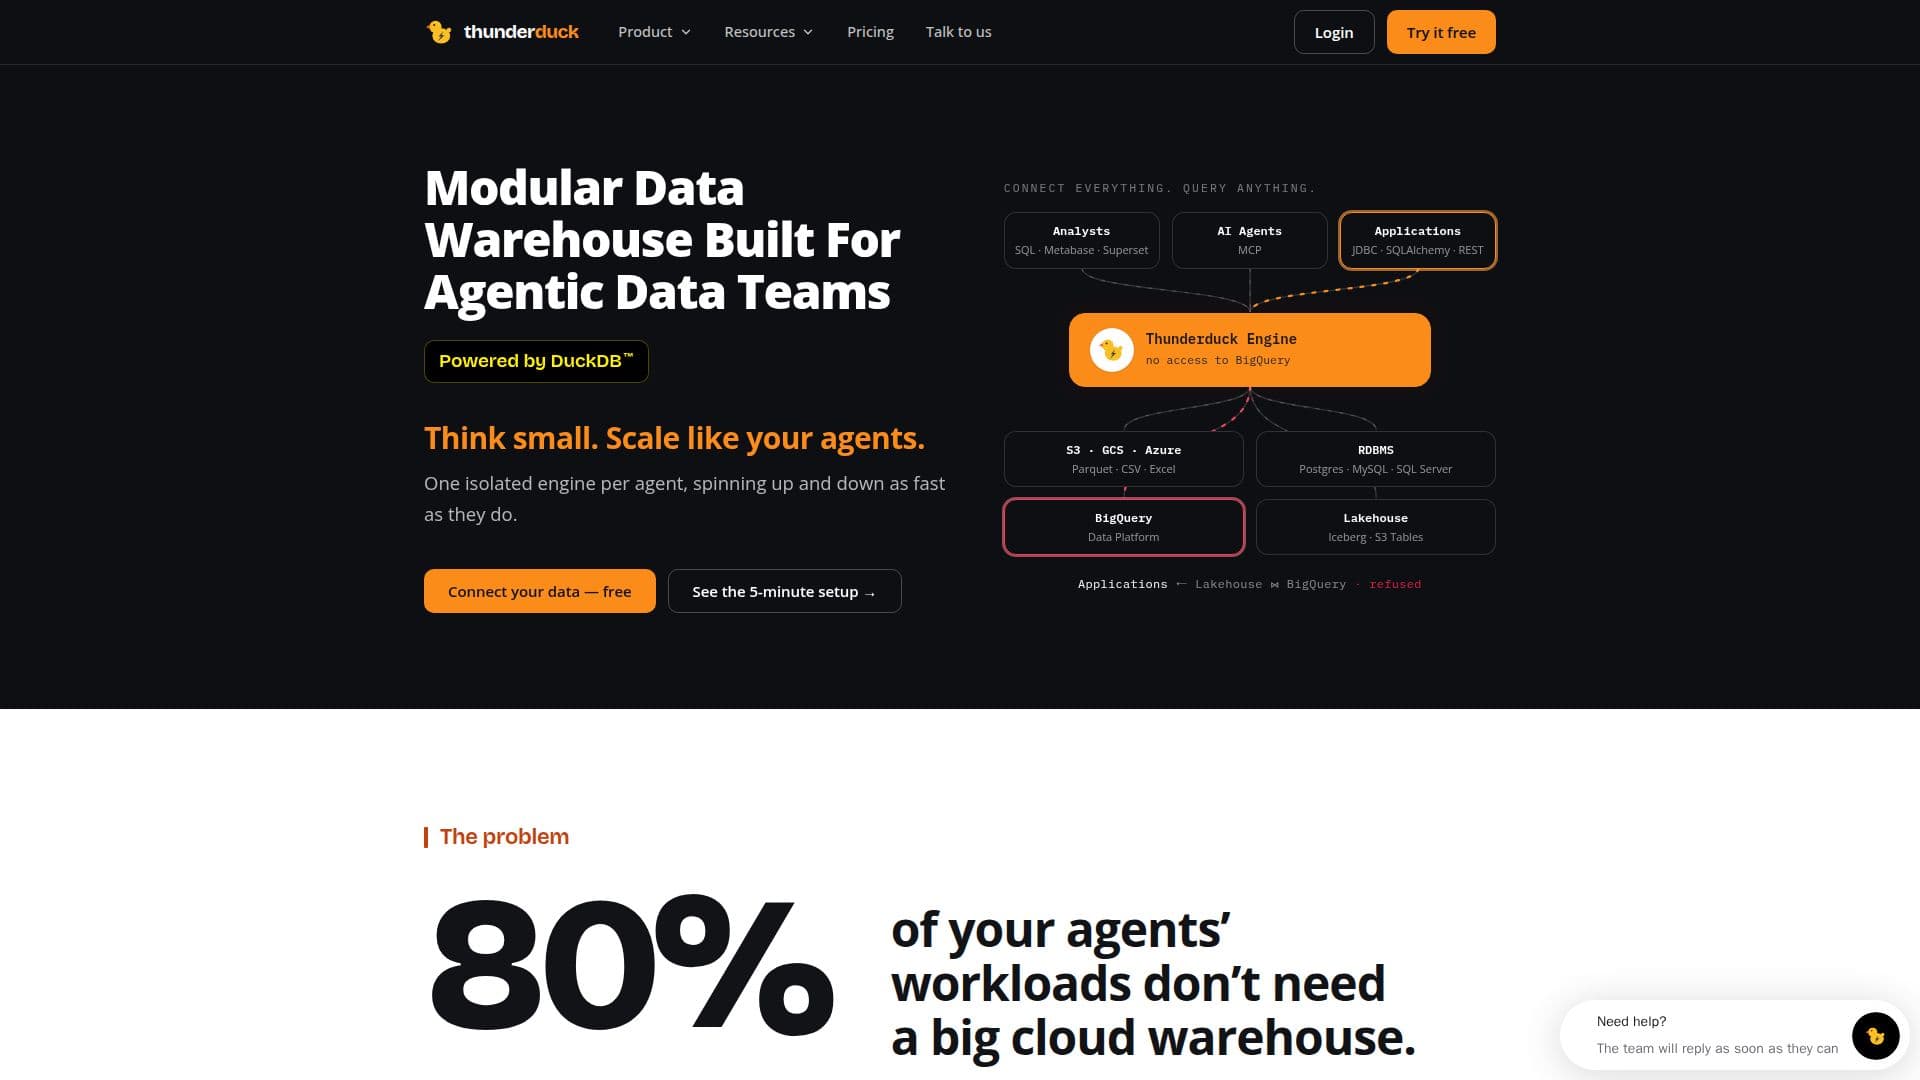
Thunderduck 提供了一种专为自主数据团队设计的模块化数据仓库解决方案,利用 DuckDB 的强大功能。它解决了一个常见问题,即 80% 的代理工作负载并不需要大型云仓库,但团队却承担了显著的分布式系统成本和托管服务费用。通过为每个代理提供一个独立的引擎,Thunderduck 允许引擎快速启动和关闭,匹配自主工作负载的动态特性。
阅读更多
该平台旨在实现对数TB数据的亚秒级查询,无论运行的代理数量如何。它简化了数据管道的构建,并自动化 DevOps 任务,同时保持企业级治理。用户可以灵活地在任何地方部署 Thunderduck,无论是在本地以云般的灵活性,还是在他们现有的云基础设施中。
Thunderduck 的核心是 DuckDB,这是一种开源的、内嵌的分析数据库,具有向量化引擎。这种架构意味着它在您的代码运行的地方运行,消除了服务器管理的需要。它支持多租户,并提供企业级安全性,通过将数据保留在用户的云或数据中心内,确保数据主权。
Thunderduck 通过 MCP 方便地与 AI 代理(如 Claude、ChatGPT 或 Cursor)集成。代理可以解释表和列的含义,而不仅仅是名称,以找到正确的表,读取分区和索引,并编写高效的查询。这些查询在预定义的角色和成本限制下运行。该平台还可以自动化 dbt 模型构建,遵循奖章层,测试分支,并打开拉取请求,以维护干净和可管理的数据集市。
它支持零 ETL 的查询联合,允许用户在单个查询中从各种来源(如 Postgres、BigQuery、Iceberg 表和文件)连接数据,并将过滤器下推到每个来源。这消除了对数据副本、加载作业或小型和临时数据的同步监控的需求。当数据集增长或需要建模时,用户可以将 dbt 管道构建到 Iceberg 中,并继续一致地查询它们。Thunderduck 还在每个查询运行之前提供成本估算,帮助控制预算,防止意外支出。
- 类别AI SQL 与数据库工具
- 定价模式免费增值
- 部署云端、本地部署
- 平台网页版
Thunderduck的核心功能
模块化数据仓库架构
每个代理一个独立的 DuckDB 引擎
对数TB数据的亚秒级查询
本地或云中部署选项
自动化 DevOps 任务
企业级治理
多租户支持
无分布式开销的低延迟
数据主权和访问规则
通过 MCP 与 AI 代理(Claude、ChatGPT、Cursor)集成
AI 辅助的查询生成和 dbt 模型构建
跨多种来源(PostgreSQL、BigQuery、Iceberg、S3)的查询联合
自动模式、表、列和类型发现
每个查询执行前的成本和运行时间估算
AI 驱动的失败查询诊断和建议修复
基于角色的目录访问控制
查询缓存以实现即时、免费的重复查询
如何使用 Thunderduck?
连接目录:提供数据库、仓库、湖仓或对象存储等数据源的凭据。
发现数据:Thunderduck 自动读取模式、表、列,并推断列的含义,保持其最新。
查询和连接:将任何表作为 catalog.schema.table 进行引用,并在单个 SQL 语句中跨多个来源进行连接。
集成 AI 代理:连接 Claude、ChatGPT 或其他 MCP 客户端,使 AI 代理能够浏览目录并运行 SQL。
自动化工作流:在 cron 时间表上调度 SQL 语句或连接 dbt 存储库以运行构建、测试和快照。
监控和治理:利用预查询成本估算、审计日志和基于角色的访问控制来管理使用情况和安全性。
Thunderduck的使用案例
- 自主数据工作负载
- 数据团队的成本优化
- 实时数据分析
- 数据管道自动化
- 数据主权和安全性
- AI 辅助查询
- 跨源数据连接
- 主动成本管理
- 数据治理和审计
- 湖仓构建