描述
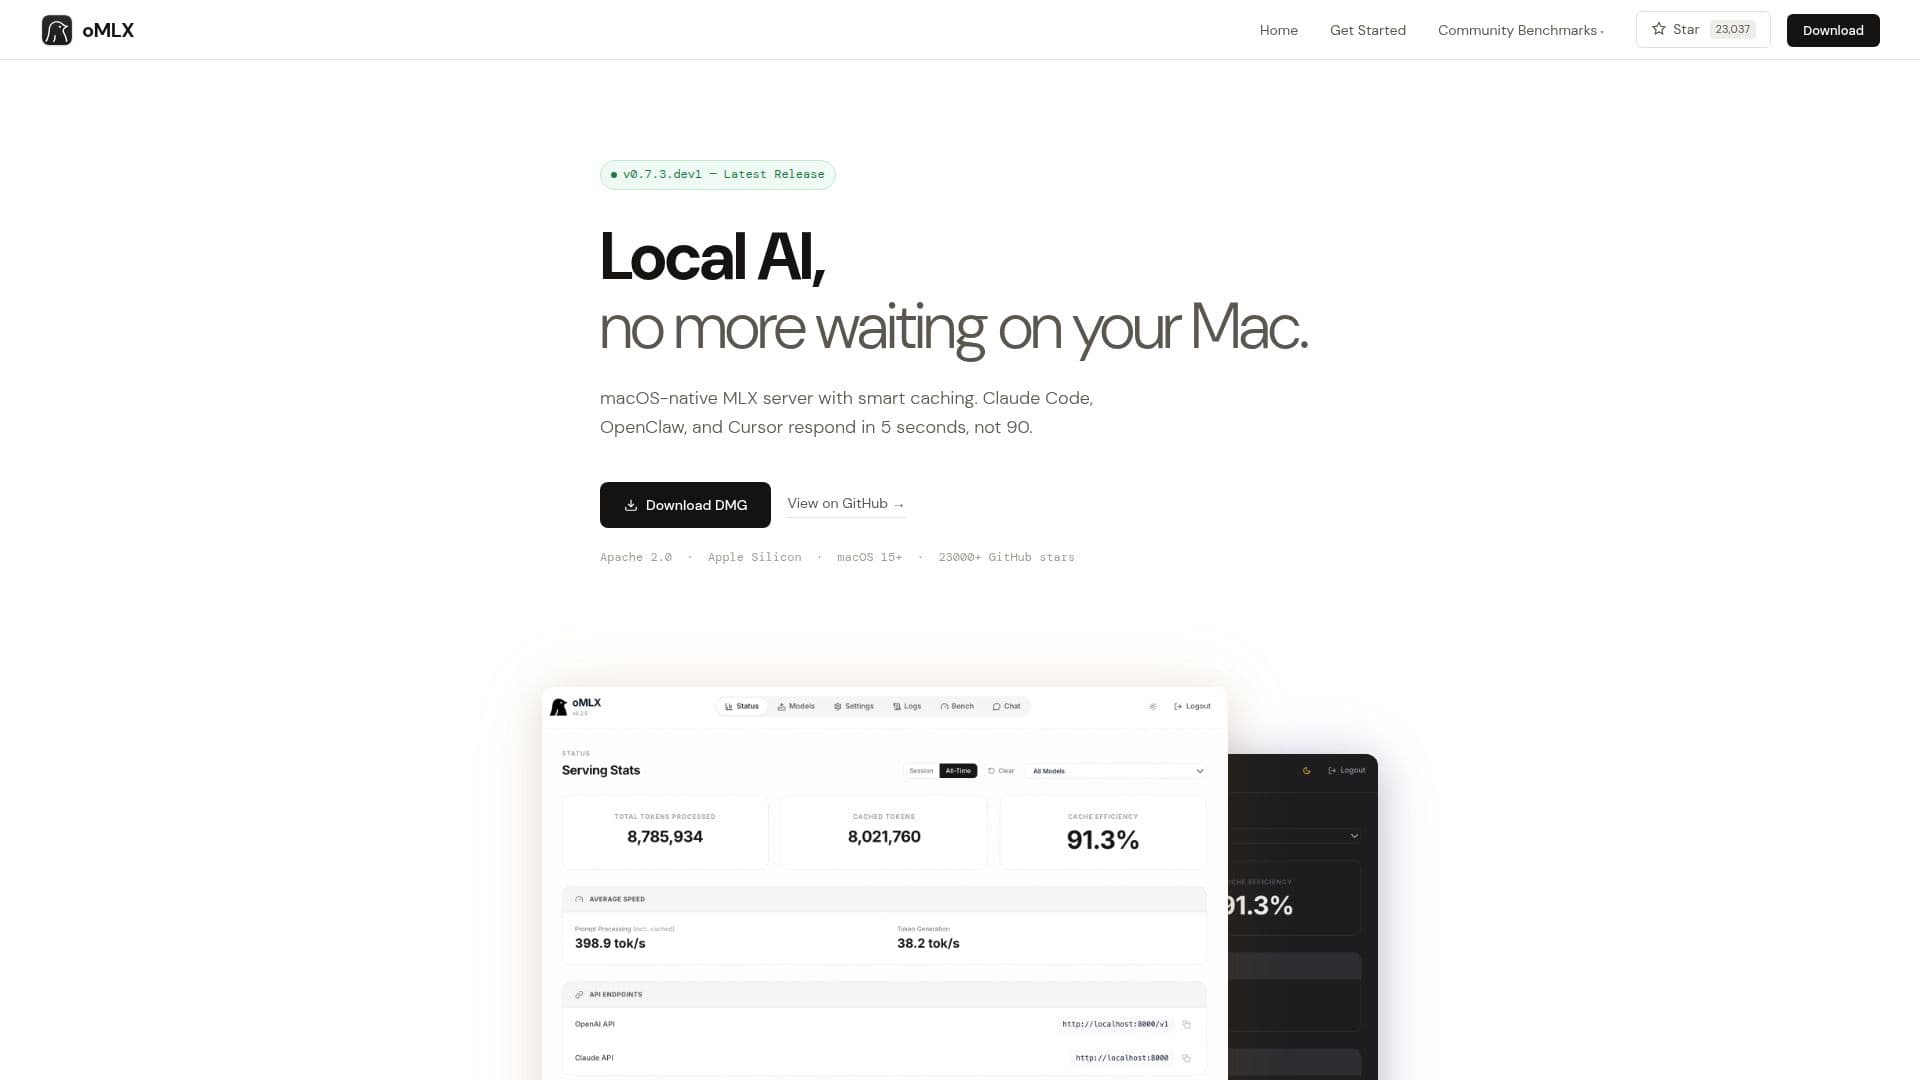
oMLX 是一个专为 macOS 设计的前沿推理服务器,充分利用了 Apple Silicon 的强大性能。基于 MLX 框架构建,它为在 Mac 计算机上本地运行大型语言模型 (LLMs) 提供了原生解决方案。其突出特点之一是分页 SSD KV 缓存,能够将首次令牌时间 (TTFT) 从典型的 30-90 秒大幅减少到 5 秒以内。这一改进对于频繁失效缓存的编码代理尤其有利,因为 oMLX 确保每个缓存块都持久化到 SSD,从而实现快速从磁盘恢复。
阅读更多
该服务器与 OpenAI 和 Anthropic 等流行 API 兼容,使其成为开发者在这些平台上工作的多功能工具。它支持连续批处理,并为 Claude Code、OpenClaw 和 Cursor 等模型提供即插即用的 API,确保响应在几秒钟内交付。在配备 512GB RAM 的 M3 Ultra 上进行的性能基准测试显示,在各种上下文和批量大小下,具有令人印象深刻的吞吐量和内存效率。
oMLX 旨在为需要在 Mac 上获得可靠且快速的本地 AI 解决方案的开发者和 AI 爱好者提供服务。它消除了对基于云的推理的需求,减少了延迟和对外部服务器的依赖。该工具在 Apache 2.0 许可证下开源,拥有强大的社区支持,证明其在 GitHub 上获得了 23,000 多个星标。用户可以通过下载 DMG 或从源代码安装轻松入门,兼容标准的 Hugging Face 缓存和 LM Studio 文件夹。
总体而言,oMLX 为在 macOS 上本地运行 AI 模型提供了强大而高效的解决方案,显著提高了速度,并与现有的 AI 工作流程无缝集成。
- 类别MLOps 与模型部署
- 定价模式开源
- 部署本地
- 平台macOS 15+
oMLX的核心功能
原生 macOS 推理服务器
分页 SSD KV 缓存
兼容 OpenAI 和 Anthropic API
支持连续批处理
Claude Code、OpenClaw 和 Cursor 的即插即用 API
快速从 SSD 恢复缓存
在 Apache 2.0 下开源
23,000+ GitHub 星标
如何使用 oMLX?
下载:获取 DMG 或源代码
安装:按照安装说明进行操作
配置:与 Hugging Face 缓存一起设置
使用:以减少的 TTFT 运行模型
优化:利用连续批处理
oMLX的使用案例
- 本地 AI 开发
- API 集成
- 编码代理
- 批处理
- 开源贡献