

跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

vLLM

AI 应用MLOps 与模型部署开源 · NVIDIA,AMD,Google TPU

vLLM 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它使得 AI 模型的快速部署成为可能,提供先进的性能,使得 LLM 服务对各行业的用户而言变得简单、快速且具有成本效益。

访问URL
分享
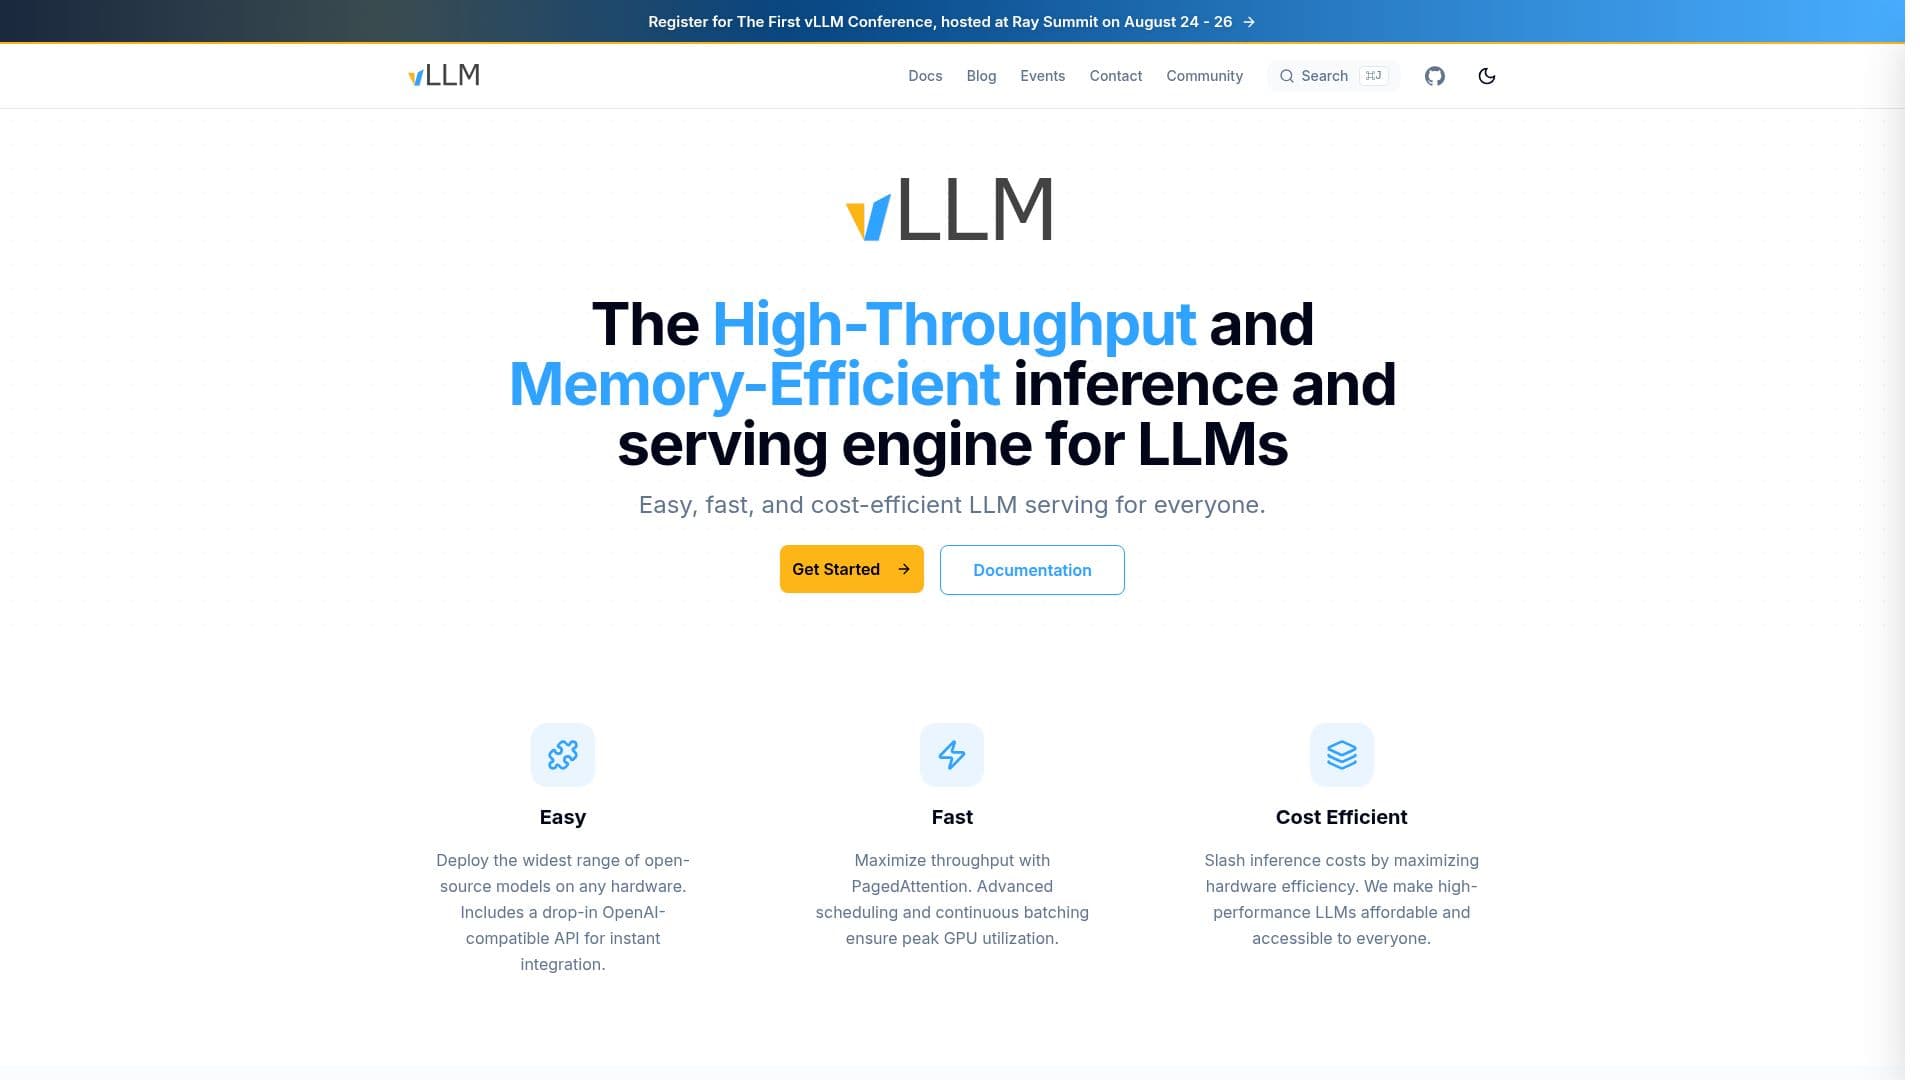
vLLM 截图
vLLM 截图

vLLM 旨在优化大型语言模型(LLMs)的推理和服务,重点关注高吞吐量和内存效率。该引擎利用先进的技术,如针对各种精度的优化 GEMM/MoE 内核,使用 CUTLASS 和 TRTLLM-GEN 等框架。vLLM 的目标是提供无缝的 AI 模型部署体验,确保用户能够在没有通常与 LLM 服务相关的复杂性的情况下实现先进的性能。

阅读更多

该平台具有通用兼容性,能够与各种硬件配置集成,包括对 NVIDIA GPU、AMD GPU 和 Google TPU 的支持。这种灵活性使得 vLLM 成为开发者和组织在不同环境中实施 AI 解决方案的理想选择。用户可以通过简单的配置过程快速开始使用 vLLM,设置工作量最小。

vLLM 还提供了一个社区驱动的方法,用户可以在论坛上讨论从硬件支持到模型集成等主题。这种协作环境促进了知识共享,帮助用户优化对平台的使用。此外,vLLM 支持多种模型,包括流行的架构,如 Llama、BART 和 GPT 等。

总之,vLLM 是一个强大的工具,适合任何希望高效部署 LLM 的人。其性能、易用性和社区支持的结合,使其在快速发展的 AI 领域中成为一个有价值的资源。

  • 类别MLOps 与模型部署
  • 定价模式开源
  • 部署云端
  • 平台NVIDIA,AMD,Google TPU

  • 高吞吐量

  • 内存高效

  • 通用兼容性

  • 优化的 GEMM/MoE 内核

  • 支持多种硬件

  • 社区论坛

  • 快速启动配置

  • 广泛的模型支持

  1. 配置:设置您的硬件环境以支持 vLLM。

  2. 安装:按照文档中提供的安装说明进行操作。

  3. 部署:将您所需的 AI 模型加载到 vLLM 引擎中。

  4. 优化:根据您的具体用例调整配置以提高性能。

  • AI 模型部署
  • 性能优化
  • 社区参与
  • 自定义模型集成
  • 跨平台兼容性

vLLM 旗下产品

隶属于 vLLM。

vLLM 评价

加载中...

与 vLLM 类似的热门AI工具

vLLM

AI GitHub 仓库

vllm-project/vllm 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它在优化性能的同时最小化资源使用,使其适用于人工智能和机器学习的各种应用。

MLOps 与模型部署

AI GitHub 仓库 排名第 23 位

查看工具

AI GitHub 仓库

高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它在优化性能的同时最小化资源使用,使其适用于人工智能和机器学习的各种应用。vllm-project/vllm 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它在优化性能的同时最小化资源使用,使其适用于人工智能和机器学习的各种应用。

精选MLOps 与模型部署
AI GitHub 仓库 排名第 23 位

Runware

AI 应用

Runware 是一个生成性 AI 推理平台,提供统一的 API 用于图像、视频、音频、3D、LLM 和视觉模型。它提供超过 40 万个模型,管理基础设施,并基于使用量定价,构建在自定义推理引擎之上。

MLOps 与模型部署
查看工具

AI 应用

生成性 AI 推理平台,提供统一的 API 用于图像、视频、音频、3D、LLM 和视觉模型。它提供超过 40 万个模型,管理基础设施,并基于使用量定价,构建在自定义推理引擎之上。Runware 是一个生成性 AI 推理平台,提供统一的 API 用于图像、视频、音频、3D、LLM 和视觉模型。它提供超过 40 万个模型,管理基础设施,并基于使用量定价,构建在自定义推理引擎之上。

MLOps 与模型部署
查看 AI 应用 Top 250

通用计算

AI 应用

一个高速AI推理提供商,通过专门构建的ASIC基础设施提供模型,采用与OpenAI兼容的API,针对编码代理和实时语音等对延迟敏感的工作负载,提供低的首次令牌时间和高吞吐量。

MLOps 与模型部署
查看工具

AI 应用

一个高速AI推理提供商,通过专门构建的ASIC基础设施提供模型,采用与OpenAI兼容的API,针对编码代理和实时语音等对延迟敏感的工作负载,提供低的首次令牌时间和高吞吐量。

MLOps 与模型部署
查看 AI 应用 Top 250

SiliconFlow

AI 平台

一个为开发者提供的AI基础设施平台,通过一个与OpenAI兼容的API,以按需付费的方式部署、微调和运行200多个优化的LLM和多模态模型。

MLOps 与模型部署
查看工具

AI 平台

一个为开发者提供的AI基础设施平台,通过一个与OpenAI兼容的API,以按需付费的方式部署、微调和运行200多个优化的LLM和多模态模型。

精选MLOps 与模型部署
查看 AI 平台 Top 150

ZETIC Melange

AI 应用

ZETIC Melange 自动化任何模型在任何设备上的设备端 AI 部署。由前高通工程师打造,它可优化 NPU 加速,在 200 多种设备上进行基准测试,并只需三行代码即可在数小时内完成部署,从而降低成本和延迟。

MLOps 与模型部署

MLOps 与模型部署 排名第 137 位

查看工具

AI 应用

自动化任何模型在任何设备上的设备端 AI 部署。由前高通工程师打造,它可优化 NPU 加速,在 200 多种设备上进行基准测试,并只需三行代码即可在数小时内完成部署,从而降低成本和延迟。ZETIC Melange 自动化任何模型在任何设备上的设备端 AI 部署。由前高通工程师打造,它可优化 NPU 加速,在 200 多种设备上进行基准测试,并只需三行代码即可在数小时内完成部署,从而降低成本和延迟。

MLOps 与模型部署
MLOps 与模型部署 排名第 137 位

BigDL LLM

AI 框架

BigDL-LLM 是一个开源库,用于在 Intel XPU 硬件上运行大型语言模型 (LLM),涵盖从笔记本电脑到云端 GPU 的各种设备。它支持 INT4/FP4/INT8/FP8 量化以实现低延迟推理,并为 PyTorch 模型提供全面的微调功能。

MLOps 与模型部署
查看工具

AI 框架

BigDL-LLM 是一个开源库,用于在 Intel XPU 硬件上运行大型语言模型 (LLM),涵盖从笔记本电脑到云端 GPU 的各种设备。它支持 INT4/FP4/INT8/FP8 量化以实现低延迟推理,并为 PyTorch 模型提供全面的微调功能。

MLOps 与模型部署
查看 AI 框架 Top 50

deAPI

AI 应用

deAPI 是一个统一的 API,适用于开源生成 AI 模型,涵盖图像生成、文本转语音、转录等功能。请求通过去中心化的 GPU 云运行,提供低成本的推理,无需管理硬件。

MLOps 与模型部署
查看工具

AI 应用

统一的 API,适用于开源生成 AI 模型,涵盖图像生成、文本转语音、转录等功能。请求通过去中心化的 GPU 云运行,提供低成本的推理,无需管理硬件。deAPI 是一个统一的 API,适用于开源生成 AI 模型,涵盖图像生成、文本转语音、转录等功能。请求通过去中心化的 GPU 云运行,提供低成本的推理,无需管理硬件。

MLOps 与模型部署
查看 AI 应用 Top 250

Bento

AI 平台

Bento 是一个为速度和控制而设计的推理平台,使您能够将任何 AI 模型部署到任何地方。它提供定制优化、高效扩展和简化的操作,以满足 AI 团队的需求。在保持对部署的完全控制的同时,简化推理基础设施。

MLOps 与模型部署
查看工具

AI 平台

为速度和控制而设计的推理平台,使您能够将任何 AI 模型部署到任何地方。它提供定制优化、高效扩展和简化的操作,以满足 AI 团队的需求。在保持对部署的完全控制的同时,简化推理基础设施。Bento 是一个为速度和控制而设计的推理平台,使您能够将任何 AI 模型部署到任何地方。它提供定制优化、高效扩展和简化的操作,以满足 AI 团队的需求。在保持对部署的完全控制的同时,简化推理基础设施。

精选MLOps 与模型部署
查看 AI 平台 Top 150
1/8




