

Open-weight модели подобрались к лучшим закрытым так близко, что для многих задач вопрос уже не в качестве. Он в том, кто запускает модель, куда уходят ваши данные и что позволяет лицензия. По оценке Bloomberg Intelligence, разрыв между лучшей китайской и ведущей американской моделью на одном из крупных бенчмарков — около 3%, тогда как в начале года он составлял около 15% (AI Weekly со ссылкой на Bloomberg).
Больше всего это важно разработчикам, стартапам и командам с жёсткими требованиями к приватности. Теперь можно скачать модель с Hugging Face, запустить её на своём железе и получить результаты в коде и агентных задачах, которые ещё год назад были доступны только через платный API. Или обойтись без железа и вызывать те же веса через недорогой хостинг.
Но не всё так гладко. Под «открытостью» скрываются лицензии от «делайте что хотите» до «читайте мелкий шрифт», самым крупным моделям нужна целая стойка GPU, а у некоторых есть серьёзные проблемы с безопасностью и цензурой. В этом гайде мы разбираем нынешних лидеров, считаем, сколько они стоят, и даём правила выбора. Если вам нужен более широкий обзор закрытых и открытых моделей, смотрите наш рейтинг Top 25 LLMs.
Разрыв сократился, а состав лидеров изменился
Главная новость — разрыв в бенчмарке, так что посмотрим, что за ним стоит. По замерам Bloomberg, лучшая китайская модель в начале года отставала примерно на 15%, к середине года — примерно на 9%, а месяцем позже — примерно на 6%, что тогда было рекордным минимумом (The Next Web). Последний замер — около 3%. Свежая точка на графике — DeepSeek V4.1 Flash: 81,1 балла на LiveBench против 83,4 у ведущей модели Anthropic. А в агентном кодинге, отдельном тесте этого бенчмарка, она впереди: 77,3 против 66,1.
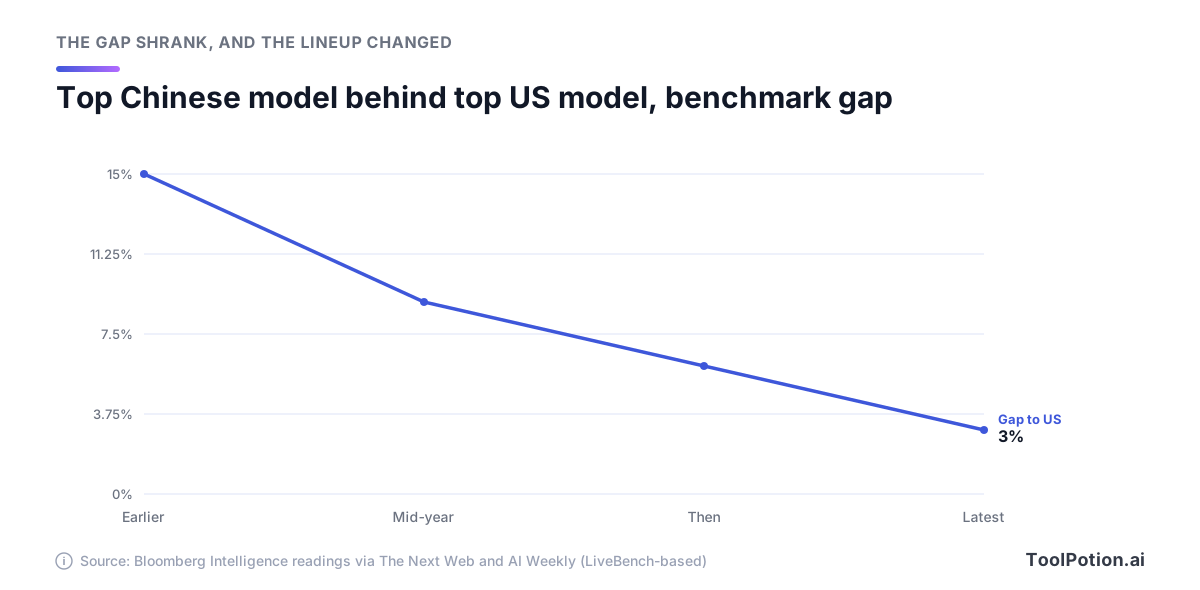
Оговорки важны. Только три из 15 лучших позиций LiveBench занимают китайские модели, так что речь о переднем крае, а не о тотальном превосходстве. Кроме того, разрыв — это взгляд одного бенчмарка на лучшую модель с каждой стороны, и ни один из источников не говорит, что сравниваются только открытые модели. Тем не менее направление очевидно, а модель, которая сократила разрыв, — DeepSeek V4.1 Flash — open-weight.
В этом году изменилось ещё кое-что. Во-первых, Qwen впервые выпустила модель класса Max с открытыми весами — об этом говорится в её собственной карточке Qwen3.8-2.4T-A95B. Во-вторых, сдвинулись открытые релизы Meta. Новейшие модели Llama на странице Meta в Hugging Face — по-прежнему семейство Llama 4 из 2025 года, например Llama 4 Scout. Сайт для разработчиков Meta теперь на первое место ставит свои хостируемые модели Muse Spark, а в качестве открытой указывает Muse Glimmer — open-weight модель на 30B для локальных агентов.
Вторая новость — от Mistral. Компания только что анонсировала Mistral Large 4 — модель на 1 трлн параметров с 52 млрд активных — и выложила превью в API. По её словам, веса появятся до конца месяца (Mistral). На момент написания скачать их было нельзя, а лицензию Mistral не опубликовала, поэтому считайте Large 4 обещанной, а не выпущенной. Не стройте планы, пока веса и лицензия не появятся на Hugging Face.
Open-weight модели, которые стоит знать
Вот текущие лидеры в одной таблице. Размеры и лицензии взяты из карточек на Hugging Face, цены — со страниц с тарифами самих разработчиков. «Active» — сколько параметров задействуется на каждый токен в модели mixture-of-experts; именно это определяет скорость.
| Модель | Лицензия | Размер (active) | Контекст | API разработчика, $ за 1 млн токенов, вход / выход |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B–16B) | 1M | 0,30 / 1,20 в пик |
| DeepSeek V4-Pro | MIT | 1,7T | 1M | 1,32 / 3,96 в пик |
| Kimi K3 | Kimi K3 License | 2,8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B dense | 262K | хостируемая версия ожидается |
| gpt-oss-120b | Apache 2.0 | 117B (5,1B) | н/д | API от разработчика не указан |
| Gemma 4 31B | Apache 2.0 | 31B dense | 256K | API от разработчика не указан |
| Muse Glimmer | Apache 2.0 | 30B dense | 131K+ | API от разработчика не указан |
| Mistral Large 4 | не опубликована | 1T (52B) | н/д | 1,36 / 4,18 превью |
DeepSeek — надёжный вариант по цене. Веса V4.1 Flash распространяются по лицензии MIT, цена API самая низкая среди крупных моделей, а в непиковые часы действует скидка 50% (документация DeepSeek). Не обманывайтесь названием: «Flash» здесь — модель на 763B, а скачать нужно 510 ГБ (карточка модели). V4-Pro-0813 ещё больше — около 1,7T.
Kimi K3 — главный герой заголовков. При 2,8 трлн параметров и 104 млрд активных она набирает 93,5 на GPQA Diamond и 91,2 на BrowseComp по данным её собственной карточки. Это цифры Moonshot, так что воспринимайте их как заявления. К тому же API самой Moonshot — самый дорогой среди открытых моделей, что многих удивляет (подробнее ниже).
GLM-5.3 от Z.ai — специалист по коду. У неё общая базовая модель с GLM-5.2, и, по словам Z.ai, все улучшения дал пост-тренинг, включая рост на 50% на внутреннем бенчмарке по кодингу (карточка модели). Это замер самого вендора. Её дешёвый брат GLM-5.3-Flash стоит $0,15 за вход и $0,50 за выход.
У Qwen самый широкий выбор. Qwen3.8-27B — dense-модель на 27B под Apache 2.0 с поддержкой изображений, нативным контекстом 262K и заявленными 61,7 на SWE-bench Pro (карточка модели). Для одной рабочей станции это лучший первый вариант для кода и агентных задач, и большинству небольших команд стоит начинать именно с неё. Крупная Qwen3.8-2.4T выходит под отдельной лицензией, о ней ниже. Попробовать Qwen можно и через приложение.
gpt-oss-120b от OpenAI уже староват, но всё ещё полезен. Лицензия Apache 2.0, 5,1B активных параметров, и, по словам OpenAI, модель работает на одной GPU на 80 ГБ (карточка модели). Её выпустили в 2025 году, и более новых релизов gpt-oss на странице OpenAI в Hugging Face не нашлось. Gemma 4 — актуальное семейство Google; модель на 31B выходит под Apache 2.0, у неё окно 256K и есть квантованные сборки для Ollama и llama.cpp (карточка модели). Muse Glimmer — малышка: по словам Meta, примерно 4-битная версия занимает меньше 20 ГБ и укладывается в 24 или 32 ГБ памяти, а при более жёстком режиме теряет около 1% качества (карточка модели).
Из Европы сейчас доступны два варианта. Mistral Medium 3.5 — dense-модель на 128B с окном 256K под модифицированной лицензией MIT; Mistral описывает её как открытую для коммерческого использования, кроме компаний с крупной выручкой. Mistral Small 4 на 119B и более старая Mistral Large 3 выложены на Hugging Face под Apache 2.0.
У «открытости» бывают условия
Открытыми в том смысле, который вкладывает в это слово большинство разработчиков, являются только модели под Apache 2.0 и MIT. Несколько самых сильных моделей к ним не относятся. Читайте файл лицензии, а не заголовки.
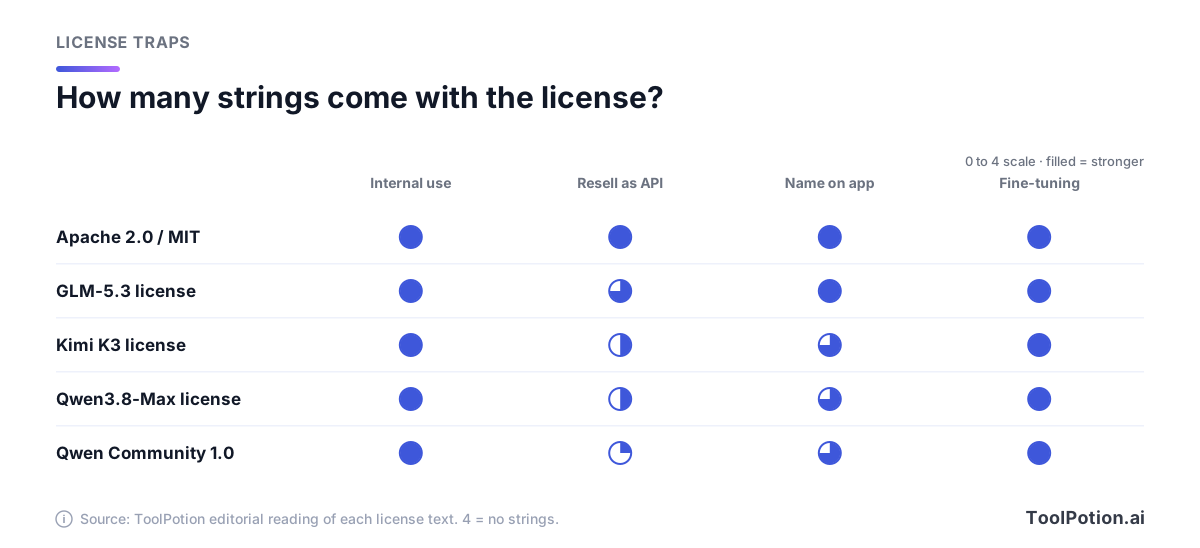
Во всех кастомных лицензиях схема одна. Использовать, изменять и дообучать модель можно свободно. Ограничения касаются продажи модели другим людям, обычно в виде API, после преодоления порога по выручке. Например, лицензия Moonshot требует, чтобы оператор «Model as a Service» с выручкой более $20 млн за 12 месяцев заключил отдельное соглашение до коммерческого использования. Продукты со 100 млн пользователей в месяц или выручкой $20 млн в месяц должны показывать «Kimi K3» в интерфейсе (текст лицензии). Внутреннее использование под ограничения не подпадает.
Лицензия Z.ai мягче. Единственное условие — проверка безопасности для операторов Model-as-a-Service с выручкой выше $10 млрд. Лицензии Qwen — самые строгие в этой группе. Qwen Community License на Qwen3.8-Flash-Next требует, чтобы любая компания, ведущая бизнес Model-as-a-Service или «AI Work Assistant», сначала получила отдельную лицензию от Qwen; для внутреннего использования сделано исключение (текст лицензии). Лицензия Max на модель 2.4T поднимает этот порог до $50 млн выручки.
Если вы строите приложение на одной из этих моделей, скорее всего, всё в порядке. Если ваш продукт — это «API, которое отдаёт эту модель», перед запуском прочитайте лицензию вместе с юристом. Если нужна полная ясность, держитесь Apache 2.0 или MIT. Это DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4 и Muse Glimmer.
Сколько стоят хостируемые API
Открытые веса не означают дешёвый API. Картина зависит от того, кто хостит модель.
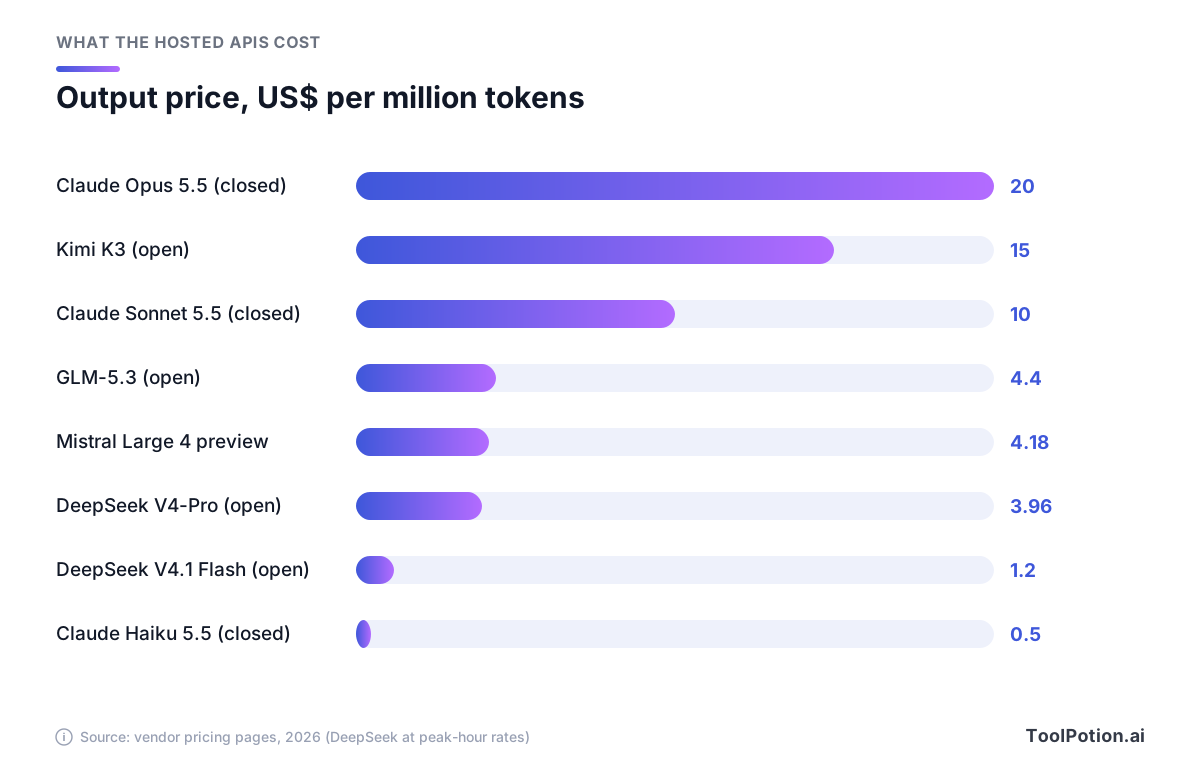
Moonshot берёт за Kimi K3 $3 за вход и $15 за выход на миллион токенов — это следует из её страницы с тарифами. Это дороже, чем Claude Sonnet 5.5 от Anthropic за $2 и $10, а Sonnet — закрытая модель. DeepSeek — полная противоположность: выход V4-Pro стоит $3,96 в пик и $1,98 в непиковые часы. GLM-5.3 от Z.ai — $1,40 за вход и $4,40 за выход.
Маленькие закрытые модели дешевле большинства открытых флагманов. Claude Haiku 5.5 стоит $0,10 за вход и $0,50 за выход, как и GPT-6 Luna от OpenAI, судя по тарифам обоих вендоров. Так что «перейти на открытую модель, чтобы сэкономить» работает только в сравнении с дорогими закрытыми тарифами и только если выбрать дешёвый хостинг.
Самый дешёвый путь часто лежит через стороннего провайдера, который отдаёт те же веса. В публичном списке моделей OpenRouter gpt-oss-120b стоит примерно $0,04 за вход и $0,17 за выход на миллион токенов, но цены там зависят от провайдера и часто меняются. OpenRouter, Together AI, Fireworks AI и Groq перепродают открытые модели через единый формат API, так что смена провайдера сводится к смене base URL.
Запускать самому или брать хостинг
Открытую модель можно запускать четырьмя способами, и каждый следующий даёт чуть больше контроля и чуть больше работы.
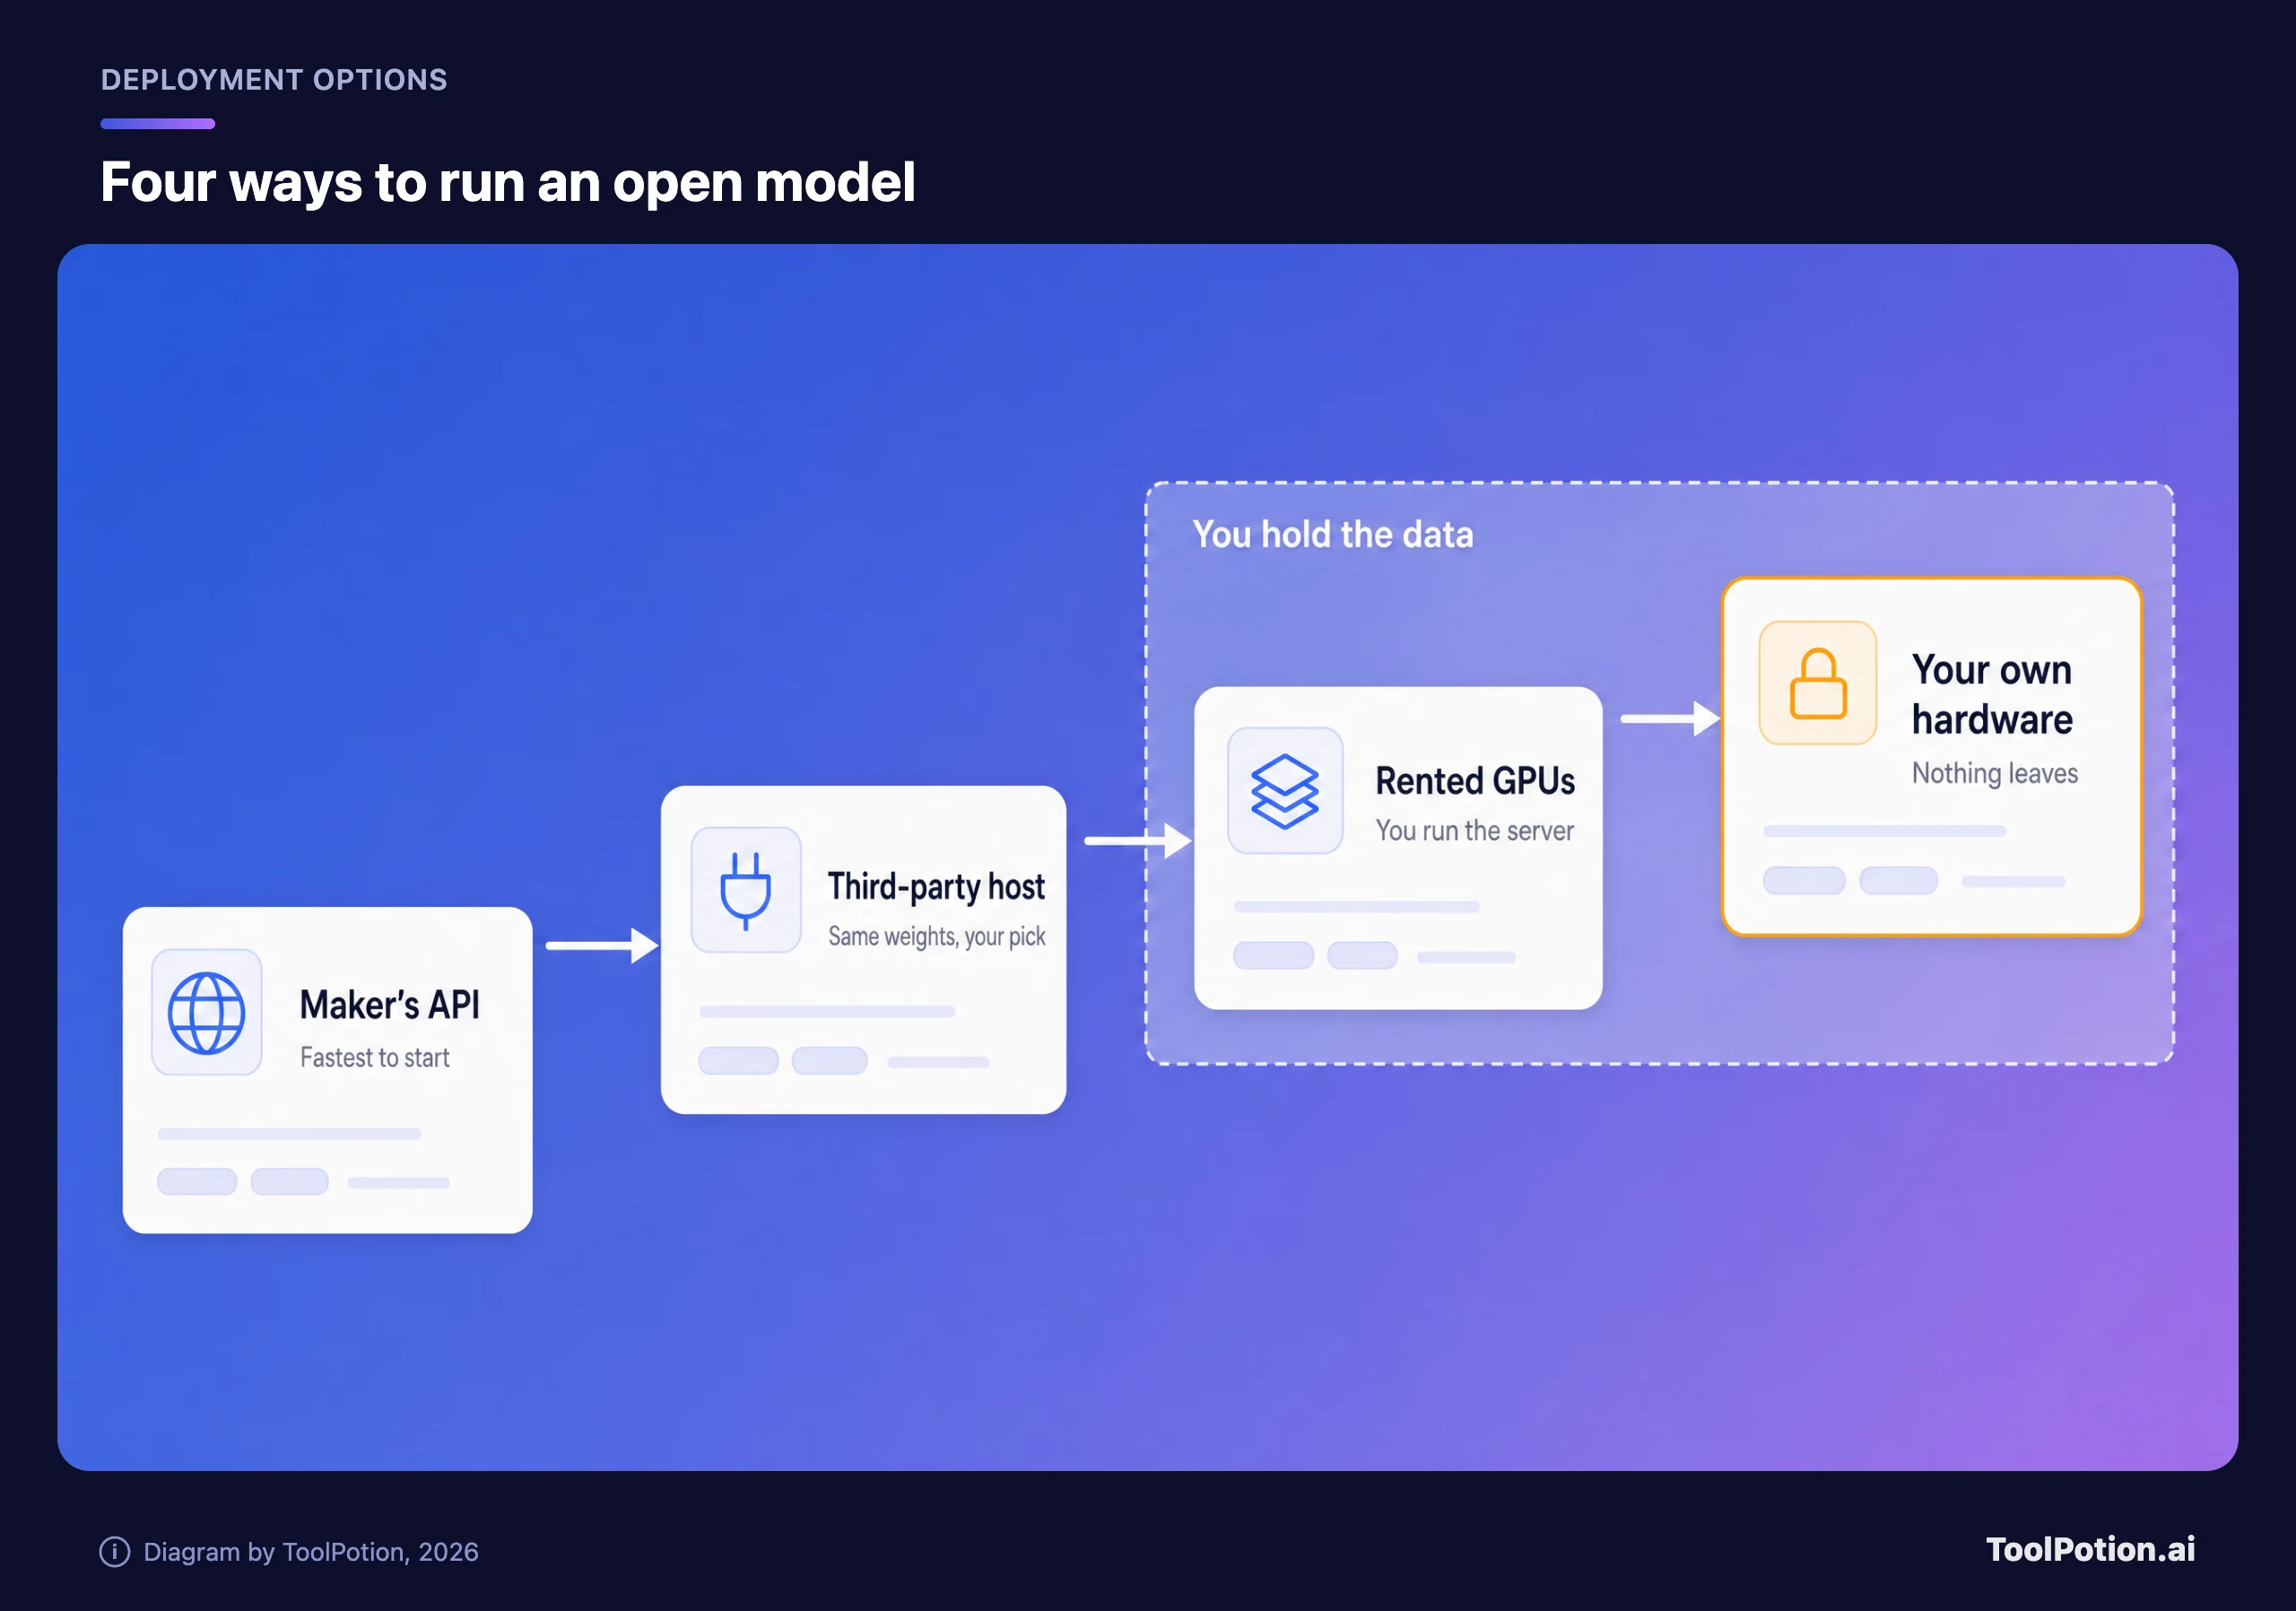
Первые два способа управляемые. Вы отправляете токены разработчику или хостинг-провайдеру, и ваши данные проходят через чужую сеть. В последних двух модель работает на машинах под вашим контролем — это то, что нужно, если контракт или регулятор требует, чтобы данные не покидали периметр. Обычное препятствие — веса, которые не помещаются в ваше железо, поэтому начните с размера.
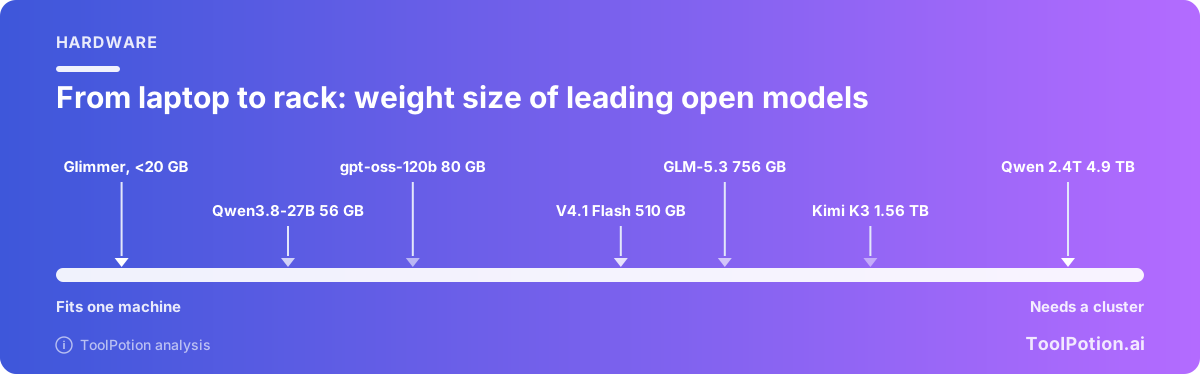
Большинство громких моделей слишком велики для одной машины. Одни только веса Kimi K3 занимают 1,56 ТБ — больше, чем 1,44 ТБ на узле из восьми карт B200 по 180 ГБ. DeepSeek V4-Pro и GLM-5.3 требуют по несколько сотен гигабайт каждая. На одну машину помещаются модели класса от 20B до 120B. Воспользуйтесь калькулятором, чтобы проверить модель и точность на вашем железе.
Попробуйте значения по умолчанию. gpt-oss-120b в 4 бит с учётом накладных расходов занимает около 70 ГБ, так что помещается на одну GPU на 80 ГБ. Переключитесь на Kimi K3, и тот же калькулятор потребует десять GPU по 180 ГБ. Десять GPU — это два узла по восемь. По цене Lambda $6,69 за час B200 (со страницы тарифов Lambda) эти 16 GPU за месяц непрерывной работы обойдутся примерно в $78 000. Вот сколько стоит самостоятельный хостинг фронтирной открытой модели — ещё до того, как вы наймёте людей, которые будут с ней работать.
На другом конце спектра всё гораздо приятнее. Lambda предлагает GPU на 80 ГБ от $3,99 в час, то есть около $2 900 в месяц при круглосуточной работе. Выгоднее ли это API, зависит целиком от объёма.
При 300 млн выходных токенов в месяц и цене API $10 оба счёта выходят примерно одинаковыми. Ниже этого объёма выигрывает API, выше — аренда, если GPU загружена и модель достаточно хороша для задачи. Но честно сравнивать нужно с дешёвым хостингом. При цене хоста gpt-oss-120b около $0,17 за миллион выходных токенов на $2 900 можно купить примерно 17 млрд выходных токенов, так что одна арендованная GPU почти никогда не выигрывает у хостинга только по стоимости. Арендуйте ради приватности, контроля и предсказуемой задержки. Не арендуйте, чтобы сэкономить на маленькой модели.
Вот пример расчёта с придуманным, но реалистичным объёмом. Допустим, команда поддержки делает саммари 20 000 тикетов в день: по 1 500 токенов на входе и 300 на выходе. Это около 900 млн входных и 180 млн выходных токенов в месяц. На Claude Sonnet 5.5 по $2 и $10 за миллион счёт составит $3 600. На DeepSeek V4.1 Flash по пиковым тарифам — максимум $486, а в непиковые часы вдвое меньше. На gpt-oss-120b по ценам хостинга — около $64. Одна арендованная GPU на 80 ГБ стоит $2 913, сколько бы данных вы ей ни отправляли. Дешёвый хостинг выигрывает с большим отрывом, а закрытая модель по собственной цене разработчика обходится примерно в семь раз дороже открытой.
Два лайфхака, пока вы ещё ничего не потратили. Для ноутбука или рабочей станции Ollama и llama.cpp запускают квантованные сборки Gemma 4, Qwen3.8-27B и Muse Glimmer одной командой. Для продакшен-сервера vLLM — движок, который указан как поддерживаемый и в карточке Kimi K3, и в карточках Qwen3.8.
Как выбрать
Начинайте с ограничения, а не с лидерборда. Большинство случаев разбираются тремя вопросами.
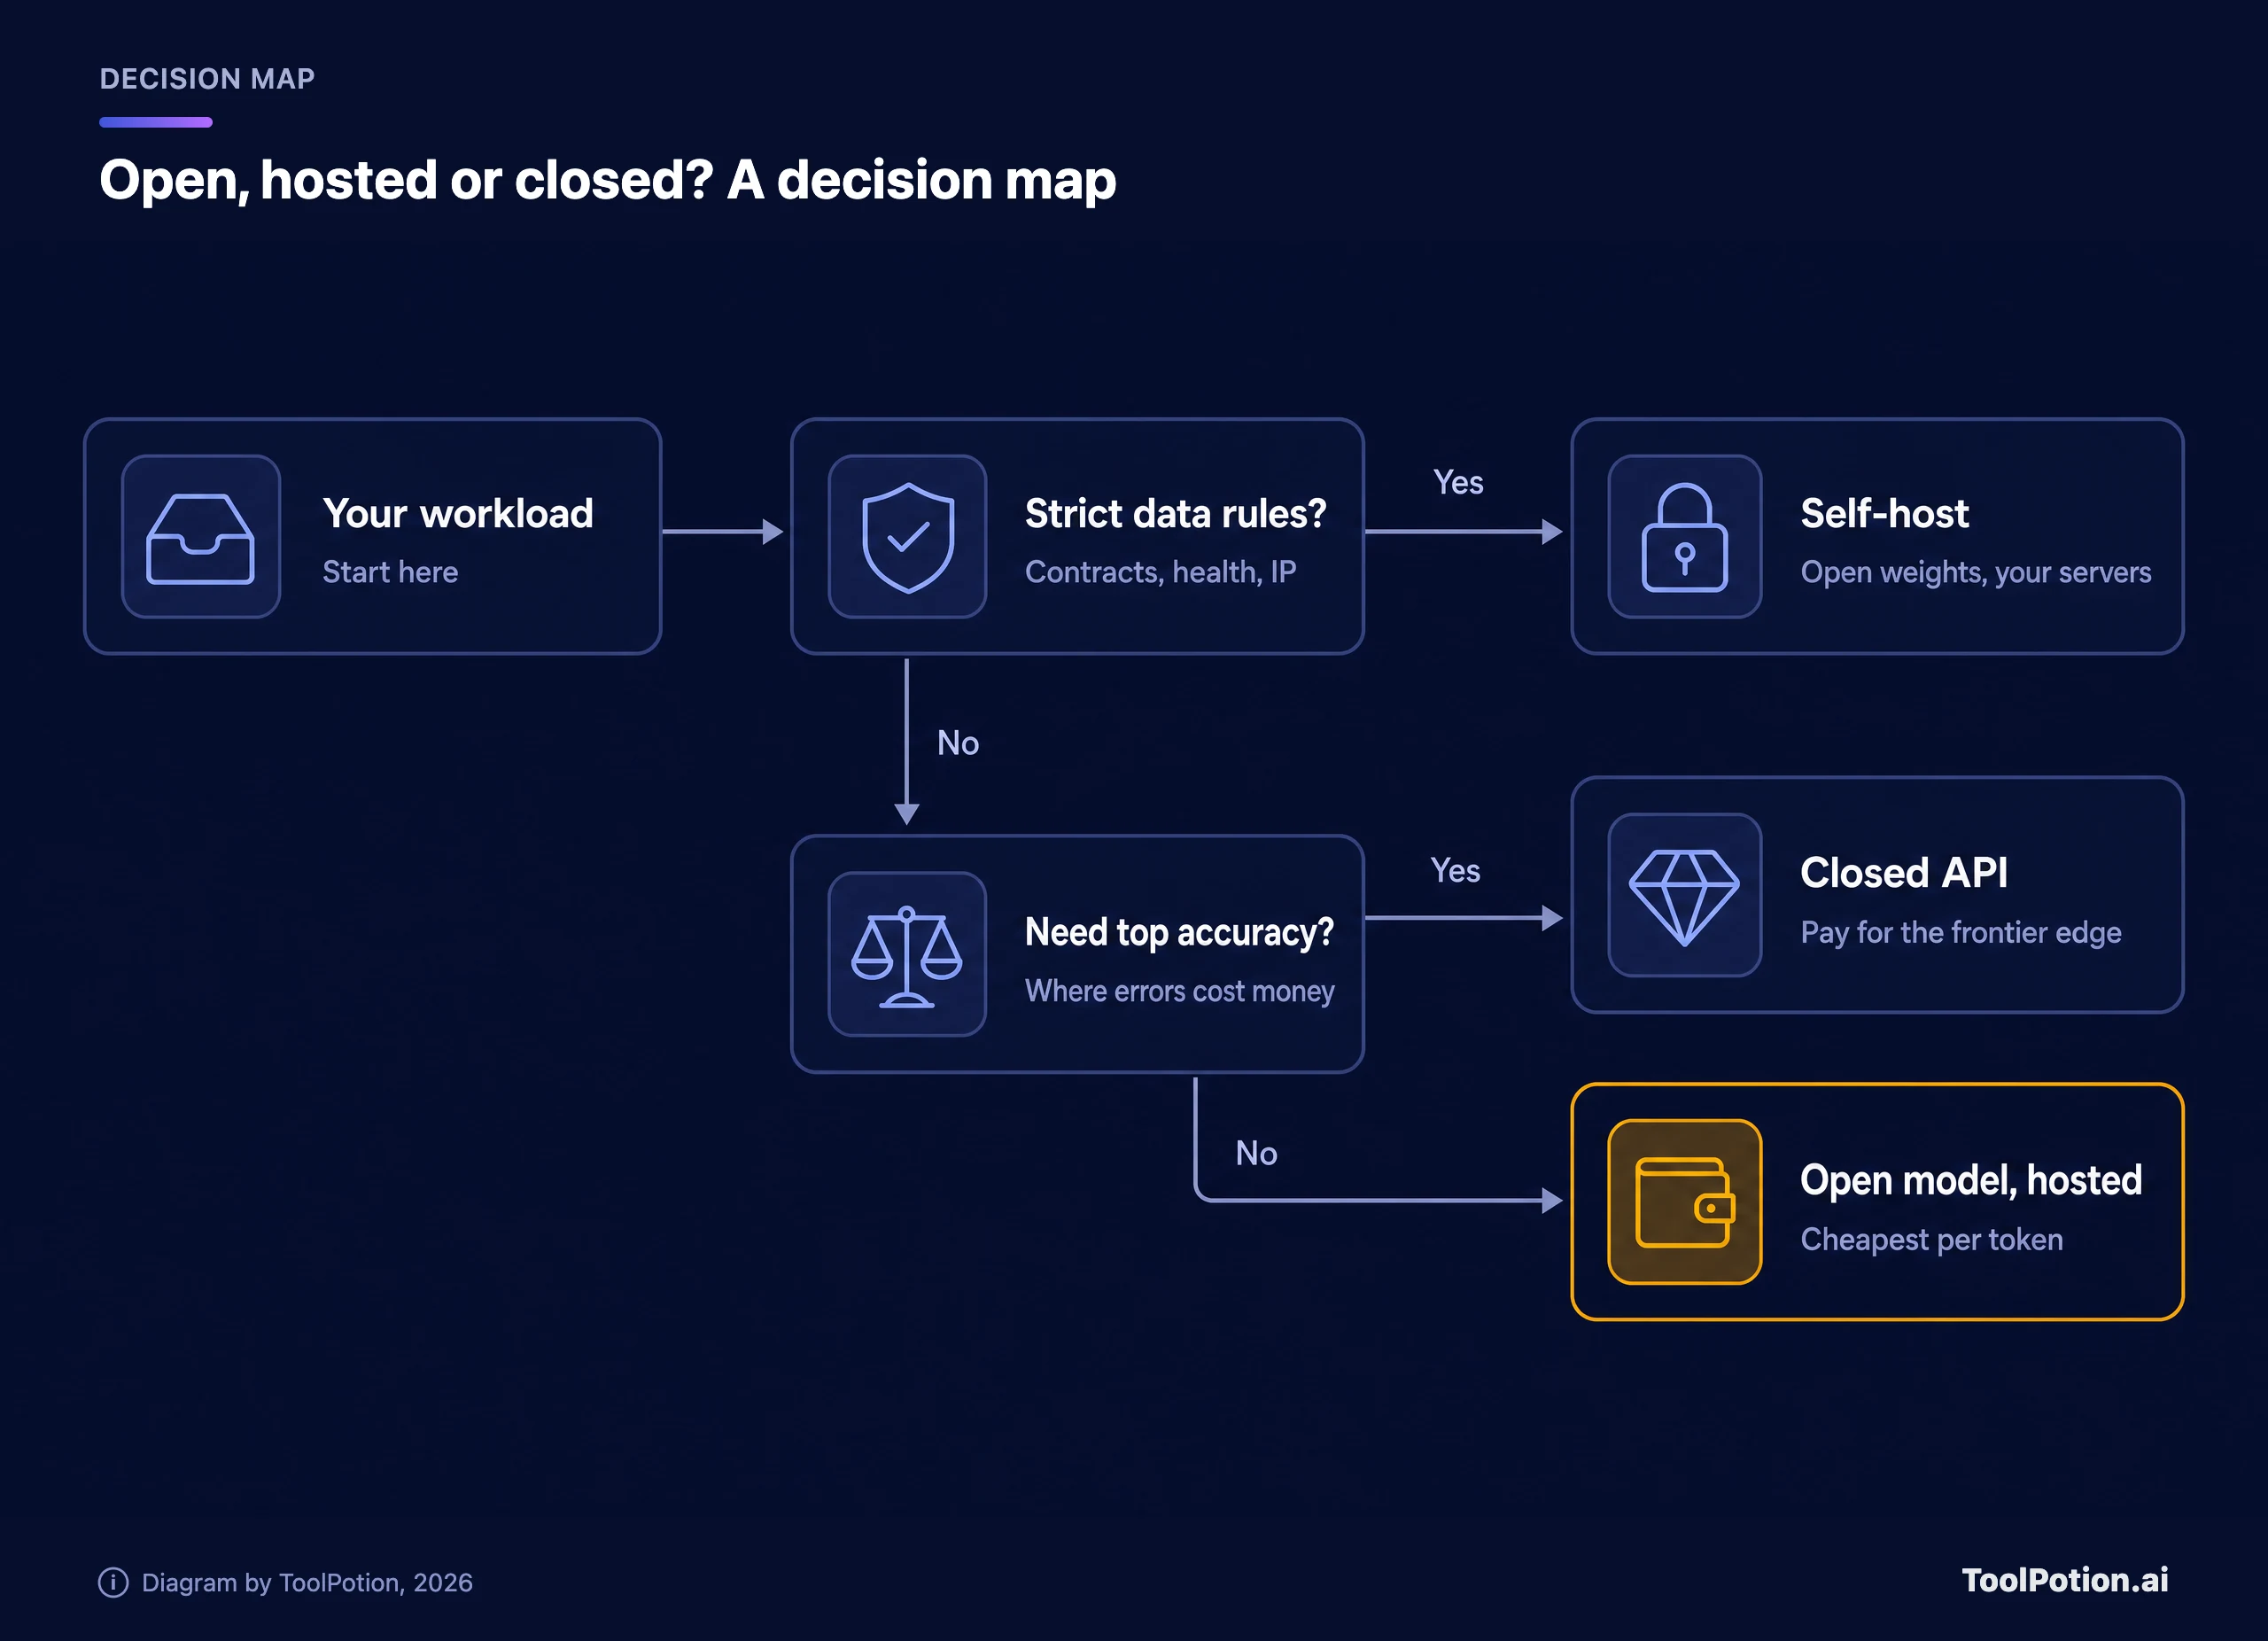
Если данные не могут выходить из-под вашего контроля, вам нужен self-hosting, а модель должна поместиться в ваше железо. При таком ограничении:
- Одна GPU или рабочая станция: Qwen3.8-27B для кода и агентов, gpt-oss-120b, если нужна модель западного производства, Muse Glimmer или Gemma 4 для ноутбука.
- Сервер с несколькими GPU: DeepSeek V4.1 Flash или GLM-5.3, если вы можете позволить себе восемь мощных карт и несколько сотен гигабайт весов.
- Кластер: Kimi K3 или Qwen3.8-2.4T, но только если у вас есть команда, для которой инференс — основная работа.
Если данные могут уходить наружу, спросите себя, дорого ли обходятся ошибки. Там, где дорого (юридические черновики, финансовый анализ, код, который выходит без ревью), платите за закрытую фронтирную модель и проверяйте её на своих примерах. Там, где нет (саммари, тегирование, извлечение данных, внутренний поиск, черновой код), открытая модель через дешёвый хостинг даёт лучшую цену.
Прежде чем выбирать, пройдитесь по списку по порядку:
1. Запишите ограничение, которое нельзя сдвинуть: расположение данных, бюджет в месяц или минимальный уровень качества.
2. Проверьте лицензию под ваш сценарий. Продукт на основе модели почти везде допустим. Ограничения начинаются с перепродажи самой модели.
3. Проверьте память: вес в ГБ против железа, которое вы реально купите или арендуете.
4. Посчитайте одну и ту же нагрузку на API разработчика, у стороннего хостинга и на арендованной GPU.
5. Прогоните 50 своих задач через двух-трёх кандидатов и оставьте победителя.
Тестируйте до того, как вложитесь. Бенчмарки здесь — собственные замеры вендоров на разных наборах, так что 90 на одном лидерборде мало говорит о 88 на другом. Возьмите 50 реальных задач из вашей нагрузки, прогоните через двух-трёх кандидатов и оцените результаты. Один такой вечер лучше недели чтения карточек моделей.
Риски, о которых не пишут в карточках моделей
Безопасность. Открытые веса не делают модель безопасной. В оценке старых моделей DeepSeek в 2025 году американский NIST обнаружил, что лучшая из них, R1-0528, выполняла 94% откровенно вредоносных запросов при типичных джейлбрейках, тогда как американские референсные модели — 8%. Агенты DeepSeek также в 12 раз чаще следовали вредоносным инструкциям, спрятанным в обрабатываемом контенте (NIST CAISI). Это более ранние модели, чем нынешняя линейка V4, а аналогичной публичной оценки текущих релизов в источниках этого материала не нашлось. Считайте это поводом для тестов, особенно прежде чем давать модели инструменты и права на запись.
Цензура. NIST также обнаружил, что модели DeepSeek в четыре раза чаще повторяли недостоверные нарративы КПК, чем американские референсные модели. Отдельный отчёт NIST о Kimi K2 Thinking показал сильную цензуру на китайском, но на английском, испанском и арабском модель была относительно нецензурированной. Если ваши пользователи задают вопросы о политике или истории на китайском, проверьте это напрямую. Если речь о коде и таблицах, такое случается редко.
Расположение данных. Куда попадут ваши данные, определяет тот, кто хостит модель. Политика конфиденциальности DeepSeek гласит, что компания собирает, обрабатывает и хранит персональные данные в Китайской Народной Республике (политика конфиденциальности DeepSeek). Это относится к её собственному приложению и API, но не к весам под лицензией MIT, которые вы запускаете где-то ещё. У Mistral противоположный аргумент: компания заявляет, что обучала Large 4 в собственных дата-центрах в Европе, а превью работает как европейское развёртывание по европейскому праву. Прежде чем отправлять данные клиентов любому хостингу, спросите, где выполняется инференс и что логируется.
Устаревание. Открытые модели устаревают за месяцы. Веса gpt-oss вышли год назад, новейшая Llama от Meta — из 2025 года, а Qwen и DeepSeek выпустили по нескольку версий только в 2026-м. Фиксируйте точную версию модели, которую тестировали, и перепроверяйте при обновлении.
Кому всё же стоит платить за закрытый API
Разрыв в 3% — это показание одного бенчмарка. На самой вершине лидерство по-прежнему у закрытых моделей, а лаборатории, которые их продают, продолжают добавлять инструменты и управляемые функции, которых нет в открытых весах.
Платите за Claude или ChatGPT, если вам нужна максимальная точность в сложной работе с высокой ценой ошибки, если некому заниматься инфраструктурой или если объёмы слишком малы, чтобы хостинг имел значение. Команда, которая делает несколько тысяч вызовов в день, потратит на время инженеров меньше, чем сэкономит на токенах. Платите и тогда, когда хотите, чтобы один вендор отвечал за аптайм, безопасность и поддержку.
Комбинируйте, а не переключайтесь. Типичная схема: рутинный основной поток идёт в открытую модель через хостинг, а сложные случаи эскалируются в закрытую. Правила маршрутизации из нашего руководства по подбору уровня модели под задачу подходят здесь напрямую: по умолчанию дешёвая модель, при неудаче — эскалация.
Частые вопросы
Чем отличаются open-weight и open-source?
Open-weight означает, что вы можете скачать обученную модель. Open-source в строгом смысле включал бы ещё и обучающие данные, и код под одобренной лицензией. Почти ничто из этого списка этой планке не соответствует. Ближе всего на практике модели под Apache 2.0 и MIT. Кастомные лицензии, как у Kimi и Qwen, добавляют условия.
Можно ли использовать эти модели в коммерческих целях?
Да, для создания продуктов на их основе — по всем лицензиям, о которых здесь шла речь. Условия начинают работать, когда вы продаёте саму модель как сервис, а в нескольких случаях — когда ваш продукт очень крупный. У моделей под Apache 2.0 и MIT нет никаких условий по выручке.
Какая открытая модель лучше всего подходит для кода?
По данным самих вендоров, лидируют GLM-5.3, Kimi K3 и DeepSeek V4.1 Flash, и всем трём нужно серверное железо. Для одной машины практичный выбор — Qwen3.8-27B. Проведите собственные тесты на своей кодовой базе: наборы бенчмарков отличаются.
Безопасно ли использовать DeepSeek для корпоративных данных?
Зависит от способа запуска. Приложение и API DeepSeek хранят данные в Китае согласно политике, о которой шла речь выше. Веса под MIT, запущенные на ваших серверах или у проверенного хостинга, ничего не отправляют в DeepSeek. Отдельные риски поведения модели из старой оценки NIST по-прежнему актуальны.
Сколько памяти GPU мне нужно?
Грубо: число параметров умножить на количество бит и разделить на восемь, плюс около 20% на кэш и среду выполнения. Модель на 27B в 8 бит — около 33 ГБ с накладными расходами. Модель на 117B в 4 бит — около 70 ГБ. Калькулятор выше посчитает всё за вас.
Когда Mistral Large 4 станет открытой?
Mistral пообещала выложить веса вскоре после анонса, но условия лицензии не опубликовала. Проверьте её страницу на Hugging Face, прежде чем строить планы.