

Engenheiros da Anthropic uma vez deixaram um agente líder distribuir instruções curtas como "pesquise a escassez de semicondutores". Os subagentes interpretaram mal: um explorou a crise de chips do setor automotivo de 2021, enquanto outros dois duplicaram o trabalho sobre as cadeias de suprimento de 2025 (Anthropic Engineering). Nada quebrou. Cada agente fez algo razoável com um pedido vago o bastante para ser lido de várias maneiras.
A maioria de nós repete esse erro sempre que entrega trabalho ao ChatGPT, ao Claude, ao Gemini CLI ou a um dos agentes de programação no terminal. Digitamos uma tarefa e chamamos isso de briefing. Abaixo: seis partes de que um briefing precisa, três reescritas que você pode aproveitar, um modelo e uma tabela com as formas como os briefings falham. Nossas posições, defendidas ao longo do texto: escreva primeiro a linha de "pronto quando", troque o "me pergunte se tiver dúvida" por uma lista nomeada de ações e corte os paredões de letras maiúsculas. A documentação dos fabricantes que citamos respalda parte disso e não cobre o resto, e dizemos qual é qual.
Uma tarefa não é um briefing
Uma tarefa nomeia uma atividade. Um briefing dá a quem vai executá-la tudo o que, de outra forma, essa pessoa teria de adivinhar. O guia de prompts da Anthropic usa a imagem de um funcionário novo: "Pense no Claude como um funcionário brilhante, mas novo, que não tem contexto sobre as suas normas e fluxos de trabalho." (Anthropic docs) A OpenAI traça uma distinção parecida entre tipos de modelo. Um modelo de raciocínio é "como um colega sênior", capaz de receber um objetivo e resolver os detalhes, enquanto um modelo GPT é "como um colega júnior", que rende melhor "com instruções explícitas para gerar uma saída específica" (OpenAI docs).
A OpenAI diz que modelos de raciocínio vão bem com orientações de alto nível, e nós não confiaríamos nisso quando o trabalho dura dezenas de passos com efeitos colaterais. O colega sênior continua sem saber o que "pronto" significa para você, e o palpite errado de um júnior custa um e-mail. Um agente age sobre a primeira interpretação errada em cada passo seguinte, como o agente líder da Anthropic mostrou.
A Anthropic oferece um teste de que gostamos porque leva dois minutos: "Mostre seu prompt a um colega com contexto mínimo sobre a tarefa e peça que ele o siga. Se ele ficar confuso, o Claude também ficará." (Anthropic docs) Se um prestador de serviço não conseguiria começar a partir da sua mensagem sem mandar cinco perguntas, o agente vai responder essas cinco perguntas sozinho, em silêncio, e você só vai descobrir pelo resultado.
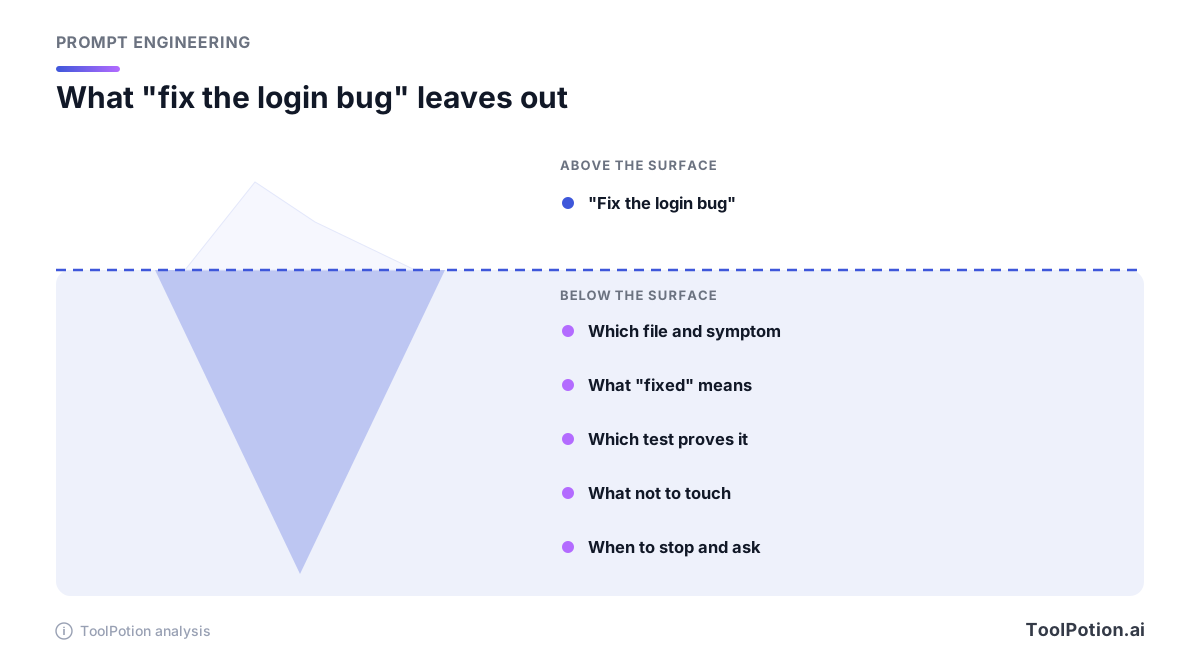
Escreva a linha de "pronto quando" antes de qualquer outra coisa
A própria página de boas práticas do Claude Code é direta: "O Claude para quando o trabalho parece pronto." Sem algo para rodar que diga se o trabalho está pronto, continua a página, "na prática isso faz de você a suíte de testes, e cada erro fica ali até você por acaso perceber." (Claude Code docs)
A orientação do Codex da OpenAI chega à mesma ideia pelo outro lado. Ela sugere quatro itens em um prompt: objetivo, contexto, restrições e "Done when" (pronto quando), que formula como uma pergunta sobre o que deve ser verdade antes de a tarefa estar concluída, "como testes passando, comportamento mudando ou um bug que não se reproduz mais" (OpenAI Codex docs). Dois fabricantes, dois produtos, um só esqueleto. Acrescentamos duas partes nossas (parar e perguntar, e relatório), e escreveríamos a linha de "pronto quando" primeiro, mesmo ela ficando em quarto lugar no briefing final, porque escrevê-la obriga você a descobrir o que quer.
Fora do código, a mesma linha funciona com outro tipo de verificação. "Uma tabela com doze fornecedores, um link de fonte ao lado de cada preço e um alerta em qualquer preço que não seja público" é algo que um agente consegue contar. "Uma comparação minuciosa" é algo que ele só consegue sentir.
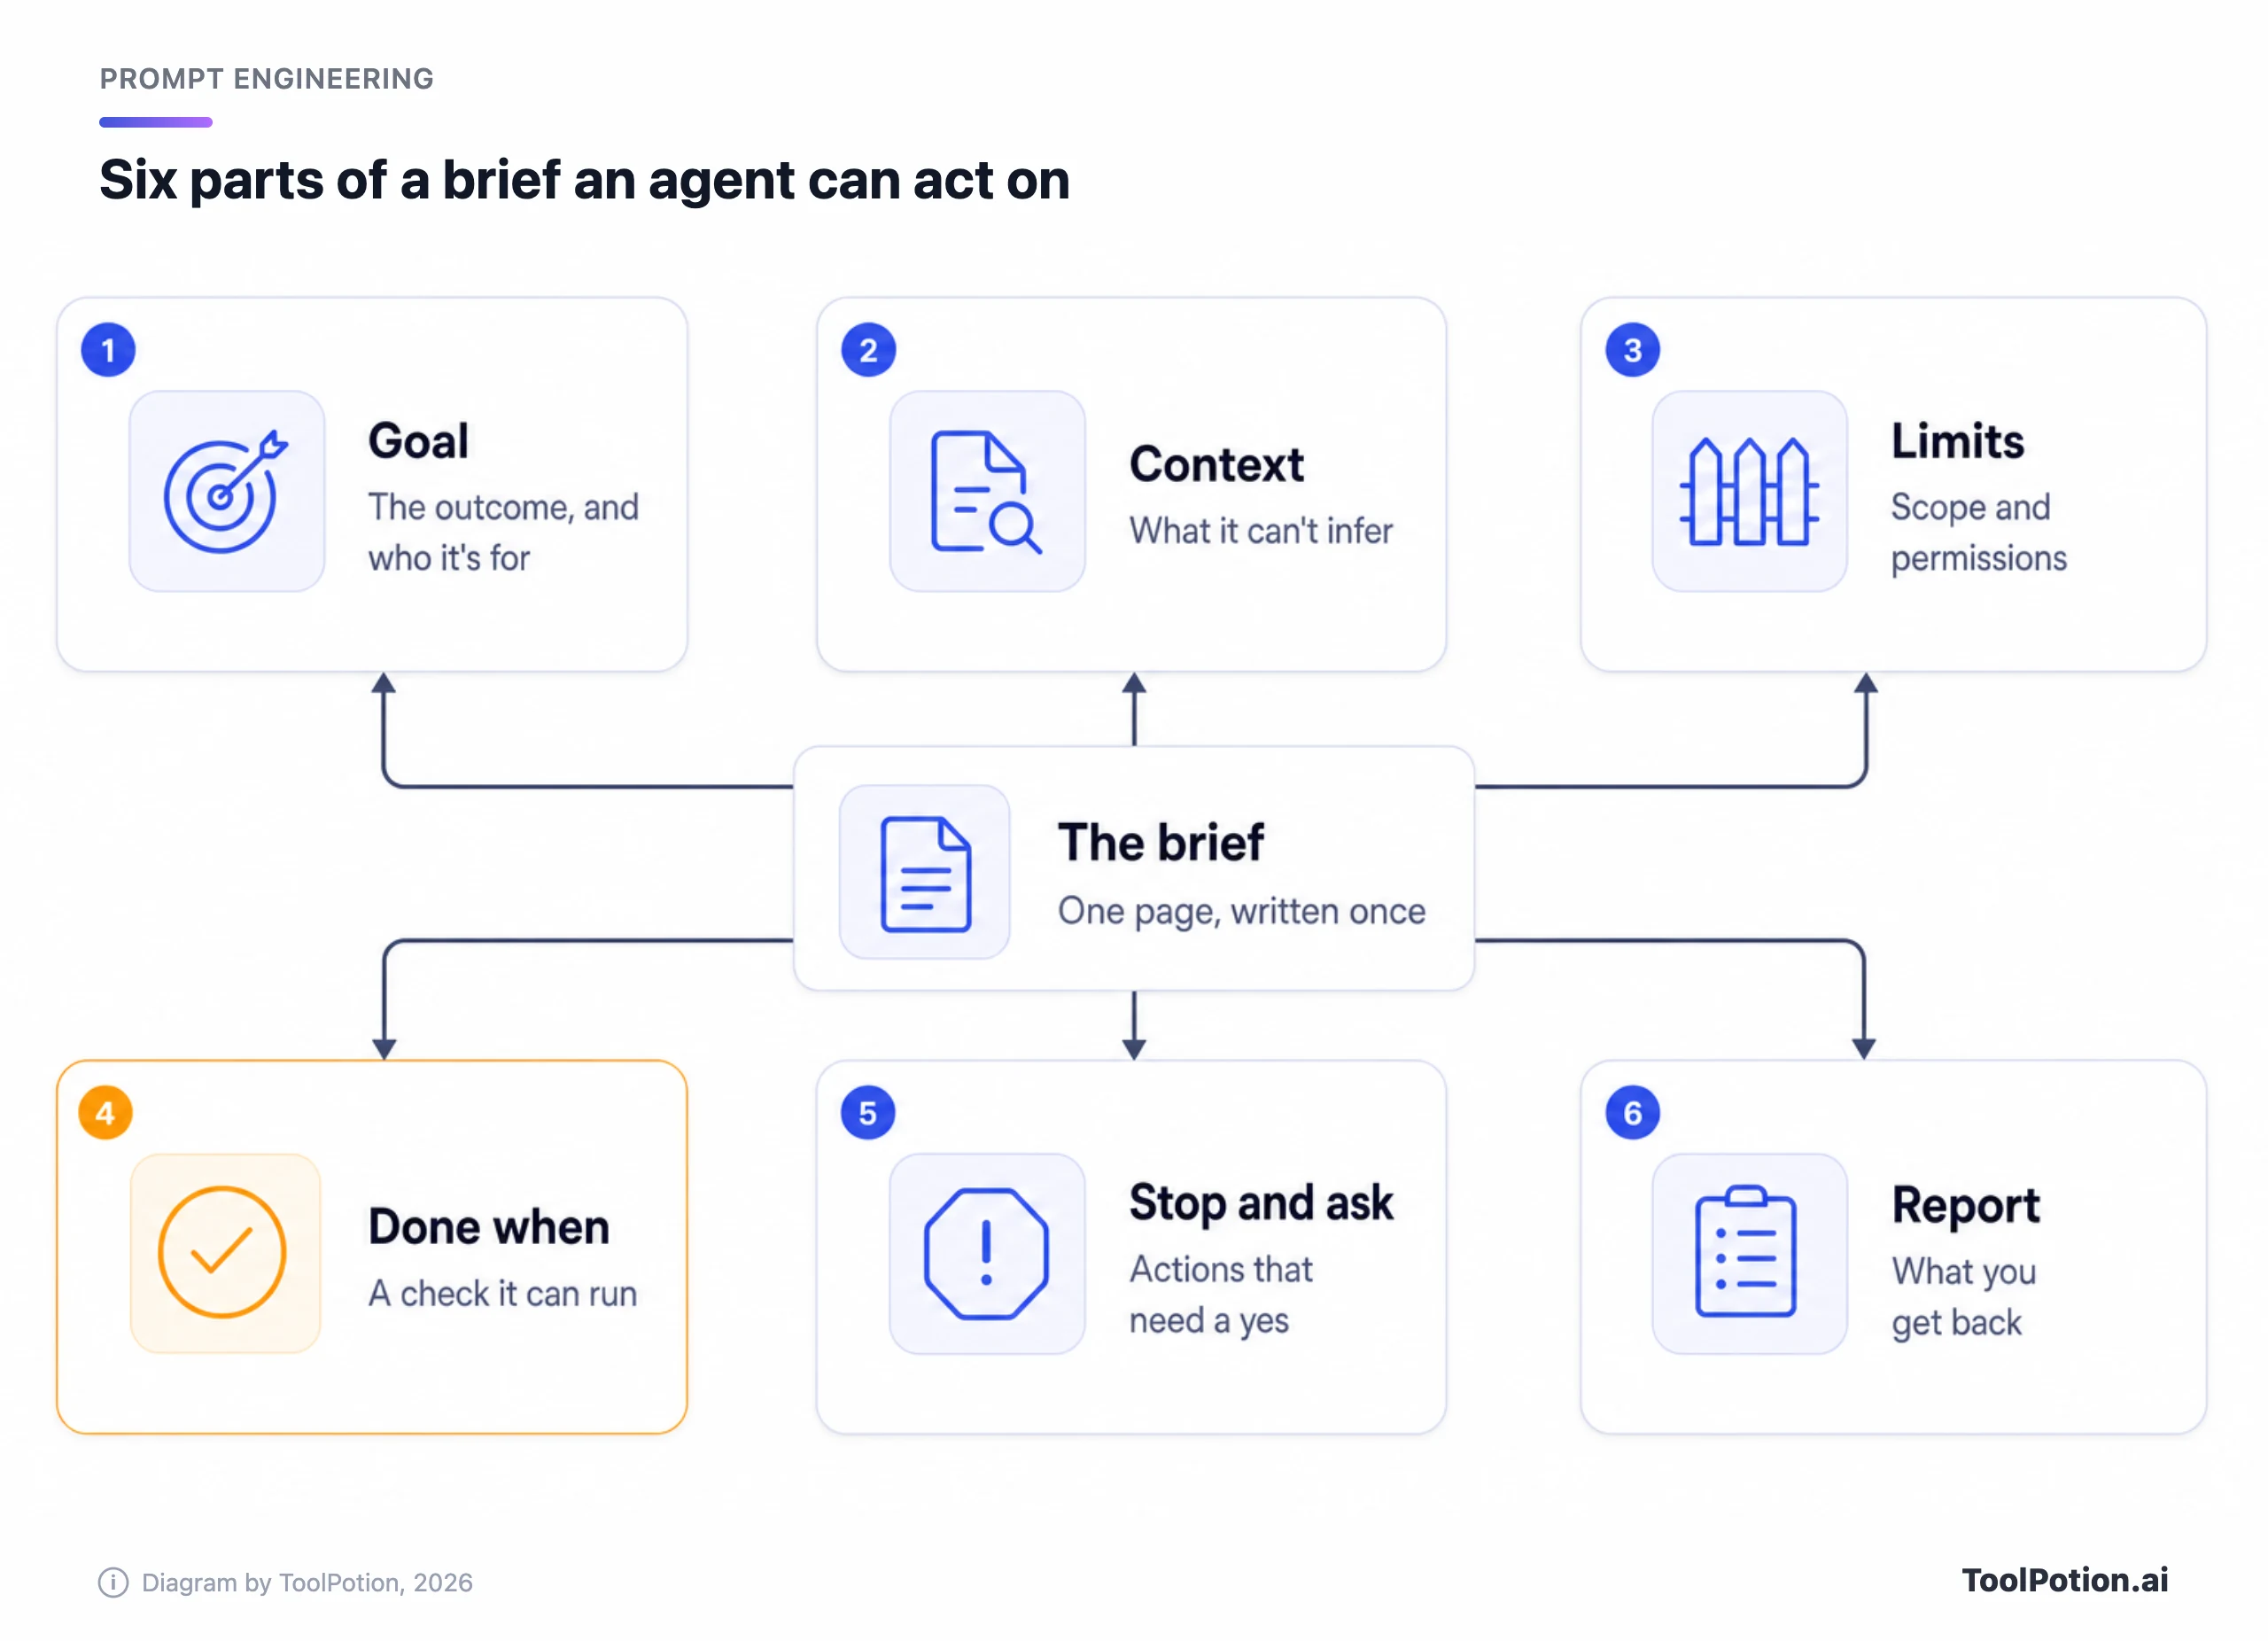
As seis partes de um briefing, de cima para baixo
O objetivo nomeia o resultado e quem vai usá-lo
Uma ou duas frases. Diga o que você quer no final e o que isso alimenta: uma recomendação que dois sócios vão ler em cinco minutos, uma correção que vai ao ar na sexta, uma lista de finalistas para uma compra. O destino muda o que o agente inclui e o que ele corta. "Pesquise preços" gera volume. "Recomende uma ferramenta de até US$ 15 por usuário" gera uma decisão.
Contexto é tudo o que ele não consegue achar sozinho
A documentação do Claude Code traz um filtro útil: "Ele conseguiria achar isso lendo o código? Ele realmente iria procurar? Se as duas respostas forem sim, deixe de fora." (Claude Code docs) O que fica é a decisão tomada em reunião que nunca chegou ao repositório, a conta que o agente deve usar, a ferramenta que você já testou e descartou, o nível do leitor.
Dê também o motivo por trás de uma regra. O guia da Anthropic diz que o contexto ou a motivação por trás de uma instrução "pode dar ao Claude mais informações sobre seus objetivos e ajudá-lo a entregar respostas mais direcionadas", e o próprio exemplo da versão mais fraca é um simples "NUNCA use reticências" (Anthropic docs).
Os limites dizem o que está no escopo e o que está fora dele
Agentes tendem a fazer mais do que você pediu. O guia da Anthropic diz que o Claude Opus 4.5 e o 4.6 têm tendência a "criar arquivos extras, adicionar abstrações desnecessárias ou embutir flexibilidade que não foi pedida", e oferece uma instrução de exemplo que inclui "Não adicione funcionalidades, não refatore código nem faça \"melhorias\" além do que foi pedido." (Anthropic docs) O guia associa esse hábito a esses dois modelos, então confira com o que você usa. De qualquer forma, pegaríamos a frase emprestada. Depois acrescente a sua própria lista: pastas que ele pode mexer, fontes que pode usar, contas em que não pode entrar.
O guia do Gemini, do Google, lista a avaliação de risco entre as configurações que um prompt de agente controla e diz que ele pode distinguir explicitamente entre ações exploratórias de baixo risco (leituras) e mudanças de estado de alto risco (escritas) (Google AI docs). Essa divisão é a parte útil. Ler e rodar testes não pedem autorização; apagar, enviar e pagar pedem.
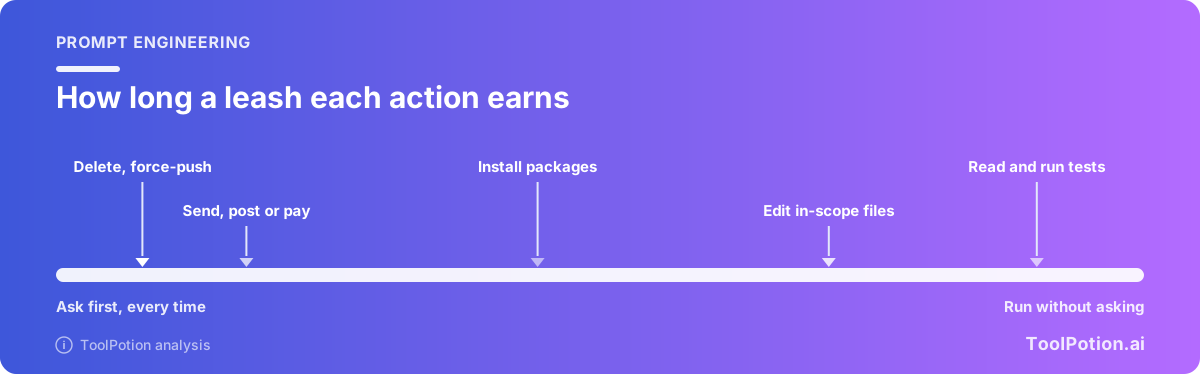
Um alerta antes de você se apoiar em qualquer coisa disso. Palavras em um briefing são pedidos. Um sandbox, um token somente leitura ou uma regra de permissão é imposição, e um não substitui o outro. Nosso guia sobre como conter agentes de IA cobre o lado da imposição; este texto fica no que você escreve.
Pronto quando é uma verificação que ele consegue executar
Nomeie o comando, a contagem ou o arquivo. "Os testes passam" é um começo. "pnpm test passa e um novo teste prova que a 101ª requisição em um minuto recebe um 429" é uma verificação. Em pesquisa, diga quantos itens, quais campos e o que escrever quando um campo não for encontrado. Se a verificação puder falhar, diga ao agente o que fazer em seguida e ponha um limite. O guia do Google observa que "Alta persistência aumenta as taxas de sucesso, mas arrisca custos de tokens mais altos ou loops", então "tente de novo um teste que falha duas vezes, depois pare e relate" é uma linha melhor do que o silêncio (Google AI docs).
Parar e perguntar é uma lista de ações, não um estado de espírito
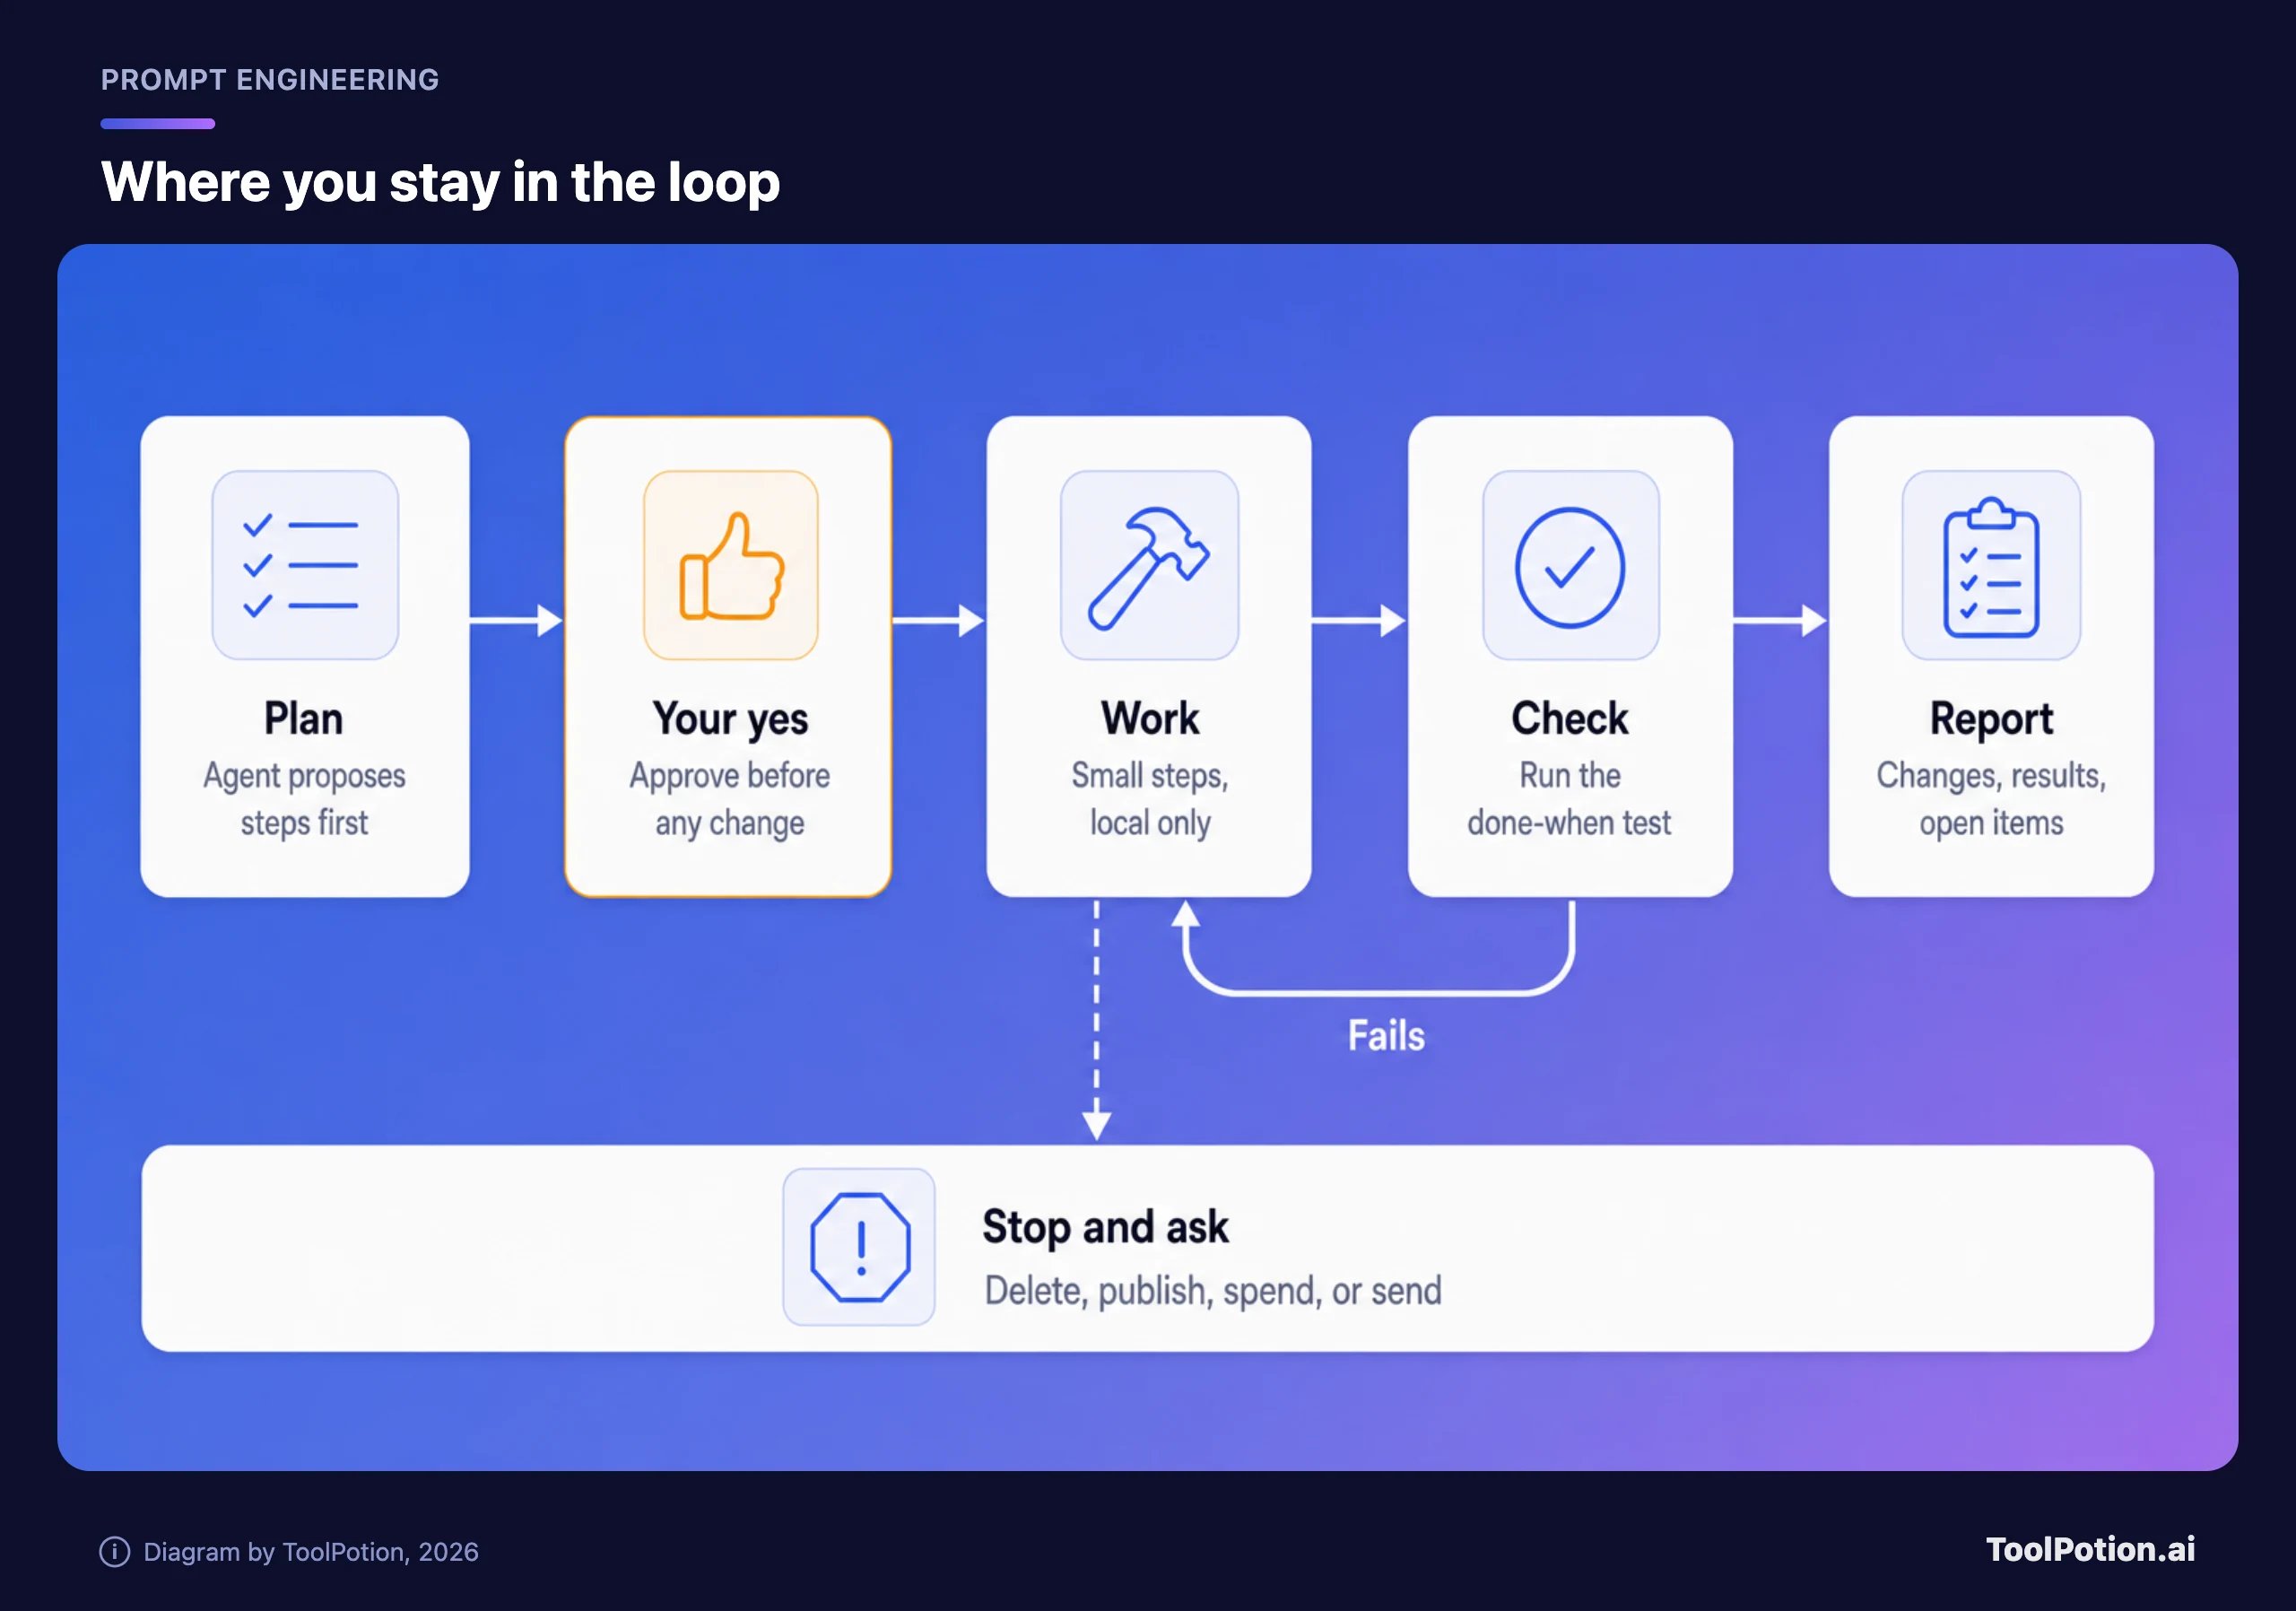
"Pergunte se tiver dúvida" entrega ao agente um julgamento para fazer, e um agente ansioso raramente tem dúvida. Liste as ações. O guia da Anthropic traz um prompt de exemplo exatamente para isso, escrito para o Claude Opus 4.6: para ações "difíceis de reverter, que afetam sistemas compartilhados ou podem ser destrutivas, pergunte ao usuário antes de prosseguir", com apagar arquivos ou branches, git push --force e enviar mensagens entre os exemplos (Anthropic docs). A lista é a parte que copiaríamos, seja qual for o modelo.
O ensaio da Anthropic sobre design de agentes descreve o padrão: os agentes "podem então fazer uma pausa para receber feedback humano em pontos de verificação ou ao encontrar bloqueios" (Anthropic Engineering). Faça do primeiro ponto de verificação um plano. Peça os passos antes de qualquer mudança, leia e só então diga "pode ir". Custa uma ida e volta, e achamos que é o ponto de verificação mais barato que existe.
O relatório é onde você diz o que deve voltar
Peça as mudanças feitas, as verificações executadas com seus resultados, tudo o que ele presumiu e tudo o que escolheu não fazer. Esse último item é o que as pessoas esquecem. É aqui que o agente avisa que pulou a migração porque você mandou não mexer no schema.
Três briefings, antes e depois
Cada reescrita abaixo tem de 120 a 150 palavras. É mais do que o prompt médio e menos do que as pessoas temem. Os três briefings são exemplos inventados por nós: as tarefas, as ferramentas e os números são fictícios, para ilustrar, e nenhum vem de um fabricante ou de um projeto real.
Um agente de pesquisa (exemplo inventado)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.Um agente de programação (exemplo inventado)
A documentação do Claude Code traz o seu próprio antes e depois: "adicionar um widget de calendário" vira um pedido para seguir o padrão de um arquivo de widget existente, com "nenhuma biblioteca nova" (Claude Code docs). Aqui está o mesmo movimento em um trabalho maior, escrito para o Claude Code ou o Codex.
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.Um agente de caixa de entrada (exemplo inventado)
Este serve para qualquer assistente que você deixe chegar perto do seu e-mail, o tipo de tarefa para a qual produtos de agente como o Manus e o Claude Cowork são vendidos. E-mail é onde "limpar" pode virar "apagar" sem ninguém notar.
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.A linha do objetivo quase não muda entre o antes e o depois. O peso está nas quatro últimas linhas: uma verificação, uma parada, um relatório e um limite que diz o que o agente nunca pode fazer.
Um modelo para colar
Apague qualquer linha que não se aplique, mas apague de propósito.
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
Avalie o seu próprio rascunho com ele. Oito perguntas de sim ou não, trinta segundos.
Como os briefings falham e o que mudaríamos
| Falha | O que você vê | Mudança |
|---|---|---|
| O objetivo é uma atividade | Páginas de saída, nenhuma decisão | Diga o que a saída alimenta |
| Sem "pronto quando" | Para em "parece pronto" ou nunca para | Adicione uma verificação executável e um limite de tentativas |
| Escopo não declarado | Arquivos extras, refatorações, melhorias não pedidas | Liste o que está fora dos limites |
| Avisos sem motivos | Um paredão de linhas com NUNCA, ignoradas ou aplicadas em excesso | Acrescente o motivo em uma oração |
| Aprovação apenas implícita | Apaga, faz push ou envia por conta própria | Nomeie as ações e peça um plano primeiro |
| Correções se acumulando | As instruções se contradizem | Reescreva o briefing e comece do zero |
Dois desses itens merecem uma explicação maior. O primeiro é o monte de maiúsculas. Duvidamos que mais ênfase tenha algum dia resolvido a falta de um motivo, e o guia da Anthropic aponta na mesma direção: um simples "NUNCA use reticências" é o exemplo fraco dele. A documentação do Claude Code acrescenta que "Frases como pense passo a passo ou seja minucioso são texto de prompt comum, não palavras-chave" (Claude Code docs). Por isso cortaríamos o texto padrão de "seja minucioso". O guia da Anthropic recomenda, sim, dar um papel ao Claude, mesmo que de uma frase, então não o baniríamos; só pularíamos a persona de "especialista de classe mundial", porque as seis partes já dizem ao agente mais do que um título diz.
O segundo é o problema oposto. O prompt de agente de exemplo no guia da OpenAI (mostrado para o modelo gpt-6-astra, como exemplo e não como regra) manda o modelo "continuar até que a consulta do usuário esteja completamente resolvida" e diz "Não pare depois de concluir apenas parte do pedido" (OpenAI docs). Isso é razoável para um trabalho com linha de chegada clara e uma armadilha para um sem ela. Um agente persistente com objetivo vago pode continuar gastando tokens em um loop; o guia do Google diz o mesmo sobre alta persistência. O ensaio da Anthropic diz que é comum incluir "condições de parada (como um número máximo de iterações)" para manter o controle (Anthropic Engineering).
Mais um hábito que abandonaríamos: colar o briefing em uma conversa que já tem dez correções. O agente passa a ter onze conjuntos de instruções e nenhum jeito de hierarquizá-los.
Observe o primeiro minuto e depois reescreva
A documentação do Claude Code aconselha: "Observe o primeiro minuto, aperte Esc assim que o Claude se desviar e, depois de duas correções que falharam, rode /clear e escreva um prompt melhor em vez de uma terceira correção" (Claude Code docs). Aplicaríamos isso a qualquer agente: o primeiro plano e as primeiras ações mostram se o seu briefing foi lido do jeito que você queria.
Quando você ainda não consegue escrever o briefing, deixe o agente entrevistar você. A documentação do Claude Code sugere um prompt na linha de "Me entreviste até conseguir escrever a especificação e depois escreva-a em SPEC.md", e a orientação do Codex diz para pedir que ele faça perguntas primeiro e "desafie suas suposições" (Claude Code docs, e OpenAI Codex docs). Depois, comece uma nova sessão a partir da especificação escrita.
Briefings que funcionam duas vezes merecem um lugar fixo. Regras permanentes (como rodar os testes, o que nunca tocar) vão em um arquivo AGENTS.md ou CLAUDE.md; a OpenAI diz que "Um AGENTS.md curto e preciso é mais útil do que um arquivo longo cheio de regras vagas" (OpenAI Codex docs). Um procedimento que você repete pode virar uma skill, assunto do nosso texto From Prompts to Skills. O que carregar na sessão logo de início é tema do nosso artigo sobre engenharia de contexto, e os hábitos que mantêm os prompts funcionando entre lançamentos de modelos estão em Prompt Patterns That Survive Model Updates. Para ferramentas feitas em torno desse tipo de delegação, veja nossos rankings de agentes de IA, de tarefas de criação de agentes e de ferramentas de engenharia de prompt.
Perguntas frequentes
Qual deve ser o tamanho de um briefing?
O suficiente para conter as seis partes, o que na maioria dos trabalhos dá de 100 a 200 palavras. Preferências permanentes pertencem a um arquivo de regras, para que cada briefing cubra só a tarefa em questão. Se o briefing passar de uma página, provavelmente o trabalho precisa ser dividido em dois.
ChatGPT, Claude e Gemini precisam de briefings diferentes?
O esqueleto é o mesmo. As quatro partes da orientação do Codex da OpenAI, o conselho da Anthropic de fornecer contexto e perguntar antes de ações de risco e as dimensões de agente do Google (tratamento de ambiguidade, avaliação de risco, persistência) descrevem um mesmo conjunto de necessidades com palavras diferentes. A formatação muda um pouco: o guia do Google recomenda tags no estilo XML ou títulos em Markdown e diz para "Escolher um formato e usá-lo de forma consistente" (Google AI docs). Qual assistente serve para qual trabalho é outra questão, que tratamos em ChatGPT vs Claude vs Gemini in 2026.
O que devo dizer ao agente para fazer quando ele estiver em dúvida?
Dê a ele uma regra que ele consiga aplicar. "Presuma qualquer coisa reversível e liste no relatório; pergunte antes de qualquer coisa que não seja" funciona melhor do que "pergunte se tiver dúvida". O guia do Google enquadra a mesma escolha como quando o modelo pode fazer suposições e quando deve pausar para pedir esclarecimento ou permissão.
Um bom briefing basta para tornar um agente seguro?
Não. Um briefing reduz erros e não impede nenhum. A Anthropic recomenda "testes extensivos em ambientes isolados (sandbox), junto com as salvaguardas apropriadas" (Anthropic Engineering), e nosso guia de contenção cobre permissões e trilhas de auditoria.
O agente errou mesmo assim. E agora?
Encontre o primeiro passo em que ele saiu do rumo e pergunte o que o briefing dizia sobre esse passo. Acrescente a única linha que teria evitado o erro e rode de novo em uma sessão nova.