

Para checar a saída de IA sem se afogar nela, pare de tentar verificar cada frase. Extraia as afirmações, ordene-as pelo que quebra se estiverem erradas e confira na fonte original aquelas em que o seu texto se apoia, porque nem uma citação bem formatada nem o "sim, tenho certeza" do próprio modelo provam nada.
O custo de pular essa etapa só sobe. Um banco de dados público de decisões judiciais envolvendo material alucinado por IA tinha registrado 2.125 delas no momento em que escrevi, e 1.193 vieram só deste ano (AI Hallucination Cases database). No início deste ano, a KPMG retirou do ar um relatório publicado por causa de aparentes alucinações de IA, depois que organizações citadas nele disseram que as afirmações sobre o uso de IA que faziam parte do texto eram "falsas ou enganosas" (TechCrunch).
As alucinações não sumiram. Elas ficaram mais difíceis de notar, porque o texto ao redor é fluente e as referências falsas parecem reais. Abaixo você vê os tipos de afirmação que mais falham, por que a autoverificação não resolve, um fluxo baseado em risco com prompts prontos para copiar e uma avaliação honesta de ferramentas de grounding como Gemini Notebook (antigo NotebookLM), Perplexity e Consensus.
Citações falsas viraram um gênero nos tribunais
Os advogados aprenderam isso primeiro, e em público. O banco de dados de Damien Charlotin registra decisões em que um tribunal constatou, ou deu a entender, que uma das partes se baseou em conteúdo alucinado, geralmente jurisprudência inventada. Ele não tenta contar toda citação falsa já apresentada, só aquelas que um tribunal tratou por escrito. Mesmo com esse filtro estreito, a curva é íngreme.
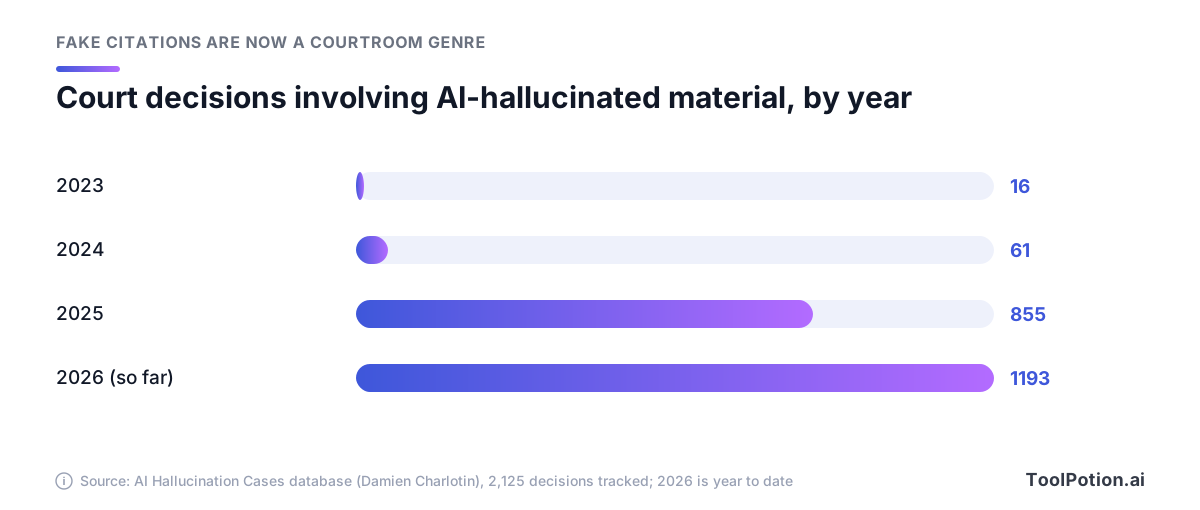
A barra de 2026 cobre só parte do ano e já passou a de 2025. Pessoas que se representam sozinhas respondem por 1.227 das decisões registradas, mas advogados respondem por 840, e a lista inclui 33 em que o material alucinado veio de um juiz. Os Estados Unidos dominam, com 1.459 decisões, seguidos do Canadá, com 223, e da Austrália, com 112.
O caso que começou tudo continua sendo a melhor lição. Em Mata v. Avianca, em 2023, um advogado de um processo na justiça federal de Nova York perguntou ao ChatGPT se um dos casos que ele tinha fornecido era real. Ele disse que sim. Pressionado de novo, respondeu que o caso "realmente existe e pode ser encontrado em bases de pesquisa jurídica como Westlaw e LexisNexis" (CNN). O caso não existia, e o tribunal multou os advogados e o escritório em US$ 5.000. O advogado declarou em juramento que "não sabia que o conteúdo poderia ser falso".
As contas só cresceram desde então. Em Couvrette v. Wisnovsky, um tribunal federal do Oregon encontrou quinze citações inventadas e sete citações distorcidas nas petições dos autores. O tribunal desconsiderou as petições, extinguiu as ações com resolução definitiva e impôs US$ 110.204 em sanções e custas, o maior valor total de um caso dos EUA no banco de dados. Se você usa IA em trabalho jurídico, nosso guia de IA para trabalho jurídico cobre as configurações mais seguras.
Os tribunais são apenas a arena mais visível. A Deloitte aceitou devolver parte do pagamento de uma revisão de US$ 440.000 feita para o governo australiano, que citava relatórios inexistentes atribuídos a professores universitários e incluía uma referência inventada a uma decisão judicial real. A empresa depois revelou que havia usado uma cadeia de ferramentas baseada no GPT-4o do Azure OpenAI (The Guardian). A EY retirou este ano um relatório sobre programas de fidelidade que aparentemente tinha notas de rodapé falsas, segundo a mesma matéria do TechCrunch que tratou da KPMG. E em 2025 o Chicago Sun-Times publicou uma lista de leituras de verão distribuída em syndication em que 10 dos 15 livros eram inventados, segundo a NPR.
Onde a saída de IA erra
Os modelos raramente erram a grafia de palavras hoje, e os pesquisadores da OpenAI explicam por que os erros migraram. A ortografia segue padrões que um modelo grande aprende, mas "fatos arbitrários e de baixa frequência, como o aniversário de um animal de estimação, não podem ser previstos só a partir de padrões e, por isso, levam a alucinações" (OpenAI). Quando pediram a um chatbot muito usado o título da tese de doutorado de um dos autores do próprio artigo, ele deu três respostas diferentes. Nenhuma estava certa.
Isso te dá um mapa. Os erros se concentram em poucos tipos de afirmação, e os mais arriscados são os que vêm disfarçados de prova.
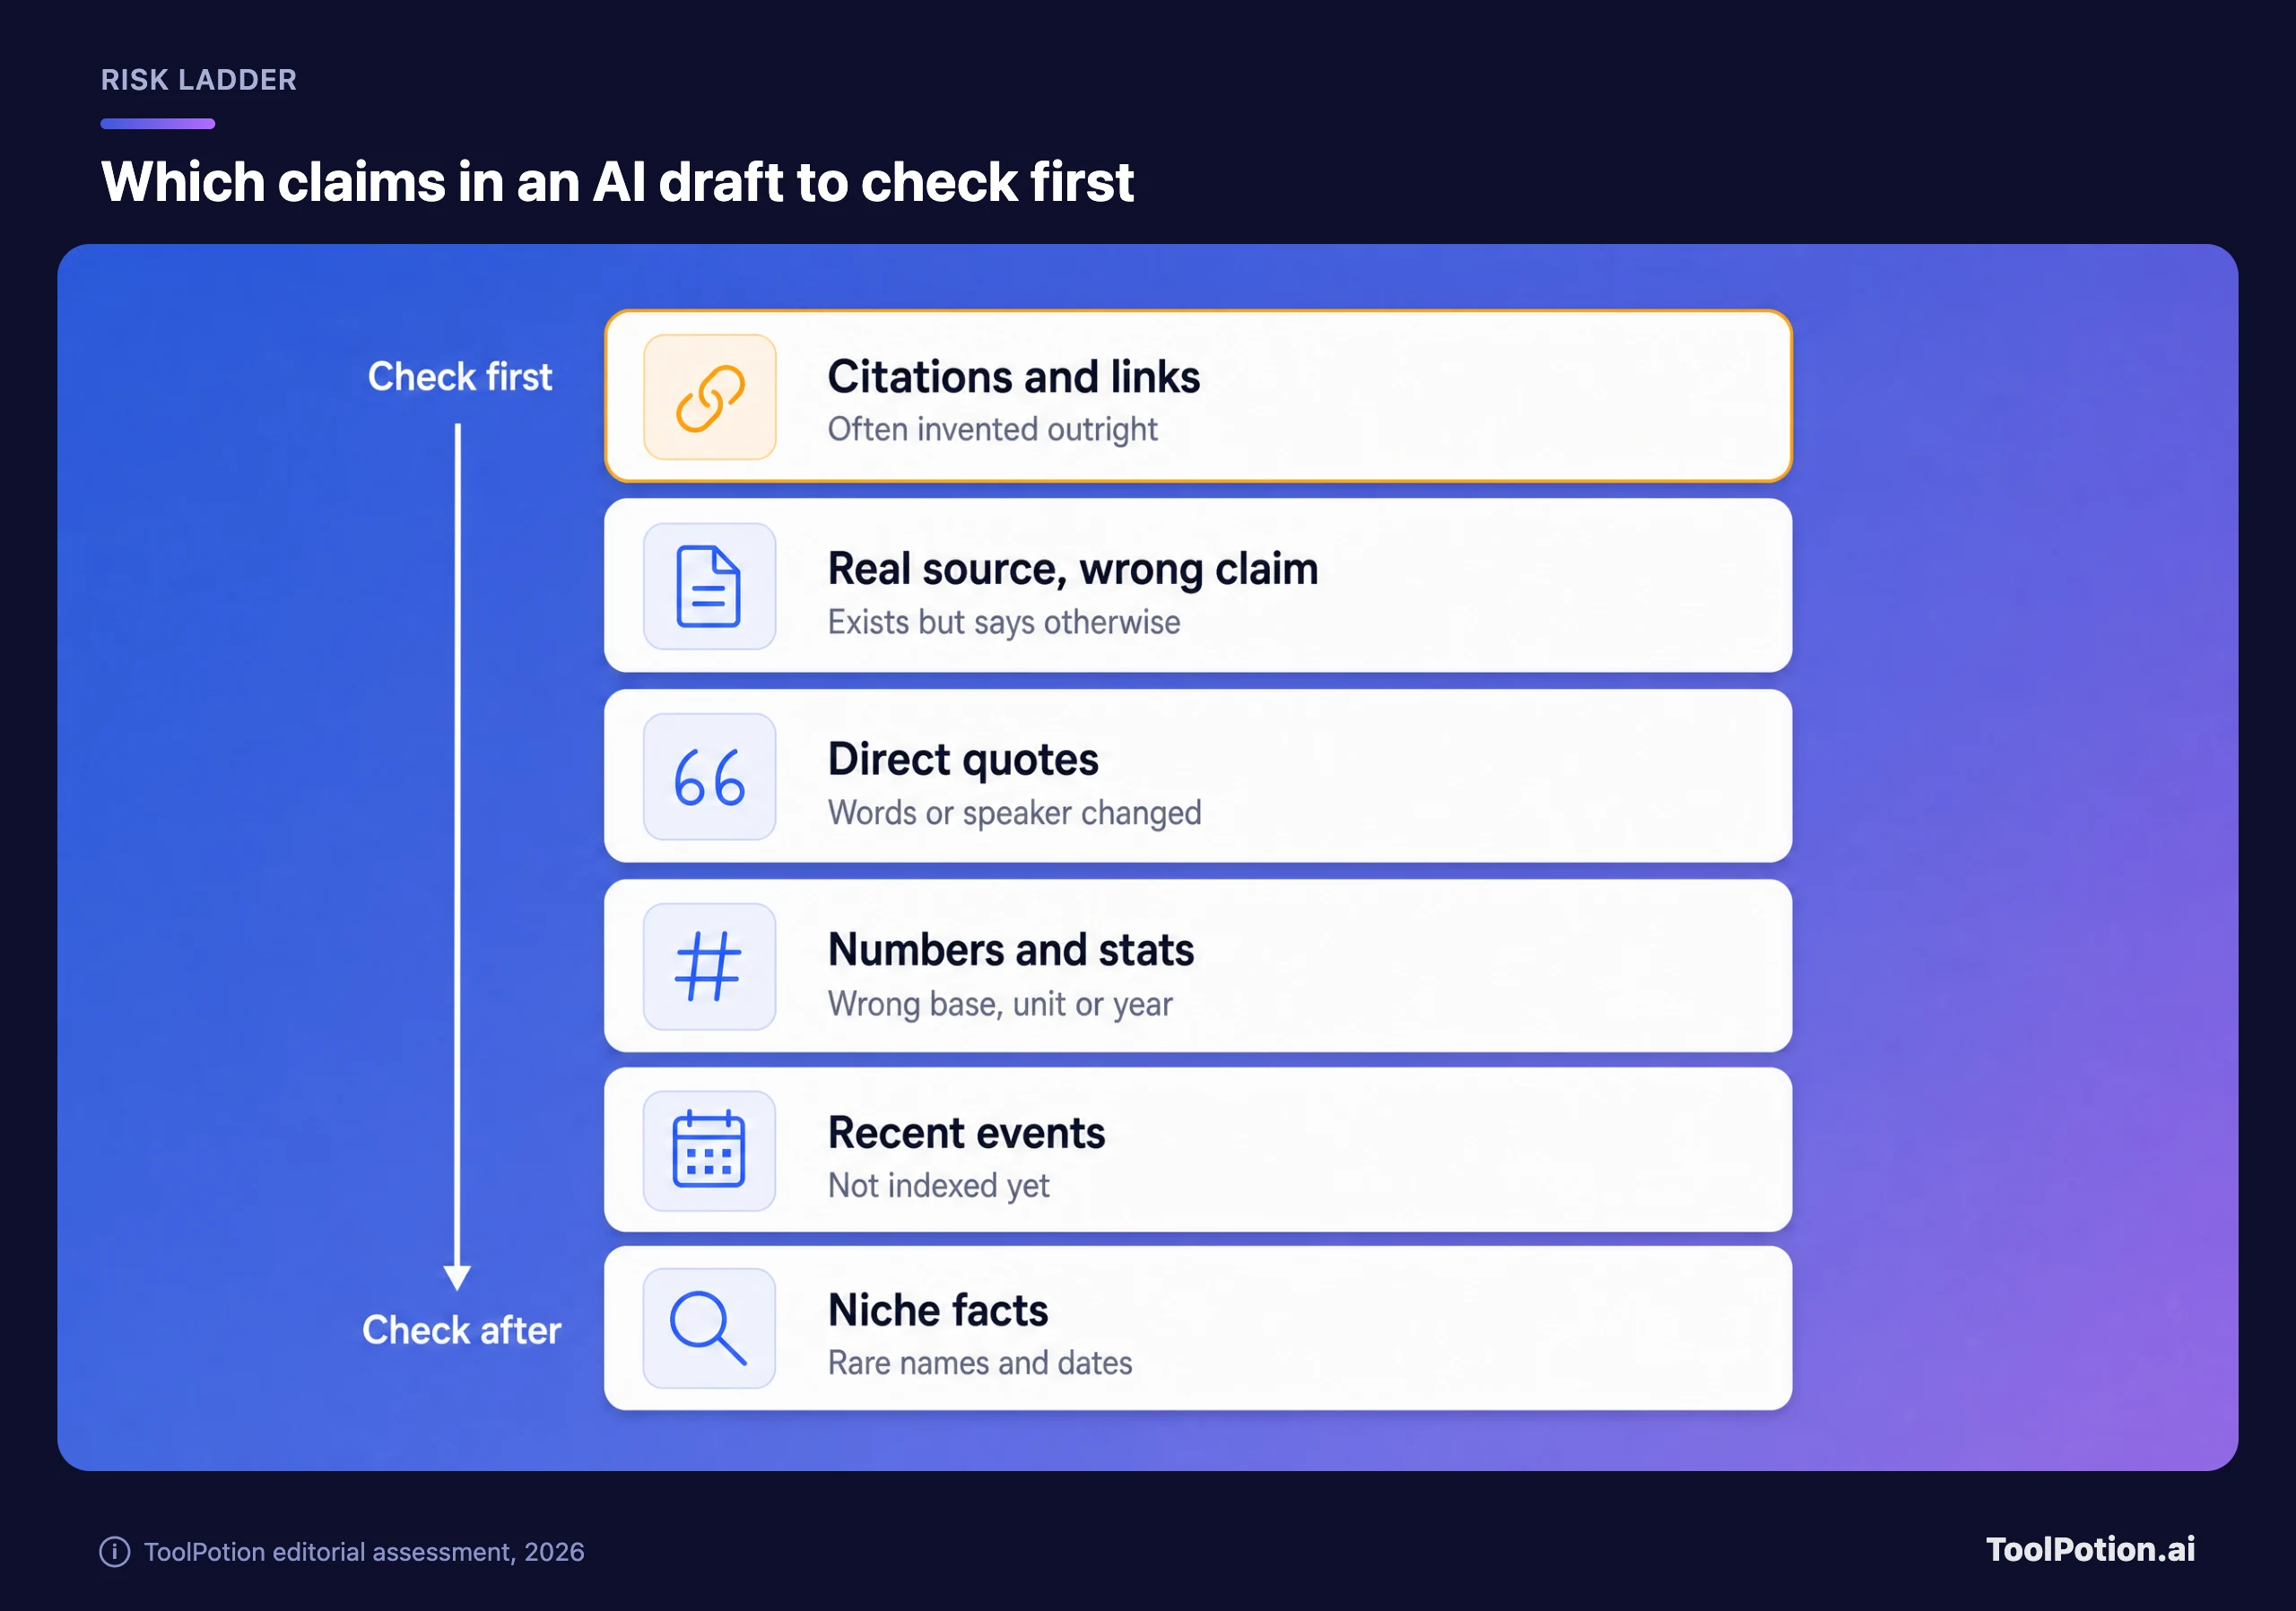
As citações ficam no topo porque falham de dois jeitos. Algumas são inventadas do zero: quando o Tow Center, da Columbia, rodou 1.600 consultas em oito ferramentas de busca com IA em 2025, pedindo a cada uma que identificasse a fonte de um trecho de notícia, as ferramentas, no conjunto, erraram mais de 60%, e o Grok 3 mandou 154 de suas 200 citações para páginas de erro (Tow Center). Outras são reais, mas citadas para algo que não dizem. O banco de Charlotin contabiliza 894 decisões envolvendo material distorcido, ao lado de 1.752 envolvendo invenção. Um link que funciona não pega esse segundo tipo.
As falas vêm em seguida. O banco lista 572 decisões com citações falsas, e a própria central de ajuda da OpenAI inclui "citações, estudos, referências ou menções a fontes inexistentes inventados" entre os modos de falha conhecidos do ChatGPT (OpenAI Help). Os números falham de forma mais discreta: um dado real do ano errado, um percentual apresentado como pontos percentuais, um preço regional passado por global.
A atualidade é uma armadilha à parte. A documentação para desenvolvedores do Perplexity diz que a alucinação é mais provável quando a informação está atrás de login ou paywall, quando as buscas retornam "resultados relacionados, mas que não correspondem" ou "quando informações muito recentes ainda não foram indexadas" (Perplexity docs). Um estudo de 2025 liderado pela BBC, com mais de 3.000 respostas de notícias do ChatGPT, Microsoft Copilot, Google Gemini e Perplexity, encontrou problemas graves de precisão, incluindo informação desatualizada, em 20% delas.
Depois, há o tom. No teste do Tow Center, o ChatGPT identificou errado 134 artigos, mas sinalizou incerteza apenas 15 vezes em 200 respostas, e os planos pagos de algumas ferramentas acertaram mais perguntas, mas também deram mais respostas erradas com confiança. A página de ajuda da OpenAI diz sem rodeios: "O modelo pode expressar alta confiança mesmo em respostas incorretas." Na saída de IA, um tom confiante diz quase nada sobre a precisão.
Por que pedir ao modelo para rechecar não resolve
O atalho óbvio é colar o rascunho de volta e perguntar se está correto. Mata v. Avianca já mostrou como isso termina, e a pesquisa confirma. Um artigo apresentado na ICLR 2024 constatou que os modelos "têm dificuldade de se autocorrigir sem feedback externo e, às vezes, o desempenho até piora depois da autocorreção" (Huang et al.).
A causa está no treinamento. Os pesquisadores da OpenAI argumentam que "os procedimentos padrão de treinamento e avaliação recompensam o chute em vez de admitir a incerteza", assim como uma prova de múltipla escolha premia o palpite às cegas em vez da resposta em branco. Eles também admitem que a precisão "nunca chegará a 100%", porque algumas perguntas reais não têm resposta. Um modelo que revisa o próprio rascunho recorre ao mesmo conhecimento que produziu o erro, então a revisão tende a repeti-lo.
A autorrevisão ainda tem utilidade. Um artigo de 2023 sobre Chain-of-Verification mostrou que uma versão estruturada ajuda: o modelo escreve uma resposta, formula perguntas de verificação, responde a elas independentemente do rascunho e depois revisa. Isso reduziu as alucinações em várias tarefas. Use isso para encontrar suspeitos, nunca para inocentá-los.
Fundamentado não é o mesmo que correto
Dar ao modelo uma fonte para trabalhar reduz a taxa de erro. Não a zera. O ranking público da Vectara pede que os modelos resumam mais de 7.700 artigos usando apenas os fatos de cada um e depois avalia os resumos com o modelo de detecção da própria Vectara. Mesmo nesse cenário fácil, todos os modelos da lista acrescentam conteúdo sem respaldo em alguma parcela dos resumos (Vectara).
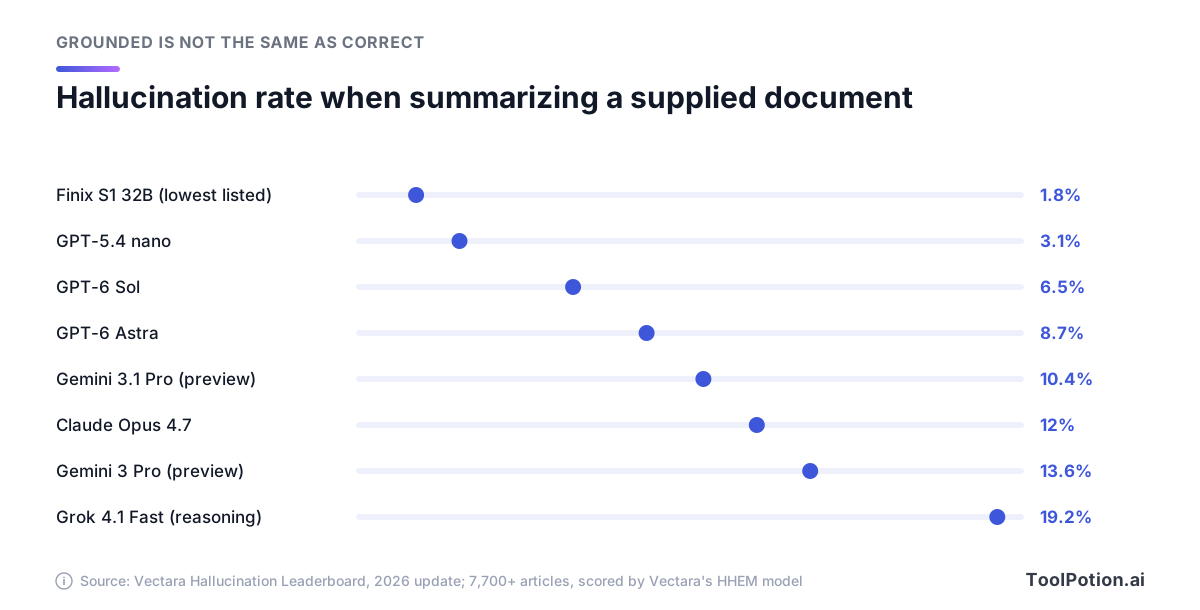
Na atualização mais recente, o GPT-6 Sol acrescentou material sem respaldo a 6,5% dos resumos e o Claude Opus 4.7 a 12%. Um modelo avaliando outro modelo é imperfeito, a Vectara diz claramente que o teste não captura todo tipo de alucinação, e a tabela ainda não inclui todos os lançamentos atuais. Mesmo assim, a direção é clara. Um estudo de 2024 sobre ferramentas de pesquisa jurídica que recuperam jurisprudência real, incluindo o Lexis+ AI e o AI-Assisted Research da Westlaw, constatou que elas ainda alucinavam entre 17% e 33% das vezes. O grounding reduz o problema a uma única pergunta: a fonte diz isso? Você ainda precisa fazê-la.
Um fluxo de verificação organizado por risco
A solução é a triagem. A maior parte de um rascunho é tecido conjuntivo: contextualização, transições e opiniões que você defenderia de qualquer jeito. Um pequeno conjunto de afirmações sustenta o texto, e é nele que um erro causa dano. Primeiro separe, depois gaste seu tempo de checagem onde ele compensa.
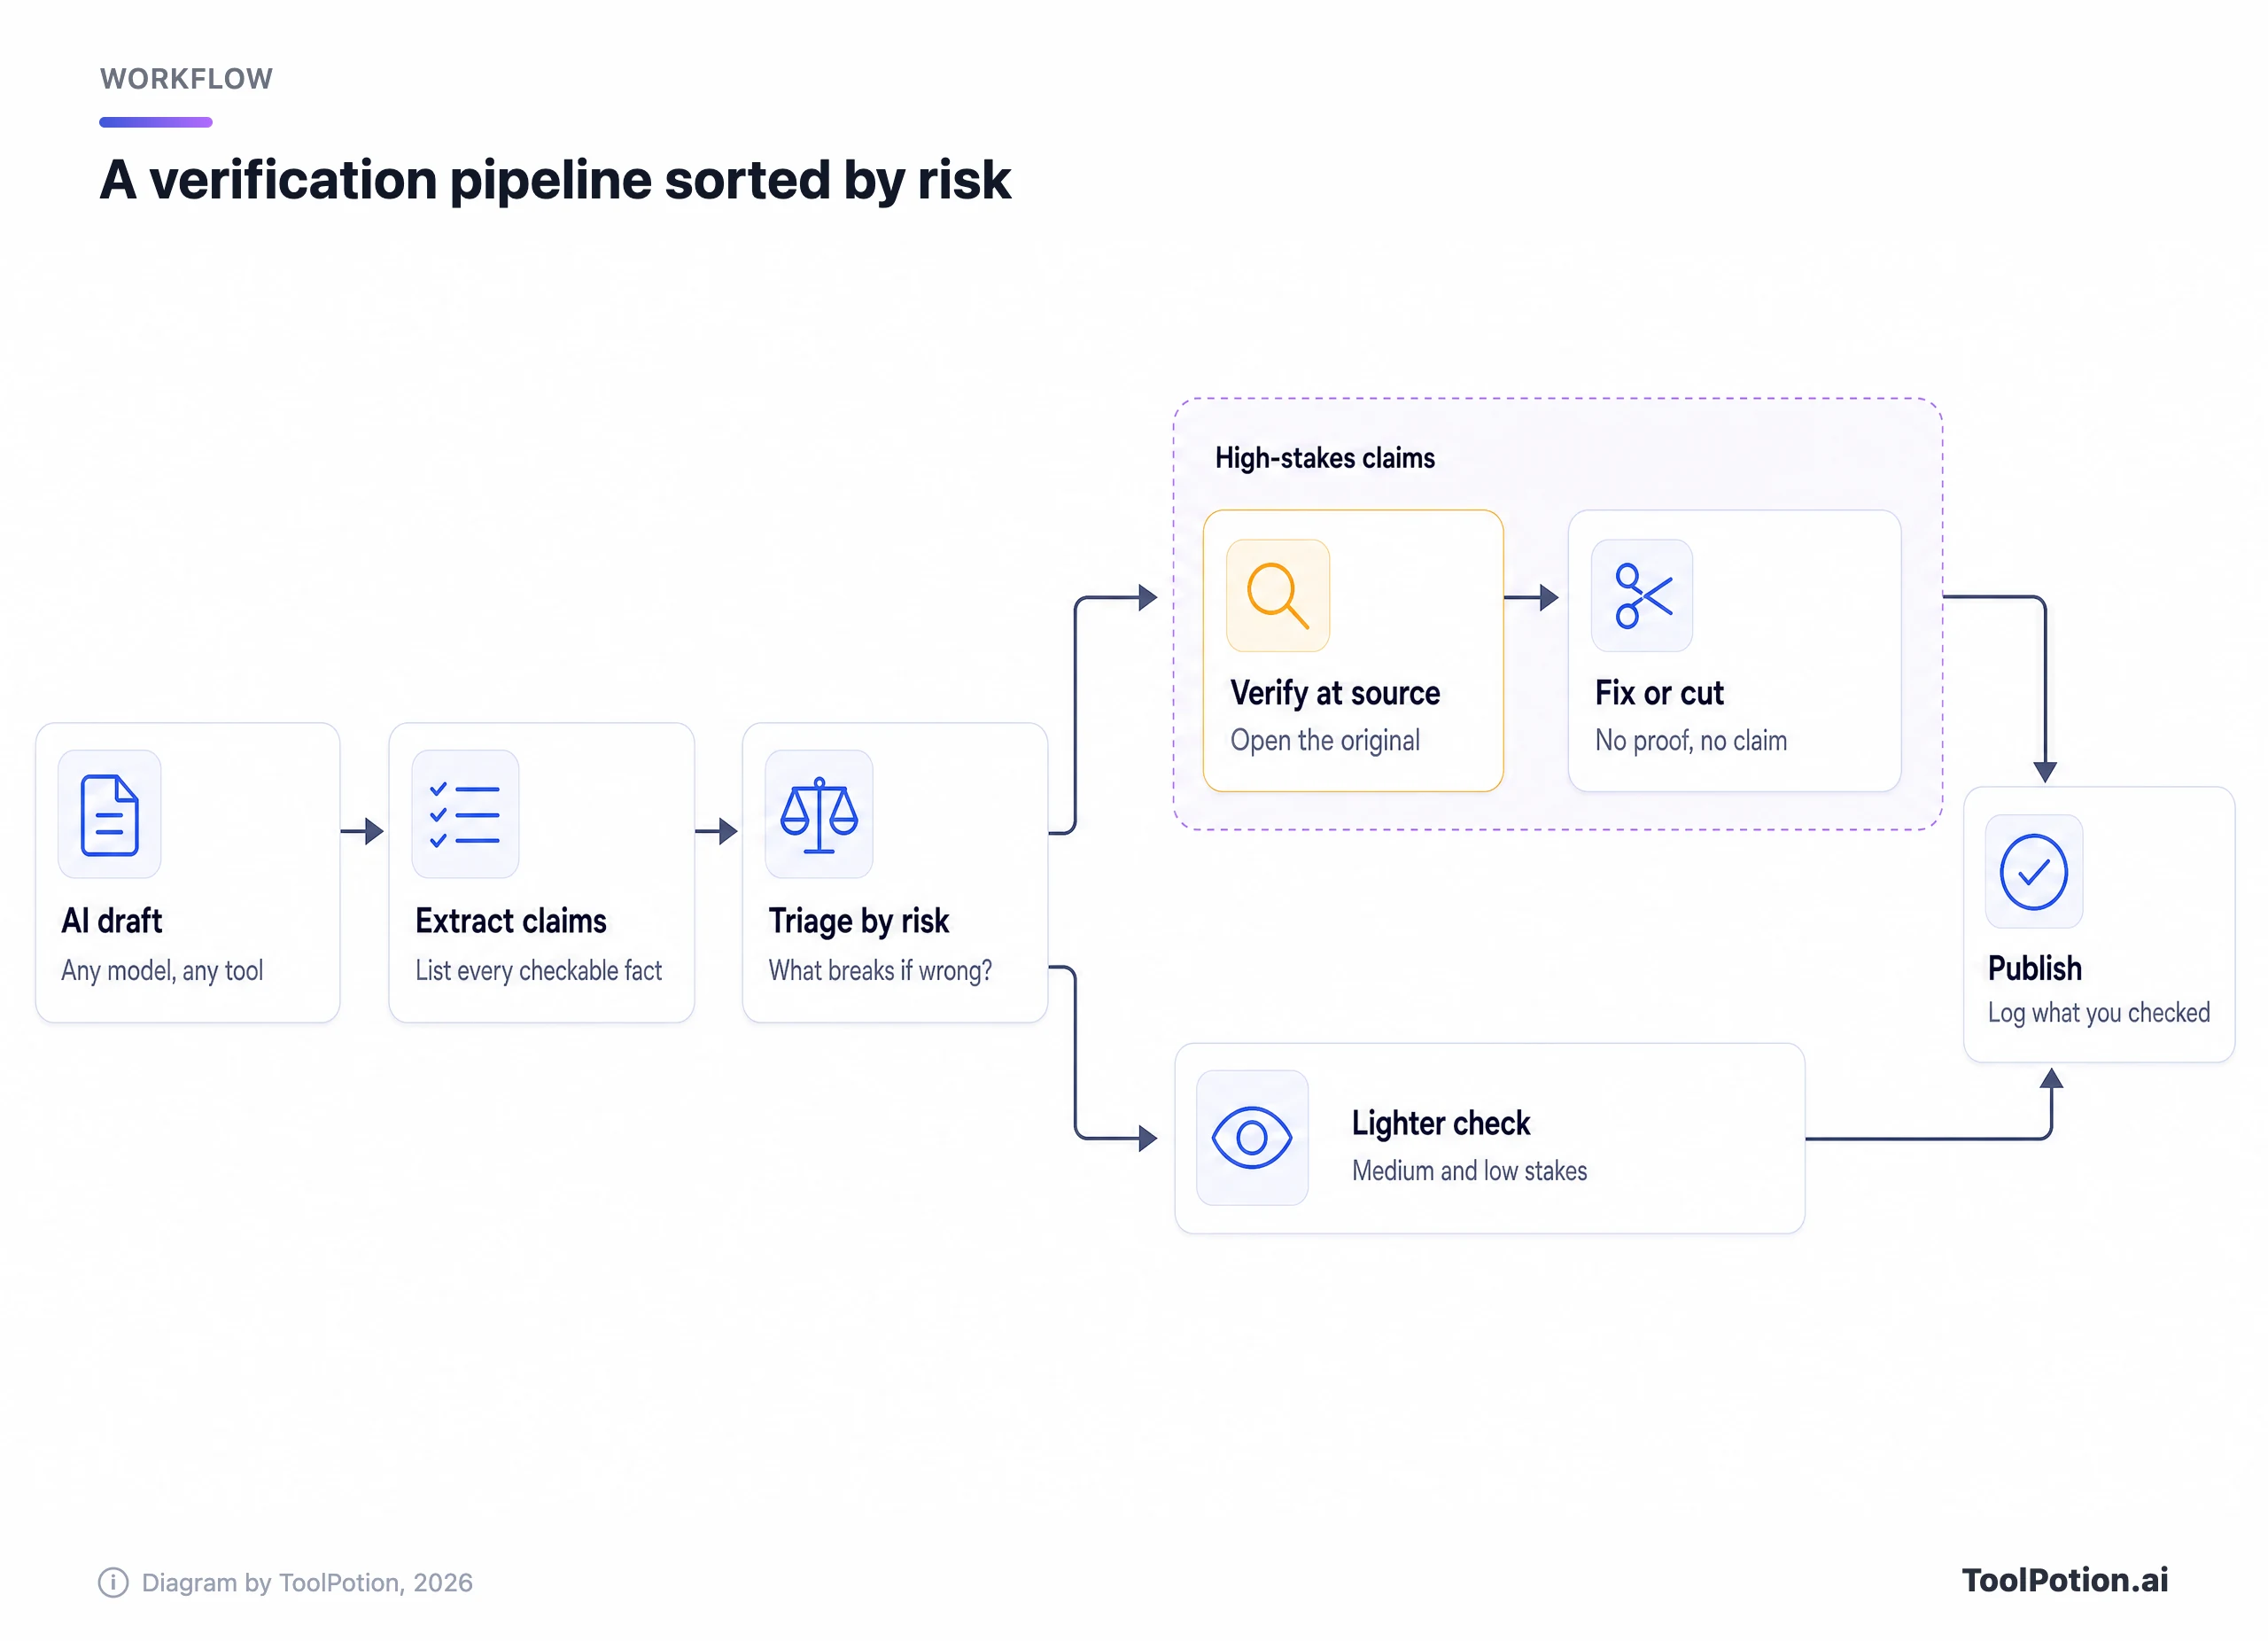
- Extraia as afirmações. Peça a um modelo que liste toda declaração verificável no rascunho: nomes, números, datas, citações, referências e relações de causa e efeito. Você vai encontrar afirmações que nem percebeu que estava fazendo.
- Faça a triagem pelo risco. Pergunte o que acontece se cada afirmação estiver errada. Tudo que for jurídico, médico ou financeiro é de alto risco, assim como toda referência, toda citação direta, qualquer estatística no título ou no resumo e qualquer afirmação sobre uma pessoa ou empresa nomeada. Contexto de apoio que um leitor pode repetir é de risco médio. Enquadramento que você defenderia de cabeça é de baixo risco.
- Verifique o nível alto na fonte primária: a decisão judicial, o processo, o conjunto de dados, a página da própria empresa, o artigo em si. Uma reportagem sobre um estudo não é o estudo.
- Faça uma checagem por amostragem do nível médio com leitura lateral, explicada abaixo, e dê ao nível baixo uma leitura de editor.
- Corrija, suavize ou corte. Se você não consegue confirmar uma afirmação no tempo que ela merece, remova-a ou atribua-a claramente ("segundo o fornecedor"). Nunca mantenha uma afirmação só porque ela soa certa.
- Mantenha um registro. Uma linha por afirmação de alto risco, com a afirmação, a fonte e o ponto dela em que está o respaldo, leva minutos e responde à pergunta que um editor, cliente ou juiz acabará fazendo.
Ajuste o esforço à distância que a saída vai percorrer. Um brainstorm pede uma leitura cuidadosa. Uma entrega para cliente exige que toda afirmação de alto risco seja aberta na fonte. Se a conta da checagem parecer grande demais, o rascunho provavelmente tem afirmações demais, e cortar costuma ser mais rápido do que verificar.
Não sabe em que nível uma saída se encaixa? Responda até três perguntas abaixo.
Repare no que a árvore pergunta: para onde a saída vai e o que ela contém, nunca qual modelo a escreveu. Um modelo mais forte muda as probabilidades. Não muda quem responde pelo erro.
Como checar citações, falas e números
Cada tipo de afirmação tem seu teste rápido. Nenhum exige software especial, só a disciplina de sair do chatbot e abrir o original.
Citações e referências
Verifique primeiro a existência. Busque o título, o DOI, o número do processo ou a URL em uma base de dados ou buscador que você controla, nunca no chatbot que a produziu. Depois verifique o respaldo: abra a fonte e encontre o trecho que sustenta a frase. Se você não achar em alguns minutos, a citação falha. Fique de olho também na versão. O Tow Center constatou que as ferramentas de busca com IA muitas vezes apontavam para cópias distribuídas em vez do veículo original, e um preprint pode diferir do artigo publicado.
Falas e citações diretas
Busque entre aspas uma expressão distintiva de cinco ou seis palavras. Se ela não aparecer em lugar nenhum, ou só em páginas que parecem escritas por máquina, trate a fala como inventada. Se for real, leia o parágrafo em volta e confirme quem falou, quando e o sentido. Uma fala verdadeira tirada do contexto engana tanto quanto uma falsa.
Números
Recalcule tudo o que puder. Confirme a unidade (percentual ou pontos percentuais, mensal ou anual, qual moeda), o ano e o denominador. Se o rascunho diz que um valor dobrou, encontre os dois números. Uma estatística sem fonte nomeada não entra, por mais plausível que pareça.
Eventos recentes e alegações virais
Confira a data de cada fonte e prefira reportagens publicadas depois do evento. Para uma alegação que já circula online, o Fact Check Explorer do Google busca checagens publicadas e mostra qual organização avaliou a alegação e como. Você também pode enviar uma imagem para ver se ela já foi checada antes.
Antes de publicar, passe o rascunho por este checklist. Os quatro primeiros itens valem em dobro.
O peso segue os dados dos tribunais: citações inventadas, fontes distorcidas e falas falsas ocupam a maior parte desse banco de dados. Se essas quatro caixas ficarem vazias, nada mais na lista torna o rascunho seguro para enviar.
Leitura lateral para afirmações sem rastro documental
Algumas afirmações chegam sem nenhuma citação para abrir. Nesses casos, adote o hábito dos checadores profissionais. O grupo Civic Online Reasoning, de Stanford, depois de observar checadores trabalhando, concluiu que "a melhor maneira de aprender sobre um site é a leitura lateral": saia da página e veja o que outras fontes dizem sobre ela, em vez de estudar a própria página.
Mike Caulfield transformou esse hábito numa rotina de quatro passos chamada SIFT (Caulfield). Ela se encaixa bem em respostas de IA, com um ajuste: a fonte que você investiga é o chatbot mais o link que ele escolheu.
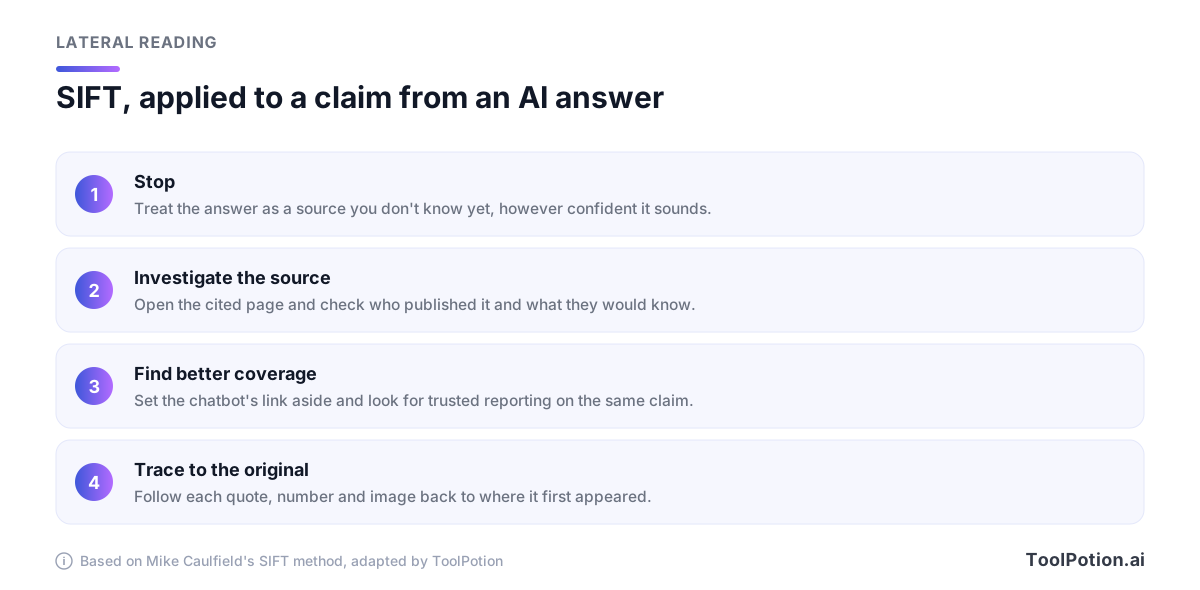
O terceiro passo é o que mais rende com chatbots. Quando a afirmação importa mais do que o artigo que a trouxe, o conselho de Caulfield é "ignorar a fonte que chegou até você e procurar reportagens ou análises confiáveis sobre a afirmação". Então busque a afirmação do zero, com suas próprias palavras. Se algo que deveria ter ampla cobertura não tem nenhuma cobertura independente, você já tem a resposta.
A leitura lateral também resolve as fontes que um modelo encontra por conta própria. Uma URL real num site que você nunca ouviu falar é uma fonte fraca, por mais bem formatada que a IA tenha deixado a referência.
Prompts que facilitam a verificação
Você não elimina alucinações com prompt, mas pode moldar a saída para que os erros sejam mais fáceis de pegar. A documentação dos próprios fornecedores é o melhor guia. A Anthropic diz que as técnicas que recomenda "reduzem significativamente as alucinações", mas "não as eliminam por completo" (Anthropic docs). Para hábitos mais amplos de prompting, veja nosso guia prático de prompt engineering.
Dê permissão para dizer que não sabe
Tanto a Anthropic quanto o Perplexity orientam os desenvolvedores a permitir explicitamente que o modelo admita incerteza ou diga que não encontrou nada. A pesquisa da OpenAI mostra por que isso importa. Na comparação no benchmark SimpleQA, um modelo que se absteve em 52% das perguntas errou 26%, enquanto um que se absteve em 1% errou 75%, com precisão quase idêntica. Use isto como instrução permanente:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
Peça as citações antes das conclusões
A documentação da Anthropic recomenda extrair citações literais de documentos longos antes de fazer a tarefa e, depois, pedir ao modelo que encontre uma citação de apoio para cada afirmação e retire qualquer uma que não consiga sustentar. Na prática, fica assim:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
Faça-o sinalizar quase-acertos e não force a brevidade
O guia do Perplexity acrescenta uma regra que vale copiar: "Se encontrar resultados relacionados, mas que não correspondem (por exemplo, um ano diferente, uma empresa controladora ou uma subsidiária), declare explicitamente a divergência antes de responder." Isso pega o fato certo sobre a entidade errada, um dos erros mais difíceis de notar a olho nu. As regras de exemplo do guia também mandam o modelo citar as fontes pelo domínio e "não escrever URLs completas".
O tamanho da resposta também importa. A Giskard, empresa de testes de IA sediada em Paris, constatou que pedir respostas concisas ao GPT-4o, ao Mistral Large e ao Claude 3.7 Sonnet os deixava menos precisos, porque "quando forçados a ser breves, os modelos escolhem consistentemente a brevidade em vez da precisão". O mesmo estudo descobriu que os modelos tinham menos probabilidade de contestar uma afirmação polêmica quando o usuário a apresentava com confiança. Formule as perguntas de forma neutra, "É verdade que X?", em vez de pressupor a afirmação, como em "Explique por que X."
Extraia as afirmações e rode duas vezes
Este prompt alimenta o primeiro passo do fluxo. Rode-o em qualquer rascunho, inclusive um que você mesmo escreveu.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
A Anthropic também sugere a checagem best-of-N: rode o mesmo prompt várias vezes e compare, já que respostas inconsistentes apontam prováveis alucinações. É o mesmo sintoma que a OpenAI viu com os três títulos de tese. A divergência entre as execuções mostra onde olhar. A concordância não prova nada.
Ferramentas baseadas em fontes ajudam, até certo ponto
Uma outra classe de ferramentas restringe aquilo em que o modelo pode se basear. Isso transforma "isso é verdade?" em "a fonte diz isso?", uma checagem mais rápida. Não elimina a checagem.
O Google renomeou o NotebookLM para Gemini Notebook no início do ano e o manteve como uma ferramenta de pesquisa independente, que segundo o Google mais de 30 milhões de pessoas usam (Google). No chat, ele responde a partir das fontes que você adiciona e "usa citações diretas, textos e imagens das suas fontes como referências". Passe o mouse sobre uma citação para ver o texto citado ou clique para ir até ele no contexto (Gemini Notebook Help). Isso torna rápidas as checagens de respaldo. Conheça também as lacunas: as páginas de ajuda do Google dizem que páginas da web com paywall não são compatíveis e que notas de rodapé e comentários em arquivos do Google não são importados. Os recursos de chat agêntico mais novos, que podem pesquisar na web e executar código, são marcados como experimentais, com a instrução "Confira tudo duas vezes."
Motores de resposta como o Perplexity anexam links a cada resposta, um avanço real em relação a um chatbot sem fontes. Os links ainda precisam ser abertos. O Perplexity errou 37% das consultas no teste de 2025 do Tow Center (as ferramentas mudaram desde então), e a própria ajuda do Gemini, do Google, observa que "nem todas as respostas incluem links ou fontes relacionados".
Para afirmações de pesquisa, as ferramentas de busca acadêmica fundamentam as respostas em artigos, e não na web aberta. O Consensus busca na literatura revisada por pares e diz que, se "não encontrar evidências relevantes suficientes, vai avisar", em vez de preencher as lacunas. O Elicit diz que respalda toda afirmação gerada por IA com citações em nível de frase. O Scite mostra se pesquisas posteriores confirmaram ou contradisseram as conclusões de um artigo, o que pega uma falha que as outras deixam passar: um estudo real que já foi contestado.
Se você monta o seu próprio pipeline, a Citations API da Anthropic retorna o trecho exato por trás de cada afirmação, e a documentação da Anthropic diz que essas citações têm "garantia de conter ponteiros válidos para os documentos fornecidos". Isso descarta fontes inventadas. Não confirma que o trecho sustenta a frase à qual está ligado. Os verificadores de referências ficam no fim da linha. O GPTZero oferece um detector de alucinações que examina bibliografias, e sua equipe sinalizou o relatório da KPMG e, no início do ano, encontrou 100 citações alucinadas em 51 artigos aceitos na NeurIPS, uma das principais conferências de IA, segundo o TechCrunch.
| Tipo de ferramenta | Fundamenta as respostas em | O que você ainda confere |
|---|---|---|
| Ferramentas de notebook (Gemini Notebook) | Fontes que você envia | Se cada trecho citado sustenta a afirmação e se as suas fontes estão certas |
| Motores de resposta (Perplexity, ChatGPT com busca) | Resultados da web ao vivo | Abra todos os links, confira a data e encontre o veículo original |
| Busca de pesquisa (Consensus, Elicit, Scite) | Artigos acadêmicos | As conclusões reais do artigo, seus limites e qualquer trabalho posterior que o contradiga |
| APIs de citação (Claude Citations) | Documentos que você fornece | Se há respaldo para a afirmação, além de um ponteiro válido |
| Verificadores de referências (GPTZero) | Registros bibliográficos | Se uma referência real diz o que o rascunho afirma |
Para comparar opções, navegue pelo ranking de assistentes de pesquisa com IA, pelo ranking de mecanismos de busca com IA e pelo ranking de busca de literatura acadêmica. Nossos comparativos de assistentes de pesquisa com IA e de mecanismos de busca com IA detalham recursos e preços.
Perguntas frequentes
Posso usar um modelo de IA para checar os fatos de outro?
Como primeira passada, sim. Um segundo modelo, principalmente um com busca, vai apontar alguns erros que o primeiro deixou passar, e as divergências mostram onde olhar. Ele não consegue confirmar nada, já que os dois podem ter as mesmas lacunas. Trate os alertas dele como uma lista de tarefas e resolva cada um na fonte. Se você está escolhendo um segundo assistente, nosso guia de alternativas ao ChatGPT compara as principais opções.
Os detectores de IA checam fatos?
Não. Ferramentas como o Originality.ai detector estimam se um texto foi escrito por máquina. Isso não diz nada sobre se uma afirmação é verdadeira, e um rascunho escrito por humano pode estar tão errado quanto. Checar fatos exige a fonte original.
Quanto tempo deve levar a checagem de um rascunho de IA?
Depende de quantas afirmações de alto risco o rascunho contém, não do tamanho dele. Conte-as depois da triagem. Um texto explicativo de 2.000 palavras com quatro estatísticas e duas falas é um trabalho curto, enquanto um memorando de uma página cheio de citações não é.
Posso citar o ChatGPT ou outro chatbot como fonte?
Não para fatos. O próprio conselho da OpenAI é "usar o ChatGPT como um primeiro rascunho, não como fonte final". Cite o documento original que você verificou. Se a saída da IA for o próprio objeto do texto, como em um teste de modelo, diga qual modelo você usou e quando.
Os agentes de deep research tornam a checagem desnecessária?
Não. Agentes como o deep research da OpenAI compilam relatórios de pesquisa com citações de muitas fontes da web, o que te dá mais citações para abrir, não menos afirmações para checar. O problema da fonte distorcida vale para cada frase citada, então a triagem importa mais à medida que os relatórios ficam mais longos.