

“Não afirmamos entender completamente a prova ainda.” A frase vem do comitê que a OpenAI nomeou para avaliar seu suposto resultado sobre Yang-Mills, citado pela Scientific American. O grupo, liderado pelo físico David Gross, tinha acabado de confirmar que a prova de uma das metades do problema passa na verificação em Lean, uma linguagem de programação que checa trabalho matemático. Ainda assim, ele não soube explicar como a prova funciona.
Lemos o material mais recente sobre IA para ciência: esse artigo, cinco posts da Anthropic, um benchmark de laboratório experimental da OpenAI, a TechCrunch sobre uma startup chamada PSI e o post de um blogueiro cujos agentes de IA apontaram um sítio maia ausente do registro oficial do México. As manchetes correm bem à frente de tudo isso. Então pegamos seis afirmações populares e checamos cada uma contra o que as fontes realmente dizem.
Afirmação 1: a IA já está descobrindo ciência nova sozinha
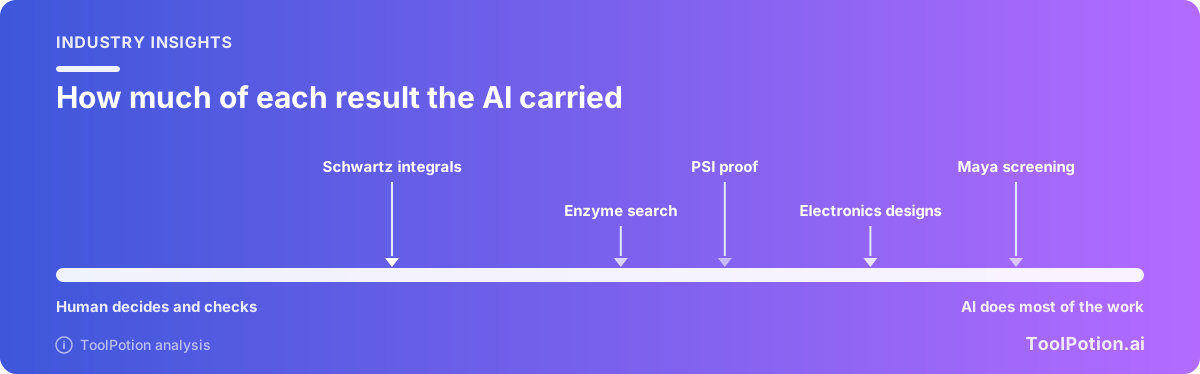
Veredito: sozinha, não. Os melhores casos são reais, e em todos eles uma pessoa escolheu a pergunta, executou as verificações, ou ambos.
Comecemos pela biologia. A Anthropic diz que agentes do Claude encontraram um sistema enzimático com repetições parecidas com as do CRISPR, usando cerca de 950 agentes, 210 milhões de tokens e 21 horas (Anthropic). Um agente identificou o padrão de repetição. Os cientistas da Anthropic forneceram o prompt inicial e fizeram todo o trabalho de laboratório, a maioria dos candidatos do Claude foi eliminada na revisão, e o artigo é um preprint. O trabalho sobre a função principal do sistema ainda está em andamento. O post diz que o Claude “parece ser o primeiro a notar” as características definidoras do sistema e que ele “consegue detectar anomalias de forma autônoma”: justo para a etapa de busca, não para o resto. Feng Zhang, do MIT e do Broad Institute, citado no mesmo post depois de ler o preprint, chamou o trabalho de “um exemplo empolgante de como agentes de IA podem contribuir para a descoberta biológica” e disse que a descoberta “merece investigação adicional”.
O físico Matthew Schwartz, pesquisador visitante na Anthropic, é mais franco que a maioria. Em um post como convidado da Anthropic, ele relata 30 integrais executadas de ponta a ponta com o Claude, 15 reproduzindo resultados conhecidos e 15 nunca calculadas antes (Anthropic). Ele chama os bons alvos de problemas “sob medida para o Claude” e acrescenta que “pode dar muito trabalho conduzi-los pela mão para produzirem algo de valor científico”. Depois de chamar especialistas externos, ele constatou que “em quase todos os casos, o Claude estava tecnicamente correto, mas o resultado não era tão interessante até o especialista ajudar a orientar o trabalho”. O Claude, diz ele, “parece favorecer debates antigos, muito citados mas há muito esquecidos”. O julgamento sobre o que vale a pena resolver ficou com os humanos.
Agora a PSI. A TechCrunch relata que David Turturean, membro da equipe técnica do laboratório startup Physical Superintelligence (PSI), usou acesso antecipado ao modelo Fable 5.2 da Anthropic para resolver um problema de 18 anos da computação quântica, a conjectura de Aaronson-Ambainis (TechCrunch). Scott Aaronson, que propôs o problema, escreve que não entende bem a prova, mas acredita que ela está correta porque foi autoformalizada em Lean e explicada por uma equipe de pesquisadores de ponta com quem a PSI a compartilhou. A descrição do próprio Turturean é modesta: “É um resultado negativo que permite às pessoas saber: ok, não vamos mais procurar ali.” A solução parece fechar um caminho para ganhos de velocidade na computação quântica, não todos.
Chamaríamos isso de um colaborador rápido e incansável que precisa de outra pessoa para escolher o problema. Já é muita coisa. Não é autonomia, e os próprios posts das empresas dizem isso, se você ler até as ressalvas.
Afirmação 2: os resultados são verificados
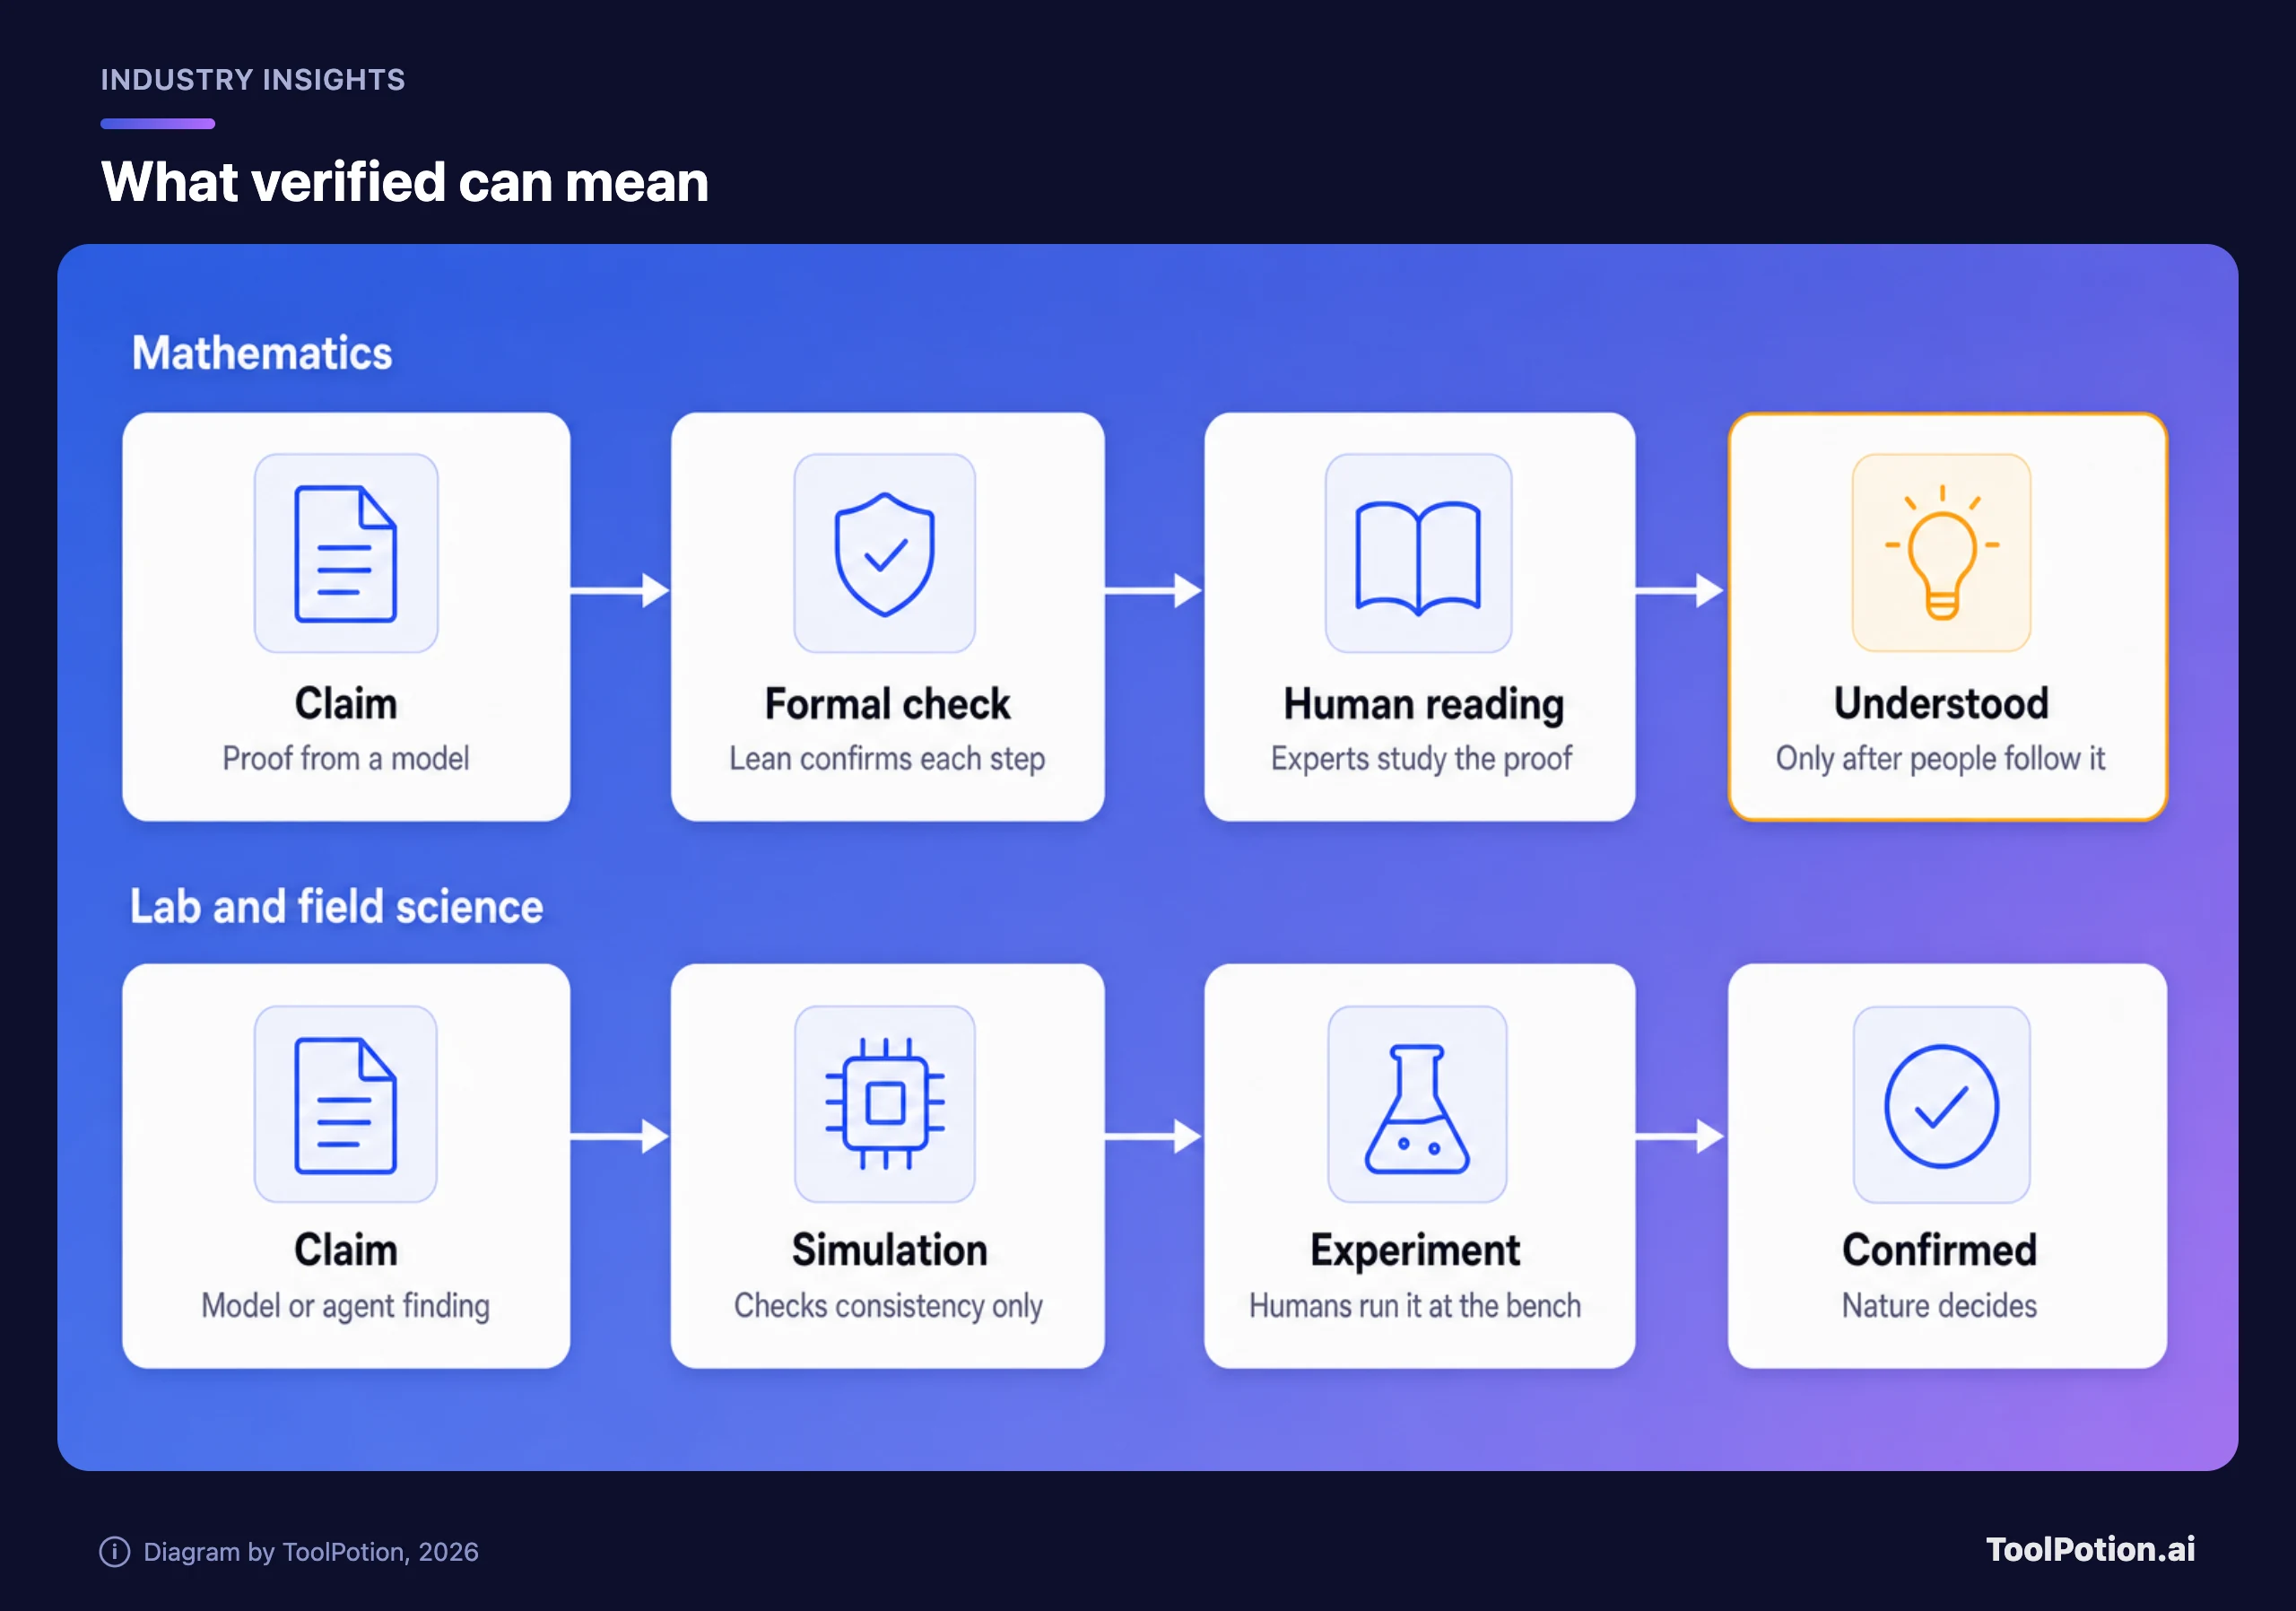
Veredito: em parte. Um verificador formal é um teste forte em matemática. Em outras áreas, “verificado” pode significar qualquer coisa, de uma simulação a uma consulta em registro.
Em matemática, o Lean consegue confirmar mecanicamente que uma prova decorre do enunciado que recebeu. É uma checagem forte, e é por isso que os resultados da PSI e da OpenAI estão sendo levados a sério. Mas a reportagem da Scientific American mostra os limites. A afirmação da OpenAI cobre a metade de existência do problema de Yang-Mills; a outra metade, a do mass gap, continua sem solução. O comitê usou o próprio modelo Astra da OpenAI para ajudar a digerir o código Lean e diz abertamente que ainda não afirma entender a prova.
Depois, há a questão da abertura. A Scientific American observa que a abordagem de “pastoreio” contradiz recomendações de transparência de um grupo consultivo ligado à OpenAI e irritou alguns matemáticos, que a veem como gatekeeping. A prova em Lean agora é pública. Scott Armstrong, da NYU, disse estar feliz por ela finalmente ter saído e acrescentou: “Essa revisão pode ser feita de forma mais eficiente e rápida às claras” (Scientific American). Concordamos com ele. Uma prova que só o comitê indicado pela OpenAI tinha visto era uma afirmação esperando revisão, e a revisão enfim pode começar.
Fora da matemática, não existe Lean. O CEO da PSI, Matt Pines, disse à TechCrunch que a física difere da matemática porque “a natureza tem voto nos seus modelos da realidade” e que a física teórica feita por máquinas “ainda não chegou lá, mas está a caminho”. Schwartz constatou que “as verificações automatizadas ainda não são confiáveis”. E o post sobre os maias, ao qual voltaremos, recebeu uma resposta oficial: o instituto mexicano não encontrou nenhum sítio registrado no local informado. Isso confirma a ausência em um registro. Não confirma a existência de um sítio.
Afirmação 3: agentes conseguem tocar um laboratório
Veredito: ainda não. Eles conseguem planejar, projetar e analisar. Pipetar e soldar ainda é com gente.
O post da Anthropic sobre eletrônicos é o exemplo recente mais forte, e vale a leitura completa. Trabalhando com a fabricante de placas Diode (a Anthropic diz ter uma relação comercial com a empresa), o Claude (modelo Fable 5.2) projetou um viva-voz USB-C, um hub de assistente de voz e um bichinho virtual portátil, do esquemático ao layout e ao firmware (Anthropic). Os engenheiros da Diode fabricaram as placas a partir dos arquivos de projeto do Claude e montaram e testaram os protótipos à mão, porque o Claude não estava conectado a equipamentos de teste nem às máquinas que fazem placas de circuito. Os dispositivos não passaram por validação elétrica, ajuste de antena, testes térmicos nem certificação. O post também cita ganhos em benchmark (69% no teste interno de layout PCB Gym da Diode, contra 25% do modelo anterior), que são números da Anthropic em um teste executado a pedido dela, e mostra o custo apenas no eixo de um gráfico, não no texto.
Do lado da biologia, a OpenAI publicou o BioBasicsBench, um benchmark de 100 tarefas que, segundo ela, mede quão bem agentes de IA interpretam dados experimentais brutos e lidam com a ciência cotidiana de bancada (OpenAI). É um teste criado pelo fornecedor, e benchmark é só uma afirmação até que gente de fora do fornecedor o execute.
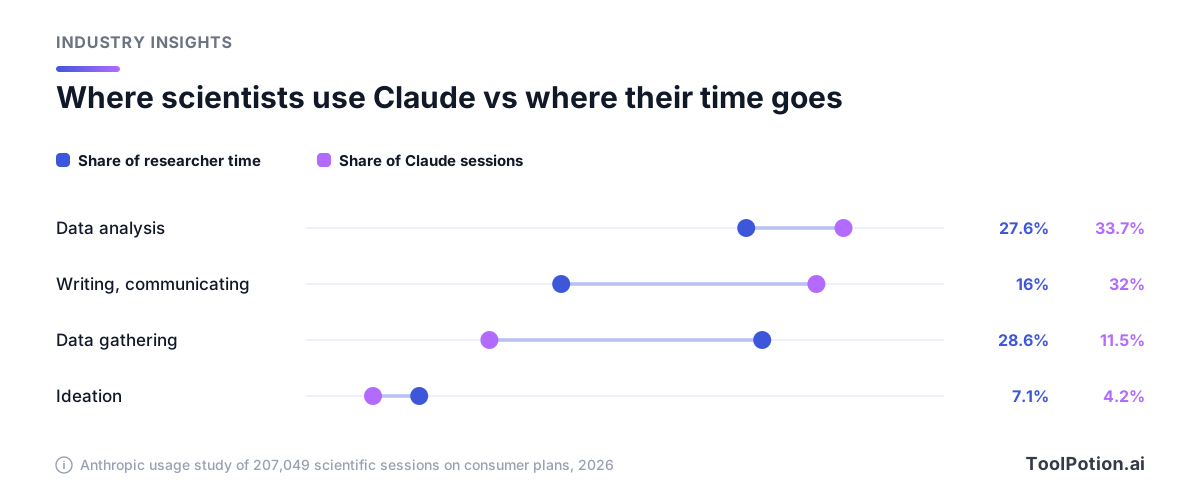
O estudo de uso da Anthropic, com 207.049 sessões científicas em planos para consumidores, mostra o mesmo padrão na prática. A coleta de dados ocupa 28,6% do tempo dos pesquisadores, mas apenas 11,5% das sessões no Claude, e a diferença é maior onde há barreiras físicas, como a coleta de dados clínicos ou bioquímicos (Anthropic). Nas palavras do próprio estudo: “gargalos físicos continuam poderosos”.
Afirmação 4: qualquer pessoa consegue fazer isso agora
Veredito: qualquer um consegue começar. Chegar a algo que se sustente exige alguém que conheça a área.
A história dos maias é o teste mais limpo. Pietro Miotti, que diz não ser arqueólogo, apontou 48 agentes para cerca de 1.200 quilômetros quadrados de lidar público da NASA e obteve um sítio no topo de uma colina, com praça e pirâmide, e depois uma resposta oficial, em menos de 72 horas (post dele). A descrição do método é admiravelmente simples: “Não houve nenhum modelo especial ou classificador: os agentes literalmente olharam as imagens.”
Depois veio a correção, que agora está no topo da página. “Os agentes não perceberam isso ao percorrer a literatura, então o redescobriram em vez de descobri-lo.” O sítio já tinha sido mapeado em um artigo de 2025 de Estrada-Belli e colegas; só não constava ainda no registro mexicano. Mérito de Miotti por colocar isso em primeiro lugar. Ele também diz que não fala espanhol e confiou na tradução do relatório feita pelos agentes, que a história do período Clássico é “especulação, vinda de uma longa conversa com os agentes” e que a imagem da reconstrução foi gerada por IA. Nenhum levantamento de campo é descrito.
Nossa leitura: é uma boa demonstração de triagem barata e uma péssima demonstração de descoberta. Olhar agora é quase de graça. Saber se alguém já olhou antes ainda exige um especialista, ou ao menos uma busca na literatura que os agentes não fizeram direito. O caminho da PSI foi diferente e instrutivo: ela segurou o resultado até o modelo da Anthropic estar quase pronto para lançamento e usou esse tempo para mostrá-lo a pesquisadores capazes de explicá-lo. Jim Halverson, professor da Northeastern que assessora a PSI, disse à TechCrunch que “as melhores práticas ainda estão surgindo”.
Afirmação 5: os cientistas estão prestes a ser automatizados
Veredito: não comprovado, e as afirmações mais barulhentas vêm de quem tem interesse nelas.
Turturean disse à TechCrunch: “Aceito totalmente a ideia de que este talvez seja o último artigo que eu publico.” Pines disse que, seis a nove meses atrás, ao conversar com investidores, ele “tinha que forçar um pouco a barra” para dizer que a física teórica logo seria domínio majoritário das máquinas, e que isso “ainda não chegou lá”. A pesquisa da Anthropic diz que cerca de 40% de 528 pesquisadores esperam que a IA conduza projetos de pesquisa completos por conta própria até 2030, mas eles foram recrutados entre os candidatos aos programas de bolsas AI for Science da própria Anthropic, então provavelmente usam IA mais do que a maioria (Anthropic).
Os números modelados são menores. A modelagem da Anthropic diz que as capacidades atuais, se amplamente adotadas, poderiam assumir de 27 a 52% do tempo de pesquisador necessário para um novo estudo, o que implica uma produção crescendo de 1,35x nas artes até 2,02x em estatística. O cenário hipotético do relatório, em que a IA automatiza todo o trabalho não físico, chega a cerca de 15x em estatística e ciência da computação, mas só 3 a 4x em ciências de bancada como biologia e química, onde as etapas físicas continuam sendo o gargalo. Isso é um cenário, não uma medição. Mesmo o caso modesto é uma grande mudança para uma área. Não é substituição, e o relatório observa que o trabalho de IA hoje é majoritariamente de assistência ou compartilhado. Sobre quem fica com o crédito, Schwartz diz melhor do que nós: isso “não será resolvido fingindo que a contribuição humana foi digitar”.
Afirmação 6: se o modelo da IA se ajusta aos dados, entendemos o sistema
Veredito: falso, e os autores que constroem esses sistemas dizem isso.
Um post convidado de um grupo de Tübingen (Jakob Macke, Daniel Gedon e Stefan Wahl, todos bolsistas AI for Science da Anthropic) sobre ensinar a IA a construir modelos científicos faz o argumento com cuidado. Muitos modelos se ajustam aos mesmos dados, então o resultado útil é um leque de modelos plausíveis e uma lista do que eles têm em comum (Anthropic). Eles admitem que esses sistemas “foram testados, na maior parte, na redescoberta de modelos que os cientistas já conhecem”, com poucas evidências em problemas sem resposta conhecida. E escrevem: “Um sistema de IA que apenas lhe entrega o modelo pode até lhe dar uma resposta, mas não lhe dá compreensão.”
Achamos que essa última frase deveria estar colada em cima de toda bancada de laboratório e de toda mesa de estudante. Um ajuste é um número. Uma explicação é algo que uma pessoa pode usar para prever o que acontece a seguir.
Uma rotina para pesquisadores e estudantes
Nada disso quer dizer que você não deva usar essas ferramentas. Os dados de uso da Anthropic sugerem que os cientistas já as usam onde funcionam melhor, principalmente em análise e escrita. Esta é a rotina que seguiríamos, construída a partir do que deu errado nos casos acima.
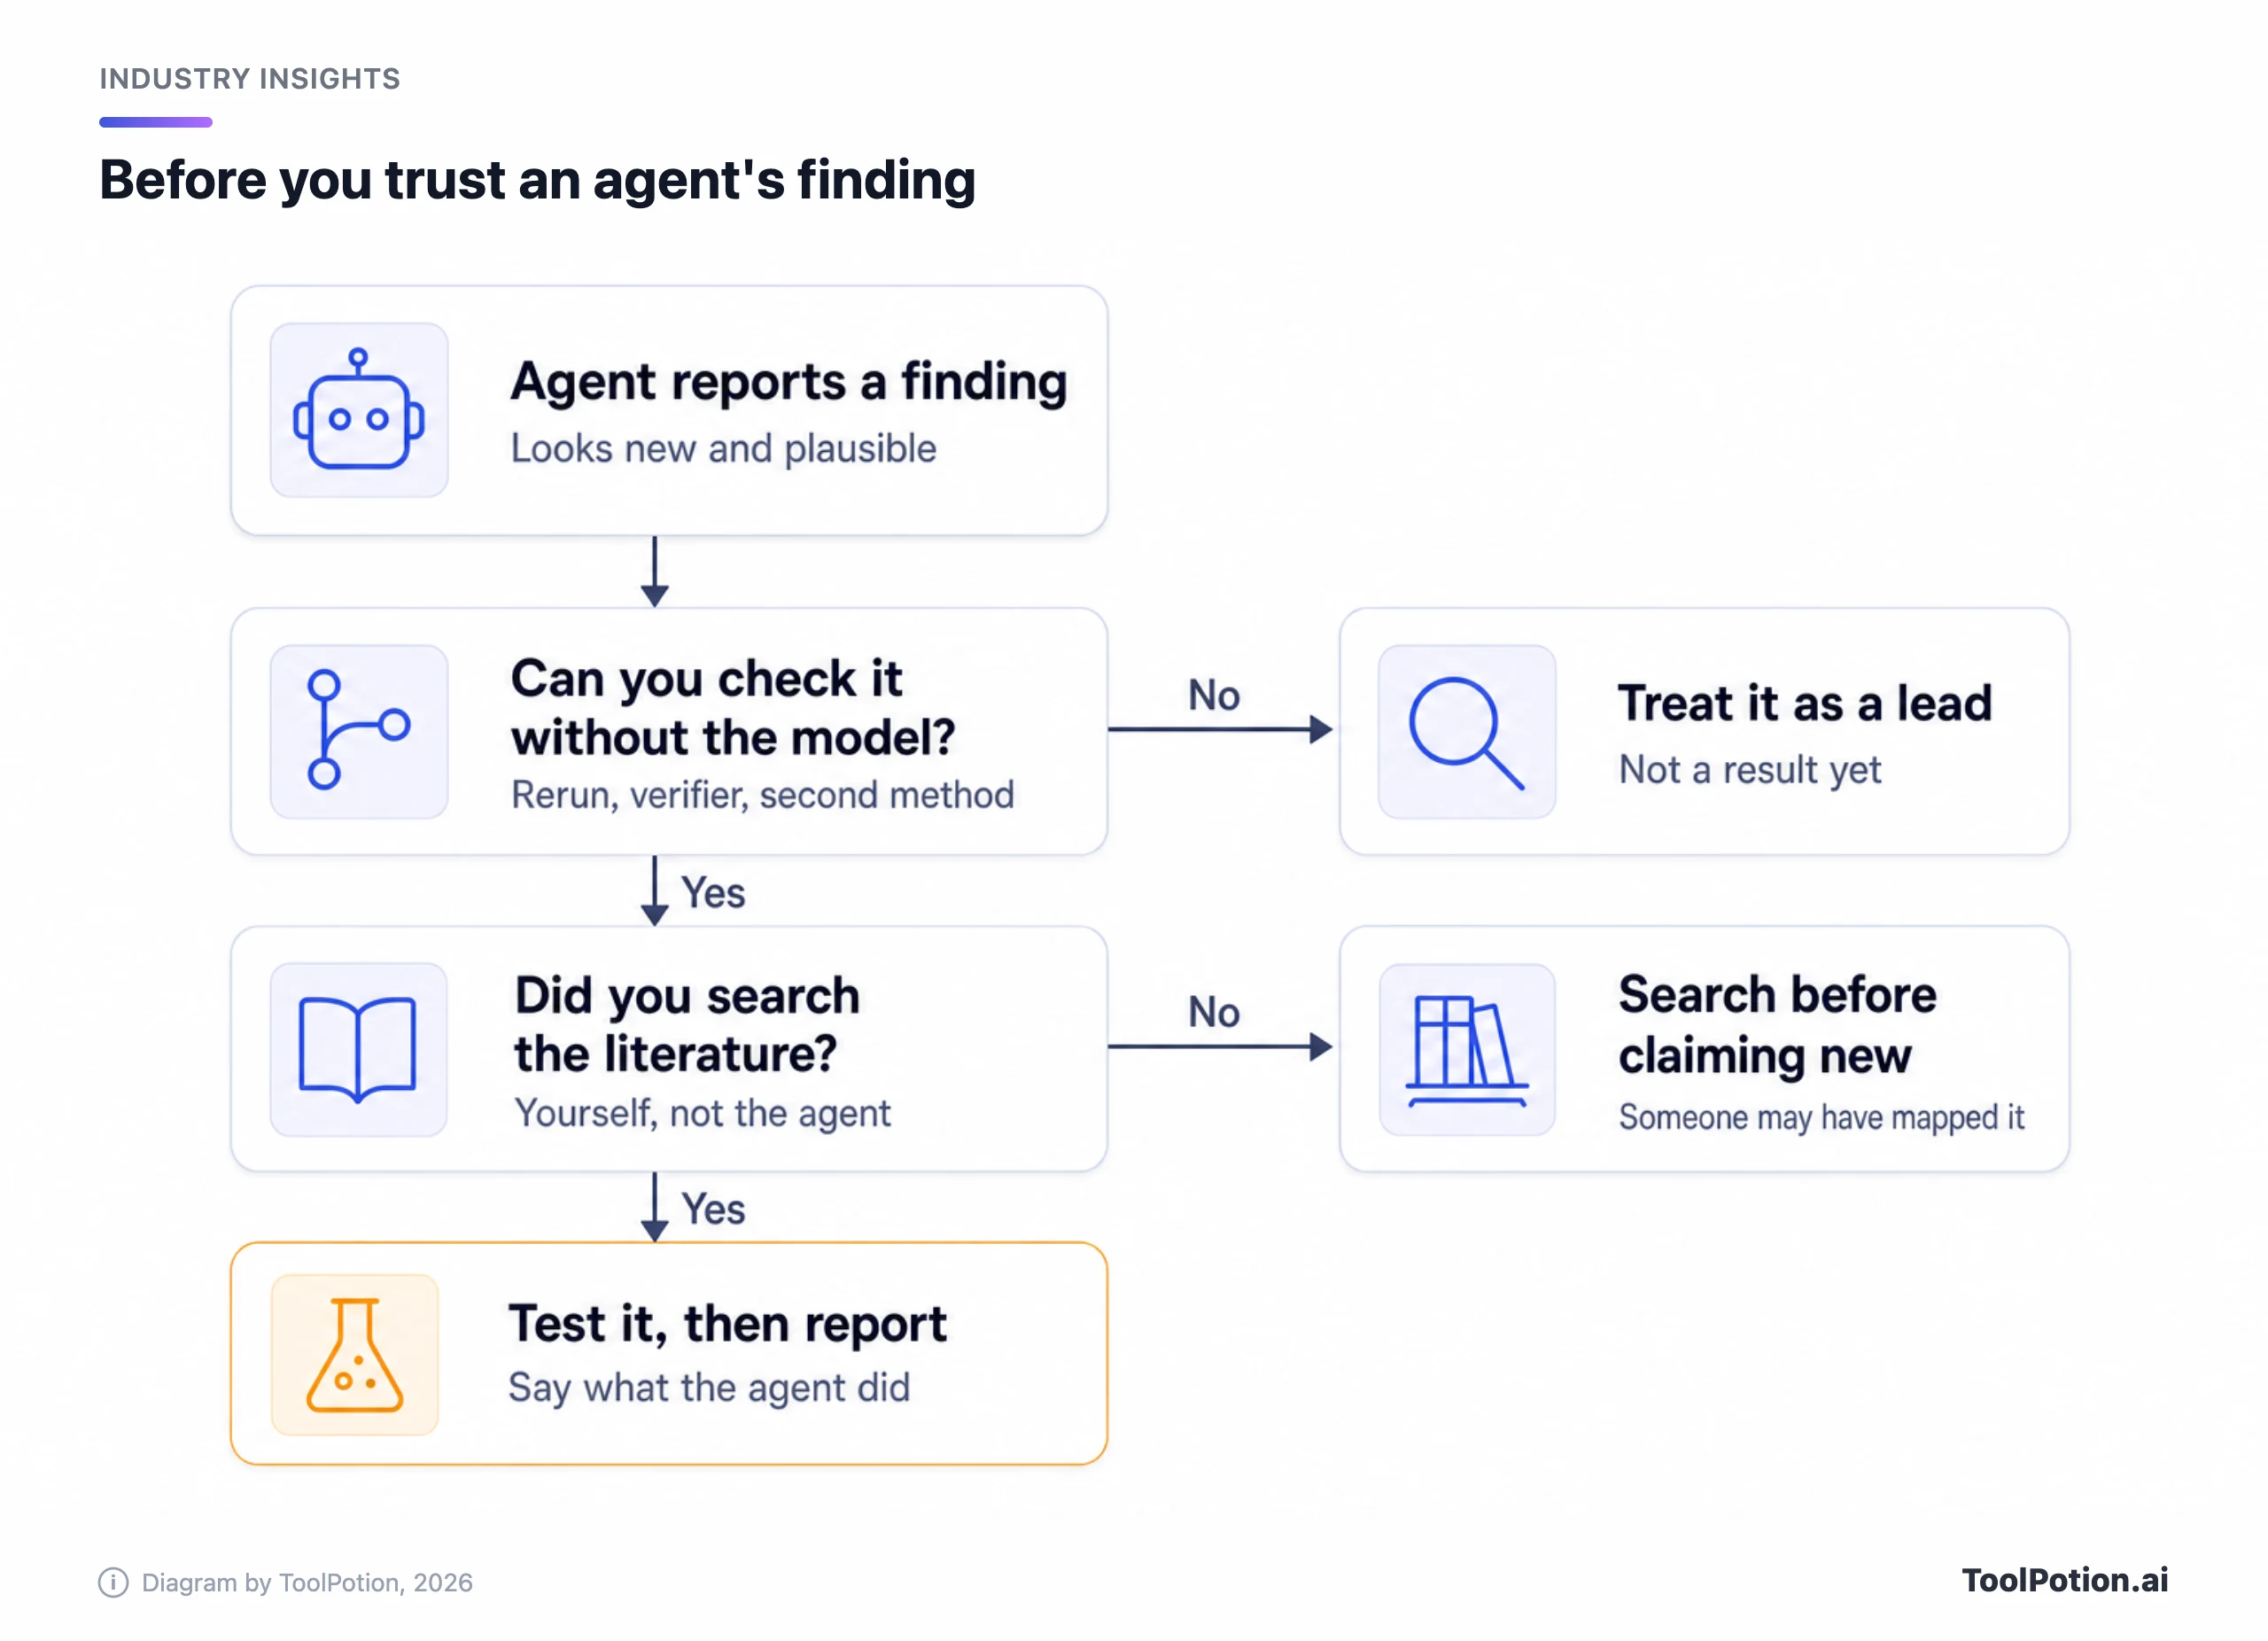
- Dê aos agentes trabalhos cujo resultado você mesmo consegue checar: análise de dados, portar código entre linguagens, triagem de artigos ou imagens. O Claude Code e o Claude Cowork foram feitos para esse tipo de tarefa, e nossa comparação de agentes de programação para terminal cobre o cenário.
- Decida antes de começar o que conta como checagem e quem a faz. Não o mesmo modelo. Um verificador formal, uma segunda análise, um experimento de bancada ou um colega.
- Quando um agente disser que algo é novo, faça você mesmo a busca na literatura. Uma ferramenta dedicada, como Elicit, Consensus, SciSpace ou ResearchRabbit, leva minutos, e o caso dos maias mostra o custo de pular essa etapa. Nosso ranking de assistentes de pesquisa com IA traz a lista mais completa.
- Mantenha a etapa física nas mãos de humanos e registrada. Se um resultado depende de uma medição, de uma amostra ou de uma visita de campo, é aí que ele é testado.
- Ao escrever o trabalho, diga o que o agente fez e o que você checou. Schwartz é direto ao dizer que a contribuição humana não foi digitar.
- Estudantes: construam vocês mesmos seus primeiros modelos. Os autores de Tübingen escrevem que “é o processo de construí-lo que traz a compreensão”. Use um agente para criticar seu modelo, não para entregar um pronto.
Se você quer o exemplo mais antigo e mais testado de IA fazendo biologia, ele continua sendo o AlphaFold, que prevê estruturas que os laboratórios depois testam. Para trabalho com literatura e pesquisa no estilo de agentes, há também o Edison Scientific, o Scientific Agent Skills para equipar seus próprios agentes e o ranking Top 250 AI Tools for Researchers. Entre os assistentes de uso geral, ChatGPT vs Claude vs Gemini compara o ChatGPT com seus dois principais rivais, enquanto os rankings de assistentes de pesquisa com IA e de agentes de IA classificam as ferramentas especializadas.
Onde chegamos e o que nos faria mudar de ideia
O que é real: agentes já são analistas e engenheiros úteis e incansáveis. Os protótipos de eletrônicos funcionam, a pista da enzima é interessante, e uma prova de um modelo checada em Lean é um resultado real, seja quem for que a entenda primeiro. As 15 integrais novas de Schwartz são resultados reais em uma área restrita.
O que é exagero: autonomia, “verificado” usado de forma frouxa e uma onda iminente de cientistas automatizados. Quase todo resultado impressionante acima tem um humano no circuito fazendo a parte que decide se aquilo é verdade, e os humanos dizem isso. Também gostaríamos que os laboratórios publicassem o custo em dólares ao lado da pontuação do benchmark. Créditos e contagem de tokens escondem quanto custa uma descoberta, e 210 milhões de tokens para uma busca de enzima é um número que importa para o orçamento de um laboratório.
Duas coisas nos fariam mudar de posição. Uma é matemáticos de fora do comitê da OpenAI lerem o código Lean de Yang-Mills e relatarem que o entendem. A outra é uma versão revisada por pares do trabalho da enzima que diga o que o sistema faz. Até lá, tratamos os dois como promissores e inacabados.