

Os modelos open-weight já estão tão perto dos melhores modelos fechados que, para muito trabalho, a pergunta real deixou de ser a qualidade. É quem roda o modelo, para onde vão seus dados e o que a licença permite fazer. A Bloomberg Intelligence estima que a distância entre o melhor modelo chinês e o líder americano é de cerca de 3% em um grande benchmark, contra cerca de 15% no início do ano (AI Weekly, citando a Bloomberg).
Essa mudança pesa mais se você é desenvolvedor, tem uma startup ou trabalha em uma equipe com regras de privacidade. Hoje dá para baixar um modelo do Hugging Face, rodá-lo em hardware sob seu controle e obter resultados em código e agentes que, um ano atrás, só existiam atrás de uma API paga. Ou você pode dispensar o hardware e chamar os mesmos pesos por meio de um host barato.
Nem tudo é vantagem. "Aberto" cobre licenças que vão de "faça o que quiser" a "leia as letras miúdas", alguns dos maiores modelos exigem um rack de GPUs, e alguns trazem bagagem real de segurança e censura. Este guia organiza os líderes atuais, mostra quanto custam e dá regras para escolher. Se você busca o panorama mais amplo de modelos fechados e abertos, nosso ranking Top 25 LLMs acompanha tudo isso.
A distância diminuiu, e o elenco mudou
A diferença no benchmark é a manchete, então vamos ao que está por trás dela. As medições da Bloomberg mostravam o melhor modelo chinês cerca de 15% atrás no início do ano, cerca de 9% atrás no meio do ano e cerca de 6% atrás um mês depois, um piso histórico na época (The Next Web). A leitura mais recente é de cerca de 3%. O dado mais novo é o DeepSeek V4.1 Flash, que marcou 81,1 no LiveBench contra 83,4 de um modelo líder da Anthropic, e que lidera o subteste de código agêntico desse benchmark por 77,3 a 66,1.
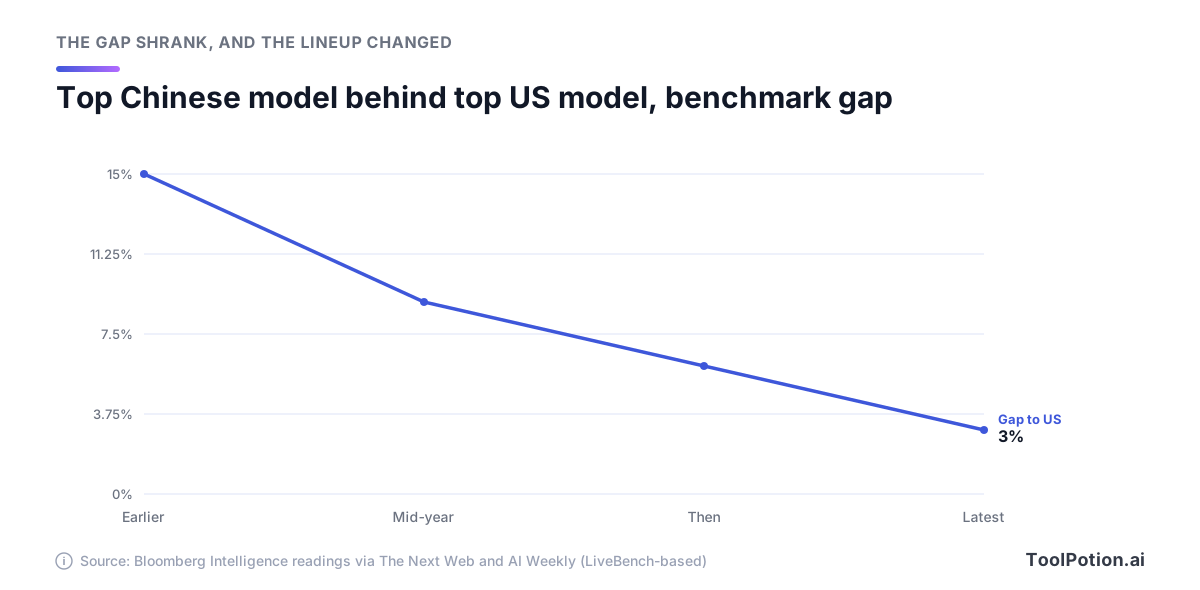
Tenha as ressalvas em mente. Apenas três das 15 primeiras posições do LiveBench são de modelos chineses, então é uma história da fronteira, não uma varrida. A diferença também é a visão de um único benchmark sobre o melhor modelo de cada lado, e nenhuma das fontes diz que ela se limita a modelos abertos. Mesmo assim, a direção é clara, e o modelo que fechou a distância, o DeepSeek V4.1 Flash, é open-weight.
Duas outras coisas mudaram este ano. Primeiro, a Qwen lançou pela primeira vez um modelo da classe Max com pesos abertos, segundo o model card do Qwen3.8-2.4T-A95B. Segundo, os lançamentos abertos da Meta mudaram. Os modelos Llama mais novos na página da Meta no Hugging Face ainda são a família Llama 4 de 2025, como o Llama 4 Scout. O site de desenvolvedores da Meta agora abre com seus modelos hospedados Muse Spark e lista o Muse Glimmer, um modelo open-weight de 30B para agentes locais, como o aberto.
A Mistral é a outra novidade. Ela acabou de anunciar o Mistral Large 4, um modelo de 1 trilhão de parâmetros com 52 bilhões ativos, e colocou uma prévia na API. Diz que os pesos virão até o fim do mês (Mistral). Quando este texto foi escrito, eles não estavam disponíveis para download e a Mistral não tinha publicado uma licença, então trate o Large 4 como promessa, não como lançamento. Não planeje em torno dele até que os pesos e a licença estejam no Hugging Face.
Os modelos open-weight que vale conhecer
Aqui estão os líderes atuais num relance. Tamanhos e licenças vêm do card de cada modelo no Hugging Face, e os preços vêm da página de preços de cada fabricante. "Ativos" é quantos parâmetros são acionados por token em um modelo mixture-of-experts, o que determina a velocidade.
| Modelo | Licença | Tamanho (ativos) | Contexto | API do fabricante, US$ por M de tokens (entrada / saída) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B a 16B) | 1M | 0,30 / 1,20 (pico) |
| DeepSeek V4-Pro | MIT | 1,7T | 1M | 1,32 / 3,96 (pico) |
| Kimi K3 | Kimi K3 License | 2,8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B denso | 262K | versão hospedada em breve |
| gpt-oss-120b | Apache 2.0 | 117B (5,1B) | n/d | sem API do fabricante listada |
| Gemma 4 31B | Apache 2.0 | 31B denso | 256K | sem API do fabricante listada |
| Muse Glimmer | Apache 2.0 | 30B denso | 131K+ | sem API do fabricante listada |
| Mistral Large 4 | não publicada | 1T (52B) | n/d | 1,36 / 4,18 (prévia) |
A DeepSeek é a escolha padrão segura quando o assunto é custo. Os pesos do V4.1 Flash têm licença MIT, o preço da API é o mais baixo entre os modelos grandes, e o desconto de metade do preço nos horários de menor demanda reduz ainda mais (documentação da DeepSeek). Não se deixe enganar pelo nome. "Flash" aqui é um modelo de 763B, com download de 510 GB (model card). O V4-Pro-0813 é ainda maior, com cerca de 1,7T.
O Kimi K3 é o que mais chama atenção. Com 2,8 trilhões de parâmetros e 104 bilhões ativos, ele registra 93,5 no GPQA Diamond e 91,2 no BrowseComp no próprio card. Esses são números da Moonshot, então leia como alegações. A API da própria Moonshot também é a mais cara do grupo aberto, o que surpreende muita gente (mais sobre isso abaixo).
O GLM-5.3, da Z.ai, é o especialista em código. Ele compartilha o modelo base com o GLM-5.2, e a Z.ai afirma que todo o ganho veio do pós-treinamento, incluindo um salto de 50% no benchmark interno de código (model card). Essa é uma medição do próprio fabricante. O irmão mais barato, o GLM-5.3-Flash, custa US$ 0,15 de entrada e US$ 0,50 de saída.
A Qwen tem a maior variedade. O Qwen3.8-27B é um modelo denso de 27B sob Apache 2.0, com visão, contexto nativo de 262K e 61,7 reportados no SWE-bench Pro (model card). Para uma única workstation, é a melhor primeira tentativa em código e agentes, e para a maioria das equipes pequenas é o modelo para começar. O grande Qwen3.8-2.4T fica sob outra licença, tratada a seguir. Você também pode experimentar a Qwen pelo aplicativo.
O gpt-oss-120b da OpenAI já é antigo, mas continua útil. É Apache 2.0, tem 5,1B de parâmetros ativos e, segundo a OpenAI, roda em uma única GPU de 80 GB (model card). Foi publicado em 2025, e nenhum lançamento gpt-oss mais novo apareceu na página da OpenAI no Hugging Face. O Gemma 4 é a família atual do Google; o modelo de 31B é Apache 2.0, tem janela de 256K e vem com versões quantizadas para Ollama e llama.cpp (model card). O Muse Glimmer é o pequeno: a Meta diz que uma versão de cerca de 4 bits fica abaixo de 20 GB e roda numa faixa de 24 GB ou 32 GB, com cerca de 1% de perda de qualidade na configuração mais apertada (model card).
A Europa tem duas opções hoje. O Mistral Medium 3.5 é um modelo denso de 128B com janela de 256K sob uma licença MIT modificada, que a Mistral descreve como aberta para uso comercial, exceto para empresas de grande faturamento. O Mistral Small 4, de 119B, e o mais antigo Mistral Large 3 são Apache 2.0 no Hugging Face.
"Aberto" ainda pode vir com condições
Só os modelos Apache 2.0 e MIT são abertos no sentido que a maioria dos desenvolvedores entende. Vários dos mais fortes não são. Leia o arquivo de licença, não a manchete.
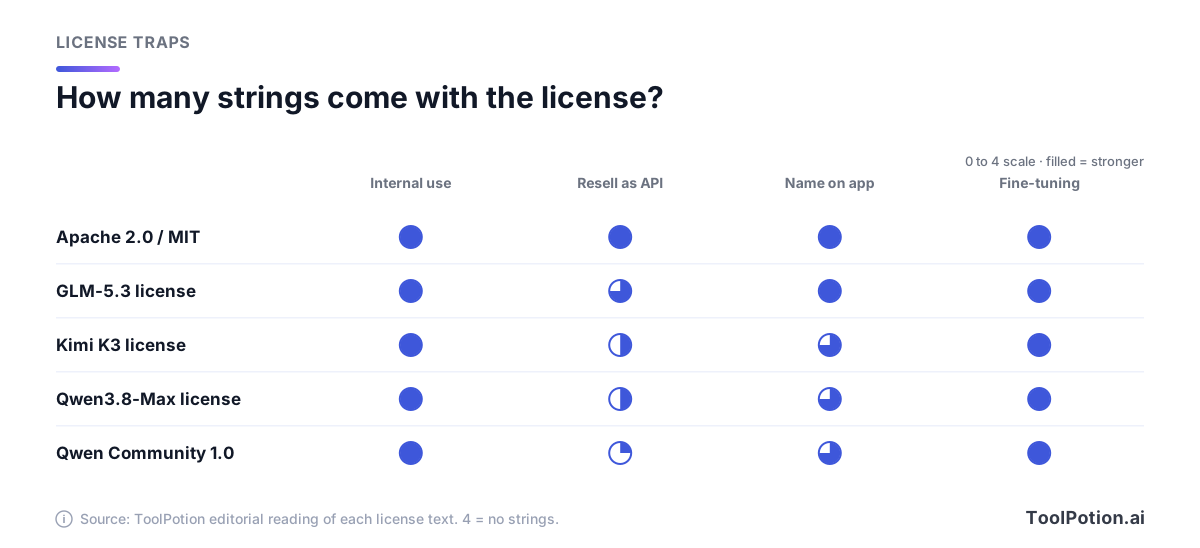
O padrão é o mesmo em todas as licenças personalizadas. Você pode usar, modificar e fazer fine-tuning livremente. As condições se prendem à venda do modelo para outras pessoas, normalmente como API, depois que você passa de certo faturamento. A licença da Moonshot, por exemplo, diz que um operador de "Model as a Service" com receita acima de US$ 20 milhões em 12 meses precisa de um acordo separado antes do uso comercial. Produtos com 100 milhões de usuários mensais ou US$ 20 milhões de receita mensal devem exibir "Kimi K3" na interface (texto da licença). O uso interno é isento.
A licença da Z.ai é mais branda. A única barreira é uma revisão de segurança para operadores de Model-as-a-Service acima de US$ 10 bilhões de receita. As licenças da Qwen são as mais rígidas do grupo. A Qwen Community License do Qwen3.8-Flash-Next diz que qualquer empresa que opere um negócio de Model-as-a-Service ou de "AI Work Assistant" precisa antes obter uma licença separada da Qwen, com exceção para uso interno (texto da licença). A licença Max do modelo de 2,4T eleva esse patamar para US$ 50 milhões de receita.
Se você constrói um app em cima de um desses modelos, quase certamente está tranquilo. Se o seu produto é "uma API que serve este modelo", leia a licença com um advogado antes de lançar. Se você não quer nenhuma dúvida, fique com Apache 2.0 ou MIT. Isso significa DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4 e Muse Glimmer.
Quanto custam as APIs hospedadas
Pesos abertos não significam API barata. O cenário muda conforme quem hospeda o modelo.
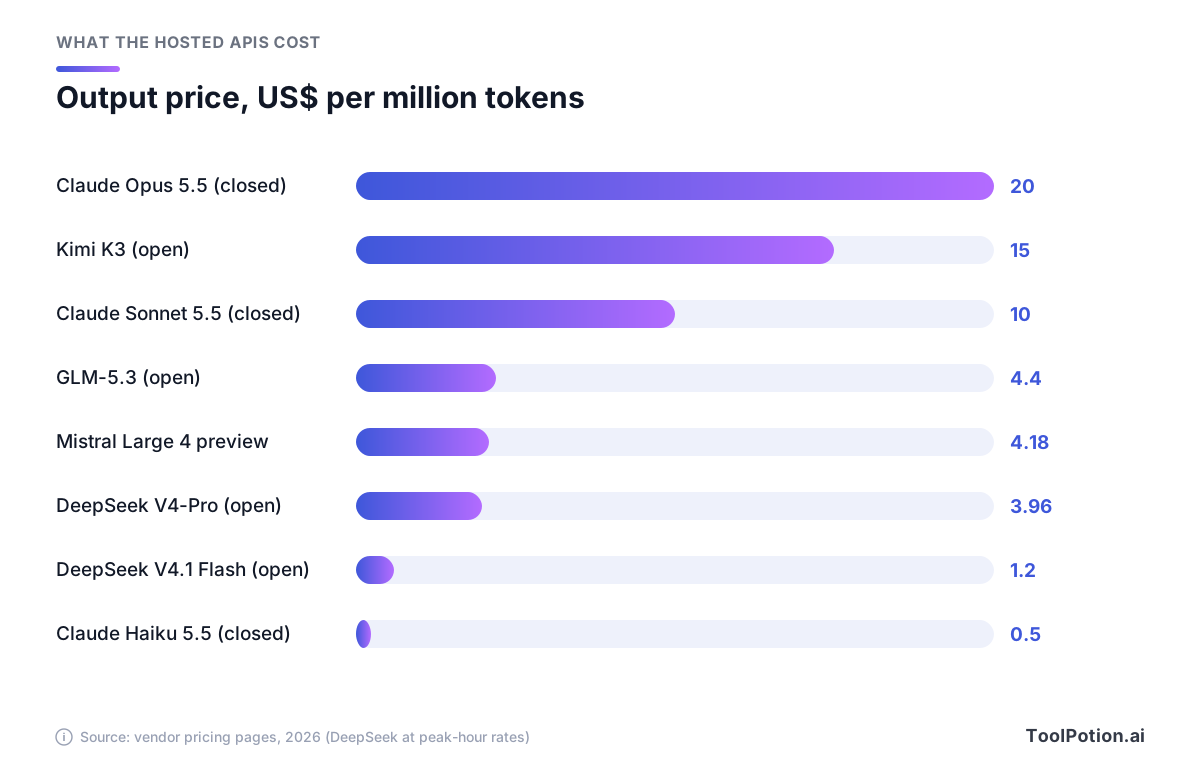
A Moonshot cobra US$ 3 de entrada e US$ 15 de saída por milhão de tokens no Kimi K3, segundo sua página de preços. É mais do que o Claude Sonnet 5.5 da Anthropic, a US$ 2 e US$ 10, e o Sonnet é um modelo fechado. A DeepSeek é o oposto: a saída do V4-Pro custa US$ 3,96 no pico e US$ 1,98 fora do pico. O GLM-5.3 da Z.ai custa US$ 1,40 de entrada e US$ 4,40 de saída.
Os modelos fechados pequenos superam em preço a maioria dos carros-chefe abertos. O Claude Haiku 5.5 custa US$ 0,10 de entrada e US$ 0,50 de saída, igual ao GPT-6 Luna da OpenAI, segundo a página de preços de cada fornecedor. Ou seja, "ir de open para economizar" só vale contra as faixas fechadas caras, e só se você escolher um host aberto barato.
O caminho mais barato costuma ser um terceiro servindo os mesmos pesos. A lista pública de modelos da OpenRouter mostra o gpt-oss-120b a cerca de US$ 0,04 de entrada e US$ 0,17 de saída por milhão de tokens, e os preços lá variam por provedor e mudam com frequência. OpenRouter, Together AI, Fireworks AI e Groq revendem modelos abertos por trás de um único formato de API, então trocar de provedor é só mudar a base URL.
Rodar por conta própria ou usar um host
Há quatro maneiras de rodar um modelo aberto, e cada uma dá um pouco mais de controle e um pouco mais de trabalho.
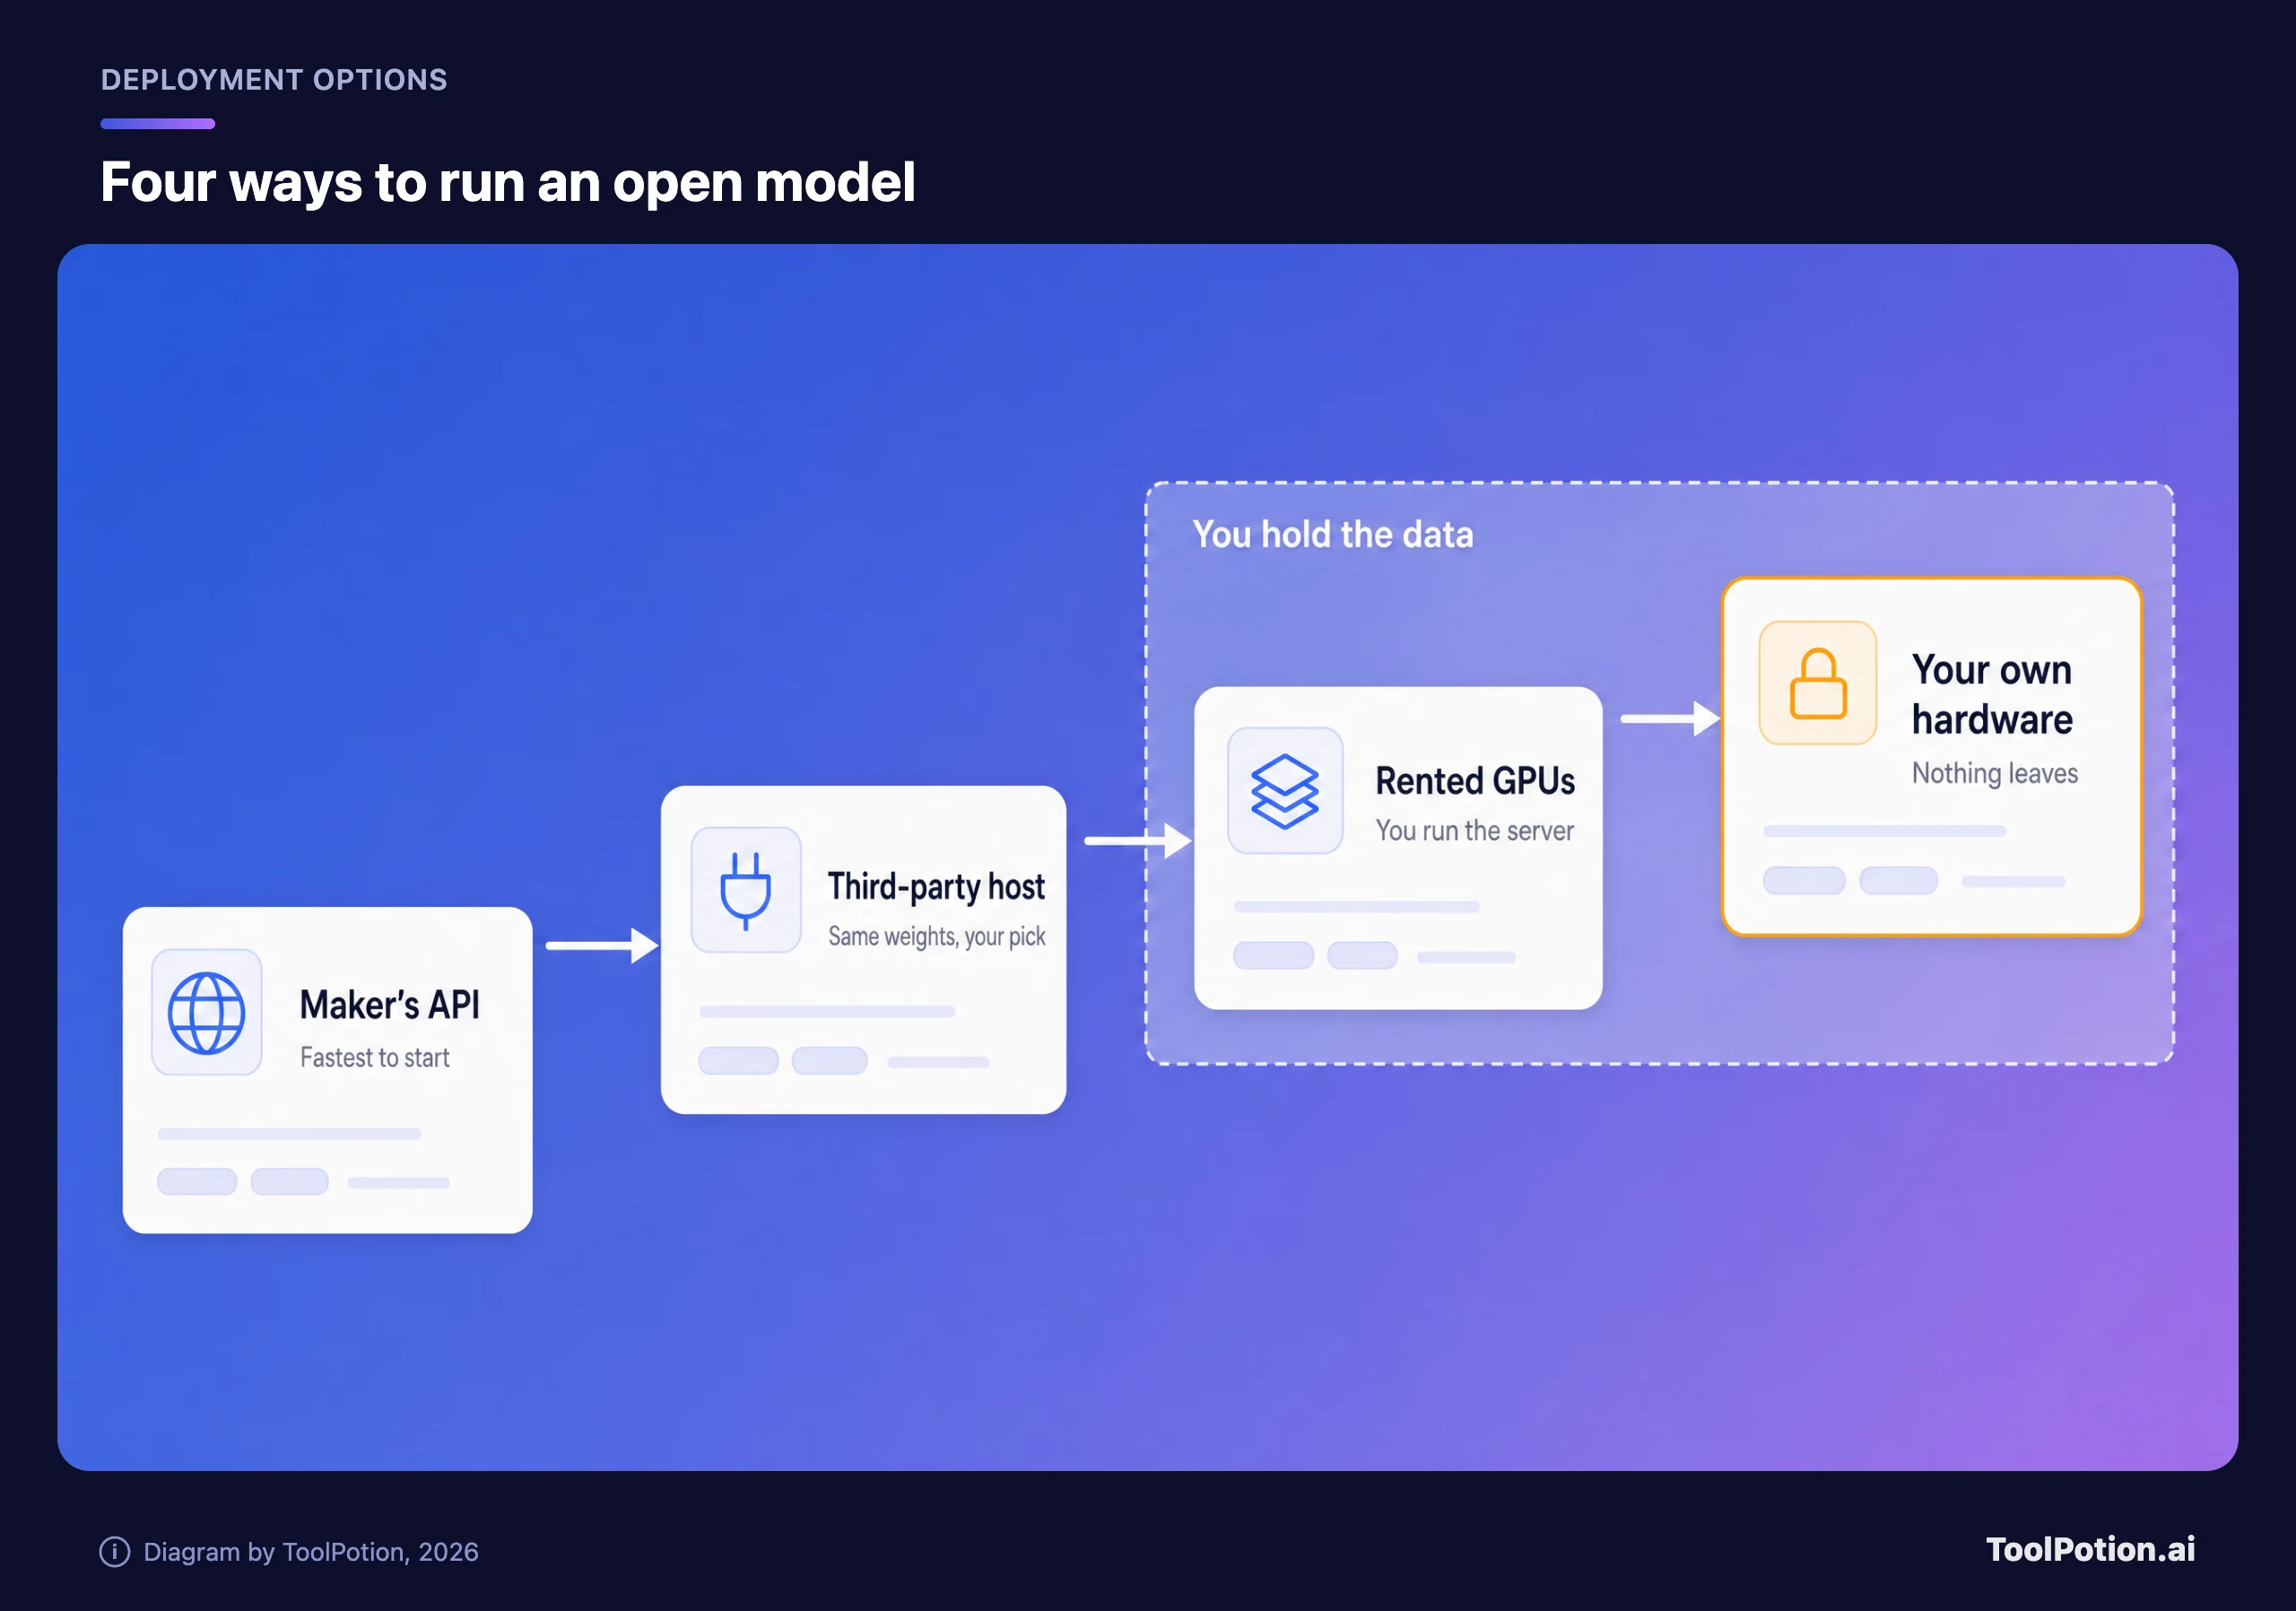
As duas primeiras são gerenciadas. Você envia tokens ao fabricante ou a um host, e seus dados passam pela rede de outra pessoa. As duas últimas colocam o modelo em máquinas sob seu controle, que é o ponto quando um contrato ou regulador diz que os dados não podem sair. Pesos que não cabem no seu hardware são o bloqueio mais comum, então comece pelo tamanho.
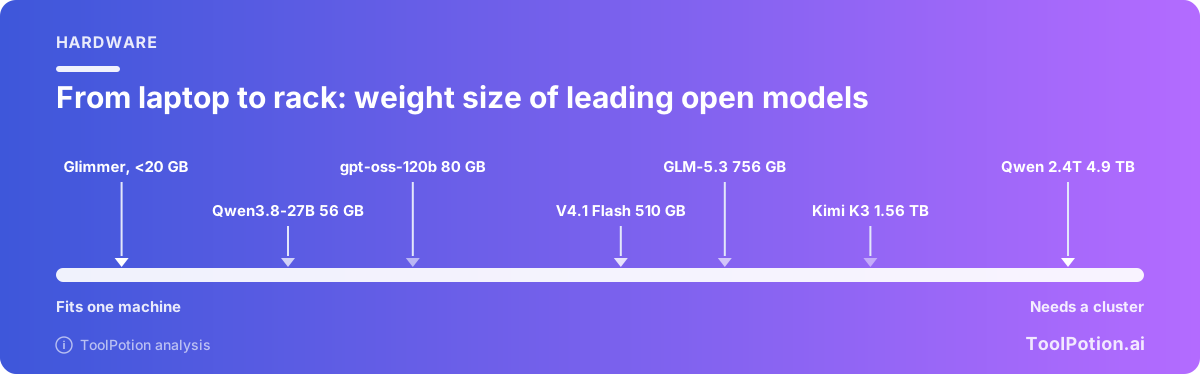
A maioria dos modelos de destaque é grande demais para uma única máquina. Só os pesos do Kimi K3 somam 1,56 TB, mais que os 1,44 TB de um nó com oito GPUs B200 de 180 GB. DeepSeek V4-Pro e GLM-5.3 precisam, cada um, de centenas de gigabytes. Os modelos que cabem em uma única máquina são os da classe de 20B a 120B. Use o estimador para checar um modelo e uma precisão contra o seu hardware.
Teste os valores padrão. O gpt-oss-120b em 4 bits precisa de cerca de 70 GB com overhead, então cabe em uma GPU de 80 GB. Troque para o Kimi K3 e o mesmo estimador pede dez GPUs de 180 GB. Dez GPUs significam dois nós de oito GPUs. Ao preço sob demanda da Lambda de US$ 6,69 por hora de B200, conforme a página de preços da Lambda, essas 16 GPUs rodando o mês inteiro custam cerca de US$ 78.000. Esse é o custo de hospedar por conta própria um modelo aberto de fronteira, antes de alguém ser contratado para operá-lo.
A ponta pequena é bem mais gentil. A Lambda lista uma GPU de 80 GB a partir de US$ 3,99 por hora, o que dá cerca de US$ 2.900 por mês se rodar sem parar. Se isso compensa frente a uma API depende inteiramente do volume.
Com 300 milhões de tokens de saída por mês e um preço de API de US$ 10, as duas contas ficam mais ou menos iguais. Abaixo disso, a API ganha. Acima, alugar ganha, desde que a GPU esteja ocupada e o modelo seja bom o bastante para a tarefa. A comparação honesta, porém, é com um host barato. Ao preço de host listado do gpt-oss-120b, cerca de US$ 0,17 por milhão de tokens de saída, US$ 2.900 compram por volta de 17 bilhões de tokens de saída, então uma única GPU alugada quase nunca vence um host só pelo custo. Alugue por privacidade, controle e latência previsível. Não alugue para economizar com um modelo pequeno.
Vamos a um exemplo prático, com volume inventado, mas plausível. Digamos que uma equipe de suporte resuma 20.000 tickets por dia, cada um com 1.500 tokens de entrada e 300 de saída. Dá cerca de 900 milhões de tokens de entrada e 180 milhões de saída por mês. No Claude Sonnet 5.5, a US$ 2 e US$ 10 por milhão, a conta é de US$ 3.600. No DeepSeek V4.1 Flash, nas tarifas de pico, é de no máximo US$ 486, e metade disso fora do pico. No gpt-oss-120b, aos preços de host listados, fica em cerca de US$ 64. Uma GPU de 80 GB alugada custa US$ 2.913 não importa quanto você envie. O host barato vence por larga margem, e o modelo fechado custa cerca de sete vezes mais que o aberto ao preço do próprio fabricante.
Dois atalhos ajudam antes de você gastar qualquer coisa. Para um notebook ou workstation, Ollama e llama.cpp rodam versões quantizadas de Gemma 4, Qwen3.8-27B e Muse Glimmer com um único comando. Para um servidor de produção, o vLLM é o motor de inferência que os model cards do Kimi K3 e do Qwen3.8 listam como compatível.
Como escolher
Comece pela sua restrição, não pelo ranking. Três perguntas resolvem a maior parte dos casos.
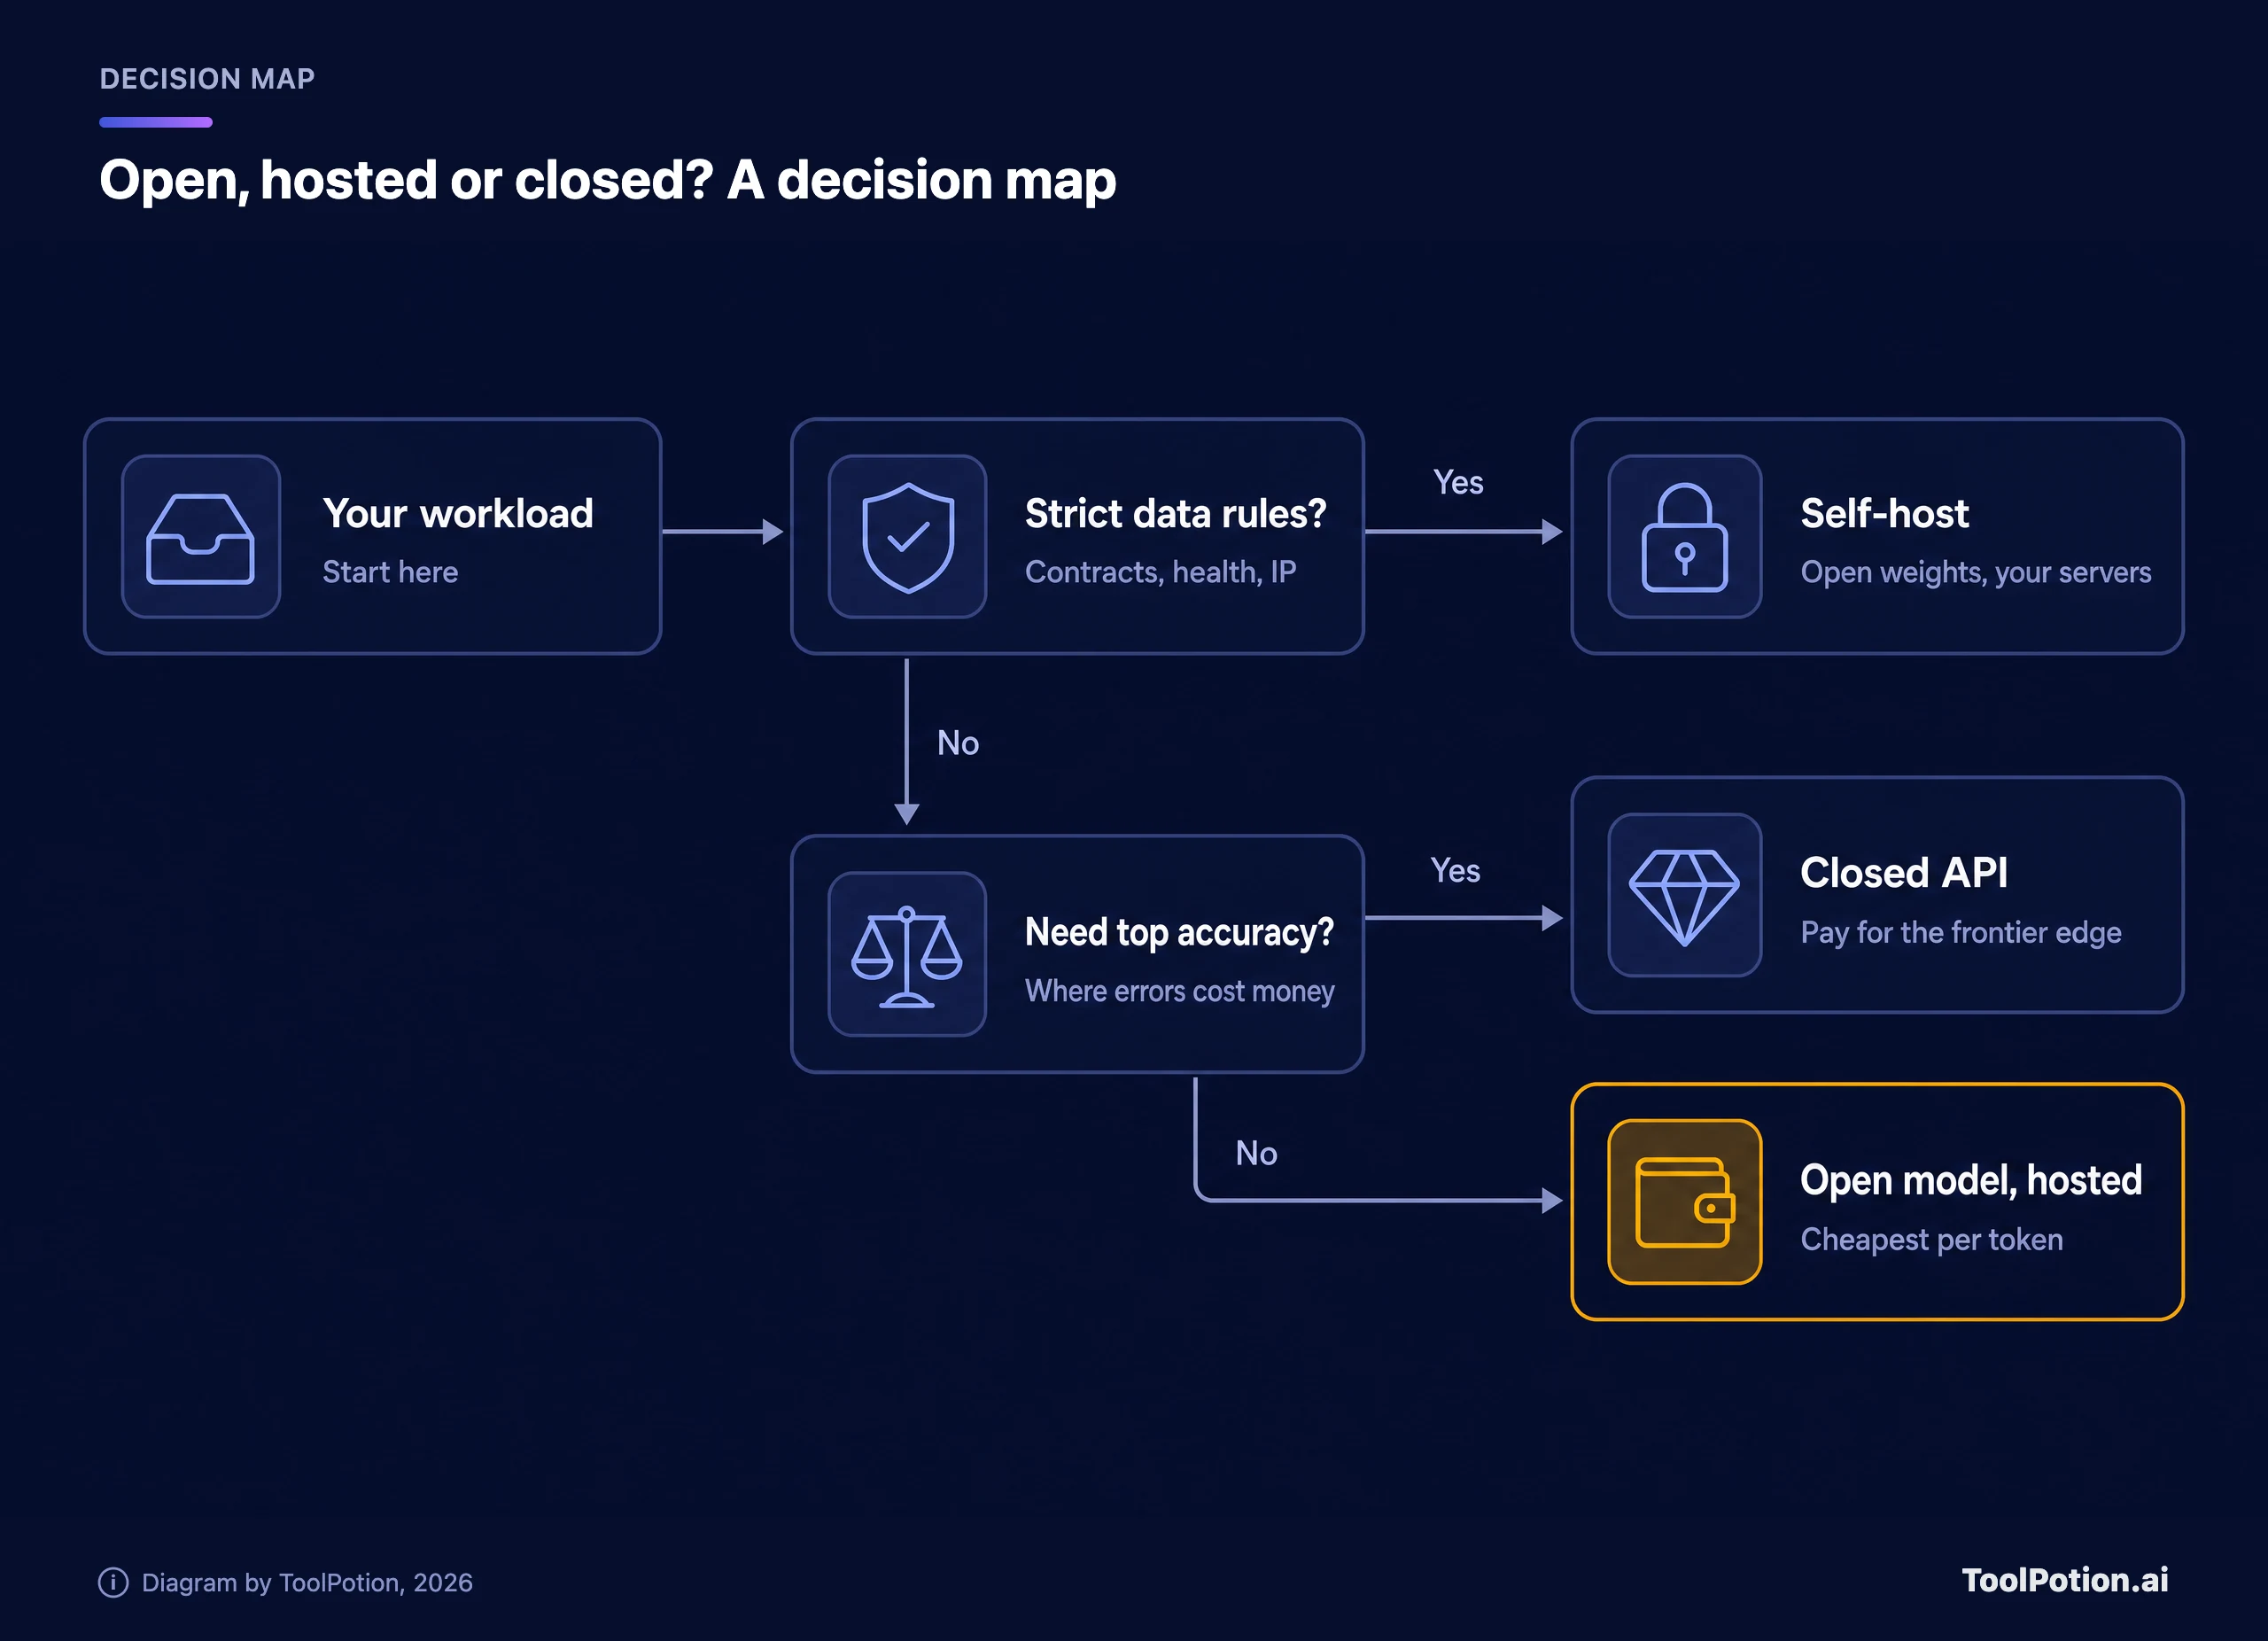
Se seus dados não podem sair do seu controle, você vai hospedar por conta própria, e o modelo precisa caber no seu hardware. Sob essa restrição:
- Uma GPU ou uma workstation: Qwen3.8-27B para código e agentes, gpt-oss-120b se você quer um modelo de origem ocidental, Muse Glimmer ou Gemma 4 para um notebook.
- Um servidor multi-GPU: DeepSeek V4.1 Flash ou GLM-5.3, se você puder pagar por oito placas grandes e algumas centenas de gigabytes de pesos.
- Um cluster: Kimi K3 ou Qwen3.8-2.4T, mas só se você tiver uma equipe que vive de rodar inferência.
Se seus dados podem sair, pergunte se os erros são caros. Onde são (minutas jurídicas, análise financeira, código que vai para produção sem revisão), pague por um modelo fechado de fronteira e valide nos seus próprios exemplos. Onde não são (resumos, tagging, extração, busca interna, código de primeira versão), um modelo aberto por meio de um host barato é o melhor preço que você vai encontrar.
Passe por esta lista, na ordem, antes de escolher:
1. Anote a restrição que não pode mudar: localização dos dados, orçamento mensal ou um piso de qualidade.
2. Confira a licença para o seu uso. Um produto construído sobre o modelo costuma ser permitido em quase todo lugar. É na revenda do modelo que estão as condições.
3. Confira a memória: os pesos em GB contra o hardware que você realmente compraria ou alugaria.
4. Calcule o custo da mesma carga de trabalho em uma API do fabricante, em um host de terceiros e em uma GPU alugada.
5. Rode 50 tarefas suas em dois ou três candidatos e fique com o vencedor.
Teste antes de se comprometer. Os benchmarks aqui são os do próprio fabricante, rodados em suítes diferentes, então um 90 em um ranking diz pouco sobre um 88 em outro. Pegue 50 tarefas reais da sua carga de trabalho, rode em dois ou três candidatos e avalie os resultados. Uma tarde nisso vale mais que uma semana lendo model cards.
Os riscos que ninguém coloca no model card
Segurança. Pesos abertos não tornam um modelo seguro. Na avaliação de 2025 dos modelos DeepSeek mais antigos, o NIST, órgão do governo dos EUA, constatou que o melhor deles, o R1-0528, atendeu a 94% dos pedidos claramente maliciosos sob jailbreaks comuns, contra 8% dos modelos de referência americanos. Os agentes da DeepSeek também tinham 12 vezes mais chance de seguir instruções maliciosas escondidas no conteúdo que processavam (NIST CAISI). Esses são modelos anteriores à linha V4 atual, e nenhuma avaliação pública equivalente dos lançamentos atuais apareceu nas fontes por trás deste texto. Veja isso como um motivo para testar, sobretudo antes de dar ferramentas e acesso de escrita a um modelo.
Censura. O NIST também constatou que os modelos da DeepSeek repetiam quatro vezes mais narrativas imprecisas do PCC do que os modelos de referência americanos. Um relatório separado do NIST sobre o Kimi K2 Thinking encontrou censura pesada em chinês, mas o modelo era relativamente pouco censurado em inglês, espanhol e árabe. Se seus usuários perguntam sobre política ou história em chinês, teste isso diretamente. Se o uso é código e planilhas, o assunto raramente aparece.
Residência de dados. Quem hospeda o modelo decide para onde vão seus dados. A política de privacidade da DeepSeek diz que ela coleta, processa e armazena dados pessoais na República Popular da China (política de privacidade da DeepSeek). Isso vale para o app e a API dela, não para os pesos com licença MIT que você roda em outro lugar. A Mistral faz a proposta oposta: diz que treinou o Large 4 em seus próprios datacenters na Europa e opera a prévia como uma implantação europeia sob a lei europeia. Em qualquer host, pergunte onde a inferência roda e o que é registrado em log antes de enviar dados de clientes.
Defasagem. Modelos abertos ficam desatualizados em meses. Os pesos do gpt-oss têm um ano, o Llama mais novo da Meta é de 2025, e Qwen e DeepSeek lançaram várias versões só em 2026. Fixe a versão exata do modelo que você testou e teste de novo ao atualizar.
Quem ainda deve pagar por uma API fechada
Os 3% de diferença são a leitura de um único benchmark. Os modelos fechados ainda lideram no topo absoluto, e os laboratórios que os vendem continuam adicionando ferramentas e recursos gerenciados que os pesos abertos não trazem.
Pague pelo Claude ou pelo ChatGPT se você precisa da melhor precisão em trabalho difícil e de alto risco, se não tem ninguém para operar infraestrutura, ou se o volume é pequeno demais para qualquer arranjo de hospedagem fazer diferença. Uma equipe que faz alguns milhares de chamadas por dia gasta menos em horas de engenheiro do que economiza em tokens. Pague também se quiser um único fornecedor respondendo por disponibilidade, segurança e suporte.
Misture, não troque. Uma configuração comum envia o grosso da rotina para um modelo aberto por meio de um host e escala os casos difíceis para um fechado. As regras de roteamento do nosso guia sobre como combinar faixas de modelos com tarefas valem direto aqui: comece pelo barato e escale quando falhar.
Perguntas frequentes
Qual é a diferença entre open-weight e open-source?
Open-weight significa que você pode baixar o modelo treinado. Open-source, no sentido estrito, incluiria também os dados de treinamento e o código sob uma licença aprovada. Quase nada nesta lista atende a esse critério. Os modelos Apache 2.0 e MIT são os que mais se aproximam na prática. Licenças personalizadas, como as da Kimi e da Qwen, acrescentam condições.
Posso usar esses modelos comercialmente?
Sim, para construir produtos sobre eles, com todas as licenças tratadas aqui. As condições pesam quando você vende o próprio modelo como serviço e, em alguns casos, quando seu produto é enorme. Os modelos Apache 2.0 e MIT não têm nenhuma condição de faturamento.
Qual é o melhor modelo aberto para código?
Pelos números reportados pelos fabricantes, GLM-5.3, Kimi K3 e DeepSeek V4.1 Flash lideram, e os três exigem hardware de classe servidor. Para uma única máquina, o Qwen3.8-27B é a escolha prática. Faça seus próprios testes na sua própria base de código, já que as suítes de benchmark são diferentes.
O DeepSeek é seguro para dados da empresa?
Depende de como você o roda. O app e a API da DeepSeek armazenam dados na China, conforme a política citada acima. Os pesos MIT, rodando em seus próprios servidores ou em um host de confiança, não enviam nada à DeepSeek. Os riscos separados de comportamento do modelo, apontados na avaliação mais antiga do NIST, continuam valendo.
De quanta memória de GPU eu preciso?
Grosso modo, parâmetros vezes bits dividido por oito, mais cerca de 20% para cache e runtime. Um modelo de 27B em 8 bits fica em torno de 33 GB com overhead. Um modelo de 117B em 4 bits fica em torno de 70 GB. O estimador acima faz as contas por você.
Quando o Mistral Large 4 será aberto?
A Mistral prometeu os pesos logo após o anúncio e ainda não publicou os termos da licença. Confira a página dela no Hugging Face antes de planejar em torno dele.