

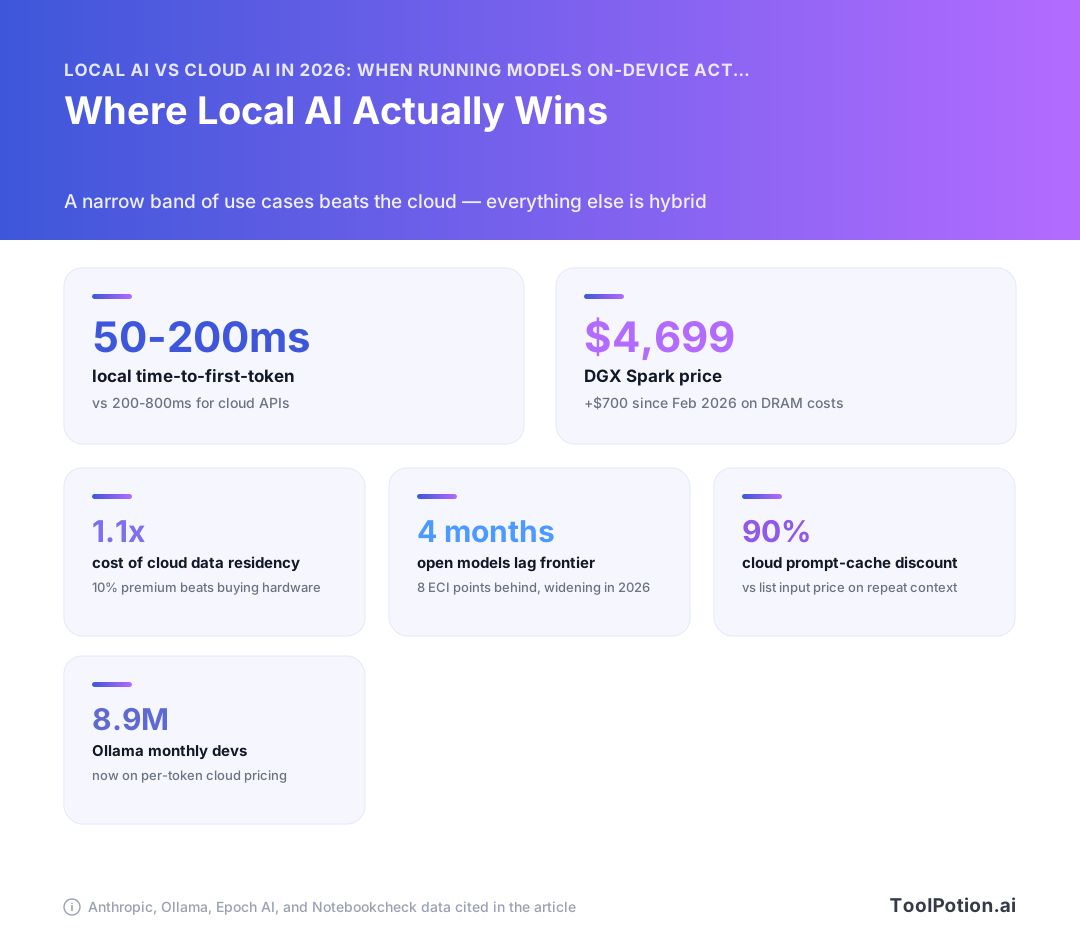
GPU는 충분히 활용할 수 있을 때만 구매하십시오. 2026년 로컬 AI vs 클라우드 AI에 대한 짧은 답변이 그것입니다. 하루 지속 사용률이 약 26%를 넘으면 로컬 장비가 토큰당 요금 지불보다 유리합니다. 그 이하에서는 2026년 메모리 가격 기준으로 유휴 실리콘에 자금을 투자하는 셈이 되며, 그 가격은 만만치 않습니다. NVIDIA는 2026년 2월 DGX Spark를 $3,999에서 $4,699로 인상했으며, DRAM 및 스토리지 비용을 이유로 들었습니다 (Notebookcheck).
한편 클라우드 측은 대부분의 비교 분석이 빠뜨리는 방식으로 더 저렴해졌습니다. 프롬프트 캐시 읽기는 입력 가격의 0.1배로 청구되고, 50% 배치 할인이 추가로 적용되어 Claude Haiku 4.5는 백만 토큰당 입력 $0.50 / 출력 $2.50에 달합니다 (Anthropic).
그 계산이 어떻게 되는지, 24GB로 무엇을 실행할 수 있는지, 그리고 여러분의 손익분기점은 어디인지 살펴보겠습니다.
로컬 AI vs 클라우드 AI: 2026년 플레이북이 네 곳에서 무너진 이유
여러분이 읽었던 손익분기 계산은 틀렸으며, 반올림 오차 수준이 아닙니다. 하드웨어는 더 비싸졌고, 성능 통계는 잘못 읽혔으며, 툴링은 진영을 바꿨고, 클라우드 요금표는 모두의 스프레드시트 아래에서 조용히 낮아졌기 때문입니다.
모든 비교 분석이 여전히 전제하는 세 가지 가정
검색 결과 첫 페이지에 나오는 거의 모든 로컬 vs 클라우드 가이드는 동일한 세 가지 주장에 기반하며, 모두 2024년 자료입니다. 첫째: 하드웨어는 고정된 하락 비용이므로 $1,999 GPU를 18개월에 걸쳐 상각한 뒤 토큰당 지출과 비교합니다. 둘째: 오픈 가중치 모델은 클로즈드 프론티어 모델보다 3~6개월 뒤처지므로 집에서 실행하는 모델은 몇 분기 뒤처집니다. 셋째: '로컬'은 자신의 머신에서 Ollama를 의미하고 '클라우드'는 프론티어 API를 의미하는, 깔끔한 양자 대결입니다.
세 가지 모두 2024년에는 타당했습니다. 2026년 현실에는 하나도 통하지 않습니다.
2024년과 지금 사이에 바뀐 것
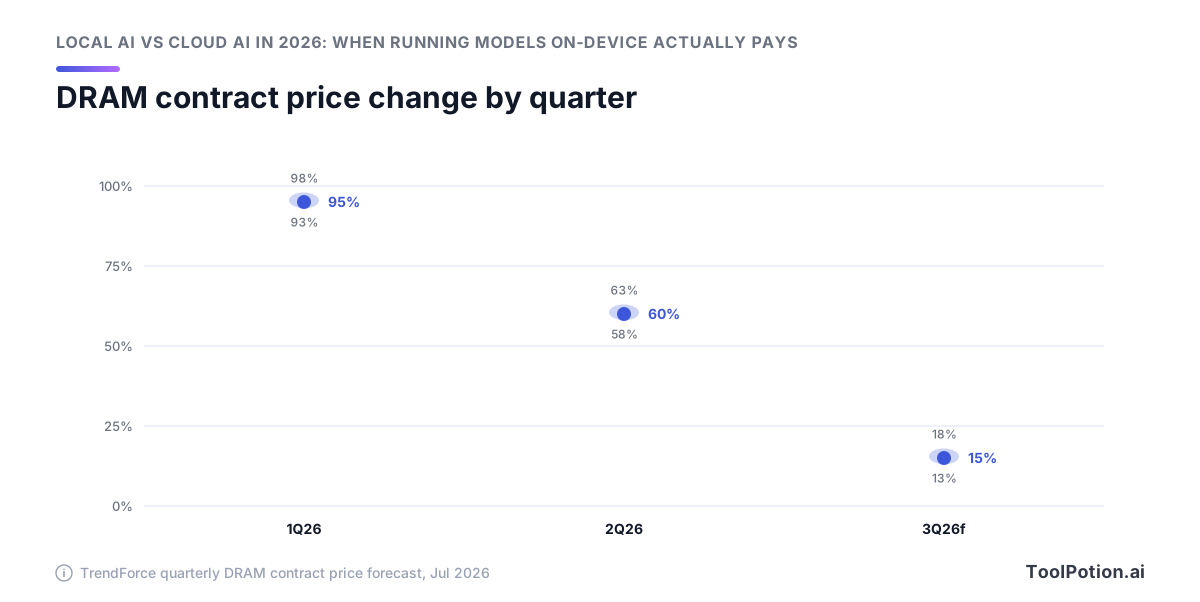
하드웨어 하한선부터 시작하십시오. 잘못된 방향으로 이동했기 때문입니다. NVIDIA는 2026년 2월 DGX Spark를 $3,999에서 $4,699로 인상했으며, 급등하는 DRAM 및 스토리지 비용을 이유로 들었습니다. 일반 DRAM 계약 가격은 1Q26에 분기 대비 약 93~98% 상승했으며, 3Q26에는 13~18%가 더 오를 것으로 예상되며 여전히 상승 중입니다. 정가(MSRP)를 인용하는 모든 계산기는 CapEx를 수천 달러 과소평가하고 있습니다.
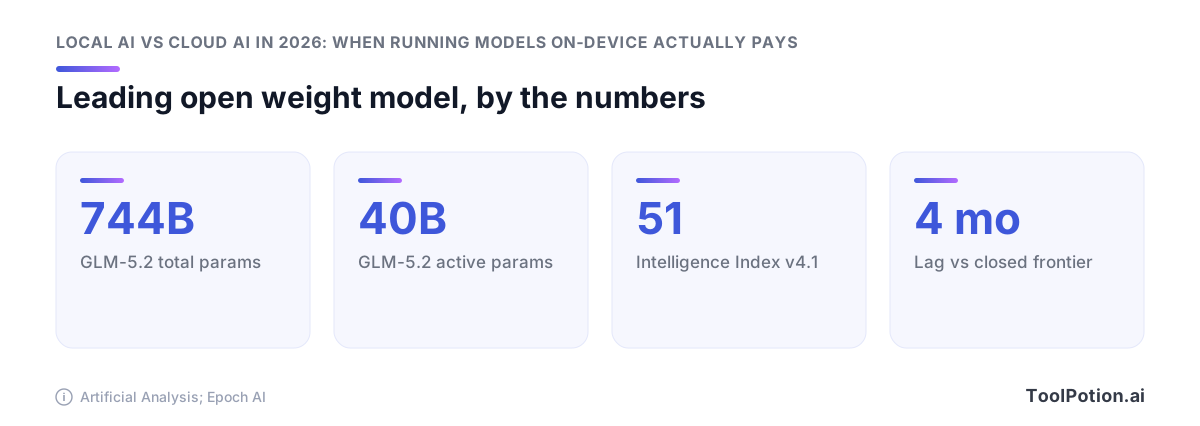
그다음은 성능 격차입니다. Epoch AI는 2026년 1월 이후 격차를 4개월, 즉 8 ECI 포인트로 측정했으며, 이는 2023년 1월부터 2025년 10월까지 측정한 3개월 평균보다 넓습니다. 아무도 인용하지 않는 부분: 그 주장을 뒷받침하는 모델인 GLM-5.2는 전체 744B, 활성 40B 파라미터입니다. 이는 랙 서버용이지 노트북용이 아닙니다.
세 번째 변화가 가장 이상합니다. 2026년 8월 31일, Ollama는 Pro, Max, Team을 토큰당 클라우드 요금제로 전환했습니다. 월 $20, $100, $500 플랜입니다. 기본 '로컬 실행' 도구가 이제 토큰을 판매하면서 비교가 GPU 구매, 저렴한 호스팅 오픈 가중치, 프론티어 API의 3파전이 되었습니다. 저희가 추적하는 AI 모델 중에서 옵션을 검토하고 있다면, 중간 경로의 가격을 먼저 확인하십시오.
그리고 클라우드 측은 어떤 공개 계산기도 모델링하지 않는 방식으로 더 저렴해졌습니다. 기본 입력 가격의 0.1배로 청구되는 프롬프트 캐시 읽기, 추가로 적용되는 50% Batch API 할인, 그리고 1.1배 배수로 제공되는 미국 전용 추론 고정 기능이 있습니다. 마지막 옵션은 사람들이 하드웨어를 구매하는 이유인 데이터 상주 속성을 $4,699 대신 10% 프리미엄으로 제공합니다.
2026년 로컬 모델이 실제로 처리하는 것
2026년 24GB 카드는 우수한 20~30B 혼합 전문가(MoE) 모델을 실행할 수 있으며, 해당 모델은 대부분의 팀이 수용 가능하다고 판단하는 품질로 초안 작성, 요약, 분류, 구조화된 문제 추론을 수행합니다. 또한 훈련 데이터 외부의 모든 내용에 대해 자신 있게 사실을 조작합니다. 이 두 문장이 성능 지형도이며, 대부분의 손익분기 가이드는 두 번째 문장을 건너뜁니다.
소비자 하드웨어 한계는 20~30B MoE 클래스
gpt-oss-20b와 Qwen3-30B-A3B는 단일 소비자 GPU의 실질적인 한계입니다. 두 모델 모두 희소 MoE 설계로, 활성 파라미터 수가 충분히 작아서 24GB 카드가 가중치를 수용하면서도 컨텍스트를 위한 공간이 남습니다. 그 아래에는 7~14B의 밀집형 Llama, Mistral, Phi 클래스 모델이 있으며, 더 편안하게 맞지만 성능을 희생합니다. 저희 오픈 가중치 LLM 목록은 이 범위에 편중되어 있는데, 이것이 사람들이 집에서 실행할 수 있는 것이기 때문입니다.
추론에 강하고 세계 지식에 약함
로컬 30B 모델에 문서를 주고 필드를 추출하거나, 스키마를 따르거나, 단계적 추론을 수행하도록 요청하면 잘 처리합니다. 2024년에 누가 누구를 인수했는지 물어보면 그럴듯한 거짓 정보를 제공합니다.
파라미터 수가 암기된 사실을 얼마나 보유하는지를 결정하며, 소비자 규모 모델은 대부분의 파라미터를 사실 저장에 사용하지 않습니다. 검색이 격차를 줄입니다. 사실을 컨텍스트에 넣고 로컬 모델이 구조화된 부분을 처리하게 하십시오. 검색 레이어 없이 광범위한 회상이 필요한 것은 프론티어 API에 적합합니다.
오픈 모델이 따라잡고 있다는 헤드라인이 사용자가 소유하지 않은 하드웨어에 관한 이야기인 이유
Epoch AI는 2026년 1월 이후 격차를 4개월, 즉 8 ECI 포인트로 측정했으며, 이는 2023년 1월부터 2025년 10월까지 측정한 3개월 평균보다 약간 넓습니다 (Epoch AI). 이 수치는 타당하지만 여러분의 노트북과는 무관합니다. 오픈 가중치 선두 모델인 GLM-5.2는 Artificial Analysis Intelligence Index v4.1에서 전체 744B 파라미터, 활성 40B 파라미터로 51점을 기록합니다 (Artificial Analysis). 이는 데이터센터 하드웨어입니다. 같은 측정에서 GLM-5.2는 작업당 43,000개의 출력 토큰을 소모하며, 그중 37,000개가 추론 토큰으로, 작업당 약 $0.46이 드는 반면 MiniMax-M3은 $0.18입니다.
양자화의 비용
Q4_K_M이 기본값인 데는 이유가 있습니다. Apple M1 Pro의 llama.cpp에서 Mistral-7B-Instruct-v0.2를 사용하면 모델 크기를 7.2GB에서 4.1GB로 43.1% 줄이면서 퍼플렉시티 손실은 0.51%에 불과합니다 (dasroot). Q2_K는 퍼플렉시티 손실 7.94%로 곡선이 꺾이는 지점이며, 벤치마크에서 확인하기 훨씬 전에 명령어 실행에서 그 차이가 느껴집니다. 4비트로 양자화하고 거기서 멈추십시오. 절약한 메모리는 컨텍스트 길이에 투자하십시오.
하드웨어 하한선이 이동했으며, 잘못된 방향으로
여러분이 찾을 수 있는 모든 손익분기 계산기는 정가에 장비를 구매할 수 있다고 가정합니다. 2026년에는 대부분 그렇지 않으며, 정가 자체도 올랐습니다.
확인 가능한 가격으로 보는 메모리 위기
일반 DRAM 계약 가격은 1Q26에 분기 대비 약 93~98% 상승했으며, 2Q26에 추가로 58~63% 올랐고, TrendForce는 3Q26에 13~18% 추가 상승을 예측합니다 (TrendForce). 이는 둔화이지 하락이 아닙니다. 이미 두 배가 된 기준 가격에서 여전히 상승 중입니다. 수요는 여러분에게서 오는 것이 아닙니다. 데이터센터는 2022년 약 20~30%에 비해 2026년 세계 메모리 생산량의 최대 70%를 흡수하고 있으며, HBM만 해도 2024년 8%에 비해 올해 DRAM 웨이퍼의 23%를 차지합니다 (IDC). 로컬 추론은 여러분이 피하려는 클라우드를 구축하는 사람들과 경쟁하는 메모리 용량 구매입니다.
DGX Spark, RTX 5090, 그리고 MSRP와 실제 가격 사이의 격차
NVIDIA는 2026년 2월 DGX Spark를 $3,999에서 $4,699로 인상했으며, 이는 회사가 급등하는 DRAM 및 스토리지 비용에 기인한다고 밝힌 $700 인상입니다 (Notebookcheck). 128GB LPDDR5X가 로컬 모델에 매력적인 이유이자, 가격이 제어할 수 없는 원자재 시장을 따라가는 이유입니다.
비교 게시물에서 인용된 2025년 MSRP는 허구로 취급하십시오. 이번 주 해당 부품의 실제 판매 가격을 확인한 후 그 숫자로 계산을 실행하십시오.
모두가 잊는 항목: 전기 요금
GPU는 일회성 구매이지만 매달 청구서를 보냅니다. 미국 주거용 전기 요금은 2026년 6월 평균 18.34¢/kWh로 전년 대비 5.0% 상승했으며, 주별로 뉴멕시코 8.96¢에서 캘리포니아 28.50¢까지 다양합니다 (EIA). 동일한 장비가 플러그를 어디에 꽂느냐에 따라 3배 이상 다른 운영 비용을 발생시킵니다. 캘리포니아에서는 전기 비용만으로도 동등한 호스팅 토큰 비용에 필적할 수 있습니다. 뉴멕시코에서는 계산이 충분히 달라져서 결론이 바뀝니다.
합리적인 2026년 장비의 비용
현재 실제 가격으로 장비 비용을 예산에 반영하고, 실제 전기 요금으로 전력 소비를 추가하고, 호스팅 엔드포인트가 요구하지 않는 로컬 추론 프레임워크와 양자화 튜닝에 소요하는 시간 비용도 추가하십시오. 연간 수백 달러의 OpEx 꼬리를 가진 수천 달러의 CapEx가 정직한 출발점이며, 모델이 얼마나 좋은지와 무관한 이유로 올해 양쪽 모두 악화되었습니다.
Ollama vs 클라우드 API 비용: 이제 3파전
이제 세 가지 가격이 중요합니다. 구매하는 GPU, 호스팅 오픈 가중치, 그리고 프론티어 API. 중간 옵션이 대부분의 워크로드에서 승리하며, 이것이 거의 모든 공개 손익분기 공식이 포함하지 않는 것입니다.
Ollama 자체가 2026년 8월 31일 클라우드 API가 되었습니다
한 세대의 개발자에게 자신의 머신에서 모델을 실행하는 방법을 가르쳤던 도구가 이제 토큰을 판매합니다. 2026년 8월 31일 Ollama는 Pro, Max, Team을 토큰당 클라우드 요금제로 전환했습니다. 월 $20(사용량 $60 포함), $100(사용량 $300 포함), $500(무제한 사용자 공유 사용량 $1,000 포함)이며, 제로 데이터 보존과 미국 및 유럽 호스팅을 제공합니다 (Ollama). 따라서 "Ollama vs 클라우드"는 더 이상 실제 선택지를 설명하지 않습니다.
호스팅 오픈 가중치: 아무도 모델링하지 않는 중간 옵션
| 모델 | 입력 / 출력 (MTok당) | 출처 |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
그 숫자로 예측을 세우기 전에 세부 조항을 확인하십시오. 대부분의 Ollama Cloud 요금은 평일 12:00~18:00 UTC에 두 배가 됩니다 (Ollama). 이는 청구서를 일정 문제로 만듭니다. 대량 작업을 야간이나 주말로 미루면 표준 요금을 유지할 수 있습니다. 유럽 오후 사용자를 위한 인터랙티브 제품을 운영하면 매 영업일마다 두 배 요금을 냅니다. 이 시간 변수는 비슷한 가격의 두 호스팅 제공업체 사이의 선택보다 더 많은 주의를 기울일 가치가 있습니다.
프론티어 API는 표시 가격보다 더 저렴합니다
캐시 읽기는 기본 입력 가격의 0.1배로 청구되고, Batch API는 입력 및 출력 모두 50% 할인되며, 두 할인은 중첩됩니다 (Anthropic). 배치 처리된 Haiku 4.5는 백만 토큰당 입력 $0.50, 출력 $2.50에 달하며, Sonnet 5는 2026년 9월 1일 예정된 $3/$15 인상 대신 도입 초기 가격 $2/$10를 유지했습니다 (Anthropic). 비동기 대량 작업은 정확히 로컬 장비가 홍보받는 용도이며, 클라우드 할인이 가장 강하게 적용되는 워크로드입니다.
반대 방향으로 작용하는 토크나이저 주석
Claude 4.7 이후 버전은 동일한 텍스트에 대해 약 30% 더 많은 토큰을 생성하는 새 토크나이저를 사용합니다 (Anthropic). 고정된 코퍼스에서 실제 Sonnet 5 청구서는 이전 토크나이저를 사용하는 로컬 모델과 비교할 때 $2/$10 요금표가 시사하는 것보다 약 30% 높습니다. 결정하기 전에 자신의 텍스트로 두 모델 모두에서 토큰을 직접 계산해 보십시오.
손익분기점 계산: GPU가 언제 이기는가?
소유 하드웨어는 2026년 하드웨어 가격과 현지 전기 요금 기준으로, 하루 GPU 지속 사용률이 약 26%, 즉 매일 약 6시간의 실제 작업을 초과하는 지점부터 호스팅 오픈 가중치를 이기기 시작합니다. 그 선 아래에서는 감가상각 시계가 돌아가는 동안 카드가 유휴 상태입니다. 구매 전에 자신의 볼륨을 호스팅 요금과 비교하십시오. deepseek-v4-flash는 Ollama Cloud에서 백만 토큰당 입력 $0.22, 출력 $0.66에 실행됩니다 (Ollama).
로컬이 이기는 경우 (짧고 명확한 목록)
검토를 버티는 네 가지 케이스가 있습니다. 그 외 모든 것은 쉬운 쿼리는 로컬 모델로 라우팅하고 나머지는 에스컬레이션하는 하이브리드 설정입니다.
카드를 바쁘게 유지하는 대량 지속 배치 작업
GPU가 하루의 90%를 유휴 상태로 있다면 공간 히터를 구매한 것입니다. 구매 케이스는 매일 하루의 4분의 1 이상 카드가 작동해야 하며, Claude Batch API와 비교를 견뎌내야 합니다. Claude Batch API는 입력 및 출력 토큰을 50% 할인하고 프롬프트 캐싱과 중첩됩니다 (Anthropic). 이는 Haiku 4.5 배치 작업을 백만 입력 토큰당 $0.50, 출력 $2.50으로 만듭니다. 로컬 장비는 상각된 하드웨어와 전기 비용으로 이를 이겨야 하며, 2026년 6월 미국 주거용 평균 18.34¢/kWh (EIA)에서 실제 부하를 당기는 카드도 공짜가 아닙니다. 스펙 시트가 아닌 실제 토큰 볼륨으로 계산하십시오.
강력한 데이터 주권, CLOUD Act (단순 GDPR 이상)
여기에 실제 카테고리가 있으며, 대부분의 사람들이 주장하는 것보다 더 좁습니다. GDPR 준수는 계약 문제입니다. 미국 관할 기관이 데이터를 강제로 제출할 수 없다는 요건은 물리적 문제이며, 물리적 문제는 통제하는 하드웨어로 해결합니다.
첫 번째 토큰까지의 시간이 제품인 인터랙티브 루프
로컬 추론은 클라우드의 200~800ms에 비해 첫 번째 토큰까지 50~200ms를 제공하며, Claude Haiku 4.5는 597ms, GPT-4.1 Mini는 약 2,400ms로 측정되었습니다 (Eden AI). 채팅 창에서는 아무도 느끼지 못합니다. 인라인 코드 완성이나 8번의 호출을 연결하는 멀티 스텝 에이전트에서는 그 차이가 사용자가 느끼는 무언가로 누적됩니다. 그런 형태로 구축한다면 저희 디렉토리의 AI 에이전트를 살펴보고 그 중 몇 개가 키 입력마다 왕복 통신을 하는지 확인하십시오.
오프라인 및 에어갭 운영
할 말이 없습니다. 네트워크가 있거나 없거나입니다.
클라우드가 이제 되팔고 있는 프라이버시 논거
두 번째 케이스에 대한 가장 강력한 반론은 Anthropic이 해당 속성을 직접 판매한다는 것입니다. Claude 4.6 이후 버전에서 inference_geo: "us"로 추론을 미국 전용으로 고정하면 모든 토큰 카테고리에 1.1배 배수가 적용됩니다 (Anthropic). $4,699의 DGX Spark 대신 10% 프리미엄입니다. 한편 Ollama의 유료 플랜은 2026년 8월 31일부로 미국 및 유럽 호스팅에서 제로 데이터 보존을 광고합니다 (Ollama). 프라이버시 요건이 계약적 보장과 지리적 고정으로 충족된다면 하드웨어 요건은 없습니다.
대부분의 실무자가 정착하는 하이브리드 설정
원칙이 아닌 난이도에 따라 라우팅하십시오. 자신의 카드에 있는 20~30B MoE 모델은 일반적인 어시스턴트 또는 문서 처리 워크로드에서 약 10개 중 7개의 쿼리를 처리하고, 나머지 3개는 프론티어 API로 넘어갑니다. 그 분할이 아키텍처입니다. 나머지는 모두 튜닝입니다.
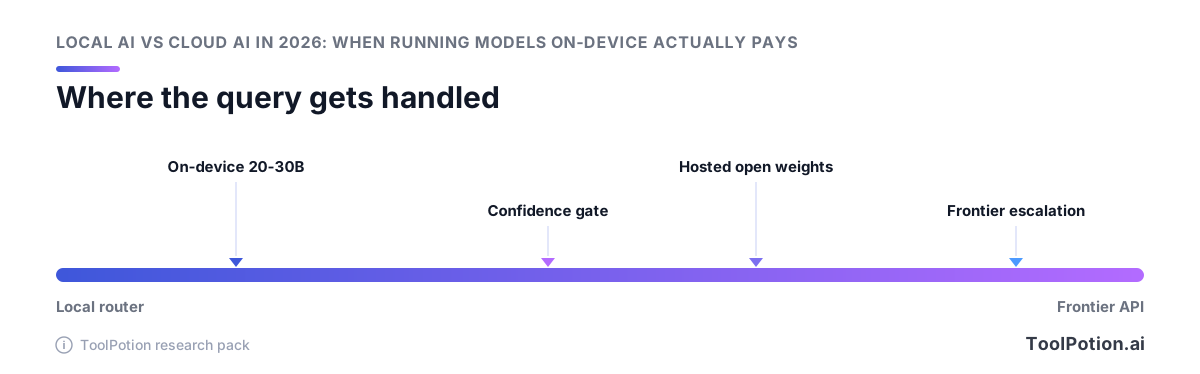
세 가지 신호가 에스컬레이션을 결정하며, 로컬 모델이 완료되기 전에 모두 계산할 수 있습니다. 모델 자체의 신뢰도(로그 확률 마진 또는 저렴한 자가 검사), 쿼리에 로컬 가중치가 없는 세계 지식이 필요한지 여부, 그리고 컨텍스트 길이입니다. 지식 신호가 대부분의 실패를 잡아냅니다. 24GB 클래스 모델은 추론은 잘하지만 회상은 서투르므로, '2025년에 누가 누구를 인수했는가'와 같은 것은 로컬을 완전히 건너뛰어야 합니다.
실제로 작동하는 구체적인 스택
앞에 Ollama 또는 LM Studio, 뒤에 프론티어 API 하나, 그 사이에 모든 결정을 기록하는 얇은 라우터.
에스컬레이션된 트래픽을 먼저 Claude Haiku 4.5($1/MTok 입력, $5/MTok 출력)로 보내고, Haiku의 답변이 검사를 통과하지 못할 때만 Sonnet 5($2/$10)에 접근하십시오 (Anthropic pricing). 에스컬레이션된 작업이 비동기라면 배치 처리하십시오. Batch API는 양쪽을 반으로 줄이므로 Haiku는 $0.50/$2.50에 달합니다. 대부분의 팀은 이를 건너뛰고 20분을 기다릴 수 있었던 작업에 정가를 냅니다.
에스컬레이션 비율을 측정하지 않으면 깜깜이 운항
요청당 네 가지 숫자를 기록하십시오. 어떤 계층이 처리했는지, 로컬 모델의 신뢰도, 토큰 수, 그리고 사람이 답변을 재시도했는지 여부. 재시도 비율이 실제 품질 신호입니다. 에스컬레이션이 약 20% 미만이면 로컬 모델이 처리하지 말아야 할 것에 답하고 있으며 재시도에서 확인할 수 있습니다. 45% 초과이면 GPU가 감가상각을 벌어내지 못하고 있습니다.
경계선이 분기마다 이동하는 이유
양쪽 가격이 아키텍처보다 빠르게 움직입니다. Ollama는 2026년 8월 31일 Pro, Max, Team을 토큰당 클라우드 요금으로 재조정했고 (Ollama), Ollama Cloud 요금은 평일 12:00~18:00 UTC에 두 배가 되며 (Ollama pricing), 오픈 가중치 성능은 2026년 1월 이후 평균 약 4개월 동안 클로즈드 프론티어 모델보다 뒤처집니다 (Epoch AI). 분기에 한 번 라이브 숫자로 라우팅 임계값을 재실행하십시오. 캘린더에 등록하십시오.
툴링 레이어는 구축할 만큼 안정적
Ollama는 14명 팀으로 월간 활성 개발자 890만 명을 운영하며, Fortune 500의 85%에 탑재되어 있고, 2026년 7월 Theory Ventures 주도로 $65M을 유치했습니다 (TechCrunch). 이는 내년에 사라질 프로젝트가 아닙니다. 그 주변의 라우터 접합부가 여러분이 소유하는 부분이며, 이미 이 패턴을 발행하는 오픈소스 AI 저장소에서 대부분을 가져올 수 있습니다.
다섯 가지 질문으로 결정하기
순서대로 답하십시오. 확실한 '예'를 주는 첫 번째 질문이 설정을 결정하며, 거기서 멈출 수 있습니다.
강력한 데이터 주권 요건이 있습니까?
강력하다는 것은 에어갭, 법무팀이 문서화한 CLOUD Act 노출, 또는 머신을 명시하는 계약을 의미합니다. 해당한다면 하드웨어를 구매하고 비용 섹션 읽기를 중단하십시오. 요건이 그보다 약하다면, Anthropic은 Claude 4.6 이후 버전에서 inference_geo: "us"로 모든 토큰 카테고리에 1.1배 배수를 적용하여 추론을 미국 전용으로 고정할 수 있으며 (Anthropic pricing docs), Ollama의 유료 플랜은 미국 및 유럽에서 제로 데이터 보존으로 운영됩니다 (Ollama). 10% 프리미엄이 거의 모든 사람에게 $4,699의 하드웨어보다 낫습니다.
작업이 지연 시간에 민감한가요, 처리량에 민감한가요?
모든 토큰을 사람이 기다리는 인터랙티브 루프는 로컬에 유리합니다. 클라우드의 200~800ms에 비해 첫 번째 토큰까지 50~200ms이며, Claude Haiku 4.5는 597ms로 측정되었습니다 (Eden AI). 처리량 작업은 반대입니다. 배치 처리하여 50% 할인을 받으면 Haiku 4.5는 입력 $0.50/MTok, 출력 $2.50에 달합니다 (Anthropic).
GPU가 하루의 4분의 1 이상 바쁠 것인가요?
그 선 아래에서는 카드가 유휴 상태로 감가상각되고 호스팅 오픈 가중치가 비용에서 이깁니다. 그 위에서는 로컬 계산이 작동하기 시작합니다. 분모에 대해 솔직하십시오. 야간과 주말도 계산에 포함됩니다.
작업에 세계 지식이 필요합니까, 아니면 추론만 필요합니까?
제공하는 텍스트에 대한 추론은 20~30B MoE 모델에서 잘 실행됩니다. 모델이 이미 알고 있어야 하는 사실에 의존하는 질문은 프론티어 API 또는 호스팅 GLM-5.2(전체 744B 파라미터로 노트북에 절대 맞지 않음)에 적합합니다 (Artificial Analysis).
분기마다 재튜닝을 감내할 수 있습니까?
오픈-클로즈드 격차는 4개월로, 3개월 평균에서 이동했습니다 (Epoch AI). 따라서 라우팅 임계값의 유효 기간이 있습니다. 재검토하지 않을 팀은 캐싱을 켜고 프론티어 API를 기본으로 사용하며 아무것도 라우팅하지 않아야 합니다. 재검토할 팀은 다른 사람들의 임계값이 어떻게 되었는지 알기 위해 실제 배포 사례 연구를 살펴볼 수 있습니다.
2027년에 이 판단을 바꿀 것들
이 조언에는 만료일이 있으며, 세 가지 구체적인 숫자가 그것을 설정합니다.
메모리 가격은 하락이 아닌 둔화 중
일반 DRAM 계약 가격은 1Q26에 분기 대비 약 93~98% 상승한 후 2Q26에 58~63%, 3Q26에는 13~18% 전망입니다. 그 곡선은 평탄해지고 있습니다. 여전히 위를 향하고 있습니다. 상승 속도 둔화가 NVIDIA가 2026년 2월 DGX Spark에 추가한 $700를 돌려주지 않으며, 내년에 실제 가격이 하락한다는 예측도 없습니다. 데이터센터 수요가 완화되지 않는 한 2027년 내내 하드웨어 케이스는 약한 상태로 계획하십시오.
헤드라인 벤치마크가 아닌 오픈/클로즈드 격차를 주시하십시오
리더보드 순위보다 두 가지 신호가 더 중요합니다. 첫째는 2026년 1월 이후 4개월, 즉 8포인트에 달하는 Epoch AI의 ECI 격차입니다. 둘째는 활성 파라미터 수입니다. GLM-5.2는 오픈 가중치에서 전체 744B 중 40B 활성으로 선두이므로, 30B 미만 활성 모델이 프론티어와 몇 ECI 포인트 이내로 도달하는 날 24GB 카드가 다시 흥미로워집니다. 또한 Ollama의 피크 시간대 두 배 요금(12:00~18:00 UTC 평일)이 지속되는지 정상화되는지도 주시하십시오. 저희 AI 트렌드 리포트는 이 중 하나라도 바꿀 모델 출시를 추적합니다.
자주 묻는 질문
2026년에는 LLM을 로컬로 실행하는 것과 클라우드 API를 사용하는 것 중 어느 것이 더 저렴합니까?
대부분의 사람들에게는 클라우드이며, 2026년에 격차가 벌어졌습니다. Claude Haiku 4.5는 백만 입력 토큰당 $1, 출력 $5로 표시되지만 Batch API를 통해 $0.50/$2.50으로 낮아지고, 프롬프트 캐시 히트는 기본 입력 요금의 0.1배로 청구됩니다 (Anthropic pricing). 반면 NVIDIA DGX Spark는 DRAM 및 스토리지 비용으로 2026년 2월 $3,999에서 $4,699로 올랐으며 (Notebookcheck), 2026년 6월 미국 주거용 평균 18.34¢/kWh로 전기 요금도 냅니다 (EIA). 로컬은 매일 상당한 시간 동안 카드를 바쁘게 유지하는 대량 지속 배치 작업, 에어갭 운영, 지연 시간에 민감한 루프에서 수익을 냅니다.
2026년에 LLM을 로컬로 실행하려면 어떤 하드웨어가 필요합니까?
24GB GPU가 실질적인 소비자 하한선이며, 오픈 가중치 프론티어와 거리가 있는 20~30B 혼합 전문가 클래스로 제한됩니다. 그 위로는 현재 $4,699인 DGX Spark 같은 128GB LPDDR5X 박스를 구매해야 합니다 (Notebookcheck). 계속 오르는 메모리 가격을 예산에 반영하십시오. 일반 DRAM 계약 가격은 1Q26에 분기 대비 약 93~98%, 2Q26에 58~63% 상승했으며, 3Q26에 13~18% 추가 상승이 예측됩니다 (TrendForce). 양자화는 수용 가능한 것을 늘리며, 4비트는 거의 무료입니다. Q4_K_M은 퍼플렉시티 손실 0.51%로 Mistral-7B-Instruct-v0.2를 7.2 GB에서 4.1 GB로 줄였으며, Q2_K는 7.94%에서 급격히 저하되었습니다 (양자화 트레이드오프).
로컬 모델은 Claude나 GPT에 비해 얼마나 좋습니까?
널리 인용되는 격차는 실재하지만 여러분이 아마 소유하지 않는 하드웨어를 설명합니다. Epoch AI는 2026년 1월 이후 오픈 가중치 모델이 클로즈드 프론티어 모델보다 평균 4개월, 즉 8 ECI 포인트 뒤처진다고 측정했으며, 이는 2023년 1월부터 2025년 10월까지의 3개월 평균보다 약간 넓습니다 (Epoch AI). 그 주장을 뒷받침하는 모델인 GLM-5.2는 Artificial Analysis Intelligence Index v4.1에서 전체 744B, 활성 40B 파라미터로 51점을 기록하며, 이는 데이터센터 하드웨어입니다 (Artificial Analysis). 노트북이나 단일 GPU에 실제로 맞는 것은 구조화된 추론에 강하고 세계 지식에 약하므로, 4개월 수치를 집에서 도달할 수 없는 상한선으로 처리하십시오.
Ollama는 여전히 무료이며, Ollama Cloud 요금은 프론티어 API와 어떻게 비교됩니까?
로컬 대 Ollama 프레이밍은 2026년 8월 31일 Ollama가 Pro, Max, Team 플랜을 토큰당 클라우드 요금제로 전환하면서 더 이상 의미가 없어졌습니다. 월 $20(사용량 $60 포함), $100(사용량 $300 포함), $500(무제한 사용자 공유 사용량 $1,000 포함)이며, 미국 및 유럽에서 제로 데이터 보존으로 호스팅됩니다 (Ollama blog). 호스팅 오픈 가중치는 거기서 저렴합니다. deepseek-v4-flash는 백만 토큰당 입력 $0.22, 출력 $0.66, nemotron-3-super는 $0.015/$0.60, qwen3.5:397b는 $0.60/$3.60이며, 대부분의 요금은 평일 12:00~18:00 UTC 피크 시간에 두 배가 됩니다 (Ollama pricing). Claude Haiku 4.5의 $1/$5 (Anthropic pricing)와 비교하면 실제 결정은 3파전이며, 호스팅 오픈 가중치는 대부분의 워크로드에서 비용 면에서 자체 GPU를 이깁니다. Ollama는 월간 활성 개발자 890만 명, Fortune 500의 85%라는 규모로 어느 쪽에서도 진지하게 받아들여집니다 (TechCrunch).
로컬에서 모델을 실행하면 클라우드 API보다 실제로 데이터가 더 안전합니까?
다른 어떤 것도 제공하지 않는 한 가지 속성, 즉 바이트가 머신을 떠나지 않는다는 것을 제공하며, 이는 에어갭 작업과 CLOUD Act 같은 강력한 데이터 주권 요건에 중요합니다. 그보다 약한 모든 것에 대해 제공업체는 이제 동일한 보장을 저렴하게 판매합니다. Claude 4.6 이후 버전에서 inference_geo: "us"로 추론을 미국 전용으로 고정하면 모든 토큰 카테고리에 1.1배 배수가 적용되며 (Anthropic pricing), Ollama의 유료 플랜은 미국 및 유럽에서 제로 데이터 보존으로 운영됩니다 (Ollama blog). 10% 프리미엄은 $4,699의 하드웨어보다 훨씬 적은 헌신입니다 (Notebookcheck).
24GB GPU에서 시작하기에 가장 좋은 로컬 모델은 무엇입니까?
Qwen3-30B-A3B 또는 gpt-oss-20b 같은 20~30B 혼합 전문가 모델을 Q4_K_M으로 양자화하여 시작하십시오. 이 클래스는 단일 RTX 5090에서 AIME 2024를 73~87% 달성하므로 추론은 잘 유지되지만 세계에 대한 사실 회상은 약합니다. Q4_K_M이 적절한 양자화 중단점입니다. 7.2 GB 모델을 퍼플렉시티 손실 0.51%로 4.1 GB로 줄였으며, Q2_K는 7.94%에서 급격히 저하되었습니다 (양자화 트레이드오프). 첫 번째 홉으로 실행하고 지식이 많이 필요한 쿼리는 클라우드 모델로 에스컬레이션하십시오.