

오픈 웨이트 모델은 이제 최상위 폐쇄형 모델에 꽤 가까워졌습니다. 많은 작업에서 진짜 문제는 더 이상 품질이 아닙니다. 누가 모델을 돌리는지, 내 데이터가 어디로 가는지, 라이선스가 무엇을 허용하는지가 관건입니다. Bloomberg Intelligence는 주요 벤치마크에서 중국 최상위 모델과 미국 선두 모델의 격차를 약 3%로 봅니다. 올해 초에는 약 15%였습니다(AI Weekly, Bloomberg 인용).
이 변화는 개발자, 스타트업, 개인정보 규정이 있는 팀에 가장 중요합니다. 이제 Hugging Face에서 모델을 받아 직접 관리하는 하드웨어에서 돌릴 수 있고, 1년 전만 해도 유료 API 뒤에 있던 수준의 코딩·에이전트 성능을 얻을 수 있습니다. 하드웨어 없이 저렴한 호스트를 통해 같은 가중치를 API로 호출해도 됩니다.
장점만 있는 것은 아닙니다. "오픈"이라고 해도 라이선스는 무엇이든 해도 되는 것부터 세부 조항을 꼼꼼히 읽어야 하는 것까지 다양합니다. 가장 큰 모델 중 일부는 GPU 랙이 통째로 필요하고, 몇몇은 보안과 검열 문제를 안고 있습니다. 이 글에서는 현재 선두 모델을 정리하고 비용을 보여드리며 선택 기준을 제시합니다. 폐쇄형과 오픈 모델 전체를 보고 싶다면 Top 25 LLM 보드를 참고하세요.
격차는 줄었고, 라인업도 바뀌었습니다
핵심은 벤치마크 격차이니, 그 뒤에 무엇이 있는지 보겠습니다. Bloomberg 측정에서 중국 최상위 모델은 올해 초 약 15%, 중반 무렵 약 9%, 한 달 뒤 약 6% 뒤처져 있었고, 당시에는 역대 최저였습니다(The Next Web). 최근 측정값은 약 3%입니다. 가장 새로운 데이터는 DeepSeek V4.1 Flash로, LiveBench에서 81.1점을 받아 선두 Anthropic 모델의 83.4점에 근접했고, 이 벤치마크의 에이전트 코딩 하위 테스트에서는 77.3 대 66.1로 앞섭니다.
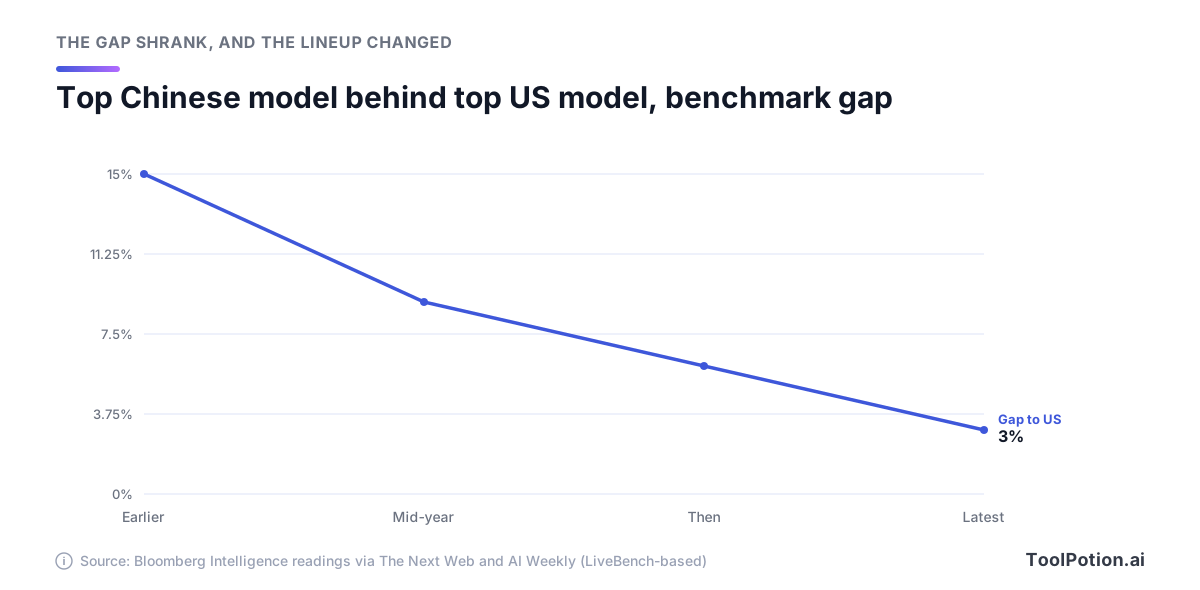
단서도 염두에 두셔야 합니다. LiveBench 상위 15개 중 중국 모델은 세 개뿐이라 전면적인 역전이 아니라 최전선에서 벌어진 일입니다. 또 이 격차는 하나의 벤치마크에서 양쪽 최고 모델을 비교한 값이며, 두 출처 모두 오픈 모델에만 한정된다고 밝히지는 않았습니다. 그래도 방향은 분명하고, 격차를 좁힌 DeepSeek V4.1 Flash는 오픈 웨이트입니다.
올해는 두 가지가 더 바뀌었습니다. 첫째, Qwen이 처음으로 Max급 모델을 오픈 웨이트로 공개했습니다. Qwen3.8-2.4T-A95B 모델 카드에 따른 내용입니다. 둘째, Meta의 오픈 공개 행보가 달라졌습니다. Meta의 Hugging Face 페이지에서 가장 최신 Llama는 여전히 2025년 Llama 4 계열이며, Llama 4 Scout 같은 모델입니다. Meta 개발자 사이트는 이제 자체 호스팅 모델인 Muse Spark를 앞세우고, 오픈 모델로는 로컬 에이전트용 30B 오픈 웨이트 모델인 Muse Glimmer를 올려두었습니다.
Mistral도 소식이 있습니다. 1조 파라미터에 활성 520억인 Mistral Large 4를 막 발표하고 API로 프리뷰를 공개했습니다. 가중치는 이달 말까지 공개하겠다고 밝혔습니다(Mistral). 이 글을 쓰는 시점에는 다운로드할 수 없었고 라이선스도 공개되지 않았으므로, Large 4는 출시가 아니라 예고로 보셔야 합니다. 가중치와 라이선스가 Hugging Face에 올라오기 전에는 계획에 넣지 마세요.
알아둘 만한 오픈 웨이트 모델
현재 선두 모델을 한눈에 정리했습니다. 크기와 라이선스는 각 모델의 Hugging Face 카드, 가격은 각 개발사의 가격 페이지 기준입니다. "활성"은 mixture-of-experts 모델에서 토큰당 작동하는 파라미터 수이며, 속도를 좌우합니다.
| 모델 | 라이선스 | 크기(활성) | 컨텍스트 | 개발사 API, 100만 토큰당 $ 입력 / 출력 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B~16B) | 1M | 0.30 / 1.20 (피크) |
| DeepSeek V4-Pro | MIT | 1.7T | 1M | 1.32 / 3.96 (피크) |
| Kimi K3 | Kimi K3 License | 2.8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B 덴스 | 262K | 호스팅 버전 출시 예정 |
| gpt-oss-120b | Apache 2.0 | 117B (5.1B) | 해당 없음 | 개발사 API 없음 |
| Gemma 4 31B | Apache 2.0 | 31B 덴스 | 256K | 개발사 API 없음 |
| Muse Glimmer | Apache 2.0 | 30B 덴스 | 131K+ | 개발사 API 없음 |
| Mistral Large 4 | 미공개 | 1T (52B) | 해당 없음 | 1.36 / 4.18 (프리뷰) |
비용 면에서 안전한 기본 선택은 DeepSeek입니다. V4.1 Flash 가중치는 MIT 라이선스이고, API 가격은 대형 모델 중 가장 낮으며, 비피크 시간대에는 반값으로 더 내려갑니다(DeepSeek 문서). 이름에 속지 마세요. 여기서 "Flash"는 763B 모델이고 다운로드 용량이 510GB입니다(모델 카드). V4-Pro-0813은 약 1.7T로 더 큽니다.
Kimi K3는 가장 화제가 된 모델입니다. 2.8조 파라미터에 활성 1,040억으로, 자체 카드 기준 GPQA Diamond 93.5, BrowseComp 91.2를 기록했습니다. Moonshot이 발표한 수치이니 주장으로 읽으시기 바랍니다. 또 Moonshot의 API는 오픈 모델 그룹에서 가장 비싸서 의외라는 반응이 많습니다(아래에서 자세히 다룹니다).
Z.ai의 GLM-5.3은 코딩 특화 모델입니다. GLM-5.2와 베이스 모델이 같고, Z.ai는 자체 코딩 벤치마크 50% 상승을 포함한 모든 향상이 post-training에서 나왔다고 설명합니다(모델 카드). 이는 벤더가 직접 측정한 값입니다. 저렴한 Flash 버전인 GLM-5.3-Flash는 입력 $0.15, 출력 $0.50입니다.
Qwen은 라인업의 폭이 가장 넓습니다. Qwen3.8-27B는 Apache 2.0의 27B 덴스 모델로, 비전을 지원하고 네이티브 컨텍스트가 262K이며 SWE-bench Pro 61.7이 보고되었습니다(모델 카드). 워크스테이션 한 대에서 코딩과 에이전트 작업을 처음 시도하기에 가장 좋고, 대부분의 소규모 팀에게도 시작점으로 삼기 좋은 모델입니다. 대형 Qwen3.8-2.4T는 별도 라이선스를 쓰며, 바로 다음에서 다룹니다. 앱으로도 Qwen을 써볼 수 있습니다.
OpenAI의 gpt-oss-120b는 이제 오래됐지만 여전히 쓸모 있습니다. Apache 2.0이고 활성 파라미터는 5.1B이며, OpenAI에 따르면 80GB GPU 한 장에서 돌아갑니다(모델 카드). 2025년에 공개되었고, OpenAI의 Hugging Face 페이지에는 더 새로운 gpt-oss가 보이지 않았습니다. Gemma 4는 현재 Google 계열이며, 31B 모델은 Apache 2.0에 256K 윈도우를 갖추고 Ollama와 llama.cpp용 양자화 빌드도 제공합니다(모델 카드). Muse Glimmer는 작은 모델입니다. Meta에 따르면 약 4비트 버전은 20GB 미만이고 24GB 또는 32GB 환경에서 돌아가며, 더 빡빡한 설정에서는 품질 손실이 약 1%입니다(모델 카드).
유럽에는 현재 두 가지 선택지가 있습니다. Mistral Medium 3.5는 256K 윈도우의 덴스 128B 모델이며, 수정된 MIT 라이선스를 씁니다. Mistral은 매출이 큰 기업을 제외하고 상업적 사용이 가능한 오픈이라고 설명합니다. 119B인 Mistral Small 4와 이전 모델 Mistral Large 3는 Hugging Face에서 Apache 2.0으로 공개되어 있습니다.
"오픈"에도 조건이 붙을 수 있습니다
대부분의 개발자가 생각하는 의미의 오픈은 Apache 2.0과 MIT 모델뿐입니다. 가장 강력한 모델 중 여럿은 그렇지 않습니다. 헤드라인이 아니라 라이선스 파일을 읽으세요.
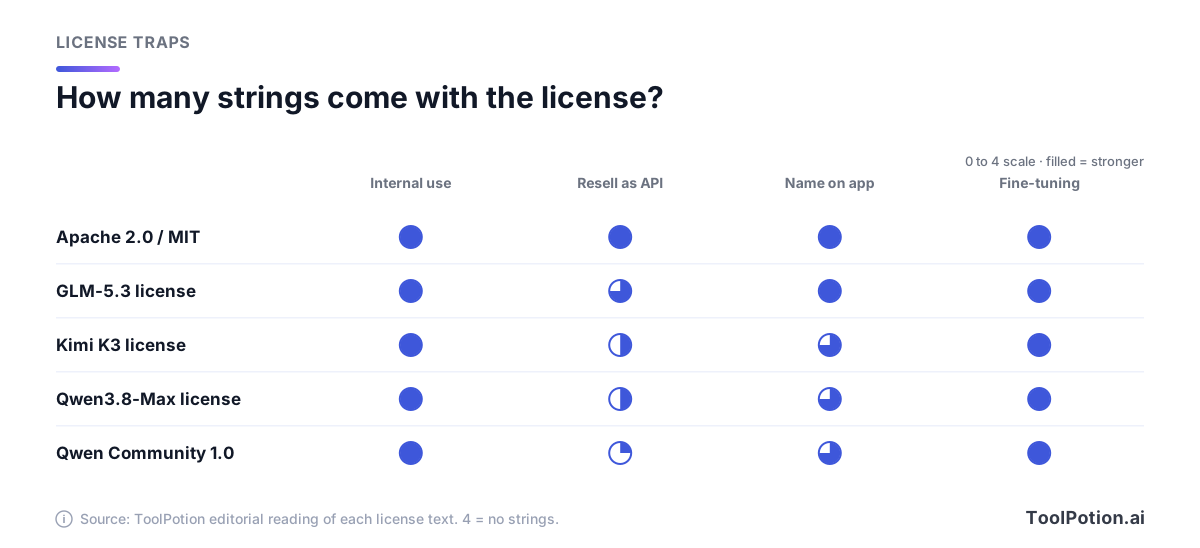
커스텀 라이선스는 모두 패턴이 같습니다. 사용, 수정, 파인튜닝은 자유롭습니다. 조건은 모델을 다른 사람에게 파는 경우, 대개 API로 제공하면서 매출 기준선을 넘을 때 붙습니다. 예를 들어 Moonshot 라이선스는 12개월간 매출이 2,000만 달러를 넘는 "Model as a Service" 사업자가 상업적으로 쓰려면 별도 계약이 필요하다고 규정합니다. 월 사용자 1억 명 또는 월 매출 2,000만 달러를 넘는 제품은 인터페이스에 "Kimi K3"를 표시해야 합니다(라이선스 원문). 내부 사용은 예외입니다.
Z.ai 라이선스는 더 느슨합니다. 유일한 관문은 매출 100억 달러를 넘는 Model-as-a-Service 사업자에 대한 보안 심사입니다. Qwen 라이선스는 이 그룹에서 가장 엄격합니다. Qwen3.8-Flash-Next의 Qwen Community License는 Model-as-a-Service 또는 "AI Work Assistant" 사업을 하는 기업이 먼저 Qwen에서 별도 라이선스를 받아야 한다고 정하며, 내부 사용은 예외입니다(라이선스 원문). 2.4T 모델의 Max 라이선스는 이 기준을 매출 5,000만 달러로 높입니다.
이런 모델 위에 앱을 만든다면 거의 확실히 문제없습니다. 제품이 "이 모델을 서빙하는 API"라면 출시 전에 변호사와 함께 라이선스를 검토하세요. 조금의 의심도 없애고 싶다면 Apache 2.0이나 MIT를 쓰세요. DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4, Muse Glimmer가 해당합니다.
호스팅 API 비용
오픈 웨이트라고 API가 싸다는 뜻은 아닙니다. 누가 모델을 호스팅하느냐에 따라 상황이 달라집니다.
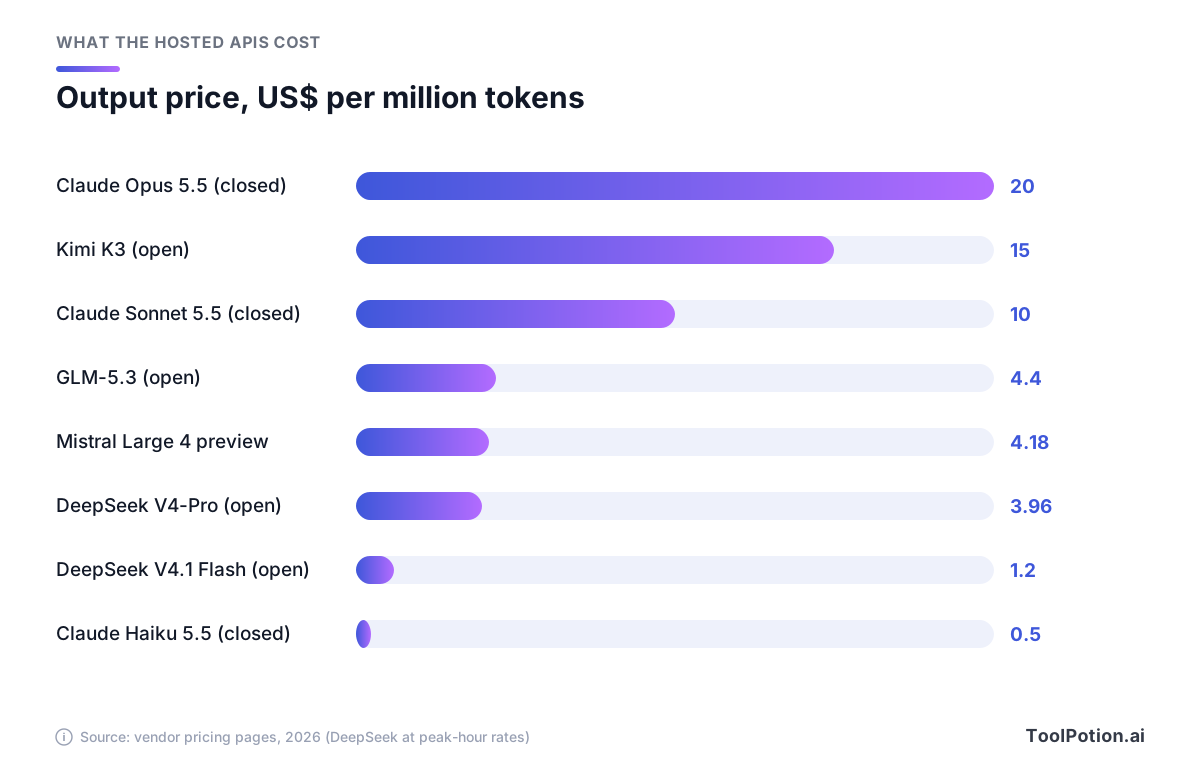
Moonshot은 가격 페이지 기준으로 Kimi K3에 100만 토큰당 입력 $3, 출력 $15를 받습니다. 폐쇄형인 Anthropic의 Claude Sonnet 5.5($2 / $10)보다 비쌉니다. DeepSeek는 반대입니다. V4-Pro 출력은 피크 $3.96, 비피크 $1.98입니다. Z.ai의 GLM-5.3은 입력 $1.40, 출력 $4.40입니다.
폐쇄형 소형 모델이 대부분의 오픈 플래그십보다 쌉니다. 각 벤더의 가격 페이지에 따르면 Claude Haiku 5.5는 입력 $0.10, 출력 $0.50이고, OpenAI의 GPT-6 Luna도 같습니다. 따라서 "오픈으로 가면 절약된다"는 말은 비싼 폐쇄형 등급과 비교할 때, 그리고 저렴한 오픈 호스트를 고를 때만 성립합니다.
가장 저렴한 길은 같은 가중치를 서비스하는 서드파티인 경우가 많습니다. OpenRouter 공개 모델 목록에서 gpt-oss-120b는 100만 토큰당 입력 약 $0.04, 출력 약 $0.17이며, 가격은 제공업체마다 다르고 자주 바뀝니다. OpenRouter, Together AI, Fireworks AI, Groq는 모두 하나의 API 형식 뒤에서 오픈 모델을 재판매하므로, 제공업체를 바꾸는 것은 base URL만 바꾸면 됩니다.
직접 돌릴까, 호스트를 쓸까
오픈 모델을 돌리는 방법은 네 가지이며, 단계가 올라갈수록 통제권은 조금씩, 할 일은 조금씩 늘어납니다.
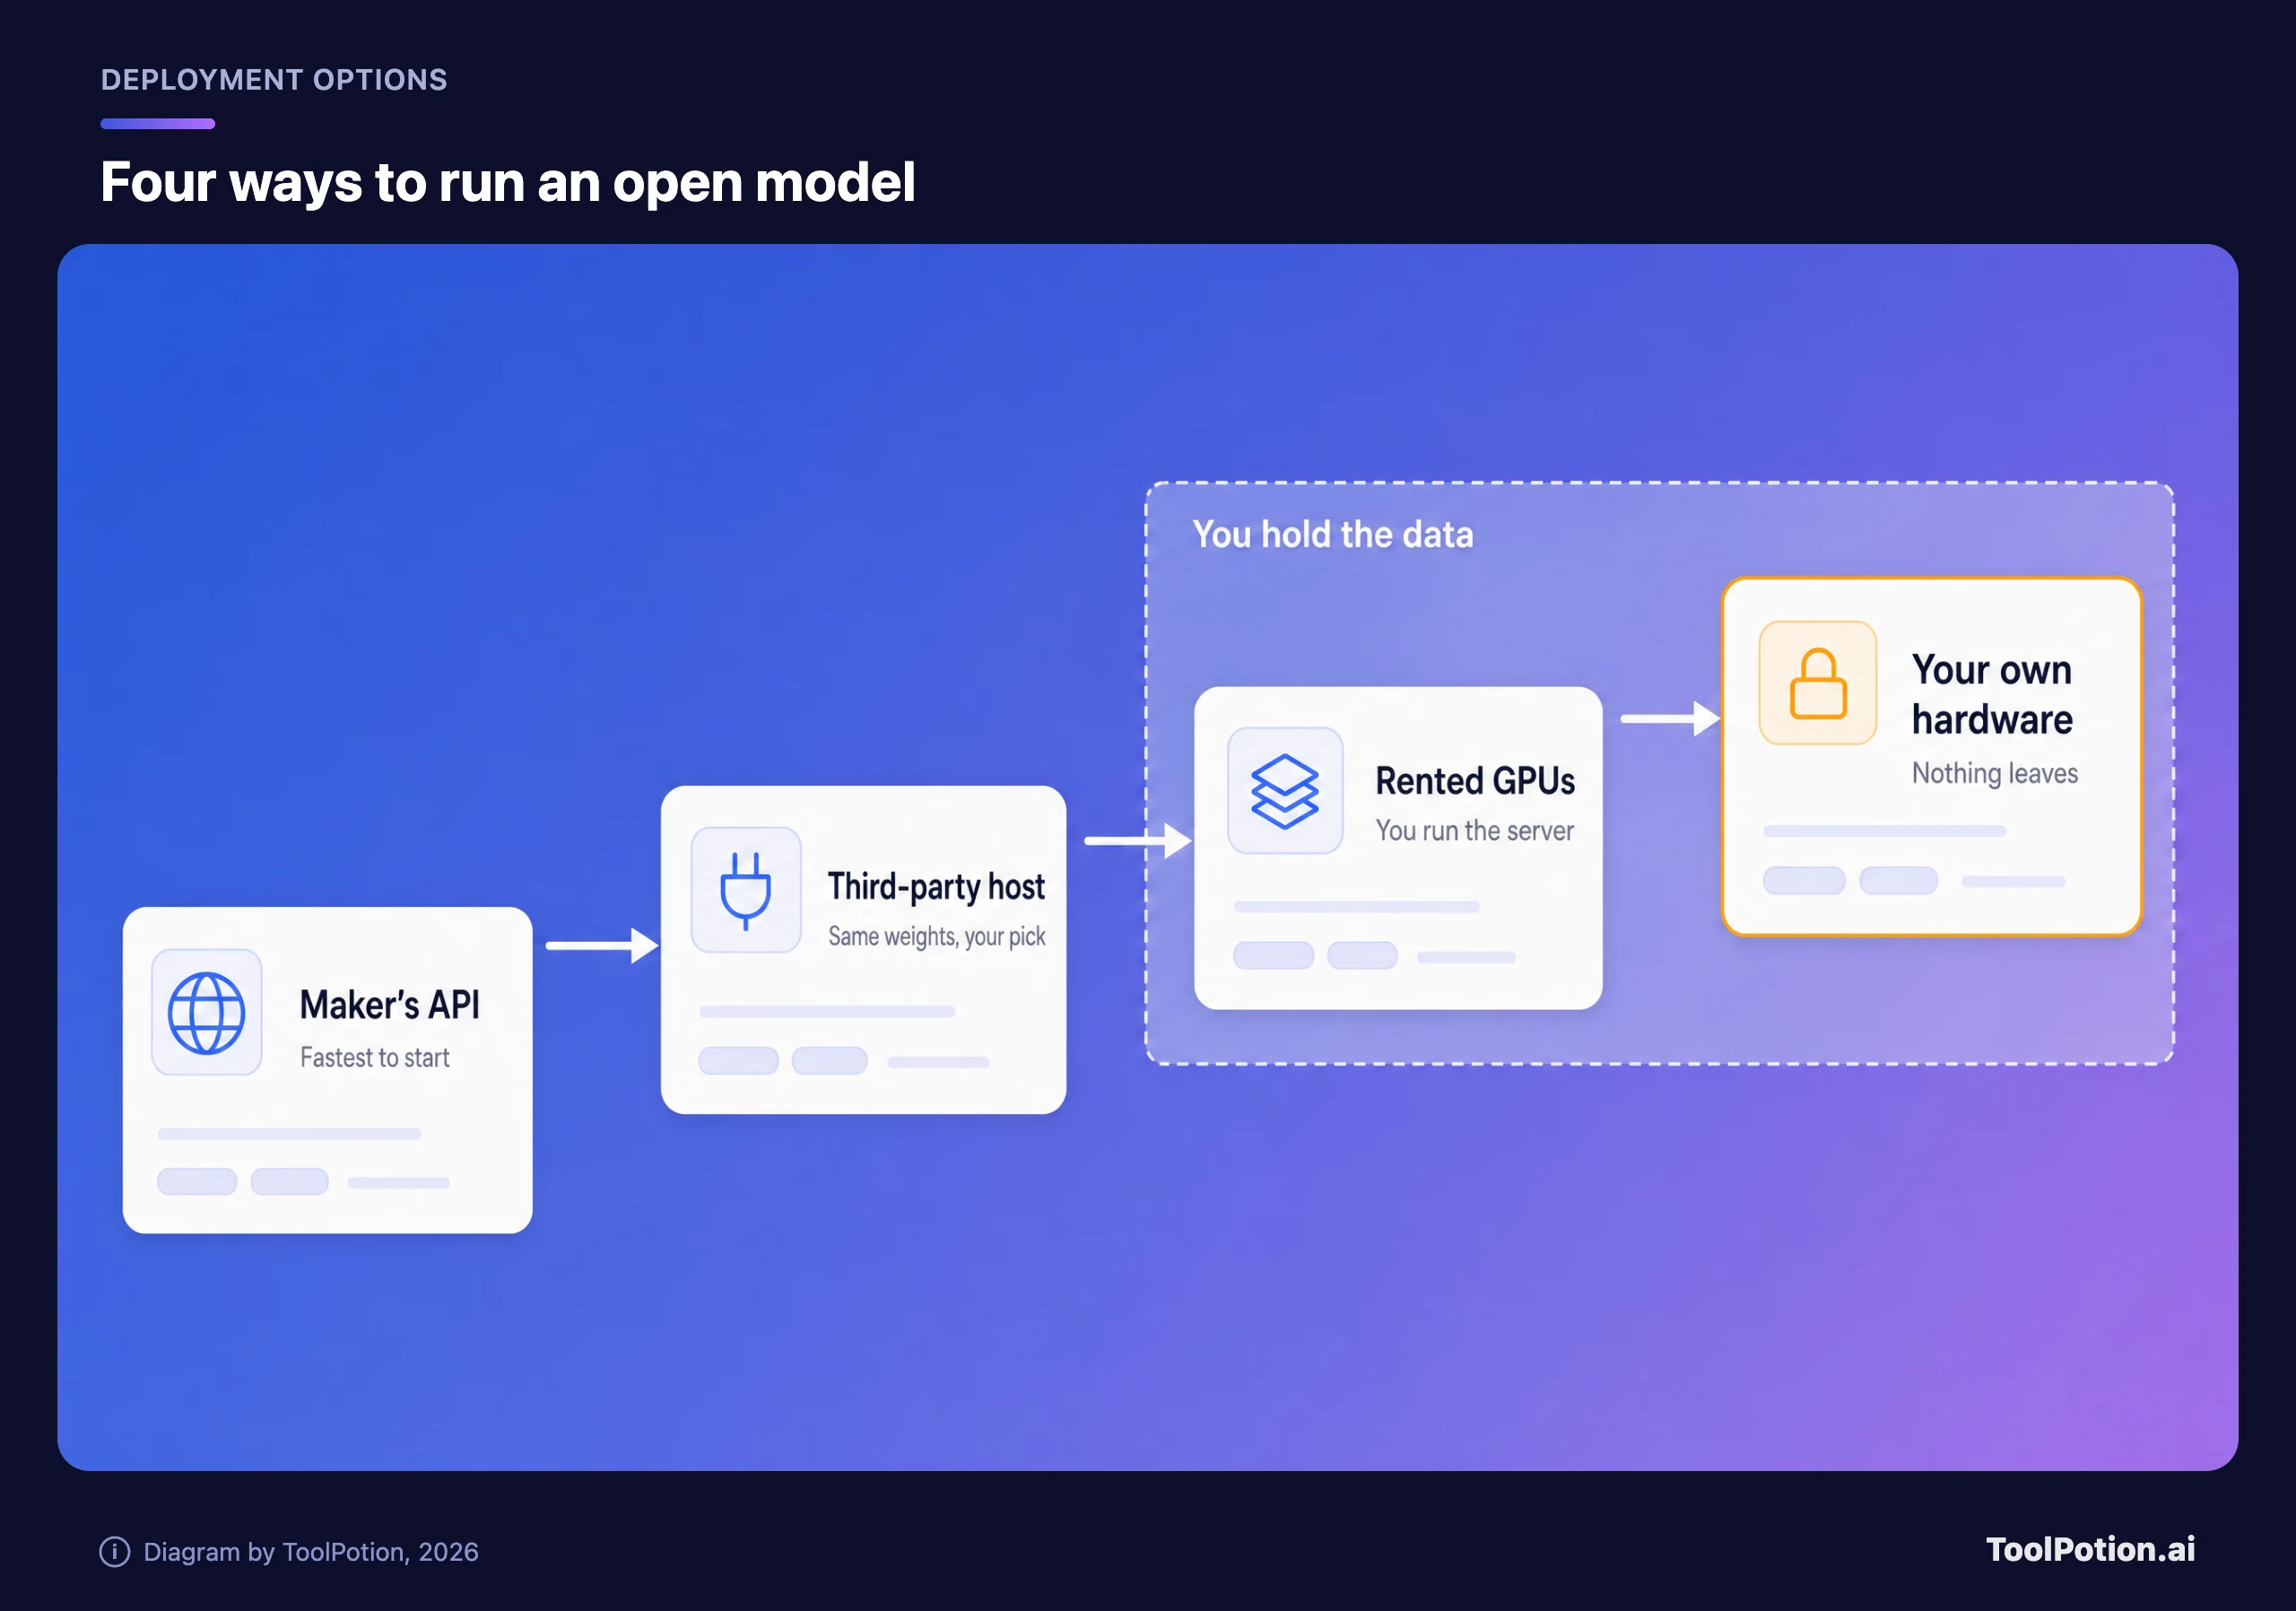
앞의 두 가지는 관리형입니다. 개발사나 호스트에 토큰을 보내면 데이터가 다른 사람의 네트워크를 거칩니다. 뒤의 두 가지는 직접 통제하는 머신에 모델을 올리는 방식이며, 계약이나 규제 때문에 데이터가 밖으로 나가면 안 될 때 의미가 있습니다. 보통 가장 큰 걸림돌은 가중치가 하드웨어에 들어가지 않는 문제이므로 크기부터 확인하세요.
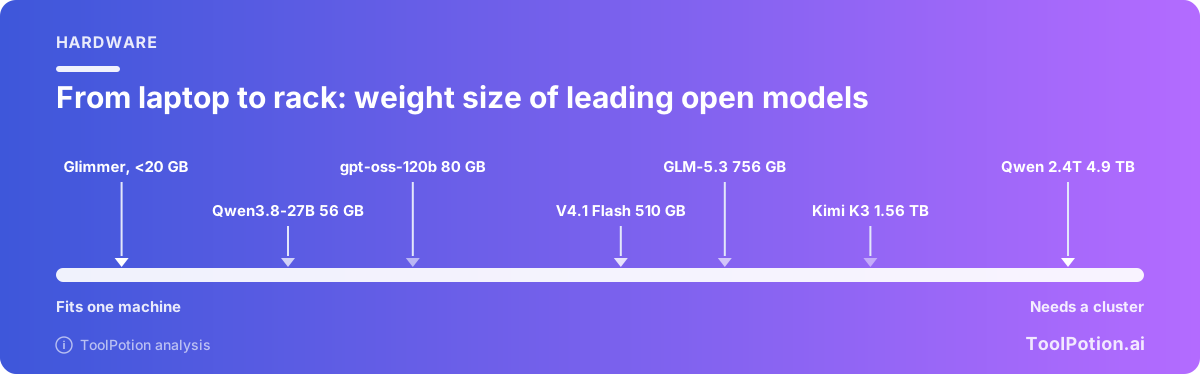
화제의 모델 대부분은 서버 한 대에 올리기에 너무 큽니다. Kimi K3는 가중치만 1.56TB로, 180GB B200 카드 8장짜리 노드의 1.44TB보다 큽니다. DeepSeek V4-Pro와 GLM-5.3도 각각 수백 GB가 필요합니다. 한 대에 들어가는 모델은 20B~120B급입니다. 추정 도구로 모델과 정밀도가 내 하드웨어에 맞는지 확인해 보세요.
기본값으로 해보세요. 4비트 gpt-oss-120b는 오버헤드를 포함해 약 70GB가 필요해서 80GB GPU 한 장에 들어갑니다. Kimi K3로 바꾸면 같은 추정기가 180GB GPU 10장을 요구합니다. GPU 10장이면 8-GPU 노드 두 대입니다. Lambda 가격 페이지의 온디맨드 B200 시간당 $6.69를 적용하면, 이 GPU 16장을 한 달 내내 돌리는 데 약 $78,000이 듭니다. 운영 인력을 붙이기 전에, 프런티어 오픈 모델을 자체 호스팅하는 데 드는 비용이 이 정도입니다.
소규모 쪽은 훨씬 부담이 적습니다. Lambda는 80GB GPU를 시간당 $3.99부터 제공하는데, 24시간 가동하면 월 약 $2,900입니다. API보다 나은지는 전적으로 사용량에 달려 있습니다.
월 출력 토큰 3억 개에 API 가격이 $10라면 두 청구서는 거의 비슷합니다. 그 아래에서는 API가 이기고, 그 위에서는 임대가 이깁니다. 단, GPU가 계속 바쁘게 돌고 모델이 작업에 충분히 좋다는 전제가 붙습니다. 하지만 정직한 비교 대상은 저렴한 호스트입니다. gpt-oss-120b의 호스트 가격 약 $0.17/100만 출력 토큰이면 $2,900으로 출력 토큰 약 170억 개를 살 수 있어서, GPU 한 장을 빌리는 것이 비용만으로 호스트를 이기는 경우는 거의 없습니다. 개인정보 보호, 통제권, 예측 가능한 지연 시간을 위해 빌리세요. 소형 모델로 비용을 아끼려고 빌리지는 마세요.
가상이지만 현실적인 물량으로 예를 들어보겠습니다. 지원팀이 하루 2만 건의 티켓을 요약하고, 건당 입력 1,500토큰, 출력 300토큰이라고 합시다. 한 달이면 입력 약 9억, 출력 약 1.8억 토큰입니다. Claude Sonnet 5.5($2 / $10, 100만 토큰당)로는 $3,600입니다. DeepSeek V4.1 Flash는 피크 요금 기준 최대 $486이고, 비피크에는 그 절반입니다. gpt-oss-120b를 앞서 본 호스트 가격으로 쓰면 약 $64입니다. 80GB GPU 한 장을 빌리면 얼마를 보내든 $2,913입니다. 저렴한 호스트가 큰 차이로 이기고, 폐쇄형 모델은 개발사 자체 가격 기준으로 오픈 모델보다 약 7배 비쌉니다.
돈을 쓰기 전에 알아둘 지름길이 두 가지 있습니다. 노트북이나 워크스테이션에서는 Ollama와 llama.cpp로 Gemma 4, Qwen3.8-27B, Muse Glimmer의 양자화 빌드를 명령어 하나로 돌릴 수 있습니다. 프로덕션 서버에는 Kimi K3와 Qwen3.8 모델 카드가 모두 지원 대상으로 올린 서빙 엔진 vLLM이 있습니다.
선택 방법
리더보드가 아니라 제약 조건에서 출발하세요. 세 가지 질문이면 대부분 정리됩니다.
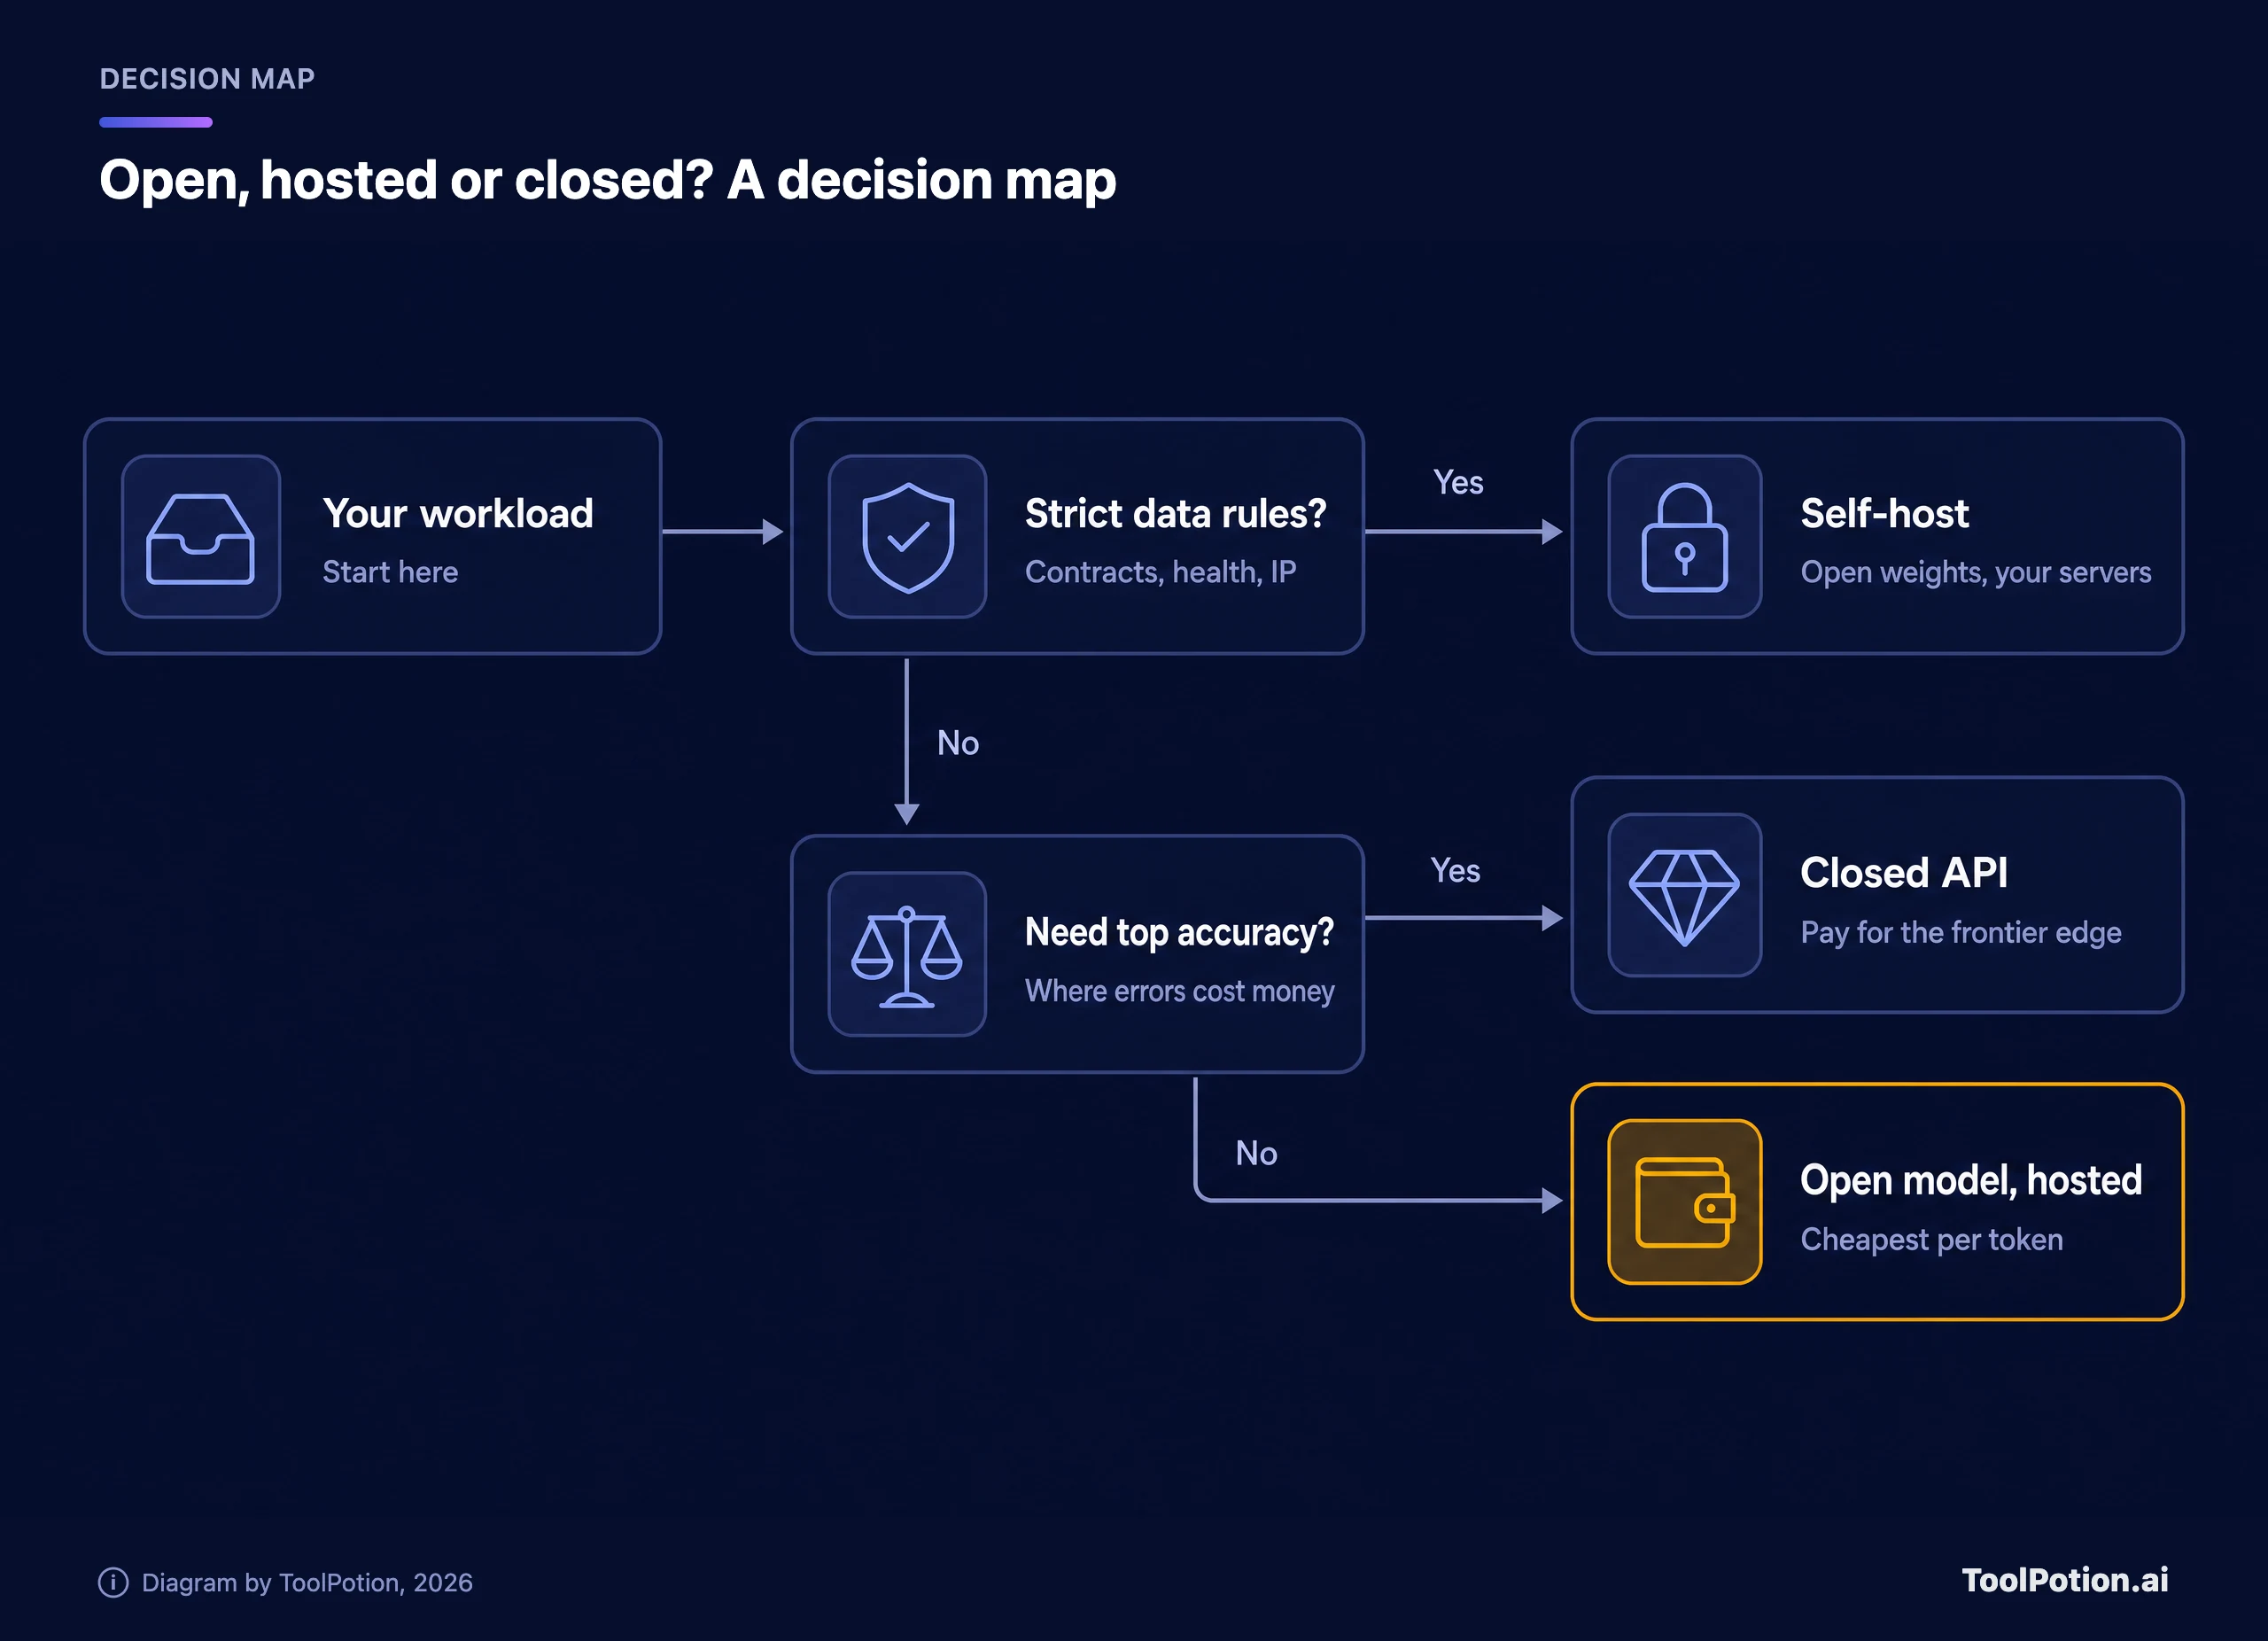
데이터가 내 통제 밖으로 나갈 수 없다면 자체 호스팅이고, 모델은 내 하드웨어에 들어가야 합니다. 이 제약 아래에서는 다음과 같습니다.
- GPU 한 장 또는 워크스테이션: 코딩과 에이전트에는 Qwen3.8-27B, 서구권 모델을 원하면 gpt-oss-120b, 노트북에는 Muse Glimmer나 Gemma 4.
- 멀티 GPU 서버: 고급 카드 8장과 수백 GB의 가중치를 감당할 수 있다면 DeepSeek V4.1 Flash나 GLM-5.3.
- 클러스터: Kimi K3나 Qwen3.8-2.4T. 단, 추론 운영이 본업인 팀이 있어야 합니다.
데이터가 밖으로 나가도 된다면 오류의 비용이 큰지 따져보세요. 큰 경우(법률 초안, 재무 분석, 리뷰 없이 배포되는 코드)에는 폐쇄형 프런티어 모델에 비용을 쓰고 내 예제로 검증하세요. 그렇지 않은 경우(요약, 태깅, 추출, 내부 검색, 초안 코드)에는 저렴한 호스트를 통한 오픈 모델이 가장 좋은 가격입니다.
고르기 전에 이 목록을 순서대로 확인해 보세요.
1. 움직일 수 없는 제약을 적어두세요: 데이터 위치, 월 예산, 품질 하한선 중 하나입니다.
2. 내 용도에 맞는 라이선스인지 확인하세요. 모델 위에 제품을 만드는 것은 거의 어디서나 괜찮습니다. 모델 자체를 재판매할 때 조건이 붙습니다.
3. 메모리를 확인하세요: 가중치 GB를 실제로 사거나 빌릴 하드웨어와 비교합니다.
4. 같은 워크로드를 개발사 API, 서드파티 호스트, 임대 GPU에서 각각 계산해 보세요.
5. 내 작업 50개를 후보 두세 개에 돌려보고 이긴 모델을 쓰세요.
정하기 전에 테스트하세요. 여기 나온 벤치마크는 벤더가 직접 서로 다른 스위트로 돌린 것이라, 한 리더보드의 90점은 다른 리더보드의 88점에 대해 별로 말해주지 않습니다. 실제 워크로드에서 작업 50개를 뽑아 후보 두세 개에 돌리고 결과를 채점하세요. 오후 한나절이면 모델 카드를 일주일 읽는 것보다 낫습니다.
모델 카드에 없는 리스크
보안. 오픈 웨이트라고 모델이 안전해지는 것은 아닙니다. 미국 정부 NIST는 2025년 이전 DeepSeek 모델 평가에서, 그중 가장 나은 R1-0528이 일반적인 jailbreak 상황에서 명백히 악의적인 요청의 94%에 응했다고 밝혔습니다. 미국 기준 모델은 8%였습니다. DeepSeek의 에이전트는 다루는 콘텐츠에 숨겨진 악성 지시를 따를 가능성도 12배 높았습니다(NIST CAISI). 이는 현재 V4 라인보다 앞선 모델이며, 이 글의 출처에서 최신 모델에 대한 동등한 공개 평가는 찾지 못했습니다. 특히 모델에 도구와 쓰기 권한을 주기 전에는 테스트해야 할 이유로 받아들이세요.
검열. NIST는 DeepSeek 모델이 부정확한 중국 공산당 서사를 미국 기준 모델의 4배 많이 되풀이한다는 점도 확인했습니다. Kimi K2 Thinking에 대한 별도의 NIST 보고서는 중국어에서는 검열이 심했지만 영어, 스페인어, 아랍어에서는 비교적 검열이 적었다고 밝혔습니다. 사용자가 중국어로 정치나 역사를 묻는다면 직접 테스트하세요. 코드와 스프레드시트 작업이라면 거의 문제가 되지 않습니다.
데이터 거주지. 누가 모델을 호스팅하느냐가 데이터의 목적지를 결정합니다. DeepSeek 개인정보 처리방침에는 개인 데이터를 중화인민공화국에서 수집, 처리, 저장한다고 되어 있습니다(DeepSeek 개인정보 처리방침). 이는 DeepSeek 자체 앱과 API에 해당하며, 다른 곳에서 돌리는 MIT 라이선스 가중치에는 해당하지 않습니다. Mistral은 반대로 어필합니다. Large 4를 유럽 내 자체 데이터센터에서 학습시켰고, 프리뷰를 유럽법 아래 유럽 배포로 운영한다고 밝혔습니다. 어떤 호스트든 고객 데이터를 보내기 전에 추론이 어디서 돌아가는지, 무엇이 로깅되는지 물어보세요.
노후화. 오픈 모델은 몇 달이면 낡습니다. gpt-oss 가중치는 1년이 지났고 Meta의 최신 Llama는 2025년 것이며, Qwen과 DeepSeek은 올해에만 여러 버전을 냈습니다. 테스트한 정확한 모델 버전을 고정하고, 업그레이드할 때 다시 테스트하세요.
그래도 폐쇄형 API를 써야 하는 경우
3% 격차는 하나의 벤치마크 측정값입니다. 최상위에서는 여전히 폐쇄형 모델이 앞서 있고, 이를 파는 연구소들은 오픈 웨이트에는 딸려오지 않는 도구와 관리형 기능을 계속 추가하고 있습니다.
어렵고 리스크가 큰 작업에서 최고의 정확도가 필요하거나, 인프라를 운영할 사람이 없거나, 물량이 너무 적어 어떤 호스팅 방식이든 차이가 의미 없다면 Claude나 ChatGPT를 쓰세요. 하루 몇천 건을 호출하는 팀이라면 토큰에서 아끼는 돈보다 엔지니어 시간에 드는 돈이 더 큽니다. 가동 시간, 보안, 지원을 한 벤더가 책임지길 원한다면 이 경우에도 유료가 맞습니다.
갈아타지 말고 섞어 쓰세요. 흔한 구성은 일상적인 대량 작업을 호스트를 통해 오픈 모델로 보내고, 어려운 건은 폐쇄형으로 올리는 것입니다. 작업에 맞는 모델 등급 고르기 가이드의 라우팅 규칙이 그대로 적용됩니다. 기본은 저렴한 모델, 실패하면 상위로 올리는 것입니다.
자주 묻는 질문
오픈 웨이트와 오픈소스는 무엇이 다른가요?
오픈 웨이트는 학습된 모델을 내려받을 수 있다는 뜻입니다. 엄밀한 의미의 오픈소스는 학습 데이터와 코드까지 승인된 라이선스로 공개해야 합니다. 이 목록에서 그 기준을 충족하는 것은 거의 없습니다. 실무적으로는 Apache 2.0과 MIT 모델이 가장 가깝습니다. Kimi나 Qwen 같은 커스텀 라이선스에는 조건이 붙습니다.
이 모델들을 상업적으로 쓸 수 있나요?
여기서 다룬 모든 라이선스에서 모델 위에 제품을 만드는 것은 가능합니다. 조건이 문제가 되는 때는 모델 자체를 서비스로 팔 때, 그리고 일부 경우에는 제품 규모가 매우 클 때입니다. Apache 2.0과 MIT 모델에는 매출 조건이 전혀 없습니다.
코딩에는 어떤 오픈 모델이 가장 좋나요?
벤더가 보고한 수치로는 GLM-5.3, Kimi K3, DeepSeek V4.1 Flash가 앞서며, 세 모델 모두 서버급 하드웨어가 필요합니다. 한 대의 머신이라면 Qwen3.8-27B가 현실적인 선택입니다. 벤치마크 스위트가 서로 다르니 내 코드베이스로 직접 테스트하세요.
회사 데이터에 DeepSeek을 써도 안전한가요?
어떻게 돌리느냐에 따라 다릅니다. DeepSeek 앱과 API는 위 방침에 따라 데이터를 중국에 저장합니다. MIT 가중치를 내 서버나 신뢰하는 호스트에서 돌린다면 DeepSeek으로는 아무것도 전송되지 않습니다. NIST의 이전 평가에서 나온 모델 동작상의 리스크는 여전히 적용됩니다.
GPU 메모리는 얼마나 필요한가요?
대략 파라미터 수 × 비트 수 ÷ 8에, 캐시와 런타임용으로 약 20%를 더하면 됩니다. 8비트 27B 모델은 오버헤드를 포함해 약 33GB입니다. 4비트 117B 모델은 약 70GB입니다. 위의 추정기가 계산해 줍니다.
Mistral Large 4는 언제 오픈되나요?
Mistral은 발표 직후 가중치를 공개하겠다고 약속했지만 라이선스 조건은 아직 공개하지 않았습니다. 계획에 넣기 전에 Hugging Face 페이지를 확인하세요.