説明
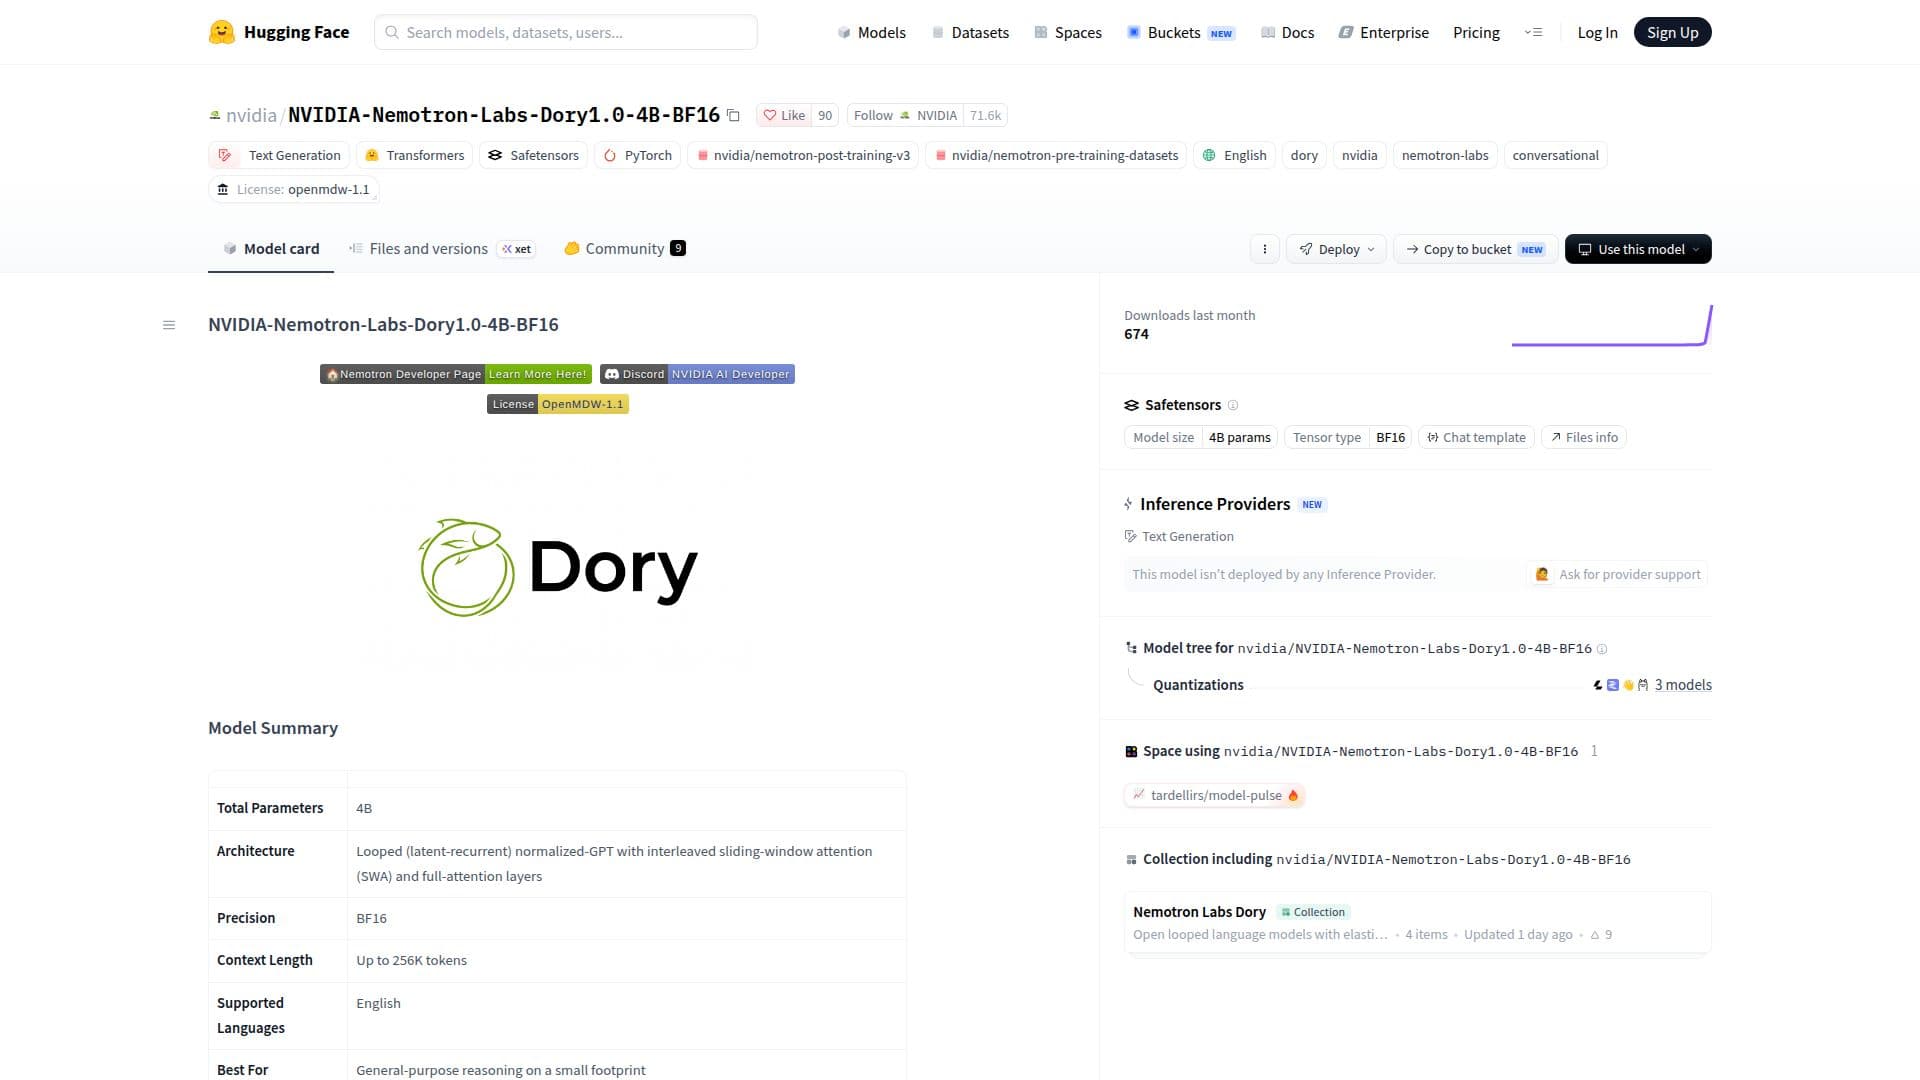
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16は、NVIDIAによって開発された大規模言語モデルで、ループ型(潜在再帰)正規化GPTアーキテクチャを利用しています。このモデルは、一般的な推論タスクを処理しながら、小さな計算負荷を維持するように設計されています。インタリーブされたスライディングウィンドウアテンション(SWA)とフルアテンションレイヤーを備えており、最大256Kトークンのコンテキスト長を効率的に処理できます。
続きを読む
このモデルは40億のパラメータで構築されており、BF16精度を採用しているため、商業用および非商業用アプリケーションの両方に適しています。英語の処理をサポートし、一般的な推論能力を必要とするタスクに最適です。モデルのアーキテクチャは弾力的な推論計算を可能にし、ユーザーがループの数を調整して計算効率と精度のバランスを取ることができ、再トレーニングの必要がありません。
Dory1.0-4B-BF16は、NVIDIAのNVFP4フォーマットを使用して事前トレーニングされ、その後BF16で続行され、高いパフォーマンスをNVIDIAのGPU加速システムで確保しています。BF16、MXFP8、NVFP4、Q5_K_Mなど、さまざまなフォーマットで利用可能であり、異なるハードウェア構成における展開の柔軟性を提供します。
モデルのトレーニングには6兆トークンが使用され、数学、科学、一般知識などの多様なドメインに焦点を当てています。多段階ツール使用、指示の遵守、構造化された出力環境でのパフォーマンスを向上させるために、監視付きファインチューニングと強化学習を経ています。モデルのベンチマークは、コーディング、推論、指示の遵守など、さまざまなタスクにおいて競争力のあるパフォーマンスを示しています。
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16は、OpenMDWライセンス契約(バージョン1.1)に基づいて管理され、2026年10月16日にリリースされました。NVIDIAのHopperおよびBlackwellアーキテクチャで最適に動作するように設計されており、Linuxオペレーティングシステムをサポートしています。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド
- プラットフォームLinux
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16のハイライト
ループ型潜在再帰アーキテクチャ
インタリーブされたスライディングウィンドウアテンション
256Kトークンのコンテキスト長
BF16精度
弾力的な推論計算
ネイティブNVFP4事前トレーニング
メモリ効率の良いループ処理
OpenMDWライセンス契約
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16をはじめる
モデルページにアクセス: NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16のHugging Faceモデルページを訪問します。
認証: モデルにアクセスするために必要な資格情報を持っていることを確認します。
設定: ループ数やKVキャッシュ設定など、モデルパラメータを設定します。
プロンプトを送信: モデルに処理するためのテキストシーケンスを入力します。
ファインチューニング: 必要に応じて特定のタスクのためにモデル設定を調整します。
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16の使用例
- 一般的な推論
- コーディングタスク
- 指示の遵守
- 長いコンテキスト処理
- 科学研究