説明
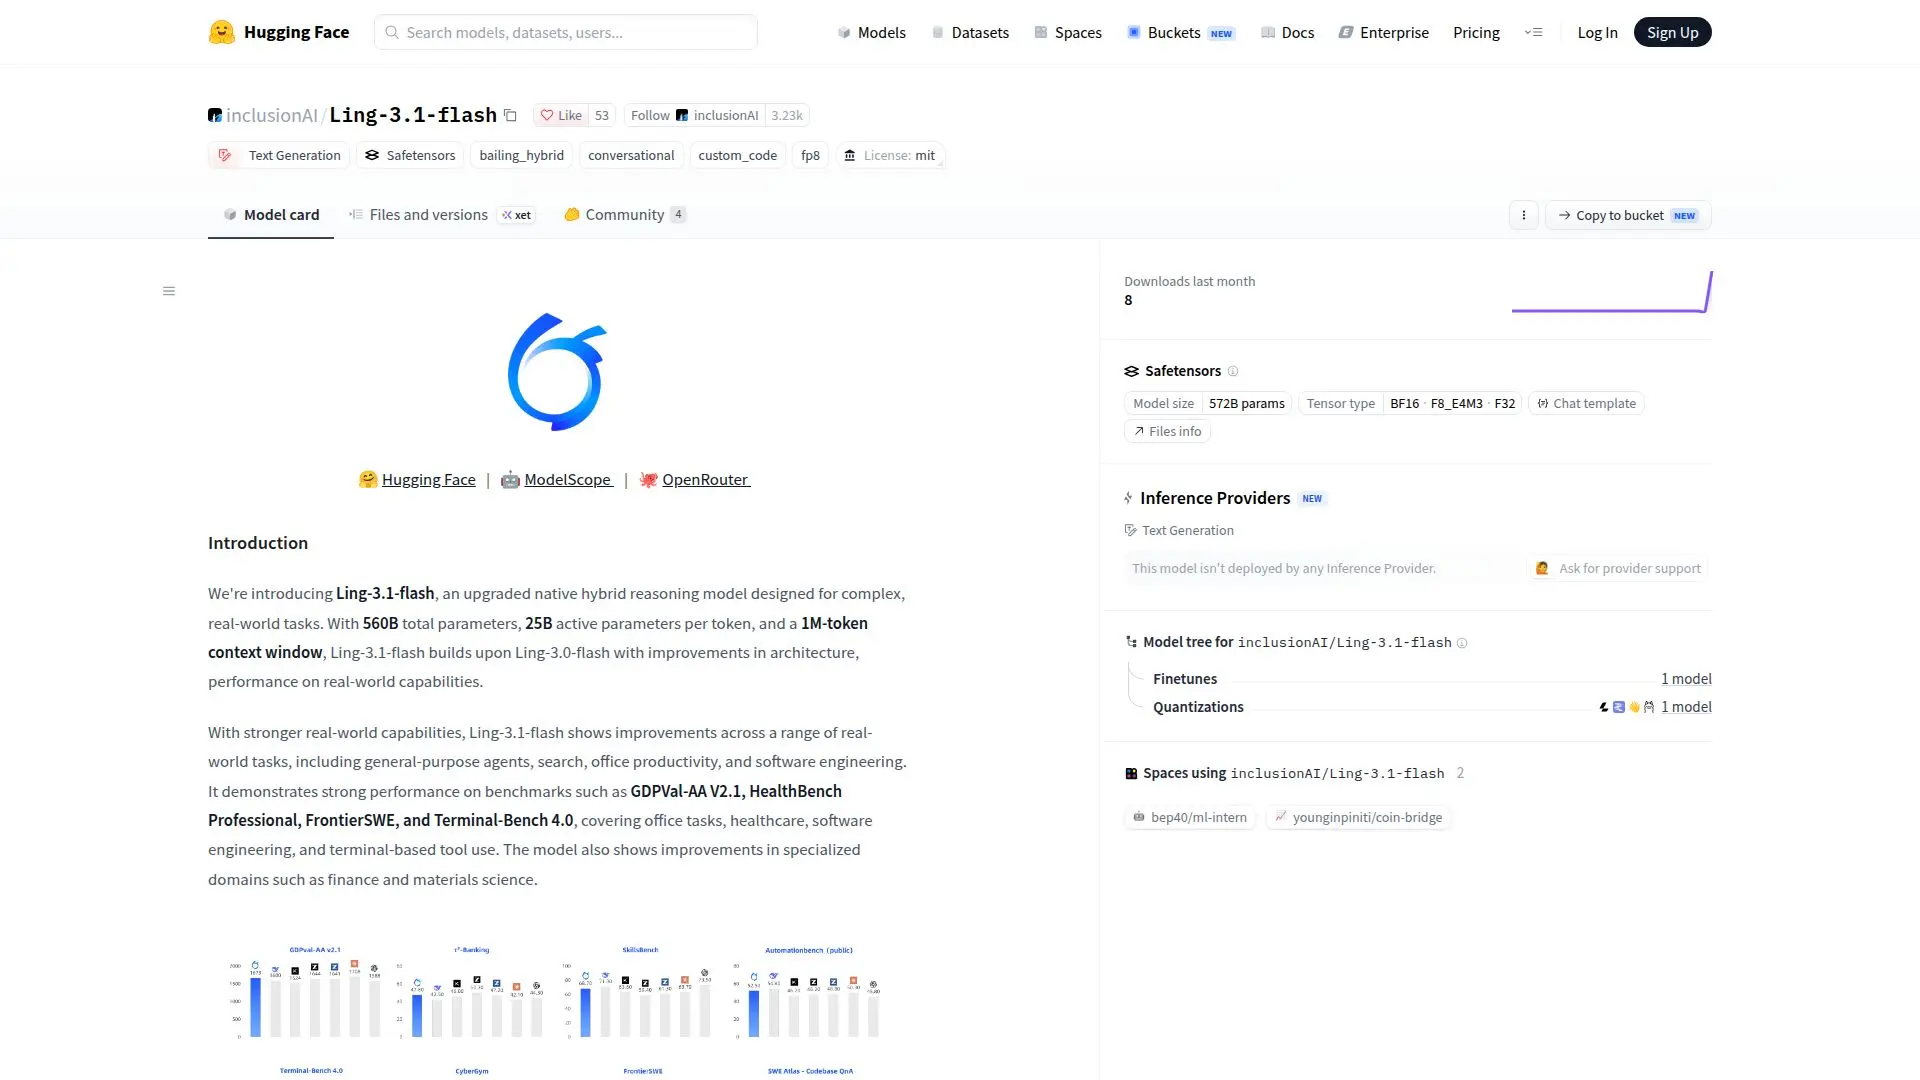
Ling-3.1-flashは、Hugging FaceプラットフォームでinclusionAIによって導入されたアップグレードされたネイティブハイブリッド推論モデルです。複雑な現実のタスクに取り組むために設計されており、このモデルは合計5600億のパラメータを誇り、トークンごとに250億のアクティブパラメータと100万トークンのコンテキストウィンドウを備えています。これらの強化は、前モデルであるLing-3.0-flashを基にしており、アーキテクチャとパフォーマンスが向上しています。
続きを読む
このモデルは、一般的なエージェント、検索、オフィス生産性、ソフトウェア工学など、さまざまな現実のアプリケーションで優れた性能を発揮します。GDPVal-AA V2.1、HealthBench Professional、FrontierSWE、Terminal-Bench 4.0などのベンチマークで強力なパフォーマンスを示しています。これらのベンチマークは、オフィスタスク、医療、ソフトウェア工学、端末ベースのツール使用など、幅広いタスクをカバーしています。さらに、Ling-3.1-flashは、金融や材料科学などの専門分野でも顕著な改善を示しています。
Ling-3.1-flashのアーキテクチャは、ハイブリッド・リニア・ミクスチャー・オブ・エキスパート(MoE)モデルに基づいており、63 KDAと9 Gated MLAトランスフォーマー層、4つの密な層、512のルーティングされたエキスパートを特徴としています。このモデルには64のアテンションヘッドと4096の隠れサイズがあり、語彙サイズは157,184です。
Ling-3.1-flashは、複数の権威あるベンチマークで評価され、コーディングおよびエージェントタスクにおける強力なパフォーマンスを示しています。Claude Code、Kilo Code、Qwen Code、Hermes Agent、OpenClawなどのフレームワークをサポートしています。また、LingCodeというオープンソースコーディングエージェントPiに基づいたハーネスを導入し、複雑で長期的なコーディングタスクにおけるパフォーマンスを向上させます。
始めたいユーザー向けに、推奨されるSGLangイメージにはLing-3.1-flashのサポート、MTPの推測デコーディング、Hopperデコードの最適化が含まれています。このモデルは、さまざまなサーバー構成で推論のために利用可能であり、異なるハードウェアセットアップに対して検証済みのレシピが提供されています。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド
- プラットフォームWeb
Ling-3.1-flashのハイライト
560Bの総パラメータ
1Mトークンのコンテキストウィンドウ
ハイブリッド・リニアMoEアーキテクチャ
63 KDA + 9 Gated MLA層
512のルーティングされたエキスパート
64のアテンションヘッド
複数のフレームワークをサポート
強力なベンチマークパフォーマンス
Ling-3.1-flashをはじめる
モデルページにアクセス: Hugging Faceを訪問
認証: アカウントにログイン
設定: サーバーまたはクライアント環境を設定
プロンプトを送信: 検証済みのレシピを使用して推論
Ling-3.1-flashの使用例
- 一般的なエージェント
- オフィス生産性
- ソフトウェア工学
- 医療アプリケーション
- 金融分析