説明
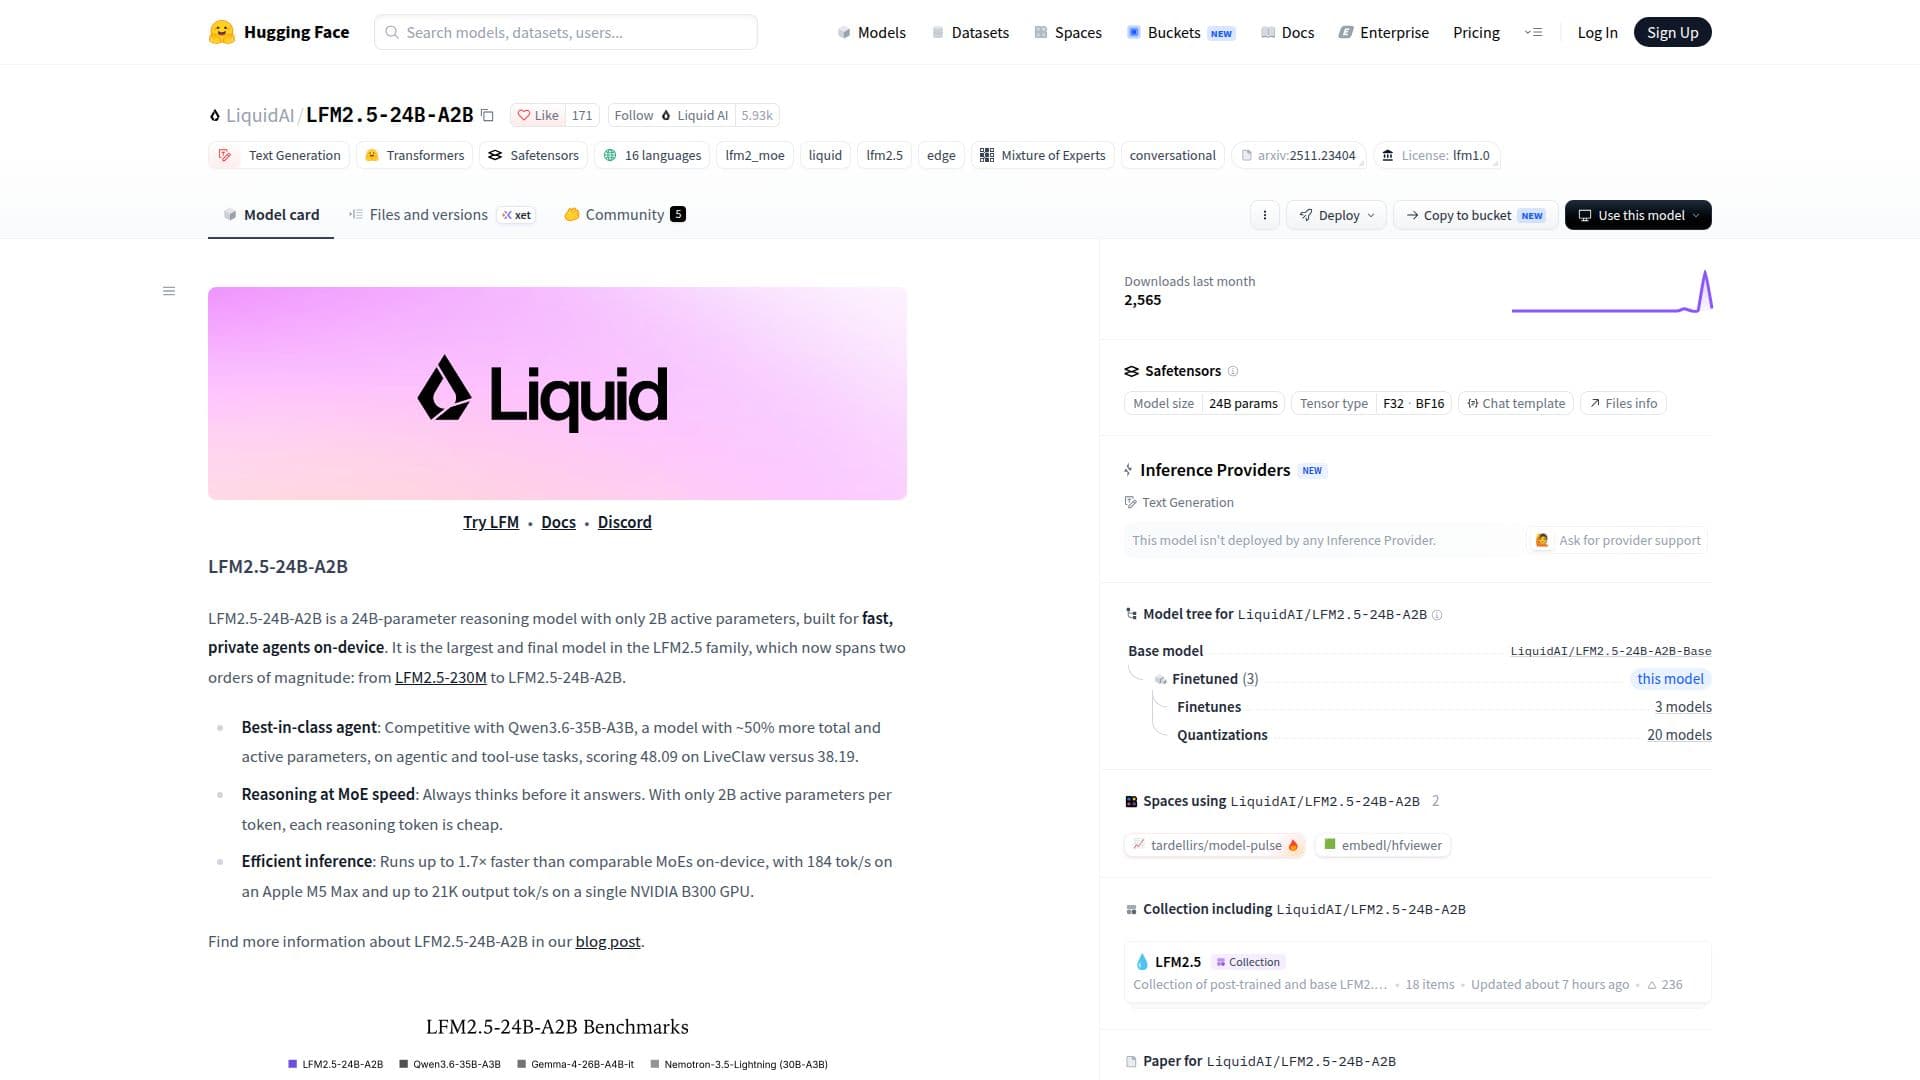
LiquidAI LFM2.5-24B-A2Bは、合計24Bのうち2Bのアクティブパラメータのみで効率的に動作するように設計された最先端の推論モデルです。このモデルはLFM2.5ファミリーの一部であり、迅速でプライベートなオンデバイスアプリケーション向けに調整されています。エージェント的およびツール使用タスクに優れ、Qwen3.6-35B-A3Bのような大規模モデルに対して競争力のあるパフォーマンスを示しています。
続きを読む
このモデルは効率的な推論のために設計されており、Apple M5 MaxやNVIDIA B300 GPUなどのデバイス上で同等のモデルよりも最大1.7倍速く動作します。英語、アラビア語、中国語など、幅広い言語をサポートしており、多言語アプリケーションにおいて柔軟性を持っています。
LFM2.5-24B-A2Bは、FP8形式での高スループットGPUサービス、CPU推論用のGGUF、クロスプラットフォーム展開用のONNXなど、さまざまな形式で利用可能です。この柔軟性により、クラウドからエッジ、モバイルまで多様な環境に統合できます。
このモデルは、推論およびツール呼び出し機能を必要とするアプリケーションに特に適しています。構造化された4ステッププロセスでの関数呼び出しをサポートし、エージェントワークフローにおける有用性を高めています。ただし、補足的な情報取得やウェブ検索機能なしでの知識重視のタスクには推奨されません。
開発者向けに、LFM2.5-24B-A2Bは、監視付きファインチューニングやUnslothやTRLなどのフレームワークを使用した直接的な好みの最適化を含む広範なファインチューニングオプションを提供します。このモデルのパフォーマンスはさまざまなタスクでベンチマークされており、一貫して高い効率と速度を示しています。
全体として、LiquidAI LFM2.5-24B-A2Bは、オンデバイスアプリケーション向けの強力で効率的な推論モデルを求める開発者にとって堅実な選択肢です。
- カテゴリーAIモデルとLLM
- 料金モデルオープンソース
- デプロイクラウド, オンプレミス
- プラットフォームWeb, Windows, macOS
LiquidAI LFM2.5-24B-A2Bのハイライト
合計24Bのパラメータ
アクティブパラメータ2B
効率的なオンデバイス推論
複数の言語をサポート
ツール呼び出し機能
複数の形式で利用可能
ファインチューニングサポート
高速GPU推論
LiquidAI LFM2.5-24B-A2Bをはじめる
モデルページにアクセス: Hugging Faceのモデルページを訪問
認証: Hugging Faceアカウントにログイン
設定: 特定のユースケースに合わせてモデルを設定
プロンプトを送信: 推論タスクにモデルを使用
ファインチューニング: データを使用してモデルをカスタマイズ
LiquidAI LFM2.5-24B-A2Bの使用例
- 多言語サポート
- オンデバイスエージェント
- ツール呼び出しワークフロー
- クロスプラットフォーム展開
- ファインチューニングアプリケーション