メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16は、2800億の総パラメータを持つ効率的なスパースMixture-of-Experts(MoE)言語モデルです。33.5兆トークンで事前学習されており、100万トークンのコンテキストでファインチューニングと推論をサポートします。このモデルは、ドメイン適応、指示チューニング、強化学習研究など、さまざまなアプリケーション向けに設計されており、複数のベンチマークで強力なパフォーマンスを提供します。

URLを訪問
共有
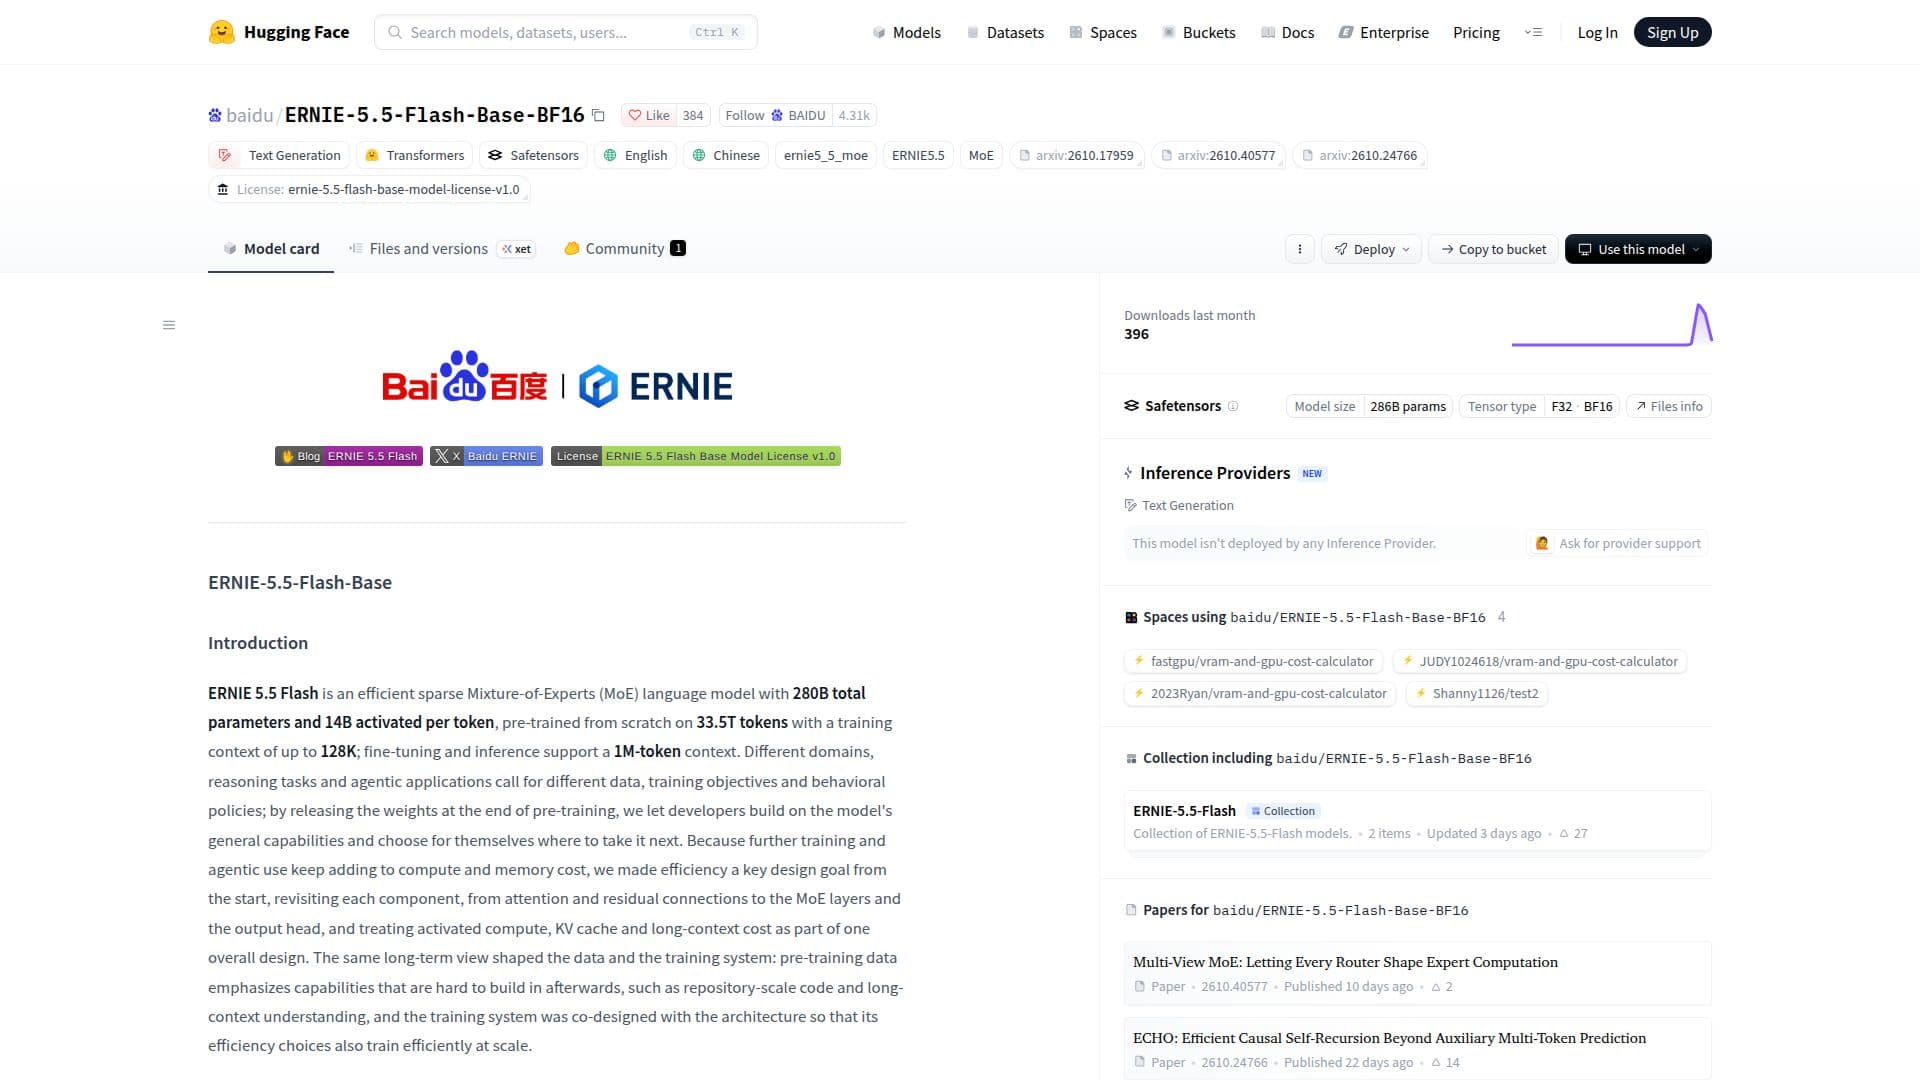
ERNIE-5.5-Flash-Base-BF16 のスクリーンショット

ERNIE-5.5-Flash-Base-BF16は、Baiduによって開発された高度なスパースMixture-of-Experts(MoE)言語モデルです。2800億の総パラメータを特徴としており、トークンごとに140億のパラメータが活性化され、複雑な言語タスクに対して非常に効率的です。このモデルは、33.5兆トークンの広範なデータセットでゼロから事前学習され、最大128,000トークンのトレーニングコンテキストを利用しています。ファインチューニングと推論のために、印象的な100万トークンのコンテキスト長をサポートし、長文コンテンツの深い理解と生成を可能にします。

続きを読む

効率性をコア原則として設計されたERNIE 5.5 Flashは、注意メカニズムや残差接続からMoE層、出力ヘッドに至るまで、すべてのコンポーネントを見直しています。この包括的なアプローチにより、計算、KVキャッシュ、長コンテキストコストを管理しながら最適なパフォーマンスを確保します。事前学習データは、リポジトリ規模のコード理解や長コンテキストの理解など、高度なアプリケーションに不可欠な能力を強調しており、開発者が多様なユースケースに向けてその一般的な能力を基に構築できるようにします。

ERNIE-5.5-Flash-Base-BF16は、事前学習の終了時点でのチェックポイントを表しており、中間または後のトレーニング段階の前の基盤モデルとして機能します。これにより、ドメイン適応、指示チューニング、強化学習に従事する研究者や開発者にとって理想的な出発点となります。このモデルは、知識、推論、数学、コード、多言語タスク、長コンテキスト理解に関連するベンチマークで優れた結果を示しています。

アーキテクチャは、43層を持つ280B-A14Bハイブリッド注意MoEを組み込んでおり、1つの密なFFNと42のマルチルータ潜在MoE層を含んでいます。37の重圧縮注意(HCA)層と6つのマルチヘッド潜在注意(MLA + DSA)層を特徴としており、スパース注意を使用しています。モデルは、各MoE層ごとに512のルーティングされたエキスパート(トップ10)と1つの共有エキスパートを利用します。低ランクゲート付き注意、仮想ヘッド注意(VHA)、マルチルータ潜在MoE、ECHO、マニフォールド制約付きハイパー接続(mHC)、マルチマックス出力ヘッドなどの革新が、先進的な能力と効率性に寄与しています。トークナイザーは約200,000エントリをサポートし、数字を右から左に最大3桁のグループでトークン化します。

デプロイメントはSGLangおよびvLLMでサポートされており、最大1,048,576トークンのコンテキスト長でのプロダクションサービスが可能です。このモデルは、ERNIE 5.5 Flash Base Model License Agreement v1.0の下で利用可能です。

  • カテゴリーAIモデルとLLM
  • デプロイクラウド
  • プラットフォームWeb

  • 2800億の総パラメータ

  • トークンごとに140億の活性化パラメータ

  • 33.5兆トークンで事前学習

  • 最大128,000トークンのトレーニングコンテキスト

  • ファインチューニングと推論は100万トークンのコンテキストをサポート

  • 効率的なスパースMixture-of-Experts(MoE)アーキテクチャ

  • 43層のハイブリッド注意MoE

  • 37の重圧縮注意(HCA)層

  • 6つのマルチヘッド潜在注意(MLA + DSA)層

  • 各MoE層ごとに512のルーティングされたエキスパート(トップ10)と1つの共有エキスパート

  • 低ランクゲート付き注意および仮想ヘッド注意(VHA)

  • 正確なエキスパート選択のためのマルチルータ潜在MoE

  • マルチホライズン損失と推測デコーディングのためのECHO

  • 信号伝播のためのマニフォールド制約付きハイパー接続(mHC)

  • 語彙分布をシャープにするためのマルチマックス出力ヘッド

  • 約200,000エントリのBPEトークナイザー

  • プロダクションサービスのためのSGLangおよびvLLMのサポート

  1. モデルページにアクセス: Hugging FaceのERNIE-5.5-Flash-Base-BF16ページに移動します。

  2. ファイルを探索: ページ上のモデルファイルとドキュメントを確認します。

  3. モデルをダウンロード: ERNIE-5.5-Flash-Base-BF16モデルのチェックポイントをダウンロードします。

  4. vLLMとプラグインをインストール: デプロイメントのためにvLLMとERNIE 5.5プラグインをインストールします。

  5. サーバーを起動: SGLangまたはvLLMを使用してモデルサーバーを起動します。

  6. リクエストを送信: curlなどのツールを使用して完了エンドポイントにリクエストを送信します。

  • テキスト生成
  • ドメイン適応
  • 指示チューニング
  • 強化学習研究
  • コード理解
  • 長コンテキスト理解
  • 多言語アプリケーション
  • 推論タスク
  • エージェンティックアプリケーション

Baidu の製品

百度文心助手 のモデルです。

ERNIE-5.5-Flash-Base-BF16 のレビュー

読み込み中...

ERNIE-5.5-Flash-Base-BF16 に似た人気のAIツール

ERNIE-5.5-Flash-Baseは、280Bの総パラメータを持つ効率的なスパースMixture-of-Experts (MoE)言語モデルで、テキスト生成のために設計されています。33.5Tトークンで事前学習されており、1Mトークンのコンテキストでファインチューニングと推論をサポートします。このモデルは、ドメイン適応、指示チューニング、強化学習研究の…

AIモデルとLLM
ツールを見る

280Bの総パラメータを持つ効率的なスパースMixture-of-Experts (MoE)言語モデルで、テキスト生成のために設計されています。33.5Tトークンで事前学習されており、1Mトークンのコンテキストでファインチューニングと推論をサポートします。このモデルは、ドメイン適応、指示チューニング、強化学習研究の…ERNIE-5.5-Flash-Baseは、280Bの総パラメータを持つ効率的なスパースMixture-of-Experts (MoE)言語モデルで、テキスト生成のために設計されています。33.5Tトークンで事前学習されており、1Mトークンのコンテキストでファインチューニングと推論をサポートします。このモデルは、ドメイン適応、指示チューニング、強化学習研究の…

AIモデルとLLM
LLM トップ100を見る

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

AIモデルとLLM
ツールを見る

効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

注目AIモデルとLLM
LLM トップ100を見る

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

AIモデルとLLM

LLMで第42位

ツールを見る

6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

注目AIモデルとLLM
LLMで第42位

DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

AIモデルとLLM

LLMで第71位

ツールを見る

ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。DeepSeek-V4-Pro-DSparkは、ハイブリッドアテンションアーキテクチャと多様体制約ハイパーコネクションを特徴とする高度な言語モデルです。1百万トークンのコンテキスト長をサポートし、効率的な長コンテキスト処理に最適化されています。

AIモデルとLLM
LLMで第71位

AliceAI-Foundation-80B-A3B-Baseは、ハイブリッドアーキテクチャとMoEレイヤーを備えた基盤となる言語モデルで、80億のパラメータを持っています。事実に基づく知識タスクに優れ、特にロシア語において高い性能を発揮し、最大262,144トークンのコンテキスト長をサポートします。

AIモデルとLLM

LLMで第29位

ツールを見る

ハイブリッドアーキテクチャとMoEレイヤーを備えた基盤となる言語モデルで、80億のパラメータを持っています。事実に基づく知識タスクに優れ、特にロシア語において高い性能を発揮し、最大262,144トークンのコンテキスト長をサポートします。AliceAI-Foundation-80B-A3B-Baseは、ハイブリッドアーキテクチャとMoEレイヤーを備えた基盤となる言語モデルで、80億のパラメータを持っています。事実に基づく知識タスクに優れ、特にロシア語において高い性能を発揮し、最大262,144トークンのコンテキスト長をサポートします。

AIモデルとLLM
LLMで第29位

Ling-3.0-flashは、効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。

AIモデルとLLM

LLMで第65位

ツールを見る

効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。Ling-3.0-flashは、効率性とパフォーマンスを考慮して設計された次世代ハイブリッド推論モデルです。1240億のパラメータを持ち、推論、指示の遵守、長文コンテキストの理解に優れ、複雑なワークフローに最適です。

AIモデルとLLM
LLMで第65位

DeepSeek-V3

AI GitHub リポジトリ

DeepSeek-V3は、DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…DeepSeek-V3は、DeepSeekによるオープンウェイトのMixture-of-Experts言語モデルで、合計6710億のパラメータとトークンごとに370億のアクティブパラメータを持っています。128Kのコンテキスト長で148兆トークンで事前学習されており、自己ホスティング用またはDeepSeekのチャットウェブサイトを通じて使用するために、Git…

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第51位

ツールを見る

高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。Kimi-K2-Instructは、高度なAIタスク向けに設計された最先端のミクスチャー・オブ・エキスパート言語モデルです。推論、コーディング、ツール使用に優れ、320億のアクティブパラメータを持つ堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第51位
1 / 8