

Open-Weight-Modelle sind den besten geschlossenen inzwischen so nah gekommen, dass bei vielen Aufgaben nicht mehr die Qualität die eigentliche Frage ist. Es geht darum, wer das Modell betreibt, wohin Ihre Daten fließen und was die Lizenz Ihnen erlaubt. Laut Bloomberg Intelligence liegt der Abstand zwischen dem besten chinesischen und dem führenden US-Modell in einem wichtigen Benchmark bei etwa 3 %, Anfang des Jahres waren es noch rund 15 % (AI Weekly, mit Verweis auf Bloomberg).
Das ist vor allem für Entwickler, Startups und Teams mit Datenschutzvorgaben relevant. Sie können ein Modell von Hugging Face laden, auf Hardware unter Ihrer Kontrolle betreiben und erhalten Coding- und Agenten-Ergebnisse, für die vor einem Jahr noch eine kostenpflichtige API nötig war. Oder Sie sparen sich die Hardware und rufen dieselben Gewichte über einen günstigen Hoster auf.
Nur Vorteile gibt es nicht. „Open“ umfasst Lizenzen von „alles erlaubt“ bis „Kleingedrucktes lesen“, einige der größten Modelle brauchen ein ganzes Rack voller GPUs, und manche bringen echte Sicherheits- und Zensurprobleme mit. Dieser Leitfaden sortiert die aktuellen Spitzenmodelle, zeigt ihre Kosten und liefert Regeln für die Auswahl. Wenn Sie einen Überblick über geschlossene und offene Modelle suchen: Unser Top-25-LLM-Ranking behält ihn im Blick.
Der Abstand ist geschrumpft, und das Feld hat sich verändert
Die Benchmark-Lücke ist die Schlagzeile, hier also der Hintergrund. Laut Bloombergs Messungen lag das beste chinesische Modell Anfang des Jahres etwa 15 % zurück, zur Jahresmitte rund 9 % und einen Monat später etwa 6 %, damals ein Rekordtief (The Next Web). Der aktuelle Wert liegt bei etwa 3 %. Der neueste Datenpunkt ist DeepSeek V4.1 Flash: Es erreichte auf LiveBench 81,1 Punkte gegenüber 83,4 für ein führendes Anthropic-Modell und liegt im Teiltest für agentisches Coding mit 77,3 zu 66,1 vorn.
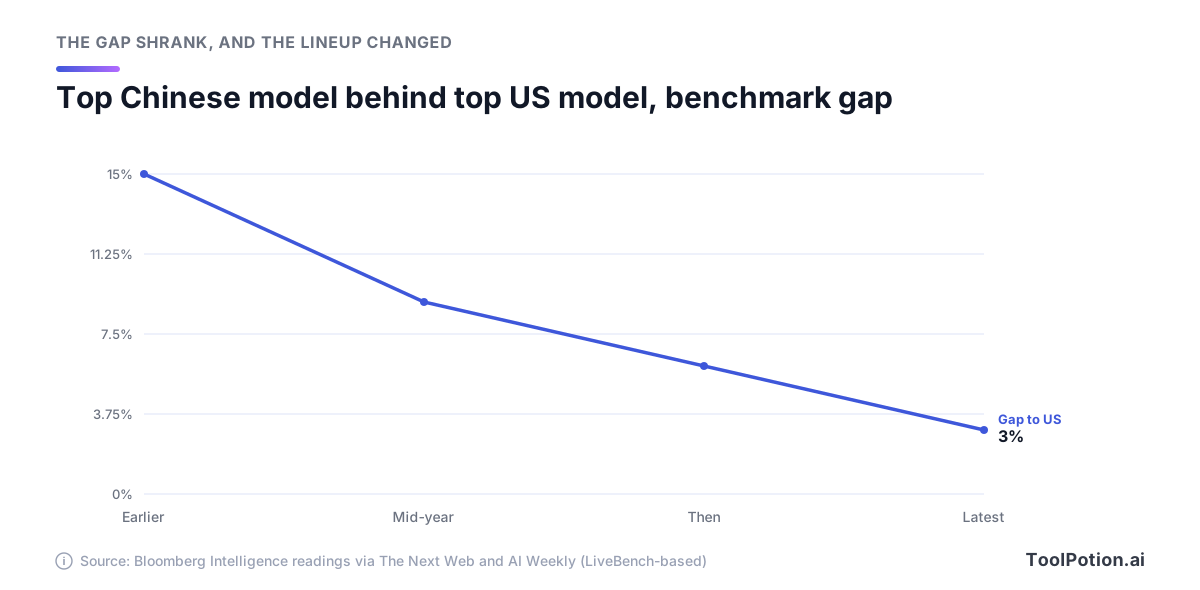
Behalten Sie die Einschränkungen im Blick. Nur drei der Top-15-Einträge auf LiveBench sind chinesisch, es handelt sich also um eine Geschichte an der Spitze und nicht um einen Durchmarsch. Außerdem zeigt die Lücke den Blick eines einzelnen Benchmarks auf das jeweils beste Modell beider Seiten, und keine der Quellen sagt, dass sie nur Open-Modelle betrifft. Die Richtung ist trotzdem klar, und das Modell, das den Abstand geschlossen hat, DeepSeek V4.1 Flash, ist Open-Weight.
Zwei weitere Dinge haben sich dieses Jahr geändert. Erstens hat Qwen laut eigener Model Card zu Qwen3.8-2.4T-A95B erstmals ein Modell der Max-Klasse als offene Gewichte veröffentlicht. Zweitens hat sich bei Metas offenen Releases etwas verschoben. Die neuesten Llama-Modelle auf Metas Hugging-Face-Seite sind weiterhin die Llama-4-Familie von 2025, etwa Llama 4 Scout. Auf Metas Entwicklerseite stehen inzwischen die gehosteten Muse-Spark-Modelle im Vordergrund, als offenes Modell ist Muse Glimmer aufgeführt, ein 30B-Open-Weight-Modell für lokale Agenten.
Die andere Neuigkeit kommt von Mistral. Das Unternehmen hat gerade Mistral Large 4 angekündigt, ein Modell mit 1 Billion Parametern, davon 52 Milliarden aktiv, und eine Vorschau in seiner API bereitgestellt. Die Gewichte sollen laut Mistral bis Monatsende folgen (Mistral). Zum Zeitpunkt des Schreibens ließen sie sich nicht herunterladen, und eine Lizenz hatte Mistral nicht veröffentlicht. Betrachten Sie Large 4 also als versprochen, nicht als veröffentlicht. Planen Sie erst damit, wenn Gewichte und Lizenz auf Hugging Face liegen.
Die Open-Weight-Modelle, die Sie kennen sollten
Hier die aktuellen Spitzenreiter im Überblick. Größen und Lizenzen stammen aus der jeweiligen Hugging-Face-Karte, die Preise von der Preisseite des jeweiligen Herstellers. „Aktiv“ bezeichnet bei einem Mixture-of-Experts-Modell die Zahl der Parameter, die pro Token feuern, und das bestimmt die Geschwindigkeit.
| Modell | Lizenz | Größe (aktiv) | Kontext | Hersteller-API, $ pro Mio. Tokens Ein / Aus |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B bis 16B) | 1M | 0,30 / 1,20 Spitzenzeit |
| DeepSeek V4-Pro | MIT | 1,7T | 1M | 1,32 / 3,96 Spitzenzeit |
| Kimi K3 | Kimi K3 License | 2,8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B dicht | 262K | gehostete Version geplant |
| gpt-oss-120b | Apache 2.0 | 117B (5,1B) | k. A. | keine Hersteller-API gelistet |
| Gemma 4 31B | Apache 2.0 | 31B dicht | 256K | keine Hersteller-API gelistet |
| Muse Glimmer | Apache 2.0 | 30B dicht | 131K+ | keine Hersteller-API gelistet |
| Mistral Large 4 | nicht veröffentlicht | 1T (52B) | k. A. | 1,36 / 4,18 Vorschau |
DeepSeek ist die sichere Standardwahl, wenn es um Kosten geht. Die Gewichte von V4.1 Flash stehen unter der MIT-Lizenz, der API-Preis ist der niedrigste unter den großen Modellen, und halber Preis in Nebenzeiten senkt ihn weiter (DeepSeek-Dokumentation). Lassen Sie sich vom Namen nicht täuschen. „Flash“ ist hier ein Modell mit 763B Parametern und einem Download von 510 GB (Model Card). V4-Pro-0813 ist mit rund 1,7T noch größer.
Kimi K3 sorgt für die Schlagzeilen. Mit 2,8 Billionen Parametern, davon 104 Milliarden aktiv, erreicht es laut eigener Karte 93,5 auf GPQA Diamond und 91,2 auf BrowseComp. Das sind Zahlen von Moonshot, lesen Sie sie also als Behauptungen. Außerdem ist Moonshots eigene API die teuerste der offenen Gruppe, was viele überrascht (dazu unten mehr).
GLM-5.3 von Z.ai ist der Coding-Spezialist. Es teilt sich ein Basismodell mit GLM-5.2, und laut Z.ai stammt jeder Zugewinn aus dem Post-Training, darunter ein Sprung von 50 % im hauseigenen Coding-Benchmark (Model Card). Das ist eine Messung des Herstellers. Das günstige Schwestermodell GLM-5.3-Flash kostet laut Preisliste 0,15 $ für Eingabe und 0,50 $ für Ausgabe.
Qwen bietet die größte Bandbreite. Qwen3.8-27B ist ein dichtes 27B-Modell unter Apache 2.0 mit Vision, 262K nativem Kontext und gemeldeten 61,7 auf SWE-bench Pro (Model Card). Für eine einzelne Workstation ist es der beste erste Versuch für Coding und Agenten, und für die meisten kleinen Teams das Modell, mit dem man anfangen sollte. Das große Qwen3.8-2.4T steht unter einer eigenen Lizenz, dazu gleich mehr. Qwen können Sie auch über die App ausprobieren.
gpt-oss-120b von OpenAI ist inzwischen alt, aber immer noch nützlich. Es steht unter Apache 2.0, hat 5,1B aktive Parameter und läuft laut OpenAI auf einer einzigen 80-GB-GPU (Model Card). Es erschien 2025, und auf OpenAIs Hugging-Face-Seite tauchte kein neueres gpt-oss-Release auf. Gemma 4 ist die aktuelle Google-Familie; das 31B-Modell steht unter Apache 2.0, hat ein Fenster von 256K und wird mit quantisierten Builds für Ollama und llama.cpp geliefert (Model Card). Muse Glimmer ist das kleine Modell: Laut Meta ist eine Version mit etwa 4 Bit unter 20 GB groß und läuft in einem Rahmen von 24 GB oder 32 GB, mit rund 1 % Qualitätsverlust bei der engeren Einstellung (Model Card).
Aus Europa gibt es derzeit zwei Optionen. Mistral Medium 3.5 ist ein dichtes 128B-Modell mit 256K-Fenster unter einer modifizierten MIT-Lizenz, die Mistral als offen für kommerzielle Nutzung beschreibt, außer für Unternehmen mit hohem Umsatz. Mistral Small 4 mit 119B und das ältere Mistral Large 3 stehen auf Hugging Face unter Apache 2.0.
„Open“ kann trotzdem Bedingungen haben
Nur die Modelle unter Apache 2.0 und MIT sind offen in dem Sinne, wie die meisten Entwickler es meinen. Mehrere der stärksten sind es nicht. Lesen Sie die Lizenzdatei, nicht die Schlagzeile.
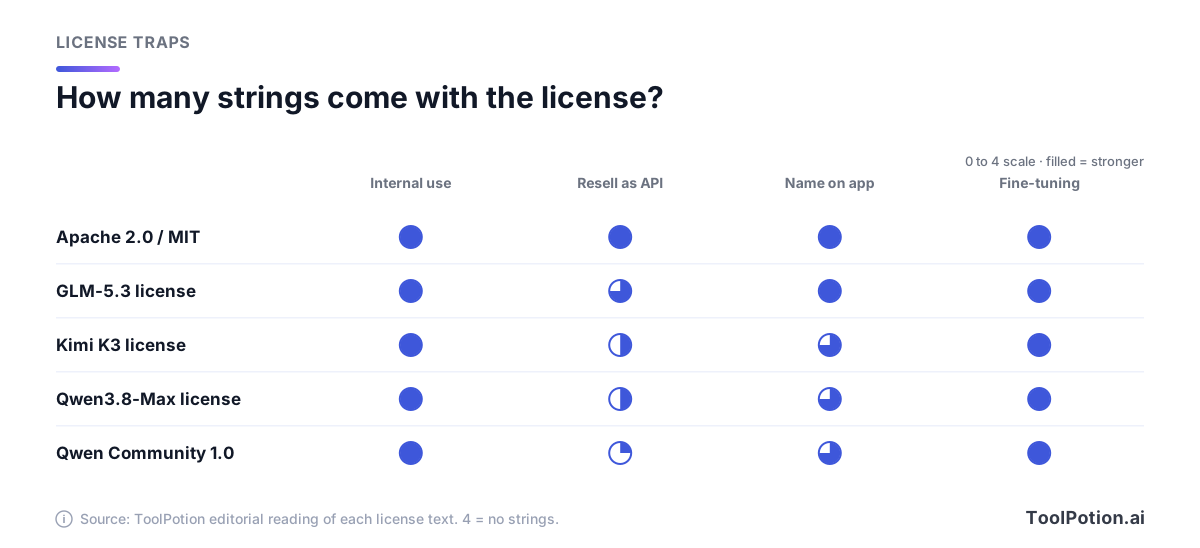
Bei den individuellen Lizenzen gilt dasselbe Muster. Nutzen, Anpassen und Fine-Tuning sind frei. Die Bedingungen betreffen den Verkauf des Modells an andere, meist als API, sobald eine Umsatzgrenze überschritten wird. So verlangt Moonshots Lizenz, dass ein „Model as a Service“-Betreiber mit mehr als 20 Millionen $ Umsatz in 12 Monaten vor der kommerziellen Nutzung eine gesonderte Vereinbarung abschließt. Produkte mit 100 Millionen monatlichen Nutzern oder 20 Millionen $ Monatsumsatz müssen „Kimi K3“ in der Oberfläche anzeigen (Lizenztext). Die interne Nutzung ist ausgenommen.
Die Lizenz von Z.ai ist lockerer. Die einzige Hürde ist eine Sicherheitsprüfung für Model-as-a-Service-Betreiber mit mehr als 10 Milliarden $ Umsatz. Die Lizenzen von Qwen sind die strengsten der Gruppe. Die Qwen Community License für Qwen3.8-Flash-Next besagt, dass jedes Unternehmen, das ein Model-as-a-Service- oder „AI Work Assistant“-Geschäft betreibt, zuerst eine gesonderte Lizenz von Qwen einholen muss, mit einer Ausnahme für die interne Nutzung (Lizenztext). Die Max-Lizenz für das 2.4T-Modell hebt diese Schwelle auf 50 Millionen $ Umsatz an.
Wenn Sie eine App auf Basis eines dieser Modelle bauen, sind Sie mit hoher Wahrscheinlichkeit auf der sicheren Seite. Besteht Ihr Produkt darin, „eine API, die dieses Modell bereitstellt“, lesen Sie die Lizenz vor dem Start gemeinsam mit einem Anwalt. Wenn Sie null Zweifel wollen, bleiben Sie bei Apache 2.0 oder MIT. Das sind DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4 und Muse Glimmer.
Was gehostete APIs kosten
Open Weights bedeuten nicht automatisch eine günstige API. Das Bild ändert sich je nachdem, wer das Modell hostet.
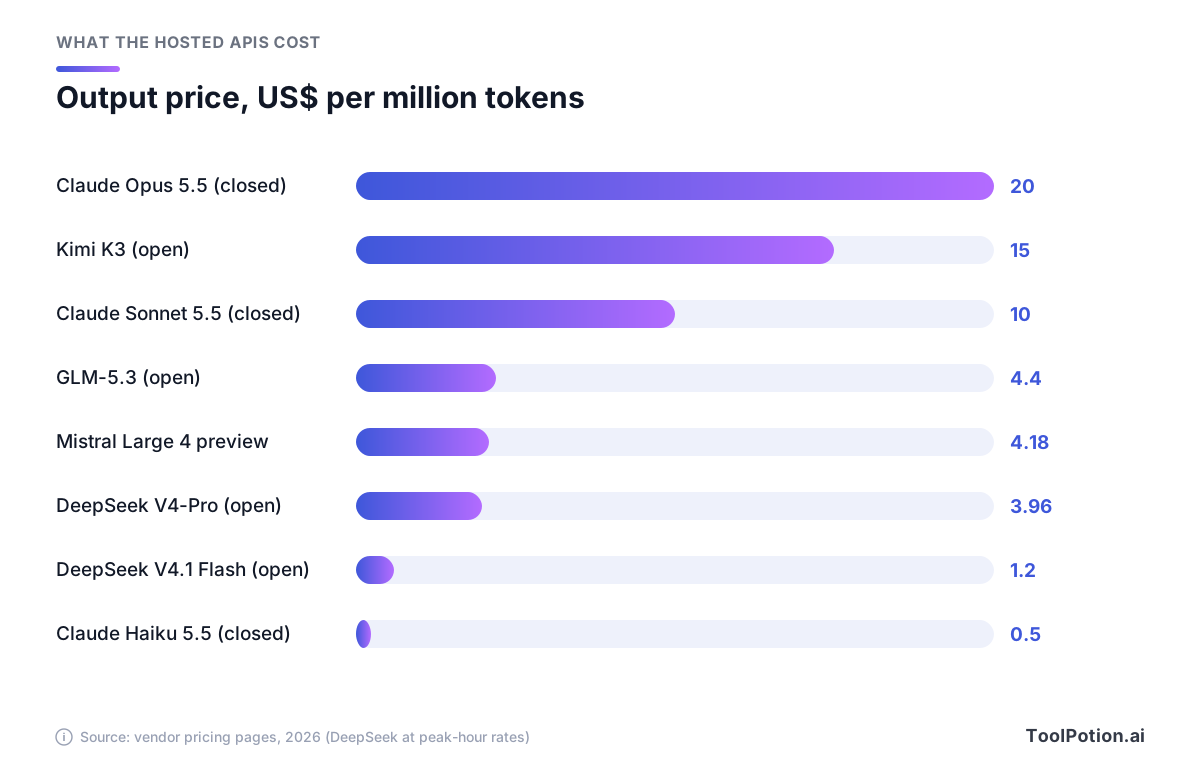
Moonshot verlangt laut Preisseite für Kimi K3 3 $ für Eingabe und 15 $ für Ausgabe pro Million Tokens. Das ist mehr als bei Anthropics Claude Sonnet 5.5 mit 2 $ und 10 $, und Sonnet ist ein geschlossenes Modell. DeepSeek ist das Gegenteil: V4-Pro-Ausgabe kostet 3,96 $ zur Spitzenzeit und 1,98 $ in Nebenzeiten. GLM-5.3 von Z.ai kostet 1,40 $ für Eingabe und 4,40 $ für Ausgabe.
Kleine geschlossene Modelle unterbieten die meisten offenen Flaggschiffe. Claude Haiku 5.5 steht laut der jeweiligen Preisseite mit 0,10 $ für Eingabe und 0,50 $ für Ausgabe in der Liste, genauso wie OpenAIs GPT-6 Luna. „Open gehen, um Geld zu sparen“ gilt also nur gegenüber den teuren geschlossenen Stufen, und nur, wenn Sie einen günstigen offenen Hoster wählen.
Am günstigsten ist oft ein Drittanbieter, der dieselben Gewichte bereitstellt. Die öffentliche Modellliste von OpenRouter zeigt gpt-oss-120b bei etwa 0,04 $ für Eingabe und 0,17 $ für Ausgabe pro Million Tokens, wobei die Preise je nach Anbieter variieren und sich oft ändern. OpenRouter, Together AI, Fireworks AI und Groq bieten offene Modelle alle hinter einem einheitlichen API-Format an, ein Anbieterwechsel ist also nur eine geänderte Base-URL.
Selbst betreiben oder hosten lassen
Es gibt vier Wege, ein offenes Modell zu betreiben, und jeder gibt Ihnen etwas mehr Kontrolle und etwas mehr Arbeit.
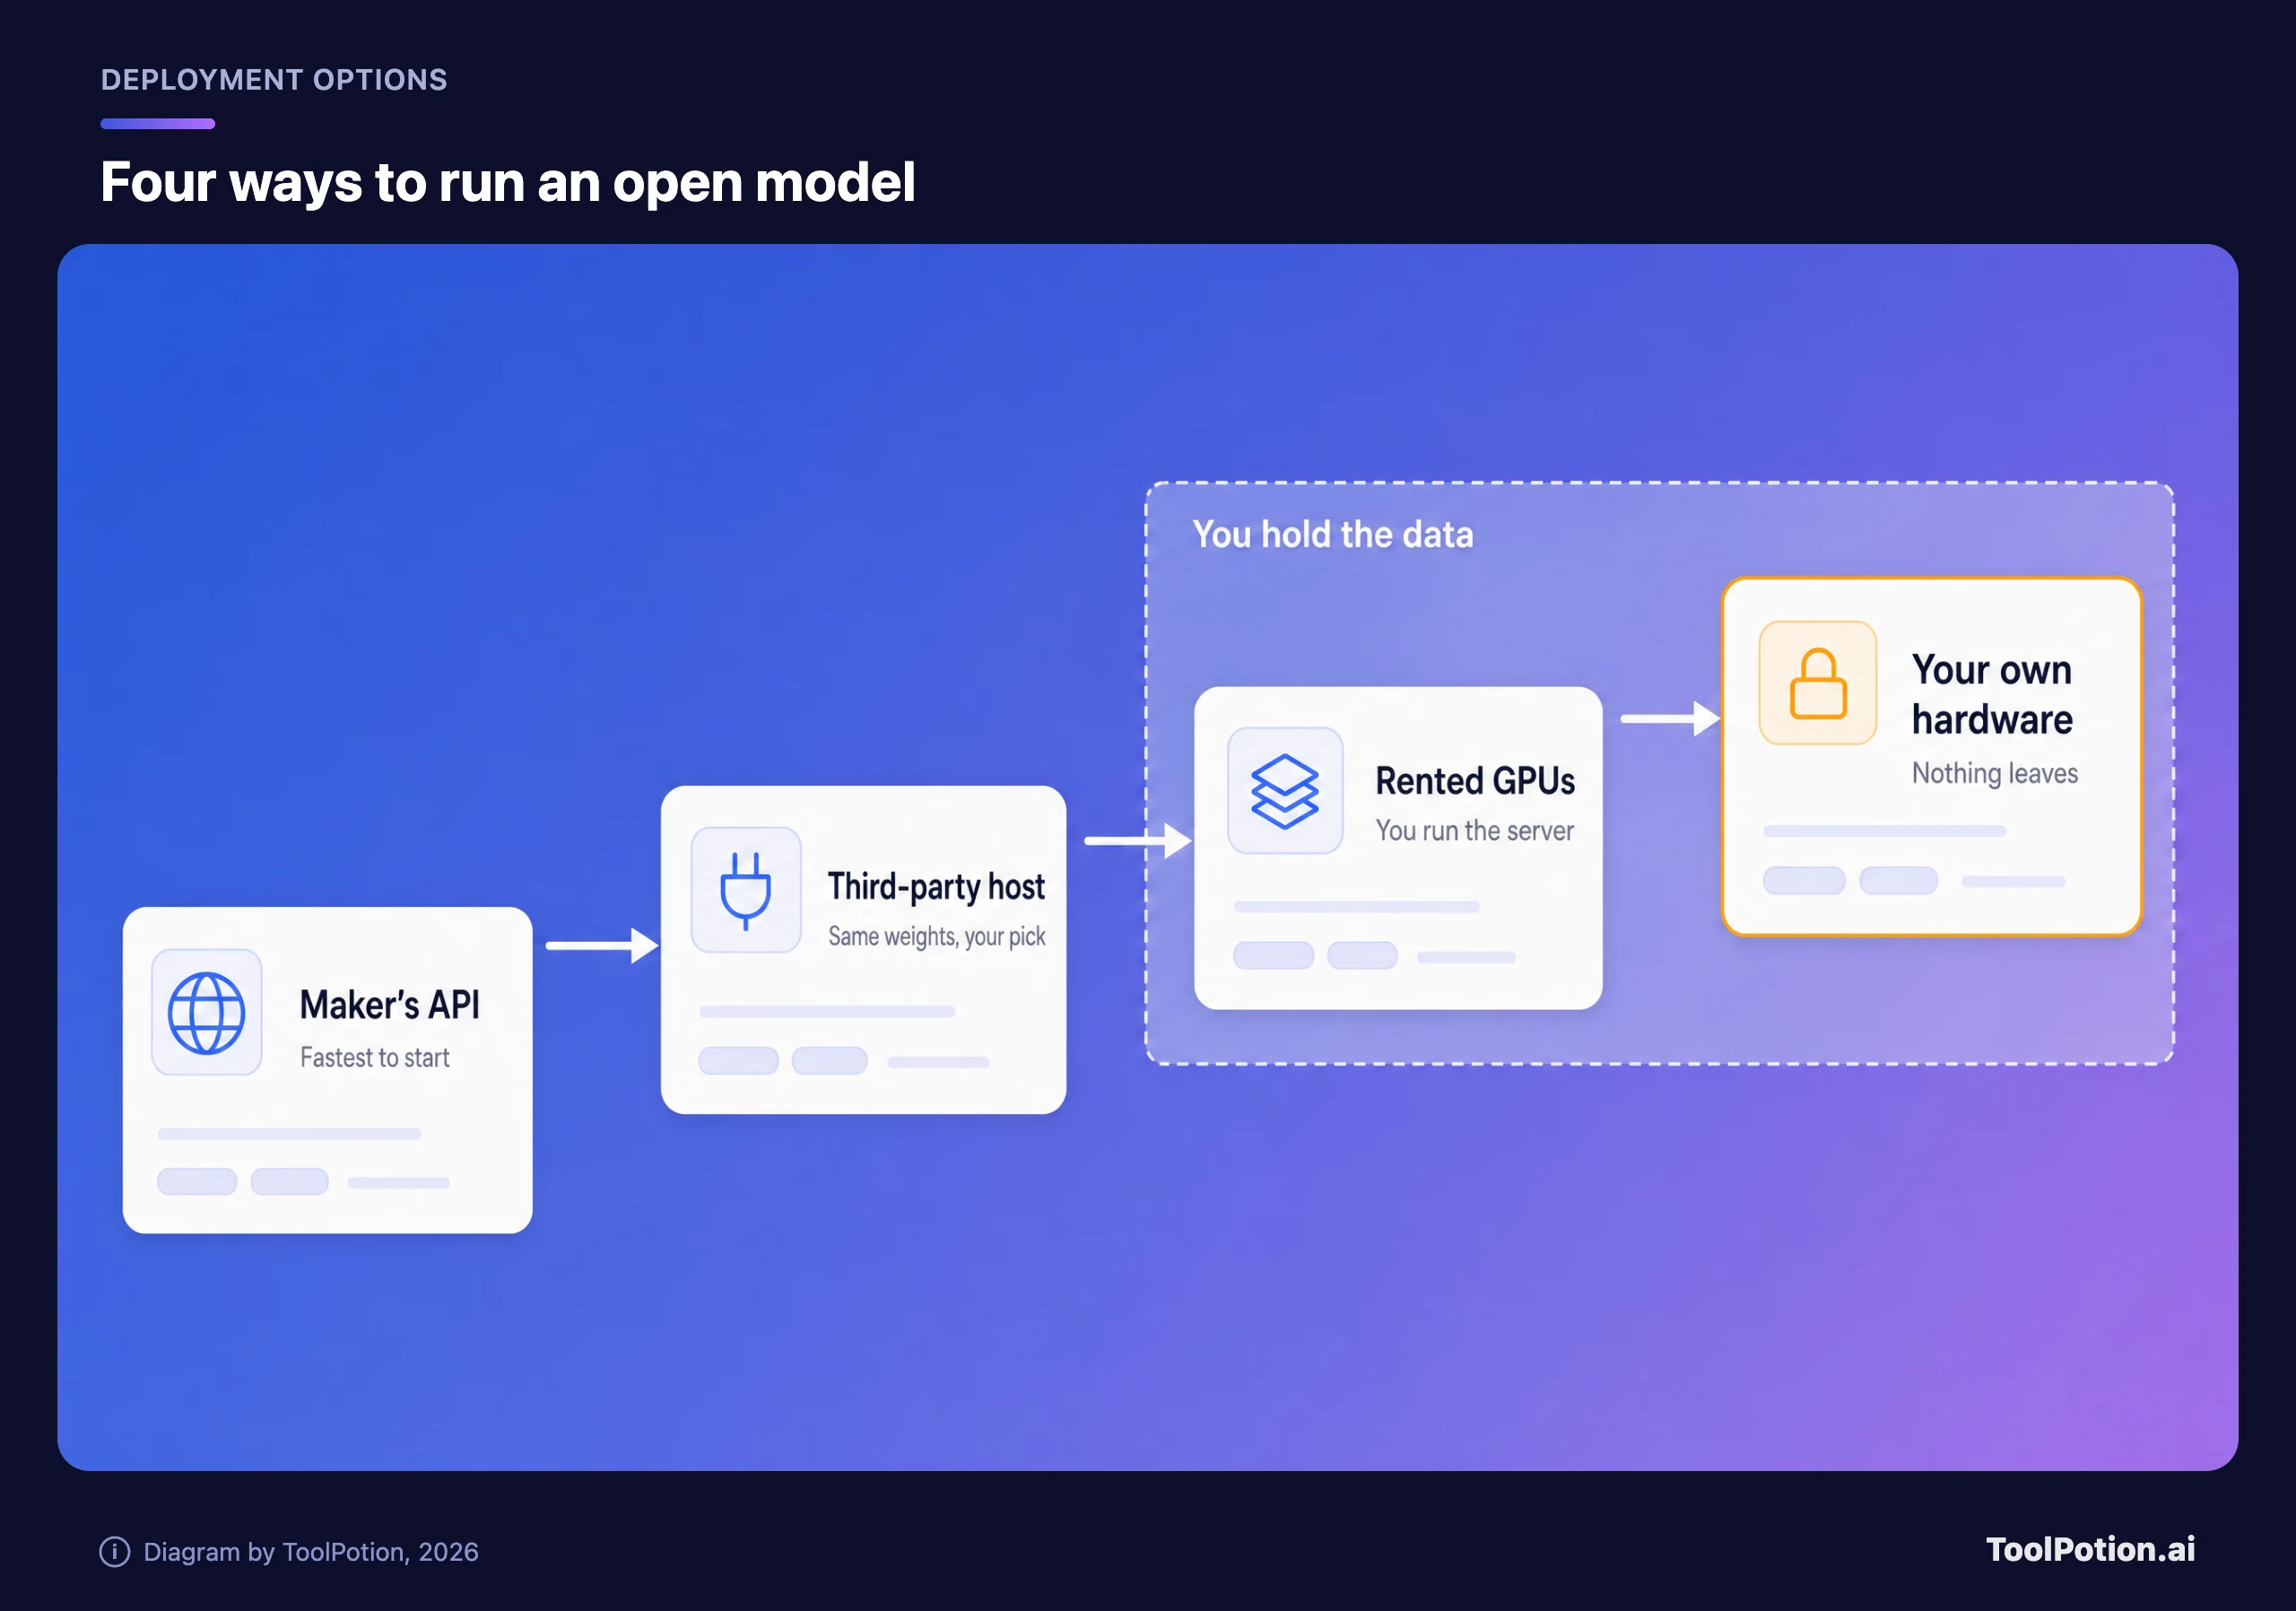
Die ersten beiden sind verwaltete Dienste. Sie senden Tokens an den Hersteller oder an einen Host, und Ihre Daten laufen über das Netz eines Dritten. Bei den letzten beiden liegt das Modell auf Maschinen unter Ihrer Kontrolle, was der Sinn der Sache ist, wenn ein Vertrag oder eine Aufsichtsbehörde verlangt, dass die Daten nicht abfließen. Gewichte, die nicht auf Ihre Hardware passen, sind das übliche Hindernis, beginnen Sie also mit der Größe.
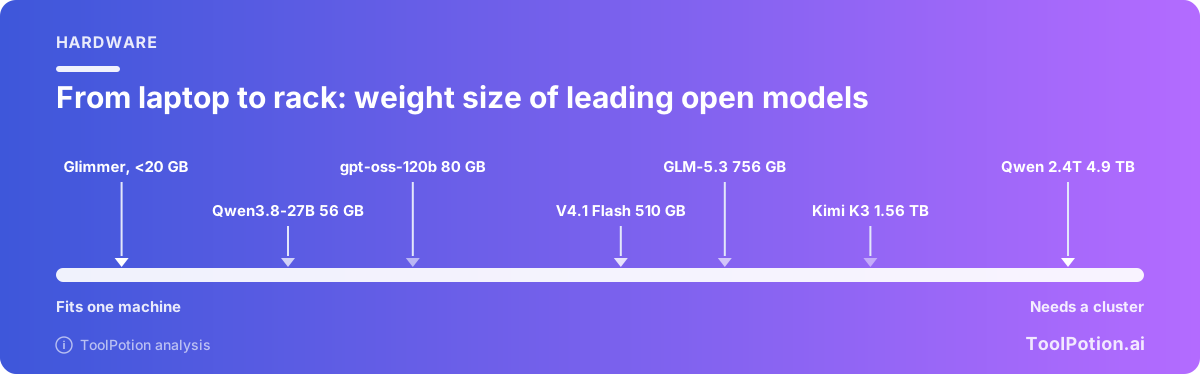
Die meisten Spitzenmodelle sind viel zu groß für einen einzelnen Server. Allein die Gewichte von Kimi K3 wiegen 1,56 TB, mehr als die 1,44 TB eines Acht-GPU-Knotens mit 180-GB-B200-Karten. DeepSeek V4-Pro und GLM-5.3 brauchen jeweils Hunderte Gigabyte. Auf eine einzelne Maschine passen die Modelle der Klasse 20B bis 120B. Prüfen Sie mit dem Rechner, ob ein Modell in einer bestimmten Präzision auf Ihre Hardware passt.
Probieren Sie die Standardwerte aus. gpt-oss-120b mit 4 Bit braucht inklusive Overhead etwa 70 GB und passt damit auf eine 80-GB-GPU. Wechseln Sie zu Kimi K3, verlangt derselbe Rechner zehn 180-GB-GPUs. Zehn GPUs bedeuten zwei Acht-GPU-Knoten. Bei Lambdas On-Demand-Preis von 6,69 $ pro B200-Stunde laut Lambdas Preisseite kosten diese 16 GPUs im Dauerbetrieb über einen Monat rund 78.000 $. So viel kostet der Eigenbetrieb eines offenen Spitzenmodells, bevor irgendjemand es betreut.
Das untere Ende ist deutlich freundlicher. Lambda listet eine 80-GB-GPU ab 3,99 $ pro Stunde, das sind rund 2.900 $ im Monat bei Dauerbetrieb. Ob das eine API schlägt, hängt ganz vom Volumen ab.
Bei 300 Millionen Output-Tokens im Monat und einem API-Preis von 10 $ sind beide Rechnungen etwa gleich hoch. Darunter gewinnt die API. Darüber gewinnt die Miete, vorausgesetzt, die GPU ist ausgelastet und das Modell ist für die Aufgabe gut genug. Der ehrliche Vergleich ist allerdings der mit einem günstigen Host. Beim gelisteten Hostpreis von gpt-oss-120b von etwa 0,17 $ pro Million Output-Tokens bekommen Sie für 2.900 $ rund 17 Milliarden Output-Tokens, eine einzelne gemietete GPU schlägt einen Host allein bei den Kosten also fast nie. Mieten Sie für Datenschutz, Kontrolle und planbare Latenz. Mieten Sie nicht, um bei einem kleinen Modell Geld zu sparen.
Hier ein Rechenbeispiel mit ausgedachtem, aber plausiblem Volumen. Ein Support-Team fasst täglich 20.000 Tickets zusammen, jeweils 1.500 Tokens Eingabe und 300 Tokens Ausgabe. Das sind etwa 900 Millionen Input- und 180 Millionen Output-Tokens im Monat. Mit Claude Sonnet 5.5 zu 2 $ und 10 $ pro Million beträgt die Rechnung 3.600 $. Mit DeepSeek V4.1 Flash zu Spitzenzeit-Preisen sind es höchstens 486 $, in Nebenzeiten die Hälfte. Mit gpt-oss-120b zu den gelisteten Hostpreisen sind es etwa 64 $. Eine gemietete 80-GB-GPU kostet 2.913 $, egal wie viel Sie ihr schicken. Der günstige Host gewinnt mit weitem Abstand, und das geschlossene Modell kostet zum Preis des Herstellers etwa siebenmal so viel wie das offene.
Zwei Abkürzungen helfen, bevor Sie etwas ausgeben. Für Laptop oder Workstation laufen mit Ollama und llama.cpp quantisierte Builds von Gemma 4, Qwen3.8-27B und Muse Glimmer mit einem einzigen Befehl. Für einen Produktionsserver ist vLLM die Serving-Engine, die sowohl die Model Card von Kimi K3 als auch die von Qwen3.8 als unterstützt aufführen.
So wählen Sie aus
Beginnen Sie mit Ihrer Rahmenbedingung, nicht mit dem Leaderboard. Drei Fragen sortieren die meisten Fälle.
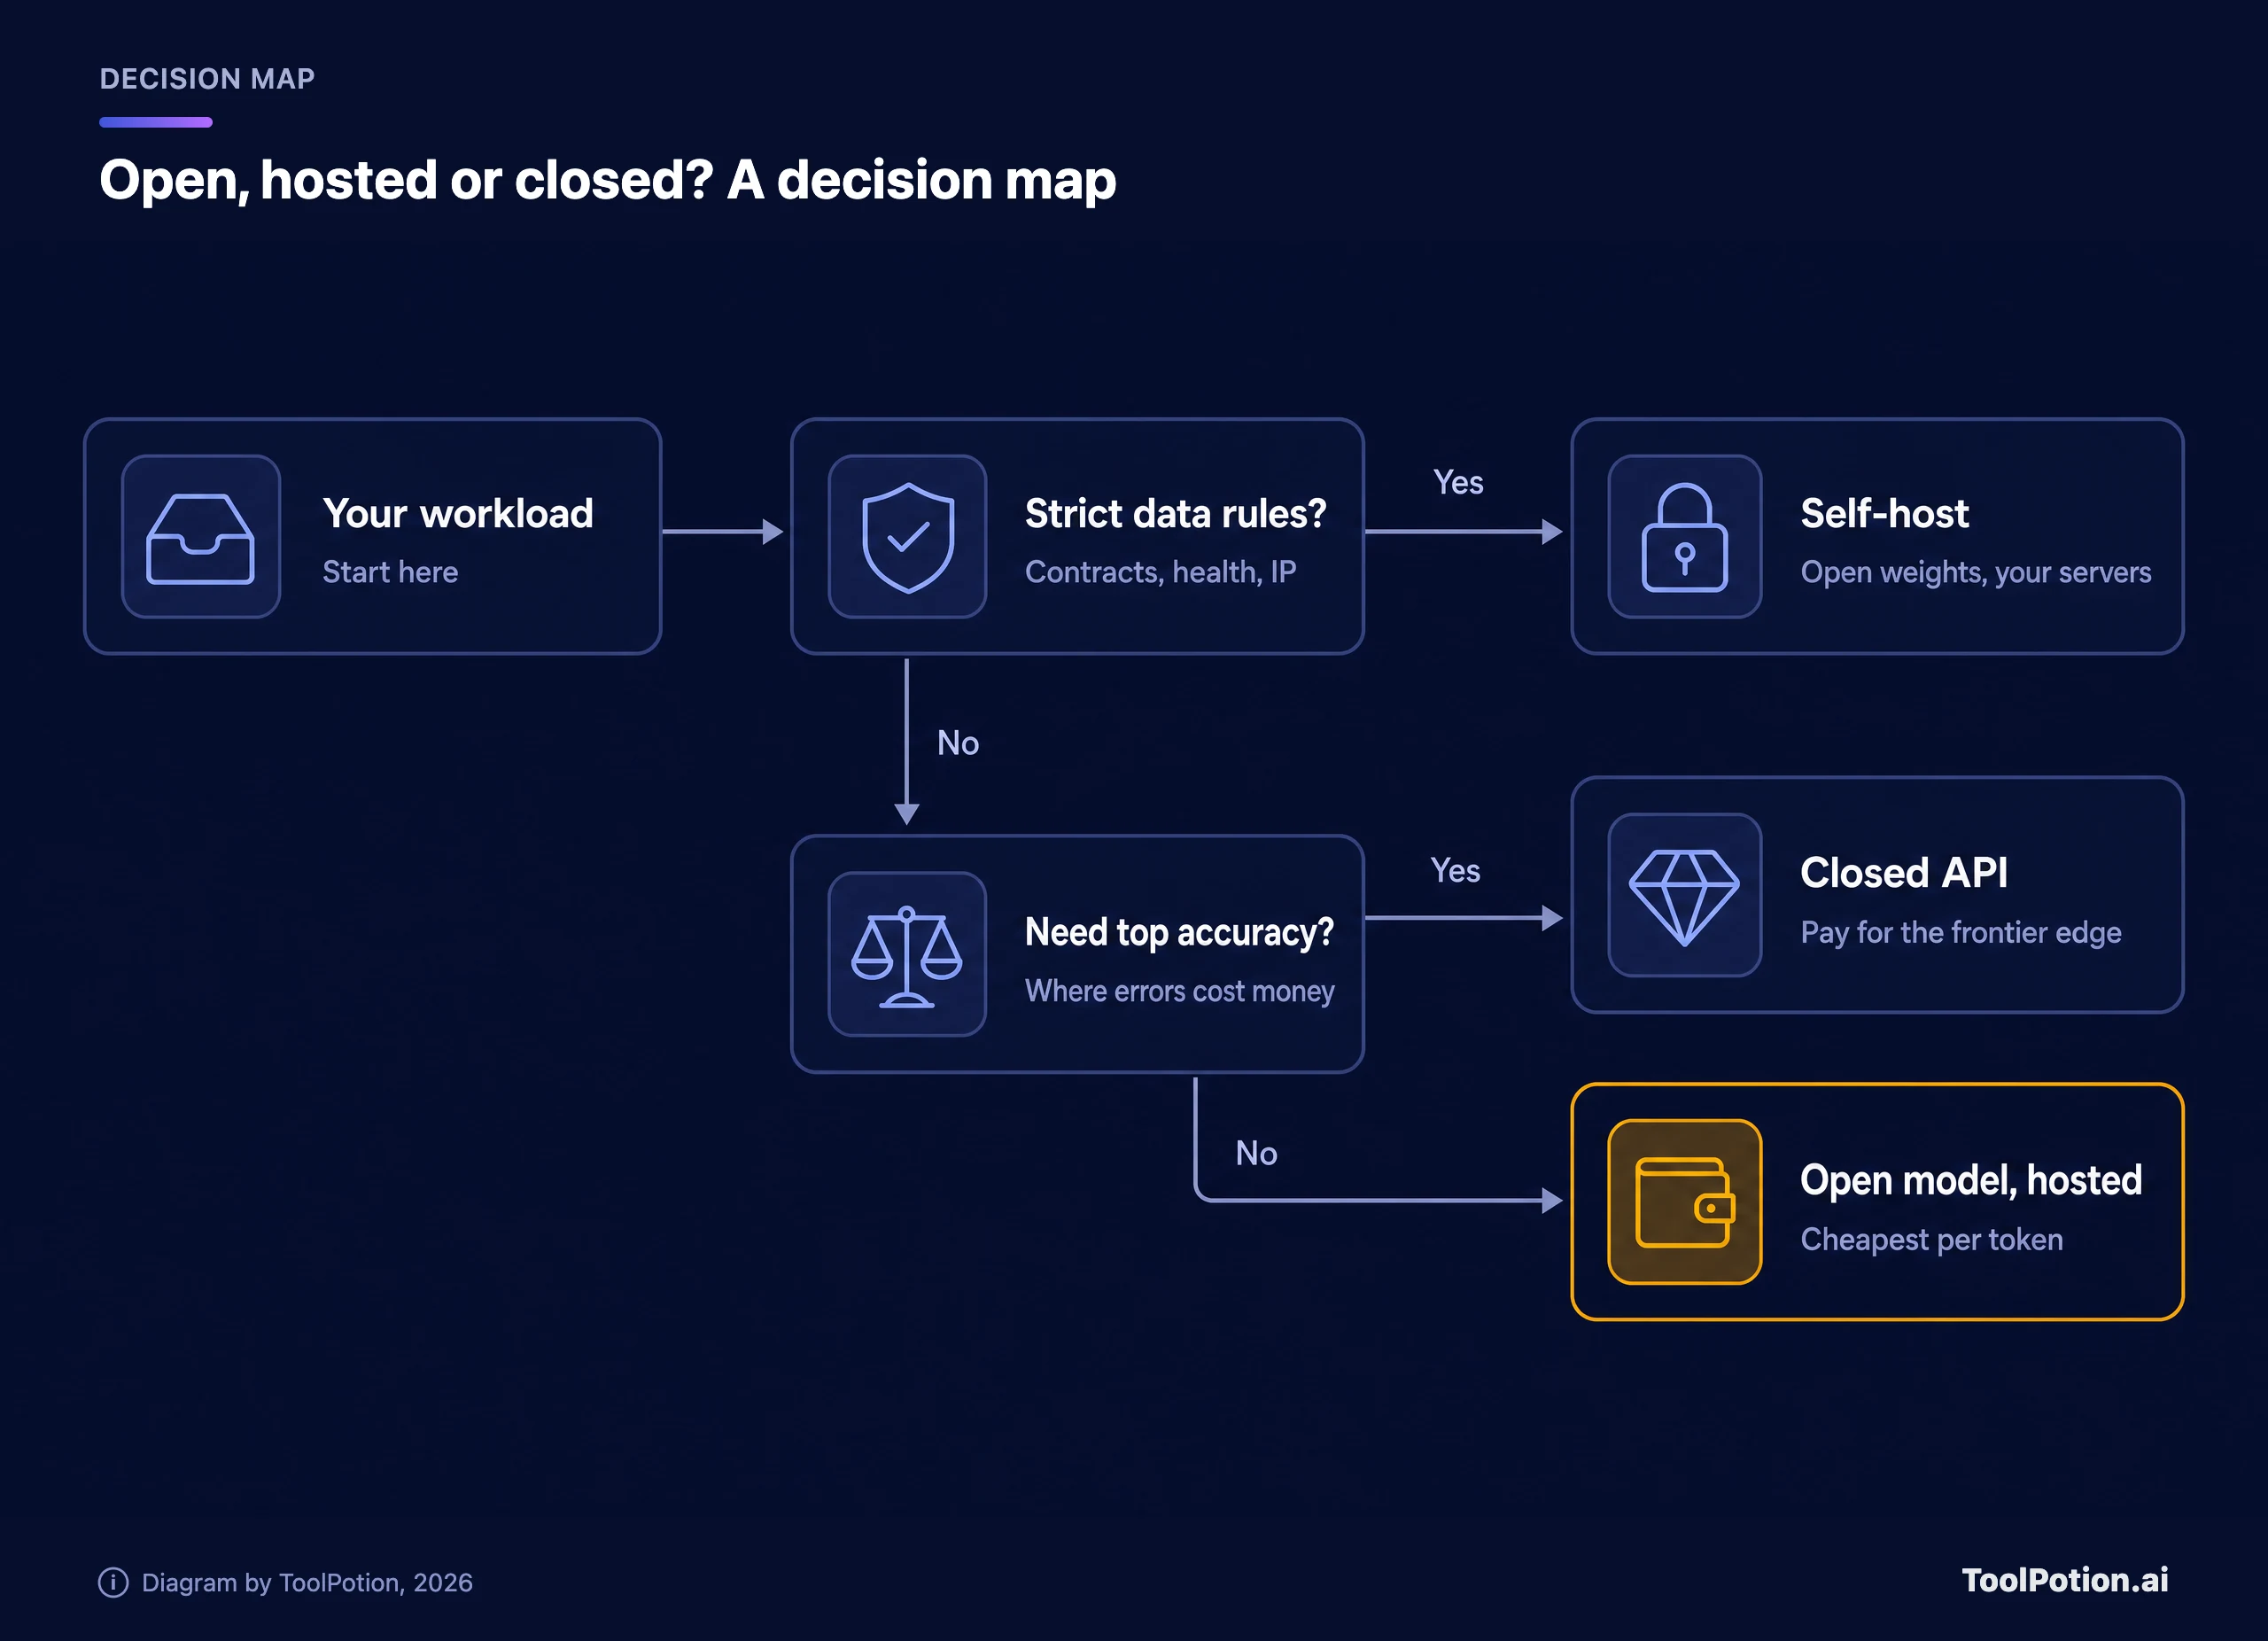
Wenn Ihre Daten nicht aus Ihrer Kontrolle gelangen dürfen, betreiben Sie selbst, und das Modell muss auf Ihre Hardware passen. Unter dieser Bedingung gilt:
- Eine GPU oder Workstation: Qwen3.8-27B für Coding und Agenten, gpt-oss-120b, wenn Sie ein westliches Modell wollen, Muse Glimmer oder Gemma 4 für den Laptop.
- Ein Multi-GPU-Server: DeepSeek V4.1 Flash oder GLM-5.3, wenn Sie sich acht große Karten und einige Hundert Gigabyte Gewichte leisten können.
- Ein Cluster: Kimi K3 oder Qwen3.8-2.4T, aber nur, wenn Sie ein Team haben, das hauptberuflich Inferenz betreibt.
Wenn Ihre Daten das Haus verlassen dürfen, fragen Sie, ob Fehler teuer sind. Wo sie es sind (juristische Entwürfe, Finanzanalysen, Code, der ohne Review ausgeliefert wird), zahlen Sie für ein geschlossenes Spitzenmodell und prüfen es an Ihren eigenen Beispielen. Wo sie es nicht sind (Zusammenfassen, Tagging, Extraktion, interne Suche, Code-Erstentwürfe), ist ein offenes Modell über einen günstigen Host der beste Preis, den Sie finden.
Gehen Sie diese Liste der Reihe nach durch, bevor Sie sich entscheiden:
1. Halten Sie die Bedingung fest, die sich nicht bewegen lässt: Speicherort der Daten, Monatsbudget oder eine Qualitätsuntergrenze.
2. Prüfen Sie die Lizenz für Ihren Einsatz. Ein Produkt auf Basis des Modells ist fast überall in Ordnung. Beim Weiterverkauf des Modells liegen die Bedingungen.
3. Prüfen Sie den Speicher: Gewichte in GB gegen die Hardware, die Sie tatsächlich kaufen oder mieten würden.
4. Kalkulieren Sie dieselbe Last bei einer Hersteller-API, einem Drittanbieter-Host und einer gemieteten GPU.
5. Lassen Sie 50 Ihrer eigenen Aufgaben durch zwei oder drei Kandidaten laufen und behalten Sie den Sieger.
Testen Sie, bevor Sie sich festlegen. Die Benchmarks hier stammen von den Herstellern und laufen auf unterschiedlichen Suiten, eine 90 auf einem Leaderboard sagt also wenig über eine 88 auf einem anderen. Nehmen Sie 50 echte Aufgaben aus Ihrer Arbeit, lassen Sie sie durch zwei oder drei Kandidaten laufen und bewerten Sie die Ergebnisse. Ein Nachmittag damit schlägt eine Woche Model-Card-Lektüre.
Die Risiken, die auf keiner Model Card stehen
Sicherheit. Offene Gewichte machen ein Modell nicht sicher. In seiner Evaluierung älterer DeepSeek-Modelle von 2025 stellte das NIST der US-Regierung fest, dass das beste davon, R1-0528, unter gängigen Jailbreaks 94 % der offen bösartigen Anfragen erfüllte, gegenüber 8 % bei den US-Referenzmodellen. DeepSeeks Agenten folgten außerdem 12-mal häufiger bösartigen Anweisungen, die in den von ihnen verarbeiteten Inhalten versteckt waren (NIST CAISI). Das sind frühere Modelle als die heutige V4-Reihe, und eine entsprechende öffentliche Evaluierung der aktuellen Releases fand sich in den Quellen für diesen Beitrag nicht. Sehen Sie es als Grund zum Testen, besonders bevor Sie einem Modell Tools und Schreibzugriff geben.
Zensur. Das NIST stellte außerdem fest, dass DeepSeek-Modelle viermal so viele unzutreffende KPCh-Narrative wiedergaben wie US-Referenzmodelle. Ein separater NIST-Bericht zu Kimi K2 Thinking fand starke Zensur auf Chinesisch, doch auf Englisch, Spanisch und Arabisch war das Modell relativ unzensiert. Wenn Ihre Nutzer auf Chinesisch nach Politik oder Geschichte fragen, testen Sie das direkt. Bei Code und Tabellen kommt es selten vor.
Datenresidenz. Wer das Modell hostet, entscheidet, wohin Ihre Daten gehen. Laut Datenschutzerklärung von DeepSeek erhebt, verarbeitet und speichert das Unternehmen personenbezogene Daten in der Volksrepublik China (Datenschutzerklärung von DeepSeek). Das gilt für die eigene App und API, nicht für die MIT-lizenzierten Gewichte, die Sie anderswo betreiben. Mistral argumentiert genau umgekehrt: Large 4 sei in den eigenen Rechenzentren in Europa trainiert worden, und die Vorschau laufe als europäische Bereitstellung unter europäischem Recht. Fragen Sie bei jedem Host, wo die Inferenz läuft und was protokolliert wird, bevor Sie Kundendaten senden.
Veralterung. Offene Modelle sind nach Monaten überholt. Die gpt-oss-Gewichte sind ein Jahr alt, Metas neuestes Llama stammt von 2025, und Qwen und DeepSeek haben allein 2026 mehrere Versionen veröffentlicht. Legen Sie die exakte getestete Modellversion fest und testen Sie beim Upgrade erneut.
Wer weiterhin für eine geschlossene API zahlen sollte
Die 3 % sind der Messwert eines einzelnen Benchmarks. Geschlossene Modelle führen an der absoluten Spitze weiterhin, und die Labs, die sie verkaufen, ergänzen laufend Tools und Managed-Funktionen, die Open Weights nicht mitbringen.
Zahlen Sie für Claude oder ChatGPT, wenn Sie bei schwieriger Arbeit mit hohem Risiko die beste Genauigkeit brauchen, niemanden haben, der Infrastruktur betreibt, oder das Volumen zu klein ist, als dass irgendein Hosting-Modell ins Gewicht fiele. Ein Team mit ein paar tausend Aufrufen am Tag gibt weniger für Entwicklerzeit aus, als es an Tokens spart. Zahlen Sie auch dann, wenn ein einziger Anbieter für Verfügbarkeit, Sicherheit und Support geradestehen soll.
Kombinieren statt wechseln. Ein gängiges Setup schickt den Routine-Großteil über einen Host an ein offenes Modell und eskaliert schwierige Fälle an ein geschlossenes. Die Routing-Regeln in unserem Leitfaden zur Zuordnung von Modellstufen zu Aufgaben lassen sich direkt übertragen: standardmäßig günstig, bei Fehlschlag eskalieren.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Open-Weight und Open-Source?
Open-Weight bedeutet, dass Sie das trainierte Modell herunterladen können. Open-Source im strengen Sinn würde auch Trainingsdaten und Code unter einer anerkannten Lizenz umfassen. Fast nichts in dieser Liste erfüllt diese Hürde. Modelle unter Apache 2.0 und MIT kommen ihr in der Praxis am nächsten. Individuelle Lizenzen wie die von Kimi und Qwen fügen Bedingungen hinzu.
Darf ich diese Modelle kommerziell nutzen?
Ja, um Produkte darauf aufzubauen, und zwar mit jeder hier behandelten Lizenz. Die Bedingungen greifen, wenn Sie das Modell selbst als Dienst verkaufen, und in einigen Fällen, wenn Ihr Produkt riesig ist. Modelle unter Apache 2.0 und MIT haben überhaupt keine Umsatzbedingungen.
Welches offene Modell ist am besten fürs Coding?
Nach Herstellerangaben führen GLM-5.3, Kimi K3 und DeepSeek V4.1 Flash, und alle drei brauchen Hardware der Serverklasse. Für einen einzelnen Rechner ist Qwen3.8-27B die praktische Wahl. Machen Sie eigene Tests mit Ihrer eigenen Codebasis, denn die Benchmark-Suiten unterscheiden sich.
Ist DeepSeek für Unternehmensdaten sicher?
Das hängt davon ab, wie Sie es betreiben. Die DeepSeek-App und -API speichern Daten gemäß der oben genannten Richtlinie in China. Die MIT-Gewichte, auf eigenen Servern oder bei einem Host Ihres Vertrauens betrieben, senden nichts an DeepSeek. Die davon unabhängigen Risiken im Modellverhalten aus der älteren NIST-Evaluierung bleiben bestehen.
Wie viel GPU-Speicher brauche ich?
Grob Parameter mal Bits geteilt durch acht, plus etwa 20 % für Cache und Laufzeit. Ein 27B-Modell mit 8 Bit braucht inklusive Overhead etwa 33 GB. Ein 117B-Modell mit 4 Bit etwa 70 GB. Der Rechner oben übernimmt die Rechnerei für Sie.
Wann wird Mistral Large 4 offen sein?
Mistral hat die Gewichte kurz nach der Ankündigung versprochen und die Lizenzbedingungen noch nicht veröffentlicht. Prüfen Sie die Hugging-Face-Seite, bevor Sie damit planen.