跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

Mage-VL-Cowork

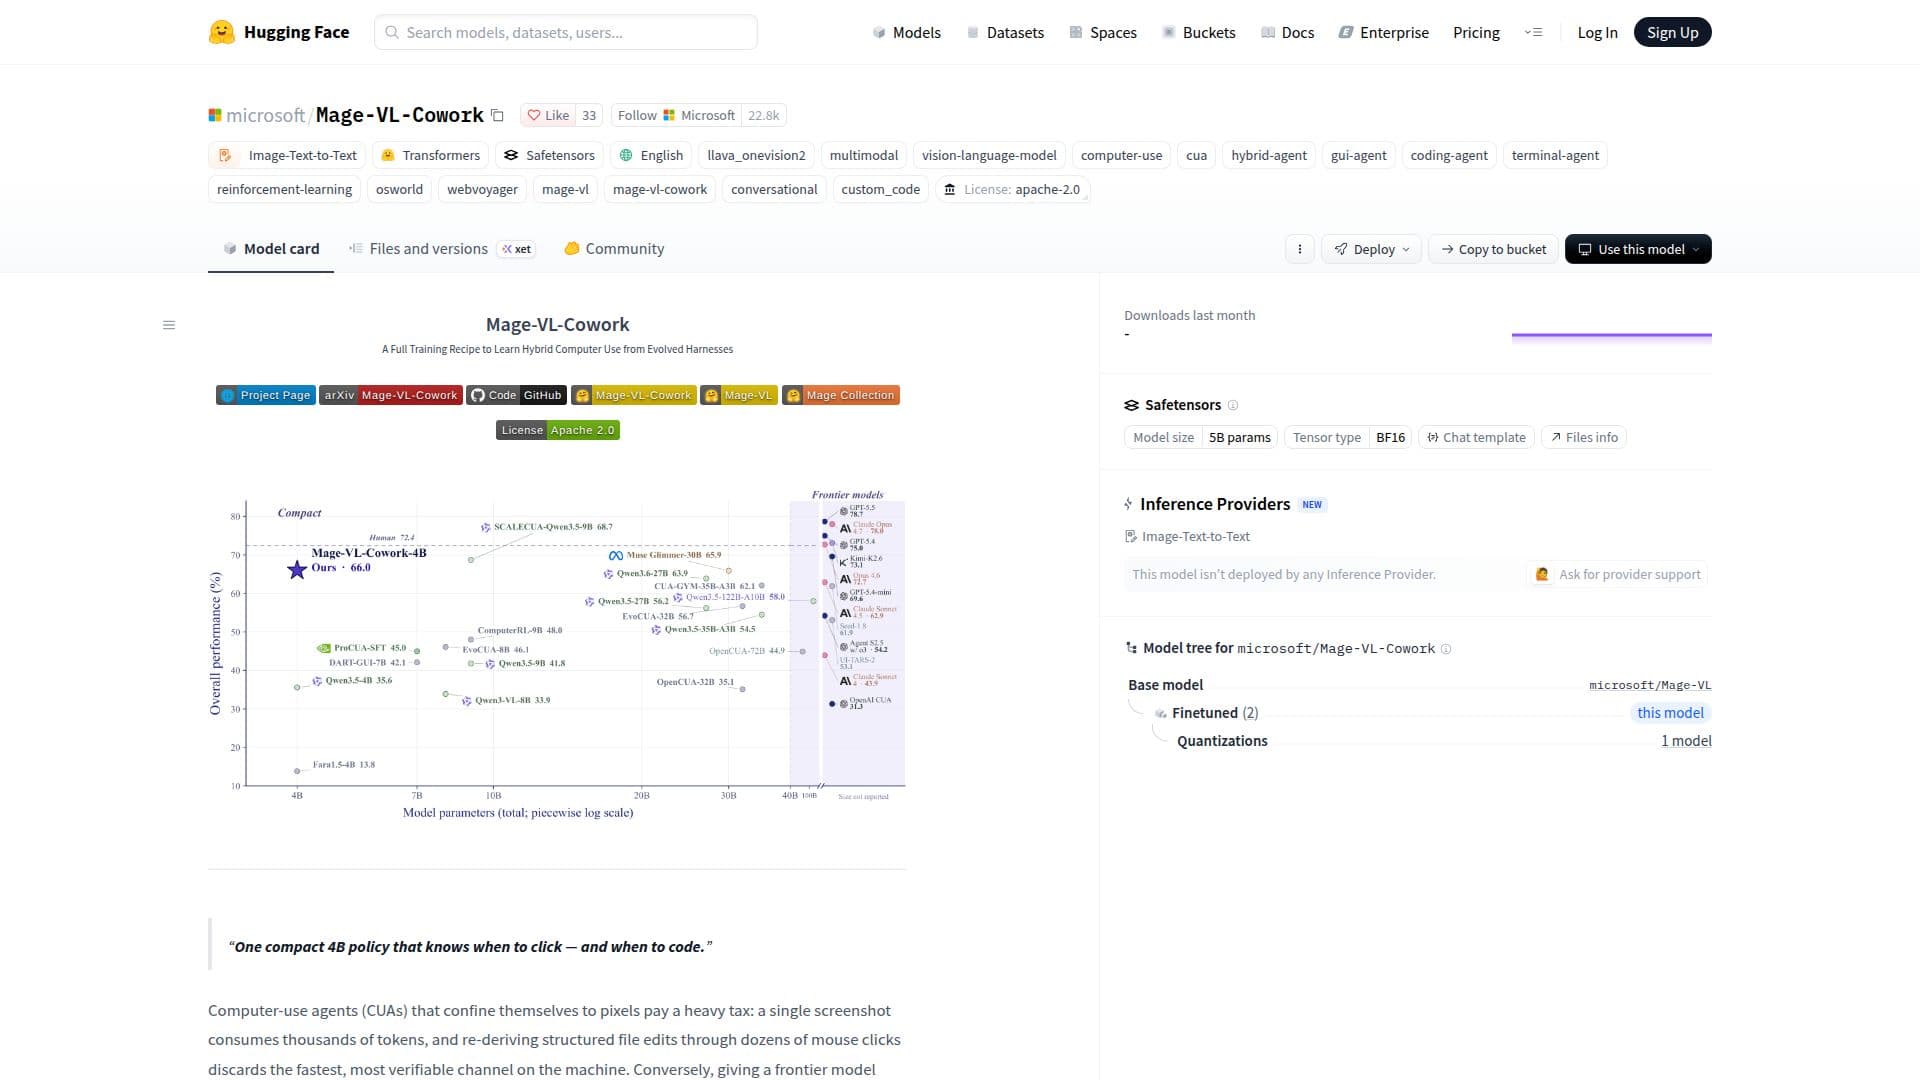
Mage-VL-Cowork 是由微软开发的一个具有 40 亿参数的多模态混合计算代理。它将基于截图的 GUI 交互和持久的代码/终端执行整合在一个单一的视觉-语言策略中。该模型在复杂计算任务中表现出色,展示了其规模下的最佳性能,并推动了自主桌面代理的设备智能前沿。

访问URL
分享
Mage-VL-Cowork 截图
Mage-VL-Cowork 截图

Mage-VL-Cowork 是由微软 Mage 团队开发的一个复杂的 40 亿参数多模态混合计算代理。它旨在弥合基于像素的计算代理(CUAs)与那些对 GUI 和终端工具具有简单访问的代理之间的差距。该模型通过将基于截图的 GUI 交互(`computer_use`)和持久的代码/终端执行(`bash`)结合在一个单一的视觉-语言策略中,实现了混合能力,消除了对外部协调者的需求。

阅读更多

该模型的训练涉及一个渐进的五阶段专业化-再统一课程,从一个中间的 40 亿 Mage-VL 检查点开始。该课程在通过混合 SFT 和异步在线混合 RL 统一它们之前,构建了强大的独立视觉基础、GUI 执行和编码/终端能力。其开发的一个关键方面是教师工具的演变,它修剪冗余的行动路径并装备领域库,从而带来了显著的学生蒸馏收益。

Mage-VL-Cowork 还利用了 Mage-CUA-Forge,这是一个以工作流为先的合成引擎,能够生成大量跨原子技能的任务,同时大幅降低每个任务的重复生成成本。这种方法相比于标准的代理优先构建方法,减少了令牌消耗和支出。

在 40 亿参数下,Mage-VL-Cowork 在 50 步预算下的 OSWorld-Verified 上达到了 66.0%,标志着其规模模型中的最佳性能。它在操作系统任务(87.5%)和多应用工作流(62.7%)上表现出色。该模型的效率通过在线强化学习进一步增强,显著提高了准确性,同时减少了平均模型调用和输出令牌。其不对称工作记忆使其能够通过压缩早期回合并保留最近的视觉和响应数据来管理长时间的桌面任务。

Mage-VL-Cowork 在 Apache-2.0 许可证下发布,旨在由于其自主能力而在隔离的、一次性的沙箱环境中部署。它支持自定义多模态架构,并需要特定的推理配置,包括用于 GUI 和终端交互的统一双通道合同。

  • 类别AI 模型与大语言模型
  • 定价模式开源
  • 部署云端
  • 平台网页版

  • 混合计算使用:在单一策略中结合 GUI 交互和终端执行。

  • 40 亿参数:在 40 亿规模下实现最佳性能。

  • 多模态架构:基于 llava_onevision2 架构的图像-文本到文本模型。

  • 五阶段训练课程:渐进的专业化-再统一方法以全面发展技能。

  • 演变的教师工具:增强学生蒸馏并提高效率。

  • 以工作流为先的环境合成(Mage-CUA-Forge):降低任务生成成本和令牌消耗。

  • 内部化的回合级通道路由:动态选择 GUI 和 bash 以实现最佳执行。

  • 高 OSWorld-Verified 性能:在 OSWorld-Verified 任务上达到 66.0%。

  • 强大的操作系统和多应用工作流执行:在操作系统任务上为 87.5%,在多应用工作流上为 62.7%。

  • 在线强化学习:提高准确性 +10.16 个百分点,并减少模型调用/输出令牌。

  • 不对称工作记忆:通过折叠记忆和活动视觉窗口管理长时间任务。

  • 统一检查点:处理视觉基础、GUI 操作、编程操作和通道切换。

  • Apache-2.0 许可证:用于使用和分发的开源许可证。

  • 自定义多模态架构:使用 llava_onevision2 和 Qwen2_5_VLProcessor。

  1. 安装依赖项:设置所需的环境,包括 SGLang、PyTorch 和 Transformers。

  2. 使用 SGLang 提供服务:使用提供的 Docker 容器或自定义环境启动 GPU 推理服务器。

  3. 配置多模态请求:使用 AutoProcessor.apply_chat_template 渲染提示,并将 base64 图像负载发送到 SGLang 的 /generate 端点。

  4. 应用采样参数:使用推荐设置,如温度 0.7、top_p 0.8 和 max_new_tokens 4096。

  5. 实施系统提示和工具架构:使用计算使用和 bash 的统一双通道合同。

  6. 执行离线 Transformers 推理:利用提供的示例进行推理。

  7. 重现 OSWorld-Verified 评估:启动 SGLang 运行时并运行 OSWorld-Verified 评估工具。

  8. 安全部署:始终在隔离的沙箱环境中运行代理,具有范围授权和零凭证暴露。

  • 自主桌面自动化
  • GUI 交互
  • 编程文件编辑
  • 系统操作
  • Web 环境交互
  • 软件工程任务
  • 设备智能
  • 研究与开发

与 Mage-VL-Cowork 类似的热门AI工具

DeepSeek-V4-Flash-Vision-Exp 是 DeepSeek-V4 系列中的一个实验性多模态模型,增强了视觉理解能力。它基于 DeepSeek-V4-Flash 架构,提供了改进的多模态代理能力,同时保持文本仅性能。

AI 模型与大语言模型

大语言模型 排名第 70 位

查看工具

DeepSeek-V4 系列中的一个实验性多模态模型,增强了视觉理解能力。它基于 DeepSeek-V4-Flash 架构,提供了改进的多模态代理能力,同时保持文本仅性能。DeepSeek-V4-Flash-Vision-Exp 是 DeepSeek-V4 系列中的一个实验性多模态模型,增强了视觉理解能力。它基于 DeepSeek-V4-Flash 架构,提供了改进的多模态代理能力,同时保持文本仅性能。

AI 模型与大语言模型
大语言模型 排名第 70 位

LiquidAI LFM2.5-2.6B

大语言模型

LiquidAI LFM2.5-2.6B 是一款为设备部署设计的混合模型,提供高效的推理和智能能力。它支持多种语言,并针对各种平台进行了优化,使其在多种应用中具有灵活性。

AI 模型与大语言模型

大语言模型 排名第 26 位

查看工具

大语言模型

为设备部署设计的混合模型,提供高效的推理和智能能力。它支持多种语言,并针对各种平台进行了优化,使其在多种应用中具有灵活性。LiquidAI LFM2.5-2.6B 是一款为设备部署设计的混合模型,提供高效的推理和智能能力。它支持多种语言,并针对各种平台进行了优化,使其在多种应用中具有灵活性。

AI 模型与大语言模型
大语言模型 排名第 26 位

OmniParser 是一种将用户界面截图解析为结构化元素的方法。它增强了视觉语言模型(如 GPT-4V)在界面上生成动作的能力。OmniParser 识别可交互的图标并理解元素语义,从而提高基准测试的性能。它被设计为各种视觉语言模型的插件。

AI 模型与大语言模型
查看工具

OmniParser 是一种将用户界面截图解析为结构化元素的方法。它增强了视觉语言模型(如 GPT-4V)在界面上生成动作的能力。OmniParser 识别可交互的图标并理解元素语义,从而提高基准测试的性能。它被设计为各种视觉语言模型的插件。

AI 模型与大语言模型
查看 AI 模型 Top 5

Command A+ 是一个具有 25B 活跃参数和 218B 总参数的专家混合模型,旨在处理复杂推理、视觉和多语言任务,支持 48 种语言,为企业提供高效准确的解决方案。

AI 模型与大语言模型
查看工具

具有 25B 活跃参数和 218B 总参数的专家混合模型,旨在处理复杂推理、视觉和多语言任务,支持 48 种语言,为企业提供高效准确的解决方案。Command A+ 是一个具有 25B 活跃参数和 218B 总参数的专家混合模型,旨在处理复杂推理、视觉和多语言任务,支持 48 种语言,为企业提供高效准确的解决方案。

精选AI 模型与大语言模型
查看 AI 模型 Top 5

Spark-X2.6-4B

大语言模型

Spark-X2.6-4B 是一款紧凑型通用语言模型,旨在设备上部署。它提供了改进的编码、多语言和推理能力,非常适合开发人员和用户处理现实世界的任务。

AI 模型与大语言模型
查看工具

大语言模型

紧凑型通用语言模型,旨在设备上部署。它提供了改进的编码、多语言和推理能力,非常适合开发人员和用户处理现实世界的任务。Spark-X2.6-4B 是一款紧凑型通用语言模型,旨在设备上部署。它提供了改进的编码、多语言和推理能力,非常适合开发人员和用户处理现实世界的任务。

AI 模型与大语言模型
查看 大语言模型 Top 100

MiniMax-M3.1-Flash

大语言模型

MiniMax-M3.1-Flash 是一个多模态专家混合模型,旨在用于编码、代理工作流和网络安全。它支持文本、图像和视频输入,通过稀疏注意力和量化感知训练提供改进的任务性能和推理效率。

AI 模型与大语言模型

大语言模型 排名第 84 位

查看工具

大语言模型

多模态专家混合模型,旨在用于编码、代理工作流和网络安全。它支持文本、图像和视频输入,通过稀疏注意力和量化感知训练提供改进的任务性能和推理效率。MiniMax-M3.1-Flash 是一个多模态专家混合模型,旨在用于编码、代理工作流和网络安全。它支持文本、图像和视频输入,通过稀疏注意力和量化感知训练提供改进的任务性能和推理效率。

AI 模型与大语言模型
大语言模型 排名第 84 位

LLaVA

AI GitHub 仓库

LLaVA 是一个视觉指令调优模型,结合了大型语言和视觉能力。其目标是达到 GPT-4V 级别的性能,实现多模态理解和交互。该项目为研究人员和开发者提供了代码、模型和资源。

AI 模型与大语言模型
查看工具

AI GitHub 仓库

视觉指令调优模型,结合了大型语言和视觉能力。其目标是达到 GPT-4V 级别的性能,实现多模态理解和交互。该项目为研究人员和开发者提供了代码、模型和资源。LLaVA 是一个视觉指令调优模型,结合了大型语言和视觉能力。其目标是达到 GPT-4V 级别的性能,实现多模态理解和交互。该项目为研究人员和开发者提供了代码、模型和资源。

AI 模型与大语言模型
查看 AI GitHub 仓库 Top 250

gptme 是一个与提供商无关、本地优先的 AI 代理,可在任何终端中运行。它提供了一个强大的 CLI,用于编码、知识工作和自主代理任务,支持众多 LLM 提供商和广泛的工具集成,以提高生产力。

AI 编程助手

AI 智能体 排名第 219 位

查看工具

与提供商无关、本地优先的 AI 代理,可在任何终端中运行。它提供了一个强大的 CLI,用于编码、知识工作和自主代理任务,支持众多 LLM 提供商和广泛的工具集成,以提高生产力。gptme 是一个与提供商无关、本地优先的 AI 代理,可在任何终端中运行。它提供了一个强大的 CLI,用于编码、知识工作和自主代理任务,支持众多 LLM 提供商和广泛的工具集成,以提高生产力。

AI 编程助手
AI 智能体 排名第 219 位
1/8